高出0.4分却贵了1431倍!大模型真能取代Embedding吗?
The Embedder's Dilemma: LLMs Are Better, but at What Cost?
在大模型上下文窗口突破百万、长文本推理日渐普及的今天,AI 工程架构正面临一场路线之争:既然大语言模型(LLM)已经能够直接读取长达数万甚至数十万 Token 的上下文,理解复杂的因果与跨文档逻辑,那么传统的向量检索与文本嵌入(Embedding)管线是否已经成为明日黄花?我们是否可以直接跳过“文本分块、生成向量、存入向量数据库、计算余弦相似度”这一套繁琐复杂的预处理链条,全部交给具备通用理解能力的 LLM 一站式解决?
ArXiv URL:https://arxiv.org/abs/2608.12875v1
来自哈佛大学与斯坦福大学等机构的研究者对这个核心工程痛点给出了清晰且量化的回答。在其发布的基准测试研究中,团队系统对比了来自 6 大主流系列的 10 款前沿 LLM(包括 Gemini 3.1 Pro、DeepSeek-R1、Qwen3.6 等)与 26 款专用文本 Embedding 模型(参数量跨越 118M 至 14B,涵盖 E5、SFR-2、Octen-8B、Qwen3-Embedding 等),测试范围覆盖分类、语义文本相似度(STS)、聚类、文本对分类和检索等 5 大类共 37 项任务。
结论既让人意外,又完全在情理之中:在整体平均能力上,两种范式实际上打成了平手——表现最好的 LLM(Gemini 3.1 Pro)平均分为 77.6,而最佳 Embedding 模型(Octen-8B)得分为 77.2,二者仅差 0.4 分,统计学检验显示这一微弱差异完全落在噪声区间内。然而,为了换取这不到半分的整体平局,LLM 付出了极其高昂的工程代价:在同等质量下,LLM 的推理成本最高达到了 Embedding 模型的 1,431 倍(单次基准评测耗资 154.14 美元对 0.11 美元);即使在相同的一张 NVIDIA H100 GPU 上部署,开源 LLM 的 Token 吞吐速度也比向量编码器慢了 2.5 到 736 倍。研究者将这种现象定义为“嵌入者的两难困境(The Embedder’s Dilemma)”。
跨范式对决:两类模型各自主导了什么?
要理解这场评测的价值,首先需要明确两者在底层机制与评价任务上的设定。在传统的文本嵌入管线中,向量模型依靠多阶段对比学习、难负样本挖掘与知识蒸馏,将变长文本投射到高维几何空间中,匹配操作本质上是空间向量的内积或余弦距离计算。而在本次研究构建的 MTEB(LLM) 基准中,LLM 则是直接接收零样本(Zero-Shot)或少样本 Prompt,以生成式的方式直接输出结构化结果或进行全库上下文匹配。
当把 37 个具体任务拆解开来时,整体均分的“势均力敌”立刻演变成泾渭分明的结构化分工:
在文档检索(Retrieval)任务上,大模型展现出了碾压式的结构优势,平均得分高出最佳向量模型 8.5 分(64.5 对 56.0)。在测试的 6 项检索任务中,Gemini 3.1 Pro 赢下了 5 项,仅在法律法条检索上一度落后。这种差距的根源在于信息交互的方式:双塔向量架构在检索时对 Query 和 Document 采用完全独立的双向编码,缺乏跨文档的交叉注意力(Cross-Attention);当用户的查询需要跨段落多跳推理、反事实辨析或高度抽象的逻辑匹配时,单纯依赖独立压缩的固定维度向量表征,往往会出现严重的信息丢失。而大模型在上下文检索中通过全自注意力机制同时观察所有候选文档,能够自然地捕捉极其微妙的语义依赖。
但在文本分类(Classification)任务中,局面发生了 180 度的逆转。配备简单 k 近邻(kNN)分类器的向量模型(如 SFR-2,得分 90.8)领先 Gemini 3.1 Pro 整整 5.6 分。当分类任务的类别粒度急剧增加时,这一优势尤为明显——在包含 77 个类别的 Banking77 意图分类与 60 个类别的 MassiveIntent 任务中,基于向量几何距离的近邻分类稳准狠,而面对数十个候选标签的零样本提示,即使最顶尖的 LLM 也会出现上下文混淆与注意力分散。向量空间天然具备几何聚拢与超平面切分特性,在有参考锚点的情况下,几何距离对分类边界的刻画远比纯文本生成可靠得多。
至于语义文本相似度(STS)、文档聚类以及成对文本分类这三项任务,两类范式在统计学上近乎打平。在聚类任务中,SFR-2 跑出的 66.7 分与 Gemini 3.1 Pro 的 66.6 分难解难分;在 STS 相似度排序上,Qwen3-E-4B(88.8 分)甚至极其微弱地领先 Gemini 3.1 Pro(88.5 分)。这明确表明,只要任务的核心逻辑本质上属于“几何相似性映射”或“标准参考物匹配”,通过特定对比损失训练出来的高维向量便能精准完成任务,盲目引入复杂的自回归生成不仅带不来任何质量收益,反而是对算力的巨大浪费。
1431 倍的成本鸿沟与思维代税
性能指标只是系统选型的一半,另一半则是工程落地无法回避的真金白银。论文对所有模型的调用费用与物理吞吐量进行了细致的成本核算。
对于在单张 H100 80GB GPU 上运行的 Embedding 模型,成本按照租赁单价(2.49 美元/小时)结合每小时处理 Token 数 $T$ 进行折算,单位成本为 $r_{\text{GPU}} / T$;而对于大模型,则严格提取调用返回中的 Input Token、Cache Token 以及包含推理思考在内的 Output Token,按照商业 API 与开放托管平台(OpenRouter)公开费率实时计量:
\[\text{Cost} = (\text{input} - \text{cached}) \cdot r_{\text{in}} + \text{cached} \cdot r_{\text{cache}} + (\text{total} - \text{input}) \cdot r_{\text{out}}\]在这个统一标尺下,成本差距极其悬殊。跑完一遍 MTEB(LLM) 评测基准,参数量仅 118M 的 mE5-small 仅需消耗 0.001 美元,即便是 14B 参数量的重型向量模型 F2LLM-v2,成本也只有 0.22 美元。然而,表现最好的 Gemini 3.1 Pro 跑完同样的数据集花费了 154.14 美元,成本比同级别最佳质量的 Embedding 模型高出整整 1,431 倍。即使考虑到各类硬件方案与 API 浮动(例如在更便宜的 L4 GPU 上运行向量模型,或使用高性价比的开源模型),大模型与向量嵌入之间的成本倍率也始终维持在 338 倍至 2,424 倍之间,呈现出牢固的数量级差距。
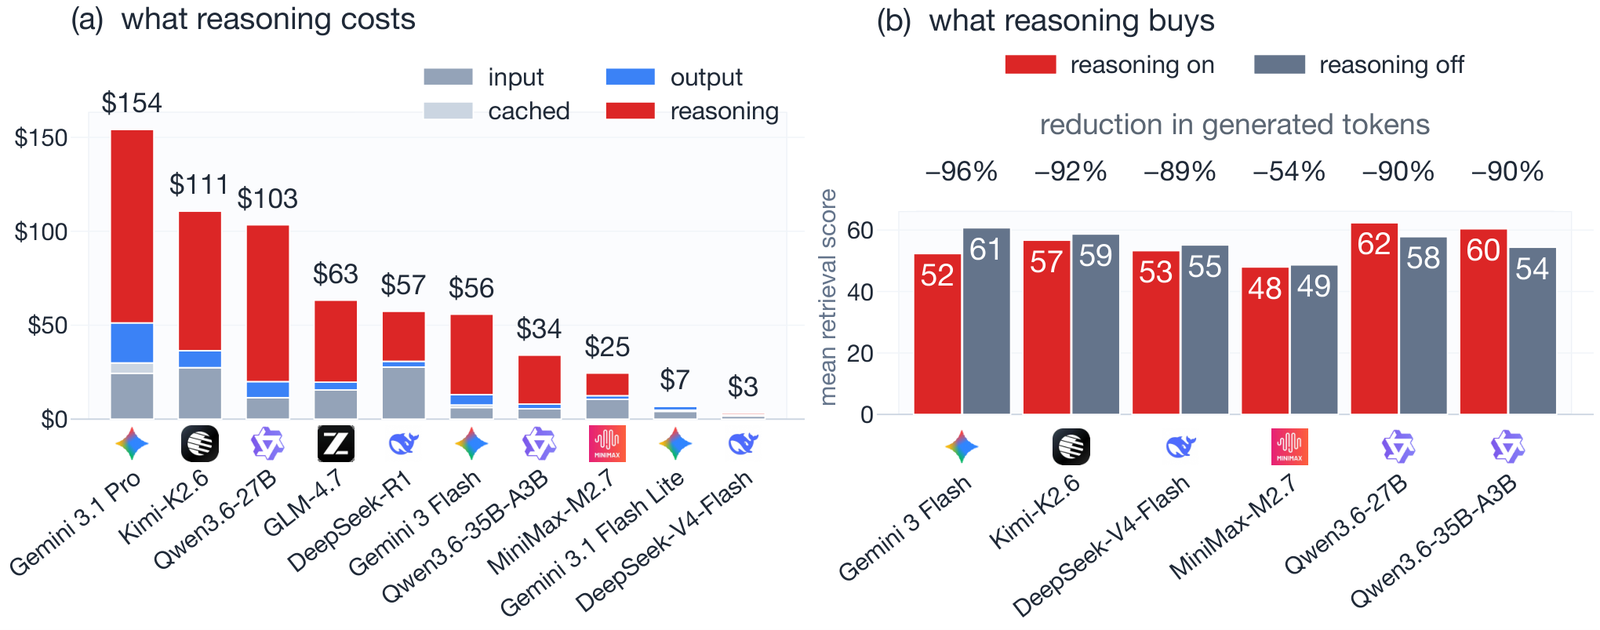
那么,大模型高昂的花销究竟流向了何处?该研究揭示了一个关键机制:所谓的“思维 Token 税(Thinking-Token Tax)”。在带长链条思维(Chain-of-Thought)的推理模型中,模型自主生成的思考 Token 占到了总体推理费用支出的 28% 到 81%。在各类云厂商的计费策略中,思考过程完全被归入最昂贵的 Output Token 单价进行结算。
极其反直觉的是,这项高额的“思维税”很多时候买来的并不是精度,而是冗余。在针对推理预算的消融实验中,研究者强制调低或在服务层直接剥离了思考 Token(生成量骤降 54% 到 96%)。结果发现,在多数模型上,大幅度缩减思考预算不仅没有削弱检索与匹配的表现,甚至在部分模型上还带来了分数的微弱回升。这种现象与推理模型常见的“过度思考(Overthinking)”直接吻合:在纯粹的候选文档关联判定中,冗长的自言自语并不能提升判断精度,反而可能在过多的自我辩驳中偏离最初的主旨,最终导致白白烧掉几倍的调用费用。
吞吐量瓶颈与真实算力天花板
除却 API 账单,离线部署中的吞吐量差距同样是一道物理硬伤。为了完全排除网络延迟、API 限流和不同硬件的干扰,研究者特意将两款能够完整塞入单张 H100 GPU 的开源大模型(Qwen3.6-27B 与 Qwen3.6-35B-A3B)与 26 款 Embedding 模型部署在完全相同的单一硬件环境下进行压力测试。
测试结果揭示了由自回归生成与单向编码器架构带来的不可调和的底层吞吐鸿沟:在同一张 H100 上,依托 vLLM 调优部署的大模型稳态吞吐量仅在 5,400 至 5,900 tokens/s 之间徘徊;而 Embedding 模型由于只需要前向单次编码并支持大规模高并发 Batching,处理吞吐量从 14B 模型的 14,700 tokens/s 一路跃升至 mE5-small 的 4,300,000 tokens/s。
即使面对同样庞大的 8B 甚至 14B 级别的密集模型,Embedding 架构的 Token 吞吐也是同尺寸生成式 LLM 的数倍到数十倍;而对比工业界普遍采用的中轻量级向量模型,两者的吞吐量落差高达数百倍。在企业级搜索或文档库实时增量场景下,面对数以千万计的文档切片和持续不断的流入更新,如果试图完全依赖全上下文 LLM 去动态消化,计算吞吐量的崩塌和基础设施成本的激增是无法承受的。
破局之道:分工明确的混合检索管线
面对大模型与向量嵌入的优劣势错位,工程落地的最优解显然不是在二者中做非此即彼的单选题,而是建立分层明确的“检索-重排(Retrieve-then-Rerank)”混合流水线。为了验证这一架构的实效,研究者将标准语义匹配基准 BEIR 与以逻辑密集型检索见长的 BRIGHT 基准引入对比矩阵,让不同向量模型担任第一阶段召回粗筛,再分别接入交叉编码器(Cross-Encoder)或 LLM 进行候选列表重排(Listwise Reranking)。
实验结果清晰地绘制出了适用边界:
在以深度因果与复杂推导为特征的 BRIGHT 基准上,单靠强向量模型第一阶段只能拿到 22.3 的 nDCG@10;而一旦在后端引入 LLM 列表重排,最终得分直接跃升至 35.1。更为关键的是,由于第一阶段向量检索已经将数以万计的文档空间裁剪为一个仅包含 Top-100 的精简候选池,LLM 仅需在百条文档的短名单上进行精细比对,基准评测成本从全上下文灌入的 154 美元暴跌至 10 到 30 美元之间;如果进一步选用性价比突出的混合专家模型(MoE,如 Qwen3.6-35B-A3B),仅花费约 10 美元便能斩获 33.6 的高分,以不到五分之一的成本逼近了顶级商业全量模型的效果。
然而,在语义形态标准的 BEIR 基准上,盲目叠加 LLM 重排不仅毫无必要,反而适得其反。实验数据显示,强向量模型凭借自身单阶段余弦检索即可取得 63.1 分的优异表现,而无论接入何种 LLM 进行二次重排,最佳综合得分反而微跌至 60.3 分。这再次印证了核心结论:对大模型推理能力的需求取决于任务是否包含真正的“推理依赖”;在常规语义覆盖的语境下,向量空间固有的稠密表征已经具备极高的信噪比,此时强行套用 LLM 进行所谓多步重排,不仅白白增加延迟与开销,还极易受到生成模型幻觉与排序倾向漂移的干扰。
架构选型的终局启示
这项研究所呈现的帕累托前沿(Pareto Frontier)为当下的 AI 应用架构师提供了一份极其扎实的选型依据:在由 36 款模型构建的质量-成本边界曲线上,整条前沿线几乎全部由不同尺寸的专用 Embedding 模型所占据,唯有 Gemini 3.1 Pro 凭借极窄的 0.4 分检索微弱优势,悬挂在曲线最顶端——代价是高出三到四个数量级的推理支出。
大模型确实带来了更强的推理式信息聚合能力,但这绝不意味着它可以全盘替换文本嵌入体系。理性的工业界实践应当是清晰的“分工自治”:
在语义相似度判定、文本分类以及无监督聚类任务中,继续坚定地选择轻量级、高吞吐的专业 Embedding 向量模型。它们在这些领域的几何表征已经高度成熟,无需为其引入生成式 LLM 的随机性与巨额算力开销。而在检索与 RAG 架构的设计中,则应当依托“Embedding 粗召回 + 局部受限 LLM 细重排”的双层机制。把全库数万文档塞进单次提示词的“粗暴打法”,在实验室小规模评测中固然能刷出亮眼的检索得分,但在真正的工业生产级吞吐要求和长期运营成本面前,注定是一条难以走通的死胡同。学会让向量模型处理空间距离,让大语言模型处理逻辑思辨,才是穿越技术泡沫、构建稳健系统的最优解。