不是模型不够聪明,而是工作流在洗白错误:多智能体串行系统中的“幻觉滚雪球”
The Hallucination Snowball: Modeling Error Propagation as State Transitions in Multi-Agent LLM Pipelines
在多智能体系统(Multi-Agent System)的设计中,串行流水线是当前工业界最普遍的落地方案。无论借助 LangGraph、AutoGen 还是 CrewAI,工程师们通常会搭建一条分工明确的流水线:先由研究员抽取数据,再由分析师计算指标,接着由写作者润色报告,最后交给审核员做质量把关。这种设计表面上模块清晰、符合人类组织协作直觉,但来自 RediMinds 与德克萨斯大学奥斯汀分校(UT Austin)的最新研究揭示了一个致命的架构缺陷:串行智能体之间的信任链条,正在将早期的微小事实错误“洗白”成无法检测的笃定结论。
ArXiv URL:https://arxiv.org/abs/2608.14588
这项发表于 FMAI 的工作将该现象命名为“幻觉滚雪球”(Hallucination Snowball)。在没有交接校验的串行系统中,幻觉不仅会沿着管道向下传播,还会随着智能体一次次的处理发生形态质变。一个在最上游清晰可查的数值错误,经过派生计算、语境叙事与形式审查后,在最终输出中近乎不可逆地隐形。更具冲击力的是其实验发现:验证的时机(Timing)远比用什么工具验证(Method)更重要。在流程末端配置强力审核,相比完全不验证仅能减少 2.3 个百分点的幻觉;而将完全相同的规则校验前置到智能体交接的边界上,能直接将幻觉存活率从 58.4% 压制到 16.2%。
幻觉如何被智能体流水线彻底“洗白”?
为了理解幻觉是如何滚成雪球的,不妨先看一个典型的财务分析场景。假设第一阶段的研究员(Researcher)智能体在阅读财报时产生了幻觉,将波音公司的销售成本(COGS)提取为 712 亿美元(真实值为 631 亿美元)。
在理想的单智能体评测视角中,这只是一个可被检索匹配轻松击碎的事实性错误。然而在多智能体流水线中,下游的分析师(Analyst)智能体完全信任上游的输入,它接收到这个假数字后,尽职尽责地算出“同比增长 8.3%”这一派生结论;第三阶段的写作者(Writer)智能体接着发挥语言模型的叙事能力,生成了一段逻辑严密的话:“波音公司面临显著的成本压力,销售成本跃升 8.3% 至 712 亿美元,这主要反映了供应链中断的持续影响”;到了最后阶段,审核员(Reviewer)智能体在没有原始财报上下文的情况下进行校验,它检查了语篇的行文逻辑、前后因果和语气风格,给出了“分析条理分明、推理合理”的通过评价。
到了这一步,原本赤裸裸的虚假数字已经被深度编织进了一套自洽的因果链条中。后续的任何检测器如果仅看最终报告,都很难在没有全量原始文档支撑的情况下察觉破绽。
研究团队指出,学术界过去的幻觉抑制方案(如 FActScore、CoVe、SAFE 等)基本都聚焦在单智能体(Single-Agent)生成场景,本质上是在孤立输出中寻找更敏锐的检测器。但真实系统是串行多阶段的,上游智能体的输出直接构成下游智能体的先验事实。多智能体系统中的幻觉问题,其本质不再是孤立的“模型生成精度问题”,而是经典的“系统级错误传播与级联放大问题”。
状态转移与不可逆的检测力衰减
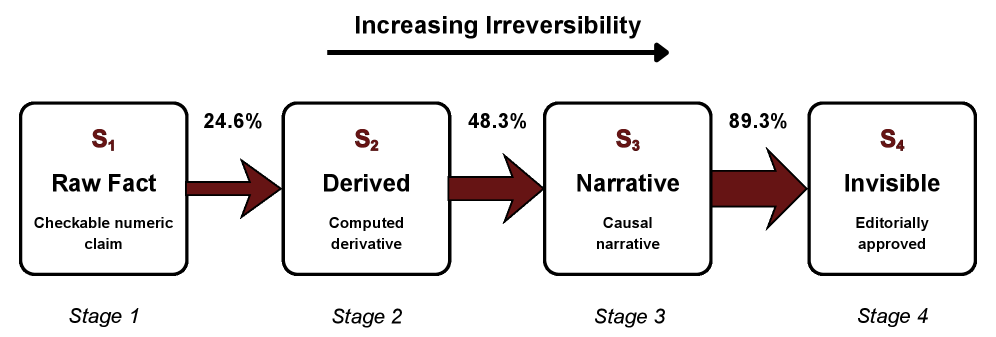
为了给这种错误演变建立数学描述,研究者将幻觉传播形式化为一个一阶马尔可夫过程(First-Order Markov Process)。幻觉在四阶段流水线中会经历四种形态状态:
\[S_1 (\text{原始事实}) \xrightarrow{s_1} S_2 (\text{派生计算}) \xrightarrow{s_2} S_3 (\text{叙事语境}) \xrightarrow{s_3} S_4 (\text{形式核准/不可见})\]在这条链条中,$s_k$ 代表幻觉跨越第 $k$ 个智能体交接边界时的逃逸概率(Escape Probability),即未能被该阶段检测机制捕获的比例。基于真实金融问答数据集 FinanceBench(包含基于真实 SEC 财报的 140 个复杂分析指令)以及注入的 346 处确定性数值扰动,研究团队系统测定了不同阶段的检测表现。
实验测得的逃逸概率呈现出令人不安的陡峭上升:
在 $S_1 \to S_2$ 边界,逃逸概率为 24.6%;
进入 $S_2 \to S_3$ 边界,逃逸概率飙升至 48.3%;
而在 $S_3 \to S_4$ 边界,逃逸概率达到了惊人的 89.3%。
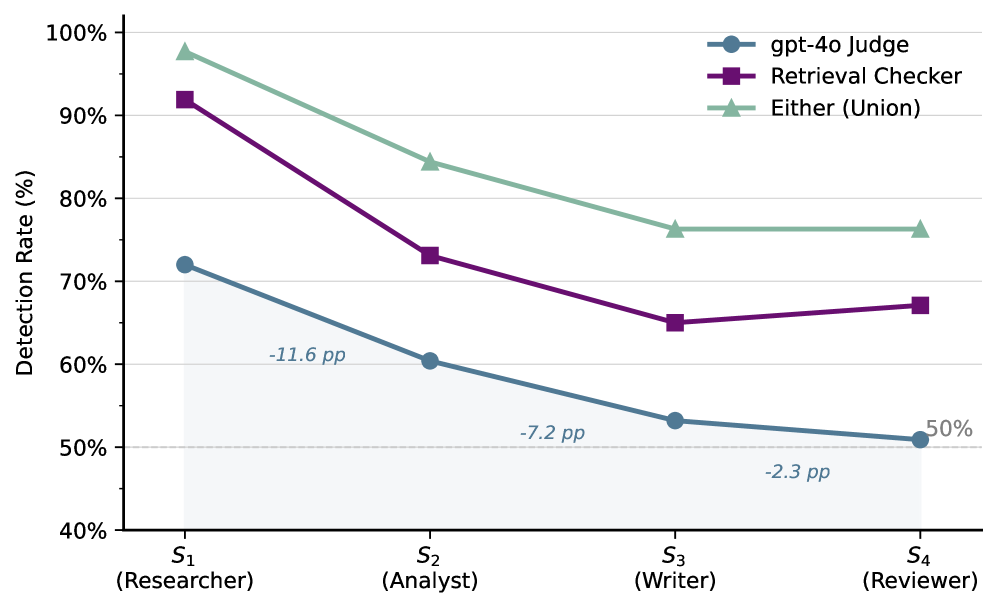
这意味着什么?每一道智能体边界都在使幻觉的存活率翻倍。当使用未接触底层财报的 gpt-4o 充当法务审查法官时,其在 $S_1$ 阶段能识别 72.0% 的幻觉,但到了 $S_4$ 阶段,检测率暴跌至 50.9%,净跌幅达 21.1 个百分点。即便采用理论上限级的确定性数值检索匹配器,检测率也从 $S_1$ 的 97.4% 骤降至 $S_4$ 的 72.5%。
检测力的衰减不是均匀发生的,而是高度集中在上游转换阶段。最大的跌幅发生在 $S_1 \to S_2$(gpt-4o 下跌 11.6 个百分点,检索匹配器下跌 18.8 个百分点),因为原始数值一旦变成派生比率,校验者就必须进行逆向工程才能还原数值矛盾。第二次显著下跌发生在 $S_2 \to S_3$(分别下跌 7.2 与 8.1 个百分点),数字被因果叙事包裹,语言模型极易被流畅的合理性说服。而 $S_3 \to S_4$ 边界处的检测率变化极其微弱,因为审核员智能体只是在做文字润色和形式确认,真正的“洗钱”过程早在上游就已经彻底完成了。
大模型的“怀疑天花板”救不了结构缺陷
面对这种检测力滑坡,直觉上的对策往往是:换一个更聪明、更有批判性思维的模型来做下游审核行不行?
研究团队为此设计了第二个实验,直接测试当前顶尖大模型在充当“怀疑者”(Skeptic Agent)时的能力天花板。测试涵盖了包括 Qwen3.5-397B-A17B 在内的多款前沿大模型,且全部放在检测条件最好的 $S_1$ 阶段(此时错误还是裸露的数值),提示词专门强化了对抗性质疑意图。
结果显示,这并非模型尺寸或推理能力能够单点突破的技术壁垒,而是一个信息结构层面的硬天花板。大模型对百分比类幻觉的检测率尚可达到 71% 至 98%,这是因为加法偏移 30% 以上的百分比在宏观业务常识上往往过于离谱;然而对于绝对金额,检测率迅速垮塌至 49% 到 86%。其背后的机理非常直白:如果波音公司的销售成本被篡改了 12.8%,在没有翻阅原始账本的前提下,没有任何大模型能单凭纯文本语境判断 712 亿与 631 亿哪个才是真财报。只要扰动落在此类业务指标的“合理区间(plausible range)”内,单纯依赖大模型的常识与逻辑推理就注定会失效。
即使是表现最出色的 Qwen3.5-397B-A17B,在最理想的 $S_1$ 阶段也只能达到 87.0% 的检出率。若将这一顶尖水平代入上述马尔可夫衰减链条,该模型在 $S_4$ 最终阶段的预期检测率也仅剩 60% 至 65% 左右。这意味着在不改造架构的前提下,即便给流水线终点换上超大规模模型,最终报告中依然会有 35% 到 40% 的幻觉完全漏网。
颠覆直觉的实验:位置彻底压倒工具
既然检测模型无法单挽狂澜,系统的破局点究竟在哪里?第三项实验给出了极其鲜明、具备工程指导意义的结论。
研究团队对比了三种流水线配置(全部基于真实的 gemini-2.5-flash 全链路测试):
-
Vanilla(原生流水线):没有任何中间校验,智能体依次执行。
-
End-Check(末端拦截):仅在第四阶段 Reviewer 之后部署一个确定性的数值比对门控(零 LLM 调用,通过正则匹配底层事实),发现错误只能告警,但由于缺乏上下文无法有效修正。
-
Ours(边界门控,Boundary Gates):在每一个智能体交接点($S_1 \to S_2$、$S_2 \to S_3$、$S_3 \to S_4$)都部署完全相同的确定性数值门控,一旦发现被篡改或不一致的数值,立即进行标记并拦截向下传递。
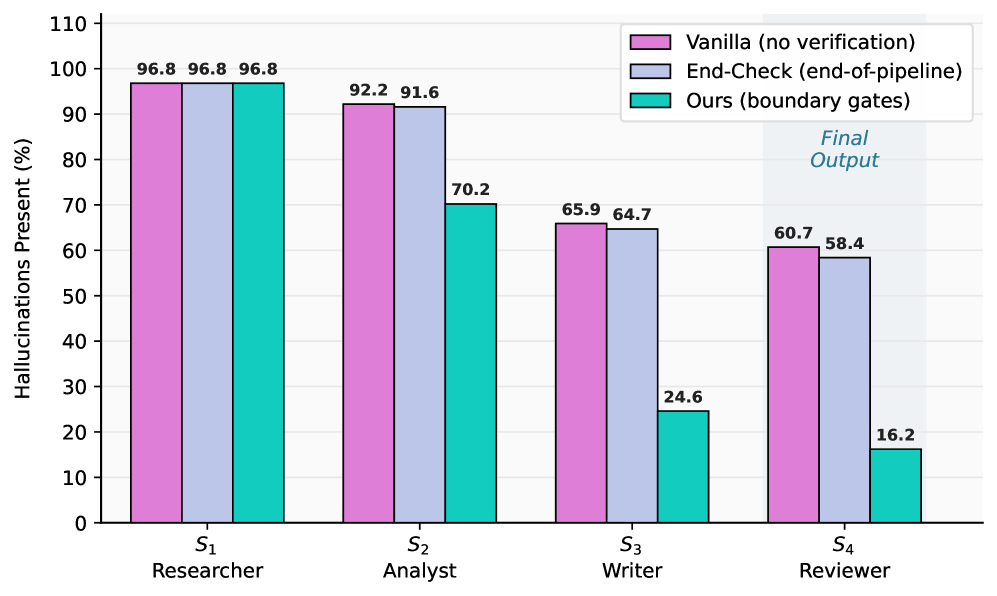
结果表明,末端拦截(End-Check)相较于原生流水线几乎形同虚设:幻觉存活率仅从 60.7% 微弱下降到 58.4%,效果改善仅有区区 2.3 个百分点。原因正如马尔可夫模型所推导的:由于前三阶段的层层包装,到了末端,接近 90% 的幻觉已经无法被提取和对齐,工具再强也无从下手。
而将同样的校验工具拆解为“边界门控”后,系统的幻觉存活率直接被砸到了 16.2%,相比末端拦截实现了 42.2 个百分点的断崖式压制(Cohen’s $h = -0.911$,$p < 0.000001$)。在生成的最终报告中,完全无幻觉的干净报告从末端拦截的 28 份直接跃升至 96 份。
这组对比有力地证明:在大模型系统工程中,“何时验证”在决定性上远超“用什么验证”。
在实际开销方面,这种确定性规则门控不需要调用任何大模型推理,仅增加微秒级的比对开销,全流程因速率限制带来的额外延迟不到 0.9 秒,相比单个智能体动辄 3 至 5 秒的生成延迟几乎可以忽略不计。
必须正视的代价格局:准确性与连贯性的拉扯
任何负责任的系统工程改造都不会只有收益而没有代价。在评测流水线输出的最终质量时,研究人员记录到了一个细微但不可忽视的现象:边界门控方案的内部连贯性质量得分从末端拦截的 4.44 分轻微下滑至 3.93 分。
追溯这 266 次门控拦截行为的底层日志可以发现,这种“质量惩罚”并不是因为规则误判(门控的假阳性率极低,仅为 0.4%)。导致文本评分下降的真正原因,在于“抑制而未恢复”(suppression-without-restoration)。在 32.7% 被成功拦截的案例中,门控准确剔除了虚假的数值,并在上下文中打上了修订标记,但下游的智能体未能完美理解指令并将正确数值重新嵌入叙事,从而在最终的行文中留下了数字缺失或语意断裂。
这揭示了当前大模型评价体系中的一个严重盲区:绝大多数面向语言模型的评估指标,其底层都在根据“内部自洽度与行文流畅度”打分,对底层事实的真伪毫无感知能力。一份基于伪造的 712 亿美元数据写成、逻辑天衣无缝的虚假报告,往往能拿到极高的流利度评分;而一份因中途拦截错误导致个别指标留白的诚实报告,反倒会被判定为“质量欠佳”。
从高价值业务严肃落地的角度来看,一篇自洽但充满捏造数据的报告绝不能被称为“高质量”。这项研究所呈现的连贯性轻微折损,恰恰给从业者敲响了警钟:消灭流水线中的幻觉雪球,不能只做简单的“警告”和“抑制”,必须在门控处提供源头级事实回填(Source Grounding),直接把检索到的真实数值强制写入下游上下文,才能在消灭幻觉的同时稳住叙事的连贯性。
串行管道的资源分配法则
基于上述实证与马尔可夫模型,对于任意线性 $n$ 智能体流水线,幻觉的理论最终存活概率可以简洁地表示为各边界逃逸率的连乘:
\[P(\text{survival}) = \prod_{k=1}^{n-1} s_k\]根据这一公式,研究者为构建复杂智能体系统的团队提炼出了极其清晰的资源投入法则:
首要资源必须坚决砸在 $S_1 \to S_2$ 边界上。在这一关卡,75.4% 的错误数值处于原始状态,不仅检索比对的召回率最高,而且此时实施纠错的计算与逻辑成本最低。一旦错过了第一个交接点,幻觉进入第二阶段后,不仅有接近一半的概率逃逸,更会不可逆地污染后续所有智能体的思维链(Chain of Thought)。
相比之下,在流水线末端(如 $S_3 \to S_4$)部署高昂复杂的审核机制,其边际检出贡献率仅有 10.7%,在有限的算力与延迟预算下几乎是不合算的投资。第一道门控的作用,远比后续所有门控加起来的总和更加关键。
同时,流水线并不是越长越好。在没有交接门控的原始架构下,智能体链条越长,错误被编织洗白的次数就越多,最终幻觉几乎必然会存活并被合法化。
尽管该研究以金融财报这一数值明确的场景作为严谨切口,但其揭示的机制具有极强的通用性。在医疗问答中,从病历信息抽取到用药方案建议的交接;在法律科技中,从法条检索到辩护意见撰写的交接;在科研助手领域,从文献解析到综述生成的串联……只要存在“可核验的事实被下游智能体加工为叙事性文本”的过程,幻觉滚雪球效应就会无可避免地上演。
对于今天在生产环境中广泛使用多智能体框架的开发者而言,这篇工作所带来的视角切换极为关键:不要再沉迷于寻找那个能够一眼看穿所有文本破绽的“完美法官模型”。在大模型工作流中,防御必须前置,干预必须发生在转化发生之前,而非叙事完成之后。阻断错误的流动,永远比挽救失控的结果更容易。