TextCall:视觉大模型调工具,真正起效的原来源自文本而非像素?
Thinking With Tools, Not With Pixels: Tool Calls as Text Scaffolds for Visual Reasoning
在多模态大模型的演进脉络中,“用图像思考”(Thinking-with-Images)一度被视作从纯语言链条迈向具身视觉推理的标准范式。无论是工业级的商业闭源模型,还是开源前沿的各类视觉代理,都在竞相模仿人类在看图时的微观行为:遇到模糊不清的角落,就调用裁剪(Crop)工具放大局部;遇到复杂的几何关系,就调用代码生成旋转或标注,随后将新生成的图像送回模型的多模态上下文中,供下一步推理反复咀嚼。
ArXiv URL:https://arxiv.org/abs/2608.09682v1
来自蚂蚁集团、香港科技大学、香港中文大学与浙江大学的研究团队在一项深入的实证研究中抛出了一个颇具冲击力的命题:在当前主流的视觉工具推理任务中,模型调用工具后返回的新像素,几乎是一个冗余的载体。真正扛起推理性能大幅提升的“承重墙”,其实是模型在发出工具调用指令的那一瞬间,所吐出的那段结构化文本——包括裁剪目标的描述、意图说明以及精确的空间坐标(Bounding Box)。
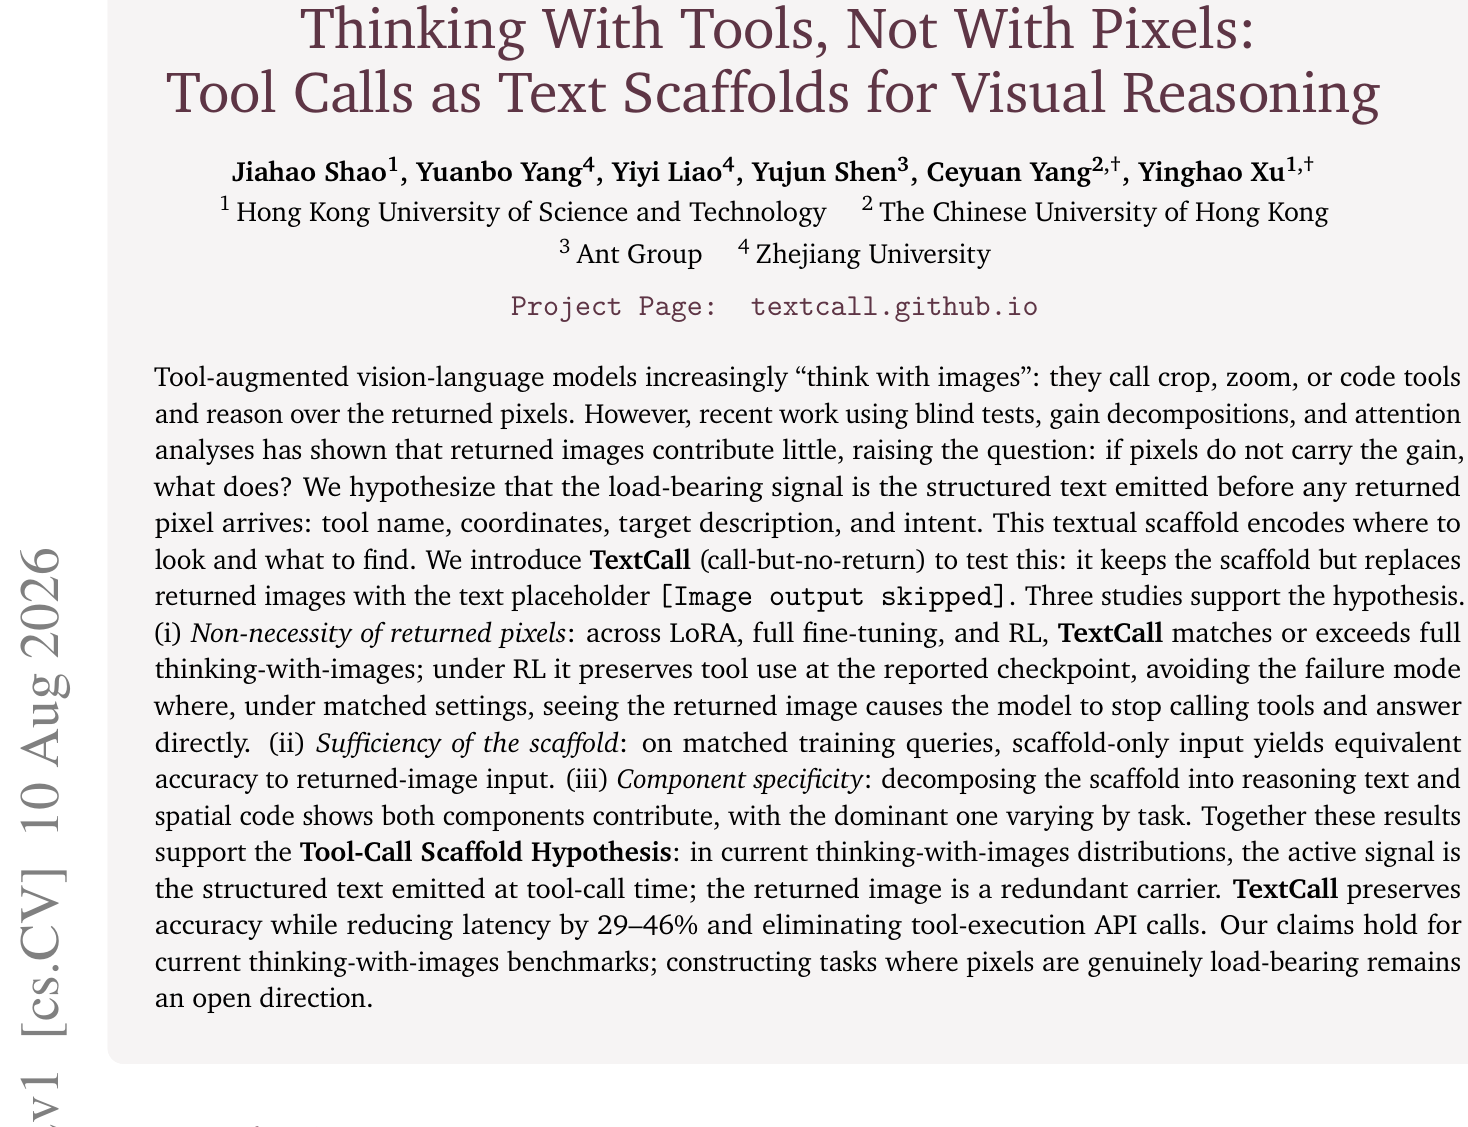
为了严格证明这一点,研究团队提出了名为 TextCall(只调用、不返回图像)的训练与评测机制:模型照常生成完整的工具调用脚手架(Scaffold),但在工具执行完毕后,系统完全不回传裁剪后的新图像,而是直接用一个固定的文本占位符 [Image output skipped] 替代。实验表明,在多项微调和强化学习设置下,完全看不到裁剪后像素的 TextCall 不仅在 6 个核心多模态基准测试上以 +1.39 个百分点的微弱优势持平甚至超越了回传真实像素的基线模型,还将端到端推理延迟压缩了 29% 到 46%,并消除了工具调用的图像推理开销。
被忽视的“因果断裂”:视觉工具真的提供了视觉信息吗?
在过去一年里,学术界对视觉大模型工具调用的怀疑论并非空穴来风。此前已有多篇工作在推理阶段做过“破坏性测试”:有人尝试在模型调用裁剪工具后,把返回的图片换成纯高斯噪声,结果模型的基准评测分数仅下跌了 0.52 个百分点;还有研究发现直接在推理期拿掉所有回传图像,数学视觉任务的准确率甚至反常地上升了 3.5 个百分点。更有统计表明,在很多经典的裁剪链条中,模型预测出的边界框只有不到 60% 真正框中了目标物体,但下游的回答却往往能神奇地答对。
这些现象暴露出一个令人困惑的技术谜题:既然推理阶段把图像拿掉或者弄坏都不怎么影响结果,那为什么在模型训练时,一旦引入“调用工具-观察新图像”的多轮机制,能力就会出现肉眼可见的飞跃?
过去大部分诊断性工作存在一个根本缺陷——它们全是在“测试期”(Inference-time)动手脚。如果模型在预训练或指令微调时一直习惯于看到裁剪图像,测试时强行拔掉图片,评测分数的波动往往会被“训练与推理分布不一致(Train-Test Mismatch)”所污染,很难理清因果。大家无法确切判断,模型究竟是真的在靠新像素推理,还是仅仅因为没有看到图像而被打乱了生成节奏。
研究团队的核心洞察在于,必须在训练阶段就实行对称的“载体置换”(Carrier Swap)。如果让一个模型在整个微调甚至强化学习训练阶段,从来就没见过工具返回的任何像素,它仅仅靠着自己生成的调用代码和意图文本,能否复现“用图像思考”所带来的所有增益?如果可以,那就意味着在现有的数据和基准分布下,视觉推理能力的跃迁实质上是“语言链条在空间维度的结构化展开”,而不是高频像素特征的二次注入。
TextCall 机制:只保留脚手架的精准手术
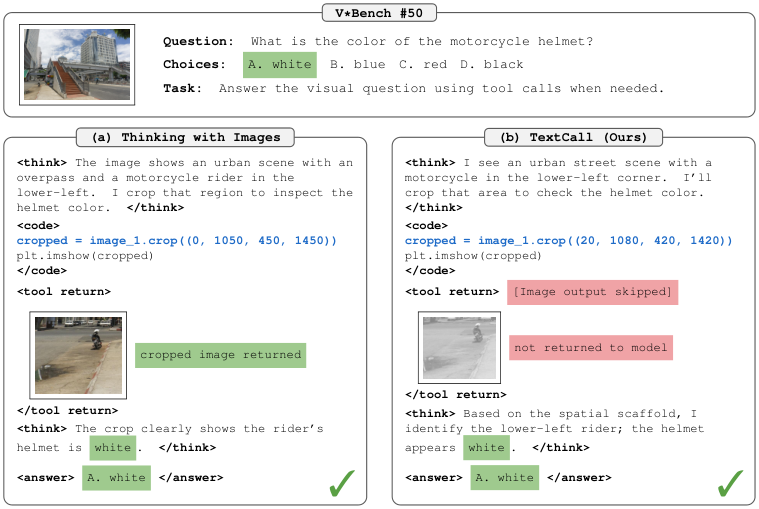
TextCall 的实现方式直截了当,却设计得极其严密。在标准的多轮工具代理交互中,模型首先在 <think> 标签内展开显式思考,阐述为什么需要对图像的某一部分进行检查(例如:“右侧货架第三层的标签字迹模糊,需要局部放大以读取保质期”);随后,模型生成一段调用工具的 Python 代码块或 API 结构,明确指出工具名称 crop 以及四元数坐标 $[x_1, y_1, x_2, y_2]$。
在常规流程中,外部环境会截取这块原图子集,经过视觉编码器编码成数百个新的 Vision Token,再次拼接回模型的 Context 中,驱动模型进行下一轮观察。而在 TextCall 流程中,整个执行管道截断了图像流,外部工具执行完毕后,仅向模型返回一行纯文本:[Image output skipped]。
从上下文结构来看,TextCall 完整保留了模型自主生成的两层关键文本信息:
-
语义意图层:位于思考标签内,交代了注意力需要聚焦的目标类型与先验假设;
-
空间代码层:位于代码块内,提供了在原图动态分辨率网格上的具体归一化坐标。
模型在整个训练期与测试期始终处于这种“知晓自己调了工具、知晓自己锁定了哪里、但必须完全基于原图初始编码作答”的约束之下。基座模型选用开源领域极具代表性的 Qwen2.5-VL-7B-Instruct,并在 DeepEyes V2 的多轮工具轨迹数据集上进行全流程验证。
从 LoRA 到 RL:彻底移除像素后的性能反超
在不同训练规模与范式下的横向对比给出了极具一致性的结论。
在基于 9.5K 条轨迹的参数高效微调(LoRA)实验中,TextCall 展现出了比常规回传图像更强的抗过拟合能力:在细粒度高难度检索基准 V*Bench 上,TextCall 跑出了 76.96% 的准确率,而遵循传统回传图像机制的模型仅录得 71.73%,TextCall 取得了超过 5 个百分点的显著领先。在小数据量下,强制让模型去理解低分辨率或局部畸变的新增裁剪像素,反而可能成为一种优化噪声;而单纯迫使模型生成精准的调用文本,相当于对大模型的内部视觉表征进行了一次强制性的“隐式注意力对齐”。
当数据量扩展到 65K 条完整轨迹、进行全参数微调(Full Fine-Tuning)时,这种现象依然坚挺。在涵盖精细视觉搜索、超高分辨率理解(HR-Bench-4K/8K)、通用多模态逻辑(MMStar)以及 2D/3D 空间关系推理(CV-Bench)的 6 项核心基准测试中,TextCall 相比于回传图像的完整方案,不仅没有出现性能滑坡,反而以 6 项平均 +1.39 个百分点的微弱优势胜出。
更为戏剧性的对比出现在后训练(Post-Training)的强化学习阶段。团队基于 GRPO 算法,在完全相同的超参数、批大小与奖励函数设定下,分别对 TextCall 模型与图像回传模型进行强化学习训练。结果显示,常规的“用图像思考”模型在经历了大约 300 个 step 后,工具调用率迅速溃塌至接近 0%,最终完全退化为一个不再调用任何工具、直接蒙答案的普通视觉问答模型;相反,TextCall 在经历前期的探索波动后,工具调用率迅速稳定在 75% 左右,持续在上下文中生成工具脚手架并保持稳定的推理能力。
这揭示了视觉强化学习中一个极少被讨论的工程隐患:在多模态 RL 阶段,引入外部图像环境的观测反馈极度容易引发策略梯度的方差爆炸。环境返回的裁剪子图哪怕存在几个像素的偏差,就可能导致下游视觉特征与语言回答之间的奖励信号产生剧烈抖动,促使优化算法迅速收敛到“放弃工具、直接输出语言”这一局部最优解中;而 TextCall 将整个状态转移严格限定在纯文本空间,使得奖励信号的传播路径高度平滑,显著降低了多模态强化学习的训练坍塌风险。
脚手架内部的解剖:思考意图还是空间代码?
既然证明了返回的新像素是冗余的,那么剩下的那个“工具调用脚手架”到底是如何单独扛起视觉推理增益的?研究人员通过两组深入实验,进一步打开了这一黑盒。
首先是一项基于高质量轨迹的数据审计。研究人员将原始图片输入评测模型,分别对比了“仅提供模型生成的最初一段思考+裁剪代码”与“提供真实裁剪图像”两种输入。数据审计显示,只要向模型注入那段不到一百词的工具调用代码和意图说明,下游判断的准确率提升幅度,就已经完全覆盖了提供裁剪图像所带来的增益。换句话说,模型在决定调用工具的瞬间,它的视觉隐空间其实就已经“看见”并“理解”了目标,只是需要一段显式的外化标记将其固定下来。
进一步的消融实验则针对脚手架的两个核心组件展开:
-
纯意图(Reasoning only):在脚手架中仅保留文字分析,删掉具体裁剪坐标的代码块;
-
纯坐标(Code only):删掉文字分析,仅保留坐标代码;
-
完整脚手架(Reasoning + Code):二者兼备。
实验结果清晰地表明,这两者缺一不可,但在不同类型的视觉任务中扮演着不同的主导角色。在以几何位置、相对空间感知为主的 CV-Bench 与 V*Bench 上,包含明确坐标的空间代码权重最高,删掉坐标代码会导致准确率显著下滑;而在高分辨率图表解析、密集文字识别等高层语义任务中,包含推理意图的文字分析起到了方向盘的作用,它引导模型在原图的全局特征中进行语义重加权。只有当模型同时写出“我要找什么”和“它大概在坐标系哪一部分”时,内部表征才被最彻底地激活。
算力账本与范式重估:从工程落地到基准反思
TextCall 带来的最直接冲击,首先体现在端到端系统架构与算力账本上。
在传统的多模态 Agent 部署中,每次工具调用都需要经过“解码调用指令 $\to$ 后端沙盒裁剪图像 $\to$ 图像再次经过视觉编码器(Vision Encoder)处理成视觉 Token $\to$ 视觉 Token Prefill 注入 Transformer 上下文 $\to$ 解码后续 Token”这一冗长而脆弱的管线。在很多现代多模态模型中,一个简单的局部裁剪图就会注入数百甚至数千个视觉 Token,导致后续解码的注意力计算量和 KV Cache 内存占用急剧膨胀。
在基于两张 H20 GPU 的单样本基准测试中,TextCall 彻底消除了图像重新编码与 Prefill 的耗时:
-
延迟大幅缩减:在 V*Bench 上的端到端推理总耗时降低了 29% 至 46%;
-
吞吐量随生成速度加速:分析表明,随着底层推理框架解码吞吐的提升(例如通过 Speculative Decoding 或算子优化),视觉 Token 的 Prefill 开销在整体延迟中的占比会越来越大,TextCall 带来的相对加速比还会逼近 50%;
-
系统复杂性归零:系统无需再维护庞大且容易超时的多模态交互沙盒,外部环境不再需要动态传输二进制图像数据,只相当于在纯文本环境中执行一个极简的占位回执。
但这篇工作更深远的价值,在于对多模态领域当前“Thinking with Images”狂热的一次清醒审视。这并不意味着视觉模型永远不需要看放大后的细节,而是指出了一个更尖锐的现实:现存几乎所有的多模态工具评测基准,本质上都还没有构造出真正“非看高清像素不可”的绝境。
在现有的高分辨率基准和搜索数据集中,原图在经过动态分辨率分块编码后,其深层特征空间内其实已经隐式包含了回答问题所需的大部分信息。模型此前答不对,很多时候不是因为原图分辨率不够导致信息丢失,而是因为注意力机制在数千个视觉 Token 组成的浩瀚特征中发生了“注意力迷失”(Attention Drift)。工具调用的真正功劳,不是带来了新的信息量,而是充当了一个显式的“外挂注意力引导器”——模型通过在自回归解码中写出坐标和意图,强迫自身的注意力矩阵在下一轮对原图特征的特定局部进行重新加权。
这项研究划定了一条清晰的技术边界:在现阶段的应用落地中,只要任务并没有超越原图编码的理论信息极限,研发团队完全可以放弃高开销的图像回传机制,采用 TextCall 这种“轻装上阵”的纯文本脚手架范式,零成本换取数倍的推理吞吐;而对于学术界而言,如何摆脱当前这些容易被文本脚手架“走捷径”的评测集,设计出真正需要依靠高频新像素才能解开的下一代视觉基准,才是多模态推理研究真正需要面对的硬核命题。