TimeRLM:把时序数据移出上下文!代码交互检索异常,IoU翻倍达0.682
TimeRLM: Recursive Language Models Enable Precise Anomaly Localization in Long-Context Time-Series
在工业设备监测、重症监护预警、金融高频交易监控以及云原生可观测性分析中,数据通常以连续不断的多通道时序流形式存在。一条记录可能涵盖长达数小时的高频生命体征、几天的穿戴设备传感器数据,甚至是数年的系统指标。在实际生产场景里,真正具有业务价值的事件往往极其短暂——可能只是心电图里几拍异常的心律失常、睡眠呼吸监测中十几秒的微弱觉醒,或是微服务链路中一瞬间的延迟尖峰。如何从数万甚至数十万个时间点中精准定位这些“沙丘里的针”,一直是时序分析领域的关键难题。
ArXiv URL:https://arxiv.org/abs/2608.03391v1
近年来,随着多模态大模型的火热,学术界提出了多种时序大语言模型(Time-Series Language Models, TSLMs),尝试将连续时序信号作为原生模态输入大模型,让模型直接用自然语言描述并定位异常。然而,现实却泼了一盆冷水:最新的基准评测表明,一旦时序序列跨度拉长(如上万点),单次前向推理(Single-pass)的 TSLM 在精细化检索任务上的性能会急剧崩塌。这种现象与文本领域长文本“迷失在中间”(Lost in the Middle)以及视觉大模型分辨率不足导致的微小目标失效如出一辙。
针对这一根本性瓶颈,来自苏黎世联邦理工学院(ETH Zurich)、斯坦福大学、Google、伊利诺伊大学厄巴纳-香槟分校等机构的研究团队提出了 TimeRLM。该工作放弃了把海量时序点直接塞入上下文窗口的传统思路,转而借鉴递归语言模型(Recursive Language Models, RLMs)的哲学:将整个时序序列作为外部环境中的变量,让语言模型充当“调度中枢”(Orchestrator),通过在沙箱环境中多轮编写并执行 Python 代码与数据交互。
在团队同步推出的长时序精准异常定位基准 AnomalyXL 上,无需微调的 TimeRLM 将异常定位的时间重叠度(IoU)从最强基准模型的 0.329 提升至 0.682;在“带证据分类”任务上更是达到了 0.745,而所有对比基线模型的最高得分仅为 0.072。不仅如此,团队通过强化学习对模型进行后训练,使得定位效率大幅提升,所需交互轮次缩减了整整三分之二。这项研究为长时序复杂推理与精细检索开辟了一条极具工程落地价值的全新路线。
为什么单次前向的时序大模型做不好精准定位?
要理解 TimeRLM 的突破,首先需要审视现有 TSLM 的架构局限。当前学术界处理长时序信号的方式主要分为两派:
一类是全分辨率 Patch 适配器(Full-resolution Adapters)。这类架构将连续的时序信号切分成许多短 Patch,映射为连续的 Embedding 向量直接传入 Transformer。它的优势在于保留了原始信号的全部细节,但代价极其高昂:由于自注意力机制计算与显存开销随序列长度呈平方阶 $\mathcal{O}(N^2)$ 增长,当序列长度达到数万甚至数十万个时间点时,显存迅速耗尽,根本无法支撑真正意义上的长序列。在很多评测中,这类模型甚至不得不靠固定步长粗暴地下采样,直接导致瞬态微小异常从输入端被抹平。
另一类是固定潜变量压缩(Fixed-latent Compression)。以 ITFormer、OpenTSLM-Flamingo 为代表的模型,在编码器和 LLM 之间架设池化或重采样模块(如 Perceiver Resampler),将整段时序强制压缩为固定数量的 Token。这种设计虽然将大模型的推理计算成本拉平,但在数学上带来了一个不可逆的矛盾:随着时序序列越来越长,压缩比率成倍上升,信息瓶颈日益加剧。将长达几万点的复杂多通道信号压入几十个 Token,模型顶多能感知整体走势,至于某个毫秒级脉冲到底发生在哪一个绝对时间区间,其高频信息早就已经在压缩过程中丢失殆尽。
此外,时序视觉混合模型(如 Toto)尝试将信号绘制成折线图后交给多模态视觉模型(VLM)处理,但这同样面临分辨率限制。长序列折线图在高密度渲染下,像素点会严重挤压粘连,大模型在图表上找微小异常无异于“盲人摸象”。
更关键的问题还在于过去评估指标的“掩耳盗铃”。此前很多时序问答评测为了配合单次前向模型的能力短板,往往将异常定位降级为短片段上的单选题(Multiple Choice Questions, MCQ),比如“这段数据里有没有异常?选项:A.有 B.没有”。这种选择题完全避开了实际工业和医疗监控中“指出异常起止时间戳与影响通道”的核心诉求。当面对真正的精确检索时,主流 TSLM 的表现几乎全面归零。
TimeRLM 核心机制:让模型在代码沙箱中递归探索
TimeRLM 摆脱了“把数据直接喂进 Prompt”的思维定势,其核心架构如下图所示:
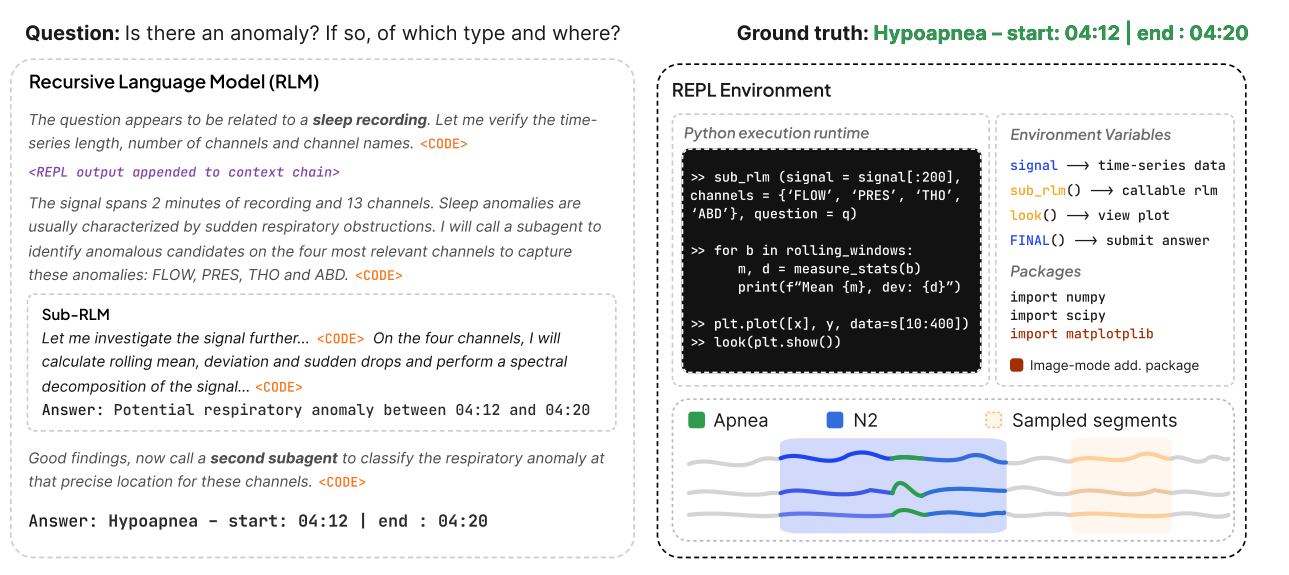
在该框架中,完整的原始多通道时序数据不进入大模型的输入上下文,而是作为一个预先挂载的 JSON 或数据变量常驻于一个安全的 Python REPL 交互沙箱内。大模型(Orchestrator)以自然语言为思考载体,以生成 Python 代码为行动手段,与时序环境展开多轮串联交互。
具体而言,这一机制包含三个层次的递进能力:
其一是代码环境直连原始信号。模型在沙箱中拥有标准 Python 数据科学库(如 NumPy、Pandas、SciPy)的支持。面对用户的提问(例如“找出通道 2 中方差发生剧烈突变的区间”),模型的第一反应不是凭空猜测,而是编写代码:先计算滑动窗口方差,再调用滤波算法,或者打印出可疑时间戳附近的统计特征。代码执行完毕后,终端的纯文本输出(如关键统计量、峰值索引)会作为观察结果返回给大模型,驱动模型展开下一步推理。
其二是主动按需渲染的可视化感知。很多时序异常形态(如特定形状的伪影、微小的周期畸变)在统计指标上并不明显,但在人类专家的视觉审阅中一目了然。TimeRLM 在沙箱中引入了图像绘图库,赋予模型主动“局部缩放”的权力。模型可以自主决定绘制某一可疑候选区间的波形图,并在后续交互中调用视觉能力“观察”这张高分辨率的局部放大图。这种“全局靠代码初筛、局部靠视觉精读”的多模态组合拳,彻底打破了传统单次前向输入的分辨率天花板。
其三是子 Agent 的递归调用(Sub-RLM)。面对多通道或跨度超长的复杂记录,根大模型可以将大任务解耦,派生出独立的子语言模型实例(Sub-RLM),针对某一个特定通道或特定的时间片段执行子查询。子 Agent 处理完局部数据后,仅向上层返回精炼的结构化结论。这种树状的递归分解,保证了任意长度的时序都不会撑爆单一 Agent 的上下文窗口。
从形式化决策过程来看,精准定位被建模为一个有限步长的序贯决策任务。在每个时间步 $t$,模型观测到当前的历史交互记录,并从动作空间中二选一:要么继续向沙箱发送一段待执行的代码 $c_t$,要么提交最终的结构化定位结果 $\mathtt{FINAL}(\hat{y})$ 终止交互。这使得模型具备了根据信号复杂度动态调整计算量(Compute at Test-Time)的能力。
AnomalyXL:专为精确定位而生的合成基准
为了检验真正的长时序异常定位能力,研究团队构建了开源基准 AnomalyXL。与以往仅提供固定短序列和简单问答的数据集不同,AnomalyXL 专为长上下文、多通道、强证据锚定而设计,其基础信号跨度从 16,000 点一直延伸到 131,072 点,覆盖最多 16 个通道。
AnomalyXL 的一大亮点在于其完全可配置的代码化异常注入生成器。研究人员在多通道平稳、周期及趋势基底信号上,精准注入了五类物理与生产中常见的异常:
-
阶跃漂移(Level Shift):在局部窗口内注入恒定的正负偏置;
-
瞬态毛刺(Transient Spike):注入类似心电异常搏动的三角窄脉冲;
-
周期紊乱(Seasonality):在局部区域混入特定振幅的额外正弦波;
-
方差异动(Variance):局部窗口内高斯白噪声方差骤增;
-
斜坡趋势(Trend):从零开始线性持续上升或下降的渐进异常。
为了全面对比单次前向与递归检索的差异,基准在相同信号上设计了两种评测形态:
-
AnomalyXL-MCQ:传统的选择题形式,涵盖存在性、起始时间早晚、异常类型、幅值范围、受影响通道以及引导滞后(Lead-Lag)关系六类问题,采用 $F_1$ 分数评估。
-
AnomalyXL-Localize:真正的硬核定位任务,要求模型直接输出包含异常起止时间戳、影响通道和异常类型的 JSON 字典。评估采用连续重叠度指标,重点计算预测区间与真实标注区间的时间重叠交并比(Intersection over Union, IoU),以及同时要求分类正确且定位重叠的“带证据分类(Classify-with-Evidence)”得分。数据集中还设置了专门的无异常样本(负样本),防止模型盲目输出伪阳性结果。
实验结果:多轮代码交互带来的压倒性代差
在 AnomalyXL 上的系统评测证明了递归代码推理对传统单次前向架构的碾压态势。
下表截取自论文在 AnomalyXL 上的关键评测数据,清晰展现了不同范式之间的性能鸿沟:
| 模型方案 | 任务交互范式 | Localize 任务 (IoU) | Classify-with-Evidence (C+E) | Localize All Channels (LAC) |
|---|---|---|---|---|
| ChatTS (Qwen3.5-4B SFT) | 单次文本前向 | 0.001 | 0.000 | 0.000 |
| OpenTSLM (Qwen3.5-4B SFT) | 压缩潜变量前向 | 0.000 | 0.000 | 0.000 |
| Toto 32B (Qwen3-VL SFT) | 视觉-时序混合前向 | 0.323 | 0.012 | 0.822 |
| 单次前向 GPT-5.5 (Image) | 单次图像输入 | 0.329 | 0.048 | 0.286 |
| TimeRLM (Qwen3.5-4B 零样本) | 递归代码交互 | 0.205 | 0.124 | 0.165 |
| TimeRLM-RL (Qwen3.5-4B) | 强化学习后训练 | 0.538 | 0.364 | 0.354 |
| TimeRLM (GPT-5.5 + Image) | 递归代码+视觉感知 | 0.682 | 0.745 | 0.551 |
从数据对比中可以提炼出几项极具冲击力的技术事实:
首先,在衡量硬核定位精度的 AnomalyXL-Localize 任务上,单次前向架构在长时序面前几乎全面失效。采用微调后的 4B 参数 TSLMs(ChatTS、OpenTSLM、ITFormer),在 Localize 与 Classify-with-Evidence 任务上的得分大多接近于 0。即使是业界领先的 32B 参数多模态混合模型 Toto,其定位 IoU 也仅停留在 0.323,且在要求“类型猜对且区间圈对”的复合指标 C+E 上直接跌落至 0.012。这表明,依靠固定的隐空间投影或折线图缩略图,大模型根本无法建立精确的细粒度时间对齐。
其次,TimeRLM 实现了质的突破。配合先进基座模型的 TimeRLM(GPT-5.5 + 图像交互)在精准定位 IoU 上直接飙升至 0.682,带证据分类得分更是高达 0.745。即使是在完全零样本、不经过任何下游时序数据微调的情况下,它也能通过调用代码编写滑动窗口检测逻辑、定位可疑峰值,在精度上彻底拉开与所有专门训练过的时序专用大模型的距离。
在企业真实生产监控基准 ARFBench Tier 2(涵盖 306 道针对实际运维遥测数据的属性判断题)上,TimeRLM 同样展现出一致的优势。其图像增强变体达到了 61.4% 的准确率和 57.9% 的 Macro-$F_1$,全面超越了单次前向大模型基线以及参数量庞大的 Toto 32B 系列。
强化学习后训练:更小的模型,更少的轮次
TimeRLM 的另一个重要探索是验证了递归时序智能体的强化学习(RL)后训练可行性。由于时序异常定位具有明确且可程控验证的数学标签(预测区间与真实区间的 IoU 是天然的数值奖励),研究团队采用群体相对策略优化(Group Relative Policy Optimization, GRPO),对开源的 4B 小模型(Qwen3.5-4B)展开了端到端强化学习。
在训练设计上,团队没有采用预先生成的固定死数据集,而是直接将合成生成器挂载进训练环境:每一个 Step 都实时合成一批全新的带噪多通道信号,使得模型永远不会在相同的数据上过拟合。同时,奖励函数中加入了 Token 消耗惩罚 $\lambda_{\mathrm{tok}}$ 以及未在预算步数内给出结论的强制终止惩罚 $\lambda_{\mathrm{fail}}$:
\[R_{i} = s_{i} - \lambda_{\mathrm{tok}} s_{i} \kappa_{i} - \lambda_{\mathrm{fail}} \mathbf{1}\{\text{forced final}_{i}\}\]这种训练机制带来了双重收益:
一方面,模型的定位性能发生质的跃升。原本未经训练的 4B 参数基础模型在 Localize 任务上的 IoU 仅为 0.205,经过仅 300 步的 GRPO 训练后,IoU 激增到 0.538,带证据分类从 0.124 提高到 0.364。这一成绩直接跨越式反超了拥有 32B 参数量的专用时序大模型 Toto(0.323 与 0.012),以小博大实现了数倍的参数效率提升。
另一方面,模型的“行动效率”被大幅压缩。在没有微调前,通用大模型写代码往往带有漫无目的的试探性,需要耗费接近 15 轮的代码交互才能勉强收敛;而经过 RL 训练后的模型学会了直奔主题的算法编排(例如先做全序列快速粗筛,再对可疑窗口做二分精修),产生最终答案所需的 Agent 交互轮次直接缩减了约三分之二。
真实临床场景的零样本迁移与局限
为了验证纯合成数据训练出来的模型是否具备现实世界的实用性,团队构建了未经任何适配的真实临床泛化测试集:包含来自长期房颤心电数据集(LTAF ECG)的 250 个两通道长窗口,以及来自睡眠多导图数据集(Sleep-PSG)的 250 个四通道呼吸窗口。在这些数据中,目标异常(如异位心搏或呼吸微觉醒)往往只占整段长记录的 1.7% 到 17.7%,并且混杂着复杂的生理伪影与基线漂移。
零样本评测显示,在没有任何真实临床数据微调的前提下,TimeRLM 在分类和定位上均超越了所有专用 TSLMs。在基线模型中,没有一个 TSLM 在真实信号上的定位 IoU 能够超过 0.004,完全丧失了定位能力。反观基于强基座的 TimeRLM,面对真实信号时自发展现出了强大的适应能力:模型在面对更复杂的真实生理信号时,自发启动子 Agent 的次数从合成基准上的平均 1.14 次主动上升到了 2.6 次,体现出任务驱动的动态自适应性。
然而,实验也诚实地暴露了当前技术栈的边界。研究人员发现,虽然在合成数据上经过 RL 训练的 4B 模型在分类判别能力上成功迁移到了真实医疗数据(LTAF 的 $F_1$ 从 0.36 提升至 0.45,Sleep-PSG 从 0.17 提升至 0.34),但其在真实复杂波形上的精确 IoU 定位性能却出现了明显回落。这说明,利用高度简化的合成信号(高斯噪声、简单趋势和正弦波)训练出的策略网络,容易将合成数据特定的数学特征当成定位 shortcut。一旦遇到真实世界中复杂的生物阻抗变化、肌电干扰和非稳态漂移,小模型在纯代码层面的阈值分割策略就会失效。这为后续研究指明了明确方向:强化学习环境中的信号生成引擎,必须进一步引入物理仿真与领域知识驱动的真实退化机制。
结语与未来启示
TimeRLM 的出现标志着时序大模型研究范式的一次重要转向。长期以来,学术界普遍执着于设计更加精巧的时序 Tokenizer、更复杂的全连接时序 Patch 投影层,试图把数以万计的连续数值“塞进”神经网络的单一前向管道中。然而,信息论与计算复杂度的客观规律决定了,单一视图的前向推理难以同时兼顾长跨度全局语义与微观像素级精度。
TimeRLM 证明了一条更为优雅且符合计算直觉的路径:不要把大模型当成信号处理器,而要把大模型当成使用科学工具的分析专家。把原始高频数据安全地存放在沙箱外部,赋予模型编写代码、动态可视化渲染以及递归派生子任务的自主权,利用代码的精准执行弥补神经网络的“幻觉与模糊”,利用语言模型的泛化推理掌控全局分析节奏。这种让 LLM 充当“时序科学家”的代码交互范式,不仅在长上下文精准定位中交出了亮眼的答卷,更为复杂工业物联、智慧医疗等严苛场景中的长时序分析提供了一套极具工业落地前景的标准蓝图。