VRR-Stop:如何防止Agent越修越错?仅需0.72轮让真实正确率提升60.6%
Verify, Repair, Repeat, or Stop? Robust Stopping for Noisy Verify-Repair Loops in LLM Agents
在大模型驱动的智能体系统里,生成、验证、修复的循环(Verify-Repair Loops)几乎成了解决复杂代码生成、多步数学推理和工具调用任务的标配工作流。这一机制的直觉非常简单:初次生成的方案难免存在缺陷,引入验证器找茬,再把报错信息喂给修复器进行微调,周而复始,方案总会变得更完美。无论是早期的 Self-Refine、Reflexion,还是引入外部工具与形式化验证的方案,大多建立在这样一个隐式假设之上:多轮迭代往往会提升真实质量,而验证器的判定足以充当质量的风向标。
ArXiv URL:https://arxiv.org/abs/2607.17641v1
兰州大学、深圳星晴智体科技与 saofund.ai 联合提出的一项研究直指该范式的隐秘痛点:当验证器本身会犯错、修复器也有概率改坏原有方案时,验证-修复循环不仅无法单调改进质量,反而会演变成一种系统性风险。在实际运行中,一个原本正确的方案可能会被验证器误判,随后被修复器改得面目全非,最终却被同一个充满噪声的验证器判定为通过。这种“表观通过率持续走高,真实有效性断崖式下跌”的脱钩现象,暴露出当前 Agent 架构普遍缺乏有理论保障的退出机制。为此,作者提出了专为噪声循环设计的停止框架 VRR-Stop 以及无参数估计保底策略 VRR-Guard。在 GSM8K 压力测试下,VRR-Stop 相比固定五轮修复将最终真实有效性提升了 60.6 个百分点,平均仅消耗 0.72 轮修复就果断锁定了正确结果。
循环毒性:当验证器开始拟合噪声
在大模型智能体的长链条执行中,多轮自我修复之所以流行,是因为单次推理往往难以兼顾所有局部约束。然而,系统内部的错误并不会随着轮数增加自然耗散,反而容易级联放大。研究者发现,真实任务中的验证反馈与修复动作本质上是纠缠在一起的双重噪声源:验证器既有假阳性(将错误方案判定为正确),也有假阴性(将原本正确的方案打回);而修复器在尝试纠错的同时,也有相当大的概率破坏原本已经成立的逻辑。
这种双向失真导致了一个反直觉的动力学现象:随着修复轮数推进,群体表观通过率依然可以稳步攀升,但真实正确率在达到某个局部峰值后会迅速崩溃。
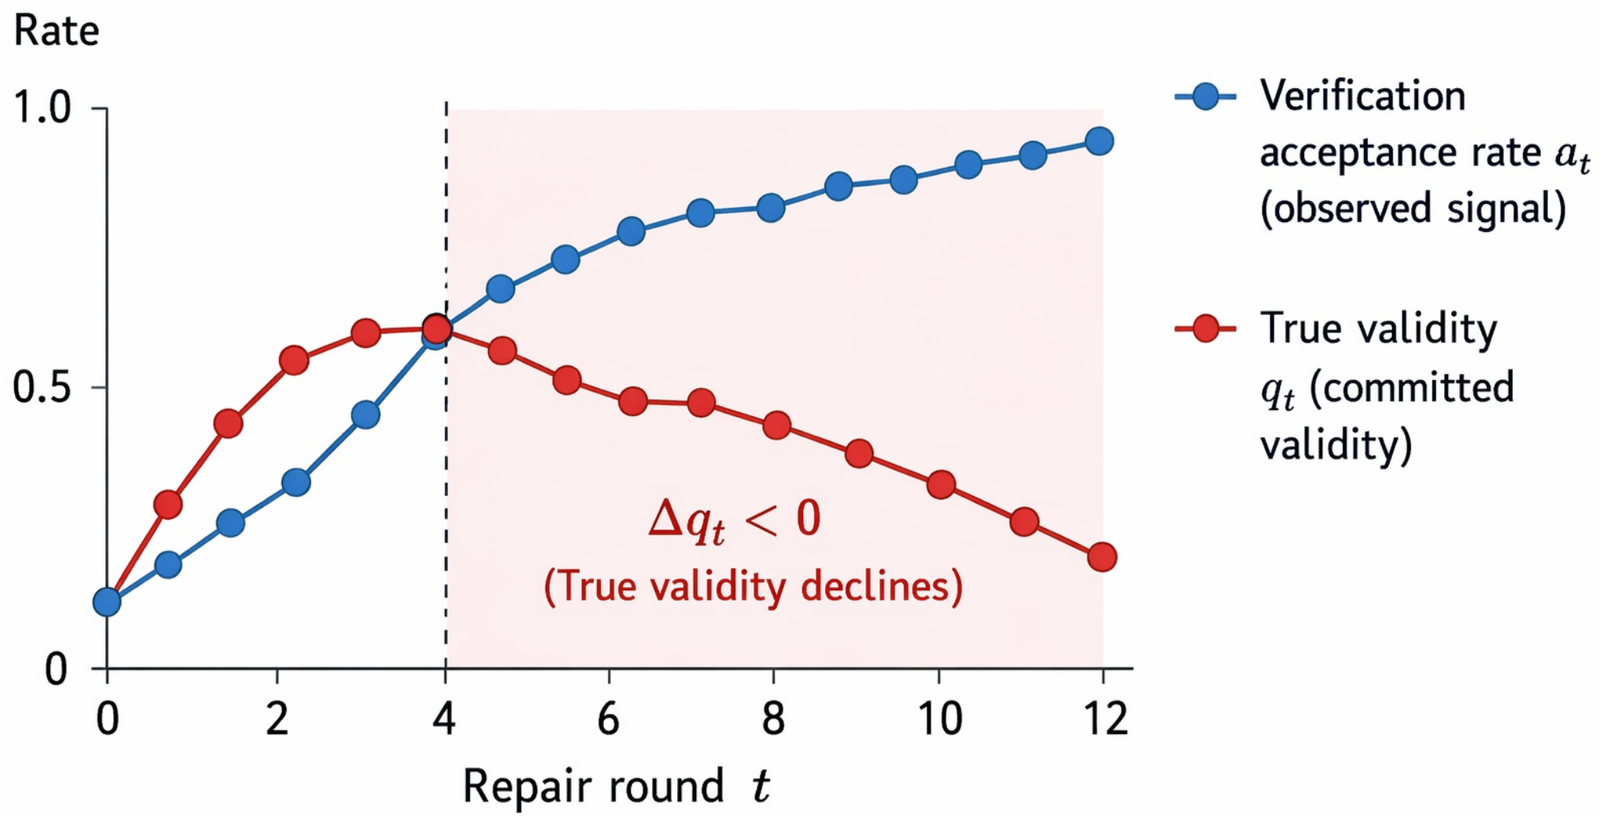
如图所示,横轴表示多轮修复的推进过程,折线清晰地呈现了表观验证率与真实有效率的背离。在阴影区域内,每进行一轮额外修复,真实质量的边际增益已经转为负值,继续修复完全变成了负收益劳动。以往的工程实现通常采用固定轮数预算、连续通过若干次即退出,或是设定置信度阈值等经验法则。但在双重噪声交织的场景下,这些规则完全无法区分当前方案是真的被修好了,还是在向验证器的噪声模式过拟合。面对不断恶化的方案,盲目设定死板的迭代预算,实质上是将智能体推入持续自毁的深渊。
四参数解耦与边际增益的符号辨识
要想在数学上定义“何时应当停止”,首先必须将验证器的判断偏差与修复器的修改行为剥离。VRR-Stop 构建了一个简洁的局部四参数噪声动力学模型:
-
$\rho_0$ 代表验证器的假阳性率,即方案本质错误却被判定为通过的概率;
-
$\rho_1$ 代表验证器的假阴性率,即方案本质正确却被误杀的概率;
-
$\alpha$ 代表修复器的修复成功率,即把错误方案修改为正确方案的转移概率;
-
$\beta$ 代表修复器的破坏率,即把原本正确的方案改错的退化概率。
在这四个参数的基础上,验证器的判别力可以用尤登指数(Youden’s $J$)来刻画,即 $J = 1 - \rho_0 - \rho_1$。只要 $J > 0$,验证器就保留了区分正确与错误的统计能力。
在实际执行过程中,系统在第 $k$ 轮会对当前方案发起 $M$ 次独立的验证查询,收集到的通过次数为 $S_k$。VRR-Stop 的第一步是利用贝叶斯信念滤波(Belief Filtering),结合历史验证记录与当前噪声参数,推断出当前方案为真时值得提交的后验概率 $b_k$。必须强调,$b_k$ 绝非表面的投票比例,而是剥离了验证器假阳性干扰后的真实置信度。
有了后验概率 $b_k$,决定是否继续修复的核心依据,就变成了再执行一轮修复所能带来的真实边际增益 $G_k$:
\[G_k = (1 - b_k)\alpha - b_k\beta\]这个公式给出了极为清爽的物理图景:继续修复的期望收益,来自于“当前做错被修复的增益”与“当前做对被破坏的损失”之间的博弈。当增益 $G_k > \tau$($\tau$ 为容忍的最小计算收益边际)时,系统选择继续修复;一旦 $G_k \le \tau$,哪怕验证器依然亮起红灯,系统也应立刻停止并提交结果。
这一设计带来了一个极其关键的理论突破:停止决策仅依赖边际增益的“正负符号”,而不需要精确无误地拟合所有参数。在弱监督场景下,要绝对精准地估计大模型在特定任务上的错误率代价极高,但只要后验估计误差没有大到逆转 $G_k$ 的正负号,停止决策的动作就与基于真实全知参数所做的决策完全一致。论文证明了在满足特定误差界条件时,符号辨识度可以得到严格概率保证,这极大地降低了弱监督标定的样本复杂度。
标定失效时的底线防线:VRR-Guard
依靠统计推断做决策虽然优雅,但在现实极端工况下,模型往往会遇到所谓“盲人判案”的至暗时刻——当验证器的判别力 $J$ 趋近于 0,甚至退化为纯随机扰动时,期望最大化(EM)算法的似然曲面会彻底扁平化,哪怕增加校准样本量,估计误差也会急剧扩散并反转增益符号。
为了应对这一估计崩溃,研究团队提出了不依赖参数估计的安全回退机制 VRR-Guard。VRR-Guard 的核心哲学非常审慎:它在内存中始终维护一个历史最佳候选方案(Incumbent),新一轮修复生成的方案不能仅凭单次通过就直接上位,必须在验证通过次数上跨越一个严格的保护裕度 $\delta$:
\[S(p_{k}) \ge S(c_{k-1}) + \delta\]只有当新方案的验证优势显著超越当前候选方案时,替换才会发生。论文给出的理论分析表明,在条件独立假设下,错误替换一个原本正确方案的单轮概率被指数级压制在 $\exp\big(-(MJ+\delta)^2 / (2M)\big)$ 之内。在整个最大迭代预算内,累积错误替换的风险也被严格控制。VRR-Guard 不需要任何复杂的离线概率标定,当离线分离度测试发现验证器判别力过低时,系统自动切入该机制,从而确保 Agent 系统即便在极端噪声下,底线表现也不会劣于“完全不修复”。
实验评测:打破越修越烂的恶性循环
为了验证 VRR-Stop 的鲁棒性,研究团队在数学推理(GSM8K、MATH-500)、代码生成(MBPP)和工具调用(BFCL)等多项任务上展开了严苛的压力测试。模型选型覆盖了 Qwen2.5、Mistral 和 Llama 等主流开源生态,基准线涵盖了固定五轮修复(如通用 Self-Refine、Reflexion 配置)、多数票提前终止、置信度阈值法,以及仅作理论参考的真实全知参数近视策略(TPM)。
在 GSM8K 配合 Qwen2.5-3B 的错配压力场景下,多轮修复的破坏性展现得淋漓尽致:
-
固定轮数退化惨烈:直接采用固定五轮修复的策略,让原本未修复时 0.700 的正确率暴跌至 0.116。在包含 500 条样本的压力追踪中,有高达 55% 的用例发生了“原本正确的解被修复器改错”,且这些改坏的解里有 24% 竟然获得了验证器的多数票支持,充分印证了无脑多轮迭代的有害性。
-
VRR-Stop 精准止血:VRR-Stop 在该设置下不仅完全规避了性能塌陷,还将最终真实有效性拉升至 0.722,相比固定五轮修复实现了 60.6 个百分点的惊人提升(McNemar 检验 $p < 2\times 10^{-85}$),同时大幅优于多数票规则(+3.2 pp)和置信度规则。
-
极低的计算开销:VRR-Stop 做出这一决断的代价极小,平均仅消耗了 0.72 轮修复。在大量本就不需要修复或越修越错的样本上,系统在第一轮甚至第零轮便敏锐察觉到边际增益为负,果断选择 Commit 提交,在节约计算资源的同时牢牢锁住了准确率。
-
跨域普适性:在 MATH-500 搭配过程奖励模型(PRM)的测试中,尽管验证器辨别力高达 $J=0.77$,固定五轮修复仍将准确率从 0.798 磨损到 0.150,而 VRR-Stop 成功稳住了 0.798 的初始胜果,证明即便使用较强的检验模型,无约束的修复同样极具破坏力。
辨别力与决策边际的相变图景
深入分析校准误差对停止决策的影响,研究进一步揭示了决定系统可靠性的底层规律。传统的直觉常常认为“估计参数越准越好”,但实验数据表明,停止决策的翻转风险并不单纯取决于参数估计误差的绝对大小,而是由验证器判别力 $J$ 与决策边际 $\Delta = \lvert G_k - \tau \rvert$ 共同主导。
在系统性的网格实验中,当 $J \le 0.15$ 且 $\Delta \le 0.10$ 时,增益符号估计错误的概率迅速升至 0.183;而一旦 $J \ge 0.4$ 或决策边际扩大至 $\Delta \ge 0.30$,错误翻转率骤降至 0.014,两者差距达到 13 倍。以具体的跨架构模型为例,Qwen-3B、Qwen-7B 和 Mistral 均展现出 $J \ge 0.18$ 的合格判别能力,VRR-Stop 的表现与全知参数参考线的差距均控制在 2.8 个百分点以内。相反,当换用判别力仅有 $J = 0.03$ 的极弱验证器时,哪怕决策边际高达 0.74,EM 估计依然因似然函数平坦而崩溃,导致最终有效率大幅跳水 58 个百分点。这一对比恰恰印证了判别力相变边界的存在,也从反面坐实了在低判别力区间部署 VRR-Guard 兜底策略的必要性。
结语:从盲目迭代到理性收敛
长期以来,社区在探索推理期扩展(Test-time Scaling)和 Agent 反思框架时,往往将精力集中于“如何生成更详尽的诊断提示词”或“如何构建更大的过程奖励模型”。这项工作以严谨的概率建模和详实的控制实验提醒我们:自我纠错并不是单调收敛的魔法,在充满不确定性的现实交互中,懂得适时收手往往比盲目纠偏更加重要。
VRR-Stop 将纠错机制中的“验证噪声”与“破坏行为”成功拆解,用极轻量的符号辨识原则替代了沉重且脆弱的全局标定,再辅以 VRR-Guard 构筑安全底线。这一范式不仅为各类多轮智能体工作流装上了灵敏的“刹车系统”,更为理解模型自我反省的边界提供了清晰的理论标尺。在追求复杂 Agent 深度自主的道路上,这类关于停止与回退的稳健性设计,无疑是迈向工业级高可用不可或缺的一环。