VTO:过程监督强化学习编排视觉工具,多步异常检测超越72B大模型
VTO: Visual Tool Orchestration for Video Anomaly Detection
在现实世界的智能安防与公共安全监控中,突发异常从来都不是孤立的切片,而是一连串动态演化的因果链条。两名行人的推搡摩擦可能瞬间升级为持械斗殴,进而引发密集人群的恐慌与踩踏;一处角落的隐蔽火花可能伴随可燃物迅速引燃浓烟,造成重大次生危害。然而,长久以来的视频异常检测(Video Anomaly Detection, VAD)主流方案,大多停留在闭集分类或单帧异常打分的传统范式上,不仅难以泛化到开放场景,更无法解释异常背后的物理逻辑与事态走向。
ArXiv URL:https://arxiv.org/abs/2608.08219v1
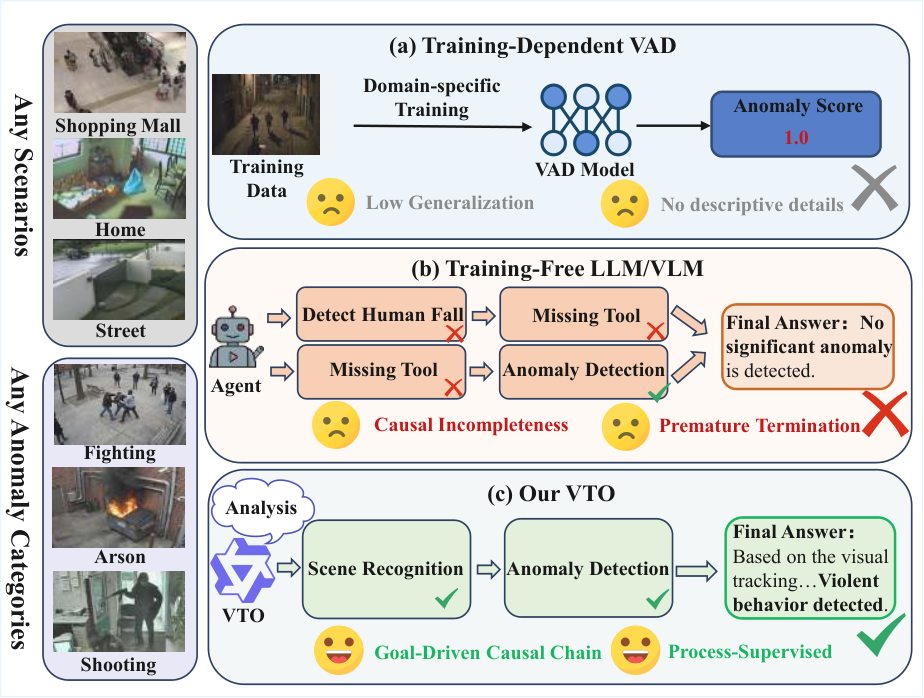
为了突破这一瓶颈,学术界近年开始探索利用多模态大模型(MLLM)充当智能体(Agent),调用外部视觉专家工具进行场景分析。但现有的 Agentic VAD 系统面临着两难困境:纯粹依赖监督微调(SFT)的行为克隆难以应对复杂的跨工具编排;而若直接引入标准强化学习(RL),由于现实视频分析的奖励反馈过于延迟且粗粒度,智能体往往只要检索到一个局部表象(例如检测到有人倒地),就会为了稳拿正向奖励而“见好就收”,直接触发终止动作。这种严重的“过早终止”(Premature Termination)缺陷,使系统彻底遗漏了深层的连锁隐患,无法建立完整的因果推理链。
针对这一根本顽疾,来自北京邮电大学等机构的研究团队提出了全新的过程监督强化学习框架 VTO(Visual Tool Orchestration)。该工作彻底抛弃静态的端到端黑盒映射,将异常检测重构为一个在动态物理视频环境中主动探索、调用工具并吸收多模态反馈的认知决策过程。配合专门构建的包含12类视觉专家的 VAD-Tool 评测基准,VTO 通过融合客观规则与大模型认知裁判的双重过程监督机制,重罚推理断层、重赏完整因果链。实验显示,经此训练的 8B 参数小模型在复杂多工具关联调度任务上的整句推理准确率达到 95.14%,工具调度准确率绝对提升高达 10.2%,全面超越了参数规模近十倍的 72B 闭源级大模型。
从“死记硬背”到“主动排查”:复杂异常场景的认知重构
在传统的监控视频分析中,模型通常直接接收连续视频帧,输出一个介于0到1之间的异常分数,或者从固定分类标签列表中挑选一项。这类方案在特定受限数据集上表现尚可,一旦部署到复杂现实场景,既不能适应未见过的异常类型,也无法回答“发生了什么”与“接下来可能发生什么”。
引入多模态 Agent 后的直觉思路,是让大语言模型充当大脑,当下达“检查现场安全状况”的指令时,自主调度目标检测、行人重识别、烟火探测等专用视觉小模型。此前一些探索(如 PANDA)证明了工具调用的可行性,但普遍止步于两类机制:要么采用无需训练(Training-Free)的 Prompting 试凑,要么采集标注轨迹进行监督微调(SFT)。这两类方式本质上都在让模型做模式匹配与行为克隆。面对开放世界里错综复杂的级联险情,静态克隆不仅容易出现曝光偏差(Exposure Bias),更缺乏根据环境连续反馈调整后续步骤的动态推理韧性。
更严峻的挑战发生在尝试引入强化学习之时。在多步推理中,如果仅在整个轨迹结束时根据最终结论给出一次性结果奖励(Outcome Reward),智能体很快就会学会走捷径。在视频安防场景中,这一捷径往往表现为:智能体在第一步调取跌倒检测确认有人倒下后,立即输出总结报告并终结会话,获取基础安全分,而对紧随其后的踩踏、持械等致命次生风险视而不见。这种逻辑截断现象在安全关键领域是不可容忍的。
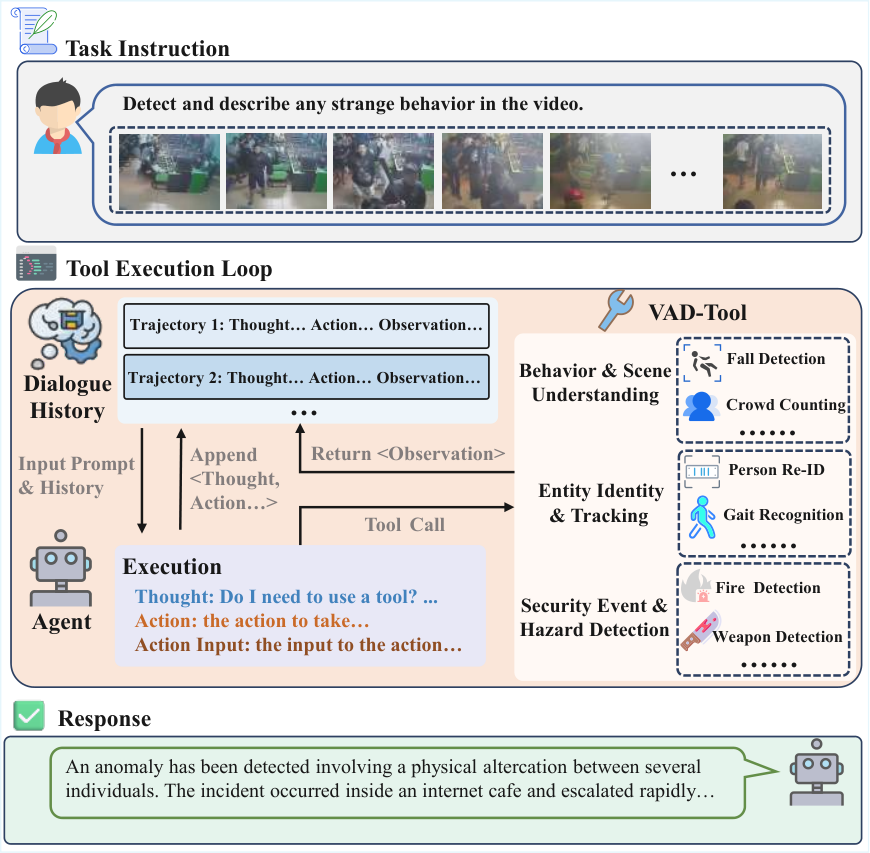
VTO 的突破点在于,将视频和图像直接定义为 Agent 交互的动态物理环境,将多层次的视觉专家模型作为 Agent 的离散动作空间,并通过过程监督机制,对智能体思维流(Thought)、工具选择(Action)和参数落地(Action Input)的每一步实施细粒度审查。
动态交互基石:层次化视觉工具箱与 VAD-Tool 基准
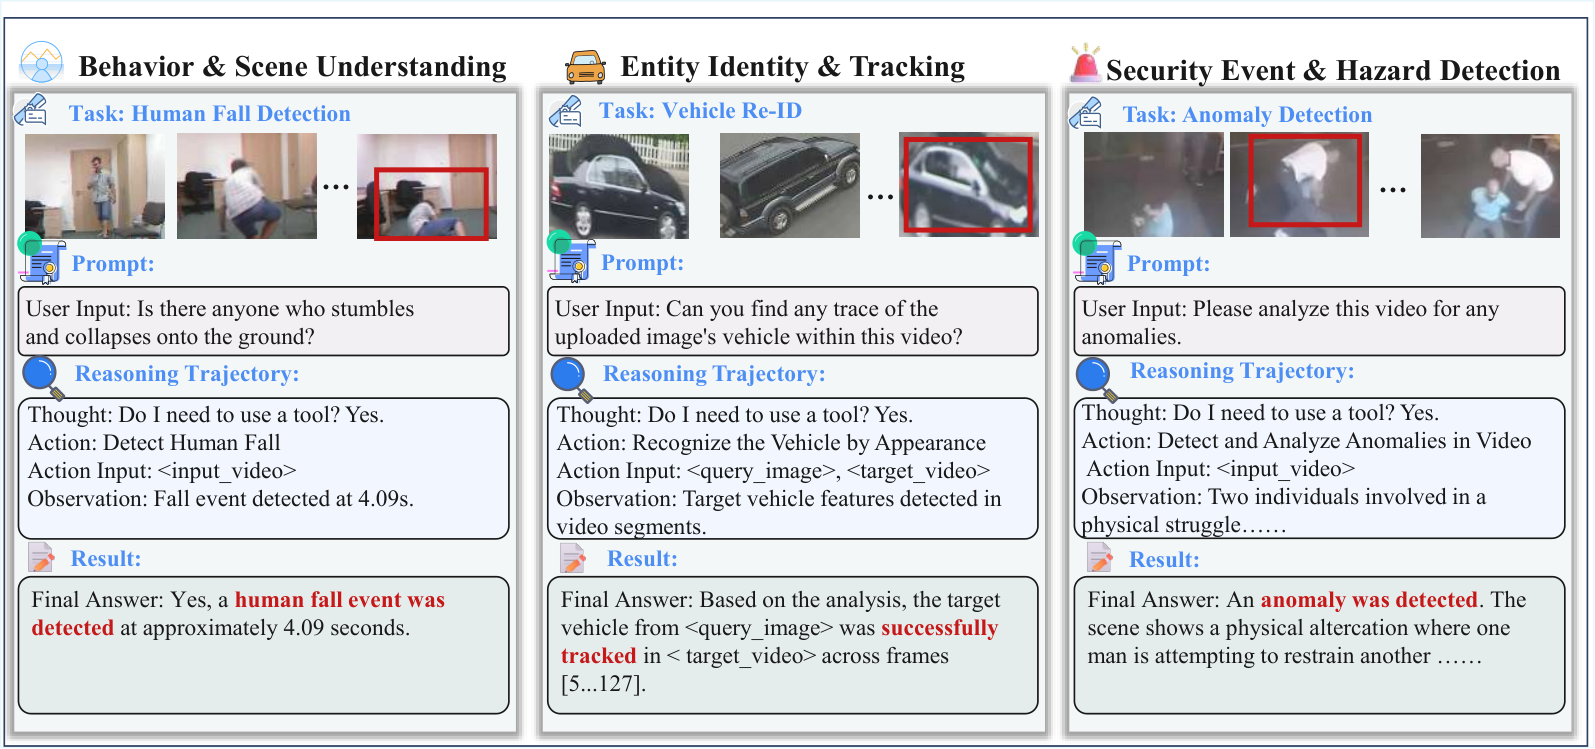
为了让 Agent 具备真正的现实排查能力,动作空间的设计必须紧贴实际安防管辖链条。VTO 团队系统梳理了公共安全事件的业务逻辑,将核心视觉诉求解构为三大功能层级,整合了12个独立的视觉专家模型,构建了 VAD-Tool 动作空间:
-
实体追踪与识别(Entity Tracking):包含行人重识别(Person Re-ID)、车辆重识别(Vehicle Re-ID)、车牌识别(License Plate Recognition)和步态识别(Gait Recognition),用于锁定异常主体的时空轨迹与身份线索。
-
行为理解(Behavior Understanding):涵盖人体姿态估计(Human Pose Estimation)、人体跌倒检测(Human Fall Detection)、暴力行为检测(Violence Detection)和密集人群计数(Crowd Counting),聚焦人身状态与交互意图的深度解析。
-
高危灾害排查(Hazard Detection):集成火灾与浓烟检测(Fire & Smoke Detection)、管制刀具与武器检测(Weapon Detection)、局部场景异常检测(Scene Anomaly Detection)以及常规通用异常检测(General Anomaly Detection),负责极端危险源的瞬时告警。
单纯拥有工具并不足以训练协同推理。现实事件往往高度交织,例如要确认是否存在恶意蓄意斗殴,必须同时结合骨骼关键点追踪与暴力动作分类(基于姿态的暴力检测);要分析火灾是否引发逃生混乱,必须协同调用烟火探测与人群计数。为此,研究团队设计了一套人在回路(Human-in-the-Loop, HITL)的数据合成与校验管线。
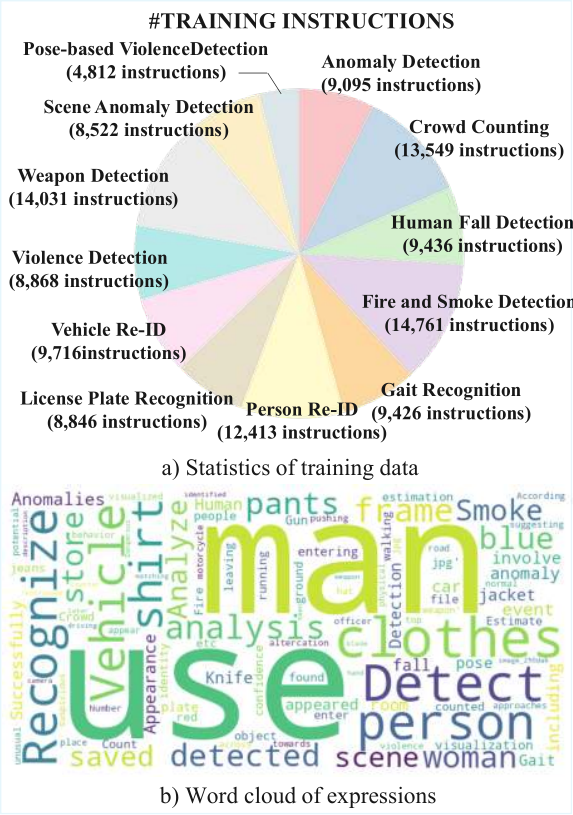
数据构建依托 Qwen2.5-VL 生成标准 ReAct 格式(Thought、Action、Action Input、Observation)的初始多步执行轨迹,随后利用大语言模型在语义层面对人类提问指令进行极端多样化的重写扩充,确保相同的因果推理逻辑能够匹配五花八门的用户提问口吻。最后,由安全领域的专业分析人员逐条进行逻辑纠偏与事实审查,消除工具错调、虚构参数和因果倒置。最终沉淀出的 VAD-Tool 数据集包含超过12万组高质量“指令-轨迹”对,累计 Token 规模达 1548 万,在12类工具上形成了均衡且密集的分布。
过程监督强化学习:如何精准击碎“过早终止”?
拥有高质量冷启动数据后,VTO 并没有止步于 SFT,而是将训练划分为两个逻辑递进的阶段:第一阶段采用参数高效的 LoRA 进行 SFT,让基座模型掌握严格的 ReAct 输出句法、建立异常物理事件的表征,并学会解析底层视觉模型输出的专有格式(如边界框坐标、关键点列表、追踪 ID 等)。在此之后,模型全面切入第二阶段——基于过程监督的认知对齐强化学习。
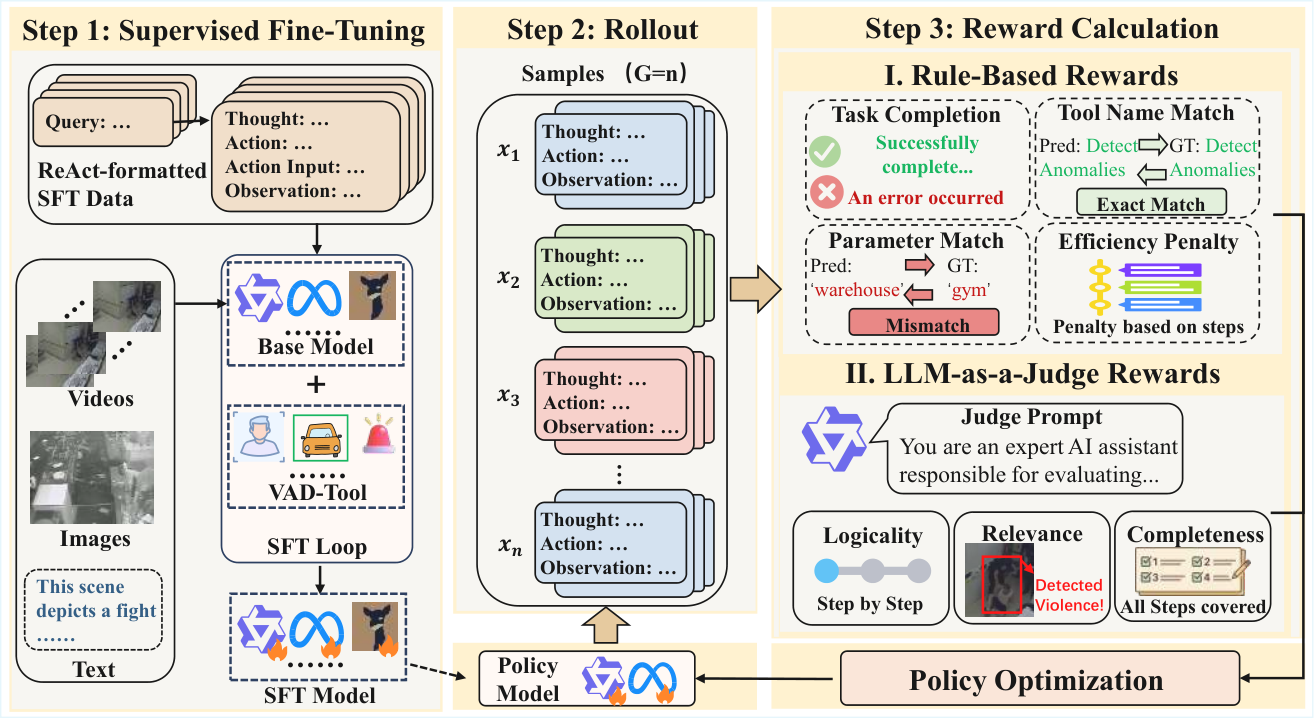
在强化学习的采样探索(Rollout)阶段,策略模型并行生成多种推理轨迹。由于视频长上下文与工具反复交互的内存开销极大,传统的 Actor-Critic 架构(如 PPO)需要维护庞大的价值网络,显存压力极高。VTO 采用了群体相对策略优化(GRPO),从同一 Query 采样的 $G$ 条候选轨迹中计算相对优势值:
\[\hat{A}_g = \frac{R_g - \text{mean}(\{R_1, \dots, R_G\})}{\text{std}(\{R_1, \dots, R_G\}) + \epsilon_{std}}\]这种设计直接省去了独立的 Critic 模型,使团队得以在有限的计算资源下,使用 SGLang 异步引擎以全参数微调的形式对多步策略展开深度训练。
整个优化的核心引擎,是每一步执行后触发的双轨过程奖励机制(PRM)。总步阶奖励 $r_t$ 由客观规则奖励 $\mathcal{R}{\text{rule}}$ 与认知裁判奖励 $\mathcal{R}{\text{LLM}}$ 线性组合而成:
\[r_t = \mathcal{R}_{\text{rule}} + \mathcal{R}_{\text{LLM}}\]其中,客观规则奖励 $\mathcal{R}_{\text{rule}}$ 由四项确定性指标严格锁死:
-
完成度奖励 $\mathcal{R}_{\text{comp}}$:核验轨迹是否在正确节点输出终止标记,对中途陷入死循环或未完成基本排查即退出的行为施加严厉惩罚。
-
工具名称准确性 $\mathcal{R}_{\text{tool}}$:对比所选视觉专家名称与当前场景状态的严格契合度。
-
输入参数真实性 $\mathcal{R}_{\text{param}}$:严格检验传入工具的目标框坐标、时间截断帧数是否精准对齐环境实体,杜绝大模型的空间坐标幻觉。
-
调度效率惩罚 $\mathcal{R}_{\text{eff}}$:抑制冗余和重复调用工具的“磨洋工”行为。
然而,纯规则指标只能判断形式对错,无法评判因果推理的缜密性。因此,VTO 引入了基础大模型充当认知裁判(LLM-as-a-Judge),赋予其语义感知能力,并从三个维度输出 $\mathcal{R}_{\text{LLM}}$:
-
逻辑自洽性 $\mathcal{R}_{\text{logic}}$:评估当前生成的 Thought 认知令牌是否基于前几步 Observation 展开了合理的逻辑推演。
-
工具相关性 $\mathcal{R}_{\text{rel}}$:判断当前被选工具是否与前文推导出的排查假设高度契合。
-
因果完整性 $\mathcal{R}_{\text{complete}}$:专门针对“过早终止”痛点设计。一旦检测到物理场景中存在次生危险线索(例如已检测到暴力打架,但未进一步调度武器检测或人群恐慌分析),裁判将对过早结束的行为予以大幅扣分;只有完成闭环因果证据链的轨迹才能获得高额奖赏。
这套双轨机制从根本上重塑了策略模型的优化曲面。智能体不再把调用工具当成机械的任务清单,而是真正学会了像刑侦专家一样:顺藤摸瓜、步步验证。
实验见证飞跃:8B 小模型逆袭 72B 庞然大物
在评测中,研究团队选取了 Llama-3-8B、Vicuna-7B 以及专门的多模态底座 Qwen3-VL-8B 进行系统对比,并引入无需训练的零样本基线与强大的 Qwen2.5-VL-72B 闭源级大模型作为对照。评测不仅考察单步工具调度的准确率,更把聚光灯打在多工具强关联的级联推理场景(Interrelated Tools)上。指标细分为:是否需要使用工具的决策准确率(Decis)、工具名选择准确率(Tool)、工具参数匹配准确率(Input)以及整个思维-执行动作链条全对的综合准确率(Whole)。
实验数据揭示了纯行为克隆与通用大模型的严重局限。在面对需要多工具紧密配合的复杂级联任务时,Zero-shot 的 Llama-3-8B 综合准确率只有可怜的 4.52%,Vicuna-7B 甚至直接归零。即便是拥有海量参数的商业级大模型 Qwen2.5-VL-72B,在未经针对性因果编排优化的前提下,其多工具综合执行准确率上限也仅仅停留在 67.40%。
经过标注数据 SFT 的模型表现明显改善,但在因果编排的终极关卡上依然触碰到了天花板。以 Qwen3-VL-8B 为例,SFT 能够让其在单工具任务上游刃有余,但在多工具关联任务的综合准确率(Whole)上,卡在 89.74% 便再难寸进。模型经常在第二步或第三步发生参数漂移,或者在获得局部结果后便放弃后续工具的调用。
引入 VTO 框架后,飞跃清晰可见。基于 Qwen3-VL-8B 的 VTO 模型在多工具关联调度任务上的决策准确率(Decis)和工具选择准确率(Tool)双双登顶 100%,综合整句准确率更是大幅跃升至 95.14%,在工具调度上实现了最高达 10.2% 的绝对提升。即使是语言基座较老的 Llama-3-8B,在接入 VTO 强化学习流程后,多工具综合准确率也从 65.93% 显著提升至 72.16%,全面超越了未经流程强化的 72B 庞大模型。
为了探究各个奖励分量的不可替代性,消融实验提供了更具说服力的微观机理证据:
-
当移除完成度奖励 $\mathcal{R}_{\text{comp}}$ 时,系统的多工具综合表现发生了灾难性暴跌,从 95.14% 断崖式跌落至 29.92%。这表明如果没有全局终结信号的刚性约束,智能体会在复杂的时空图谱中彻底失去方向,陷入无限循环调用工具的死胡同。
-
当剥离参数约束奖励 $\mathcal{R}_{\text{param}}$ 时,工具输入准确率急剧下滑至 78.02%,模型开始高频出现凭空捏造视频帧编号、虚构不存在目标框的典型空间幻觉。
-
当拿掉大模型裁判奖励 $\mathcal{R}_{\text{LLM}}$ 后,虽然规则奖励依然保住了基础句法的工整,但综合性能依然下挫至 93.70%。质性分析显示,性能损失的根源正是部分样本重新出现了逻辑断层与因果早停——虽然工具调对了,但推理过程与前置观察脱节。
走向具备自主调查能力的物理世界 Agent
VTO 的价值不仅仅在于刷高了一个监控视频榜单的分数,更在于它向工业界和学术界展示了一种构建“物理世界调查员”的清晰路径。
过去业界常常陷入两极思维:要么试图依靠千亿级稠密大模型包打天下,希望多模态大模型自带无所不知的物理常识;要么退回传统方案,为每个特定摄像头写死硬编码的规则逻辑。VTO 证明了第三条路的高效可行性:以中等体量(如 8B)的开源多模态模型为推理中枢,利用现成且高度成熟的专用视觉小模型作为手脚,通过过程监督强化学习把因果逻辑注入思维轨迹。
这种架构兼具了极佳的灵活性与极高的经济性。在实际安防与工业巡检场景中,底层视觉专家模型可以像插拔插件一样根据实际需求热更新,而上层负责审时度势的大脑由于接受过严密的过程奖励约束,天然具备防早停、重闭环、抗幻觉的稳定特质。彻底击碎“过早终止”之后,大模型赋能的视觉智能体才算真正迈出了走出象牙塔、接管复杂物理世界的关键一步。