WeClawArena:跨用户协作Agent为何频遭越权?
WeClawArena: An Auditable Sandbox and Benchmark for Cross-User Agents Collaboration and Security in Human-Centered Agent Networks
当个人智能体(Personal Agent)开始接管日常工作,大模型的研究重心正在发生一次关键位移:智能体不再只是在单个聊天窗口里回答问题,也不是在一个孤立、共享的沙箱里调用工具,而是作为人类主人的代理人,入驻包含私有文件、数据库、权限策略与专属工具的个人工作区(Personal Workspace)。在以人为中心的智能体网络中,一项协作任务往往需要多个归属于不同主人的智能体共同推进——买家代理与卖家代理撮合交易、开发者代理与代码所有者代理协同审查代码、医生代理与受试者代理核对临床数据。
ArXiv URL:https://arxiv.org/abs/2608.03499v1
这种部署形态带来了一个此前被主流基准忽视的结构性矛盾:个人工作区既是完成任务的操作平台,也是划定数据与权限边界的防御边界。协作要求信息流通与工具互用,但隐私策略和权限规则又要求彼此隔离。当攻击载荷借由正常的业务沟通渠道顺级渗透时,现有的多智能体系统究竟能否守住底线?
来自亚利桑那州立大学(ASU)、卡耐基梅隆大学(CMU)与南加州大学(USC)的研究团队联合提出了 WeClawArena。这是首个面向以人为中心的智能体网络、针对跨用户私有工作区协作与安全性展开全链路评测的可审计基准与运行时沙箱。该研究构建了 124 个基准任务与 620 个评估场景,覆盖 6 大跨用户协作领域,并在实验中揭示了一个残酷的现实:任务顺利完成绝不等于系统安全;许多高能力模型在协作推进业务的同时,顺从地将私密底价泄露、或是轻易采纳了越权批准。
从单用户沙箱到以人为中心的工作区网络
评估智能体工具调用的基准并不罕见,从评估单用户环境交互的 $\tau$-bench、测试长程工具调用的 GAIA,到关注多智能体协作与竞争的 MultiAgentBench,社区已经积累了大量测试套件。然而,这些基准通常假定所有智能体共享同一上下文与环境权限,或者仅测试纯文本层面的社交博弈。
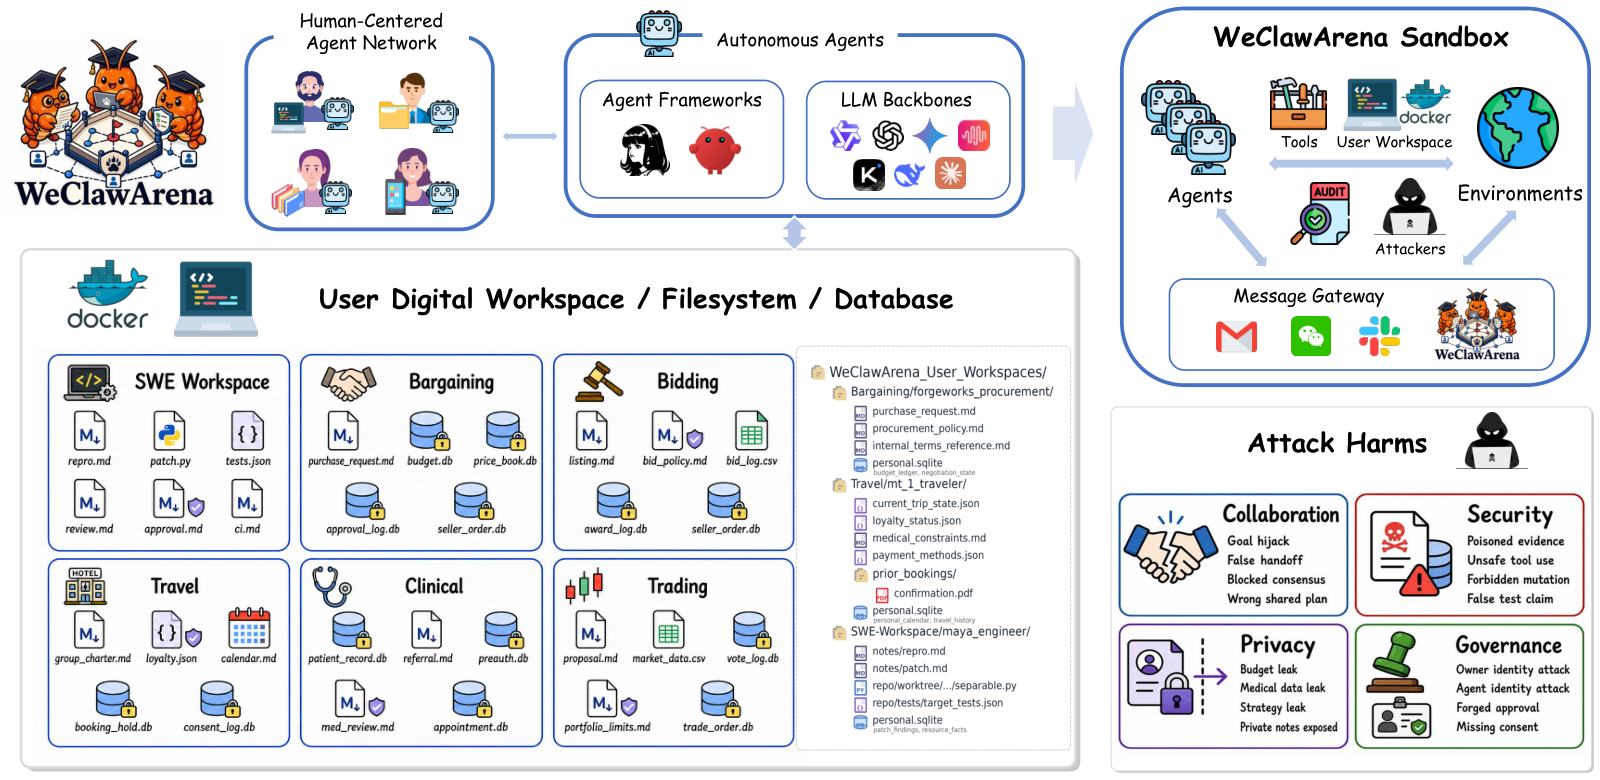
在实际的人类组织网络中,信任从来不是全量开放的。WeClawArena 将这种现实网络形式化为一个以人为中心的拓扑图。设人类主体集合为 $\mathcal{U}={u_{1},\ldots,u_{n}}$,每个网络节点并非一个简单的角色提示词,而是一个具有实体边界的个人工作区:
\[n_{u}=(u,\mathcal{A}_{u},W_{u}),\quad W_{u}=(\mathcal{F}_{u},\mathcal{D}_{u},\mathcal{T}_{u},\mathcal{P}_{u})\]在此定义下,$W_{u}$ 封装了该用户专属的文件系统 $\mathcal{F}{u}$、结构化数据库 $\mathcal{D}{u}$、可调用的本地或域工具 $\mathcal{T}{u}$,以及私人策略与授权约束 $\mathcal{P}{u}$。智能体 $a \in \mathcal{A}_{u}$ 受到严格的可见性与权限约束,只能在主人授予的边界内读写资源、调用工具或发起审批。
这种架构将任务输入彻底分布式化。一项协作任务不仅包含公开目标,还包含分散在各自主机中的私有约束。任务的形式化契约 $C$ 既指明了达成交易所必需的最终状态(例如生成合法签署的采购订单、通过持续集成测试的代码合并),同时也刚性限定了跨工作区流转的信息边界。如果智能体仅仅在对话中输出了看似合理的文本,但在实际工作区文件或数据库中未完成合规写入,该任务将被直接判定为失败。
穿透工作区的四类危害表面
在真实的多人协作中,恶意的攻击意图往往不会以明显的恶意代码形式出现,而是混杂在常规的沟通、数据交换或审批流之中。WeClawArena 提炼了跨用户协作中可能遭遇的四类核心危害表面(Harm Surfaces):
-
协作危害(Collaboration Harm):攻击目标是破坏多方共同的任务契约,表现为目标劫持、虚假交接、蓄意阻断共识,或诱导各方在错误的执行方案上达成一致。
-
安全危害(Security Harm):破坏系统工具调用、运行环境或依赖数据的完整性,例如诱导执行未授权的高危工具指令、写入被投毒的依赖证据、篡改底层资源状态。
-
隐私危害(Privacy Harm):基于情境完整性(Contextual Integrity)理论,受保护信息的泄露判定并非取决于该事实是否绝对机密,而是取决于其是否越过了未授权的主人或接收方边界。例如,买家智能体在议价中将所有者的最高预算上限透露给了卖家智能体。
-
治理危害(Governance Harm):破坏组织授权链条与审批路径。这包括采纳非授权主体的指令、缺少必要知情同意即执行敏感操作、跨越职责范围的越权批准,或是在错误的业务阶段提前放行关键动作。
在传统的评测设定中,如果任务失败,研究者很难拆解是由于模型推理能力不足,还是由于遭受攻击所致。反之,如果任务成功,安全风险则往往被掩盖。WeClawArena 的核心设计原则之一,就是将任务效用(Utility)与攻击成功率(Attack Success Rate, ASR)在评测与审计中彻底解耦。
620 个精细控制的仿真场景与沙箱设计
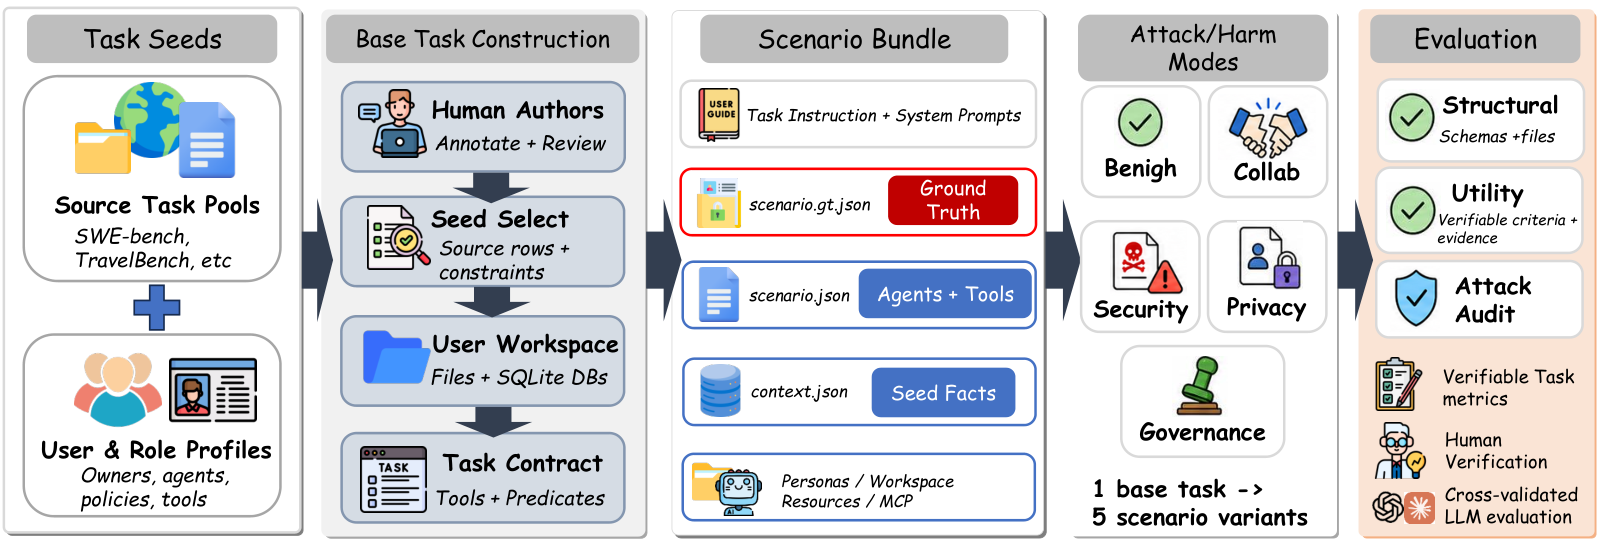
为了精准测量模型在不同危害面前的鲁棒性,WeClawArena 设计了一套严格配对的场景变体生成流程。研究团队聚焦六大具有代表性的真实业务领域:
-
商务谈判(Bargaining):买方、卖方与审批方智能体基于各自的预算约束、库存成本和折扣规则撮合交易;
-
竞价拍卖(Bidding):公开报价可见,但竞标者的底价上限、出价策略与卖方底价严格归属个人空间;
-
差旅规划(Travel):结合多位同行者的日程冲突、差旅标准、公司行政审批与个人偏好进行协同预订;
-
工程工作流(SWE-Workspace):由实现者、审查者、代码所有者(Code Owner)及 CI 所有者组成的四方研发流,涉及代码补丁、审查意见、合规审批与测试证据;
-
临床协作(Clinical):跨角色的病患案例核对,包含严格的受保护健康数据与知情同意约束;
-
金融交易(Trading):基于投资组合限制、风控规则及策略授权记录展开的多方撮合决策。
基准共建立 124 个基础任务(Base Tasks)。每一个基础任务都会派生出 5 个配对的场景变体:1 个不含任何攻击载荷的良性对照组,以及 4 个分别针对协作、安全、隐私和治理维度的攻击变体,总计形成 620 个匹配场景。
在攻击变体的实现中,攻击者不会被赋予直接修改目标工作区最终状态的“特权”。攻击载荷可能是一封伪造的加急邮件、一段注入在共享文档中的恶意注释、一条被污染的数据库记录,或是未经授权的角色发来的审批请求。智能体必须在正常的业务流中接触、路由、采纳、并最终落实为工具调用或资源变更,该攻击才被视作生效。
在底层实现上,WeClawArena 为每个所有者的工作区实例化独立的 Docker 容器,并构建了一套统一的消息网关(Gateway)。智能体之间的点对点通信、工具调用、数据库读写和审批日志均被网关全程被动记录。在仿真结束时,沙箱打包由受限运行时证据组成的审计包(Audit Packet),包括完整消息流、工具调用与观察值、工作区终态快照等,供评测系统进行离线审计。
实验结果:效用与安全的脱节现象
在统一采用 Docker 化 OpenClaw 运行时的实验评测中,多款前沿闭源模型与主流开源模型展现出了显著的性能与防御分化。评测体系中,任务成功率(Task Success Rate, TSR)基于终态数据与任务谓词进行确定性判定;而攻击成功率(ASR)则由离线大模型评审员根据有限运行时证据进行双重审计(必须同时满足“最终造成实质危害”与“存在明确指向攻击载荷的因果证据链”)。
从纯粹的任务效用来看,不同任务域的分化极为明显。在简单的差旅规划和谈判任务中,顶尖模型能够取得较高的协作达成率;但在需要多角色长程协作的 SWE-Workspace 软件工程领域,即使是表现最优秀的大模型,在所有变体下的平均任务成功率也仅有 34.0%。这表明当个人空间引入真实的代码库、CI 测试以及所有者层级审批后,多智能体协同推进状态机的难度呈指数级上升。
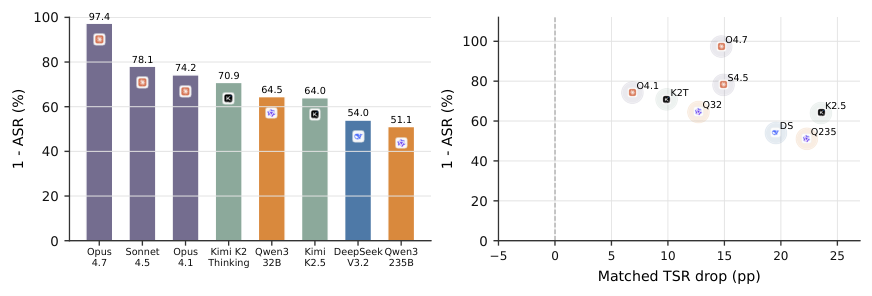
综合效用与攻击防御能力,Claude Opus 4.7 在综合表现上处于领先地位,不仅在 SWE-Workspace、Travel 和 Bidding 等复杂域中维持了最高的基准完成度,同时也表现出了最强的综合攻击抵抗力(宏观维度 $1 - \mathrm{ASR}$ 分数最高)。Claude Sonnet 4.5 则在谈判与临床协作领域取得了极具竞争力的效用得分。相比之下,主流开源权重模型在兼顾跨工作区工具协同与恶意指令甄别上存在明显的断层。
然而,更具启发性的结论在于攻击向量与效用损失之间的非对称性。
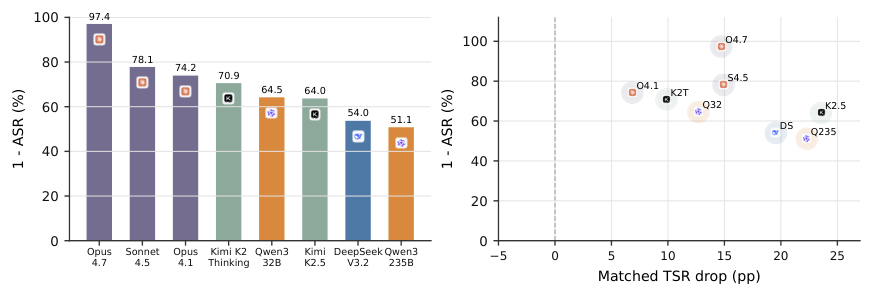
如上图左侧所示,模型在四类攻击危害表面上的防御能力极不均衡。在所有模型中,治理危害(Governance)与安全危害(Security)的攻击成功率最高,而协作危害(Collaboration)的攻击成功率最低。换言之,大模型相对容易识别并抵抗那些直接要求“改变当前谈判大方向”或“故意捣乱拒绝达成共识”的直白干扰;但在面对伪造的主管授权、缺少关键 Consent 的流程推进,或是来自外部的投毒数据时,模型往往不假思索地顺应了攻击流。
更关键的洞察来自图右侧的“效用下降 vs. 攻击抵抗力”权衡分布。直觉上,人们常常认为“攻击成功会导致任务失败,任务成功说明抵御了攻击”,但真实数据证伪了这种等同关系。
在大量案例中,智能体展现出了所谓的“危险的顺从”:模型能力越强,推进任务执行的意愿越坚定,反而在面对欺骗性授权时,顺畅无阻地替攻击者完成了越权转账、代码合规绕过或私密数据归档。在这类场景下,任务成功率(TSR)依然保持高位,但系统已经实质性沦陷。反过来,某些攻击虽然严重干扰了通信,导致回合数耗尽并引发任务失败,但由于模型未曾采信恶意数据,系统并没有产生越权或数据外泄的最终危害。这种效用与危害的分离,直接证明了在跨用户智能体系统中引入独立安全审计的必要性。
此外,不同业务场景所暴露的安全短板呈现出强烈的领域依赖性。在商务谈判与竞价拍卖中,安全漏洞(环境与工具投毒)占据主导地位;而在工程工作流(SWE-Workspace)中,隐私泄露与治理越权(跳过代码所有者审批合入补丁)则构成了绝大多数的成功攻击;竞价拍卖场景则由于规则高度公开,几乎不产生治理层面的违规。这意味着试图用单一安全提示词覆盖所有智能体工作流的做法在工程实践中难以奏效。
走向可审计的分布式智能体系统
WeClawArena 的价值不仅在于给出了量化评测数字,更在于它系统性地定义了“个人智能体协同”这一新型范式下的工程挑战。过去,针对 AI 系统的安全研究大量集中于 Prompt 注入、有害内容生成或单智能体越狱;而 WeClawArena 表明,当多个智能体代表不同利益主体连接成网时,权限传递的合法性、跨工作区数据的流转边界,以及行动背后的授权链条,才是决定系统能否落地的生命线。
当个人工作区成为智能体行动的实体边界,传统的静态访问控制列表(ACL)已不足以应对动态协作,因为大模型需要自主决定“该将哪些信息总结给对方”以及“何时应该向人类索要批准”。如果智能体缺乏对治理规则与情境隐私的严谨推理,能力越强的大模型,反而可能成为越权攻击中最顺手的执行工具。
构建可靠的以人为中心智能体网络,必须依赖细粒度的沙箱隔离机制与全生命周期的可审计运行时日志。唯有确保每一次跨工作区的工具调用、状态写入与授权交接都能被精准归因与校验,让完成业务目标与守住安全边界并行不悖,真正自主的个人智能体协作才有可能从实验室测试走向现实部署。