EffVLA:不用复杂扩散模型,动作头直接复制语言层让机器人控制快又稳!
What Makes an Efficient VLA? Navigating Action-Head Design, Scaling, and Latency
在具身智能领域,视觉-语言-动作(Vision-Language-Action, VLA)模型已成为连接多模态理解与机器人控制的主流范式。这类模型通常由三大模块拼装而成:预训练的视觉编码器(Vision Encoder)、大语言模型底座(Language Backbone)以及将表征转化为底层机械臂连续轨迹的动作头(Action Head)。
ArXiv URL:https://arxiv.org/abs/2609.13984
长期以来,业内在设计动作头时充满了“玄学”与试错。为了提高控制精度,有人引入多步去噪的 Flow Matching 或扩散机制(如 $\pi_0$、Diffusion Policy),有人使用自回归离散 Token(如 OpenVLA),也有人选择轻量级 MLP 回归(如 OpenVLA-OFT)。然而,不同方案往往混杂了不同的模型骨干、私有训练数据与评测环境,缺乏真正公平的控制变量对比。更关键的是,机器人系统运行在严格的时间预算内,动作分块(Action Chunking)通常要求端到端推理延迟必须压在几十毫秒以内,而现有研究几乎从不公开成对的硬件实测延迟。
由北京邮电大学、中国科学院、理想汽车及伦敦大学学院(UCL)等多家机构组成的研究团队,近日完成了一项大规模的控制变量基准研究。他们固定了统一的底座组合与训练管线,在相同的软硬件环境下系统消融了动作头的四项核心设计维度,并精确测量了每一组配置在 NVIDIA RTX 5090 上的端到端毫秒级延迟。研究不仅推导出一套被称为 EffVLA 的高效架构,更打破了学术界对复杂动作解码器的执念:决定动作头性能的决定性因素根本不是复杂的解码架构、损失函数或多步推理,而是权重初始化。
四维动作头解耦:初始化才是真正的核心变量
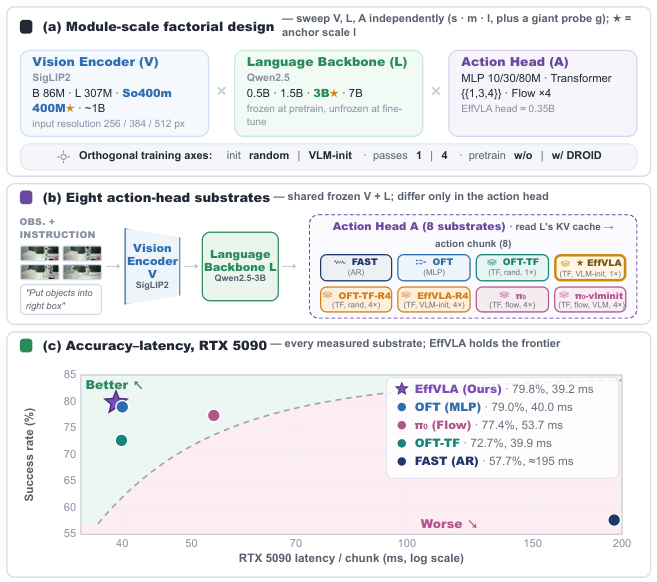
为了彻底理清动作头内部的相互作用,研究团队在 SigLIP2-So400m 视觉编码器和 Qwen2.5-3B 语言底座上固定了训练流水线(先在 DROID 数据集预训练,再于 LIBERO 进行全模型微调),并从四个正交维度拆解了动作头设计:解码架构(MLP 对比 Transformer 块)、训练损失(L1 回归对比 Flow Matching)、推理步数(单步对比 4 步迭代)以及权重初始化方式(随机初始化对比直接复制 VLM 语言层)。
通过在 LIBERO-Plus 基准上的近千次评测与 RTX 5090 实测延迟对比,实验揭示了三个极具颠覆性的现象:
权重初始化是单一最大的收益来源,且完全不增加推理延迟。将语言底座的最后几层 Transformer 块直接复制作为动作头(即 VLM-init),在 LIBERO-Plus 评测中为模型带来了高达 $7.1$ 个百分点的成功率提升。这一项调整所带来的收益,甚至超过了将语言模型参数规模从 0.5B 一路扩增至 7B 所获得的全部红利(仅提升约 2 个点)。
更为关键的是,初始化方式彻底逆转了其他架构设计的优劣逻辑。在传统的随机初始化状态下,复杂的 Flow Matching 机制确实优于单步 L1 回归,复杂的解码器也显得必不可少——这正是过去大量 VLA 研究得出“必须使用扩散或流匹配”结论的原因。然而,一旦动作头通过语言底座层进行了对齐初始化,单步 L1 回归的得分立刻反超 Flow Matching 达 $4.4$ 个百分点;更深更重的解码器不再带来额外增益,多步去噪的推理预算也毫无效果。这表明,业界此前广泛依赖的复杂生成建模,本质上只是在弥补随机初始化所导致的“表征未对齐”缺陷。
基于这一发现,团队总结出了动作头设计的第一法则:直接复制语言底座最后几层来对齐表征,其余部分保持最简单的单步 L1 回归。
为什么复制语言层管用?注意力与特征对齐的机理解析
为什么仅仅将语言模型末尾几层“搬”过来,就能让动作头产生质的飞跃?作者团队通过中心核对齐(Linear CKA)分析与跨模态注意力可视化,揭示了背后的表征传递机制。
在线性 CKA 测量中,采用语言层初始化的动作头在微调的整个生命周期中,与语言底座的表征相似度稳定维持在 $0.76$ 左右,且从靠近底座的输入层到动作输出层均表现出高度一致性。相比之下,随机初始化的动作头在训练全过程中相似度从未突破 $0.24$。
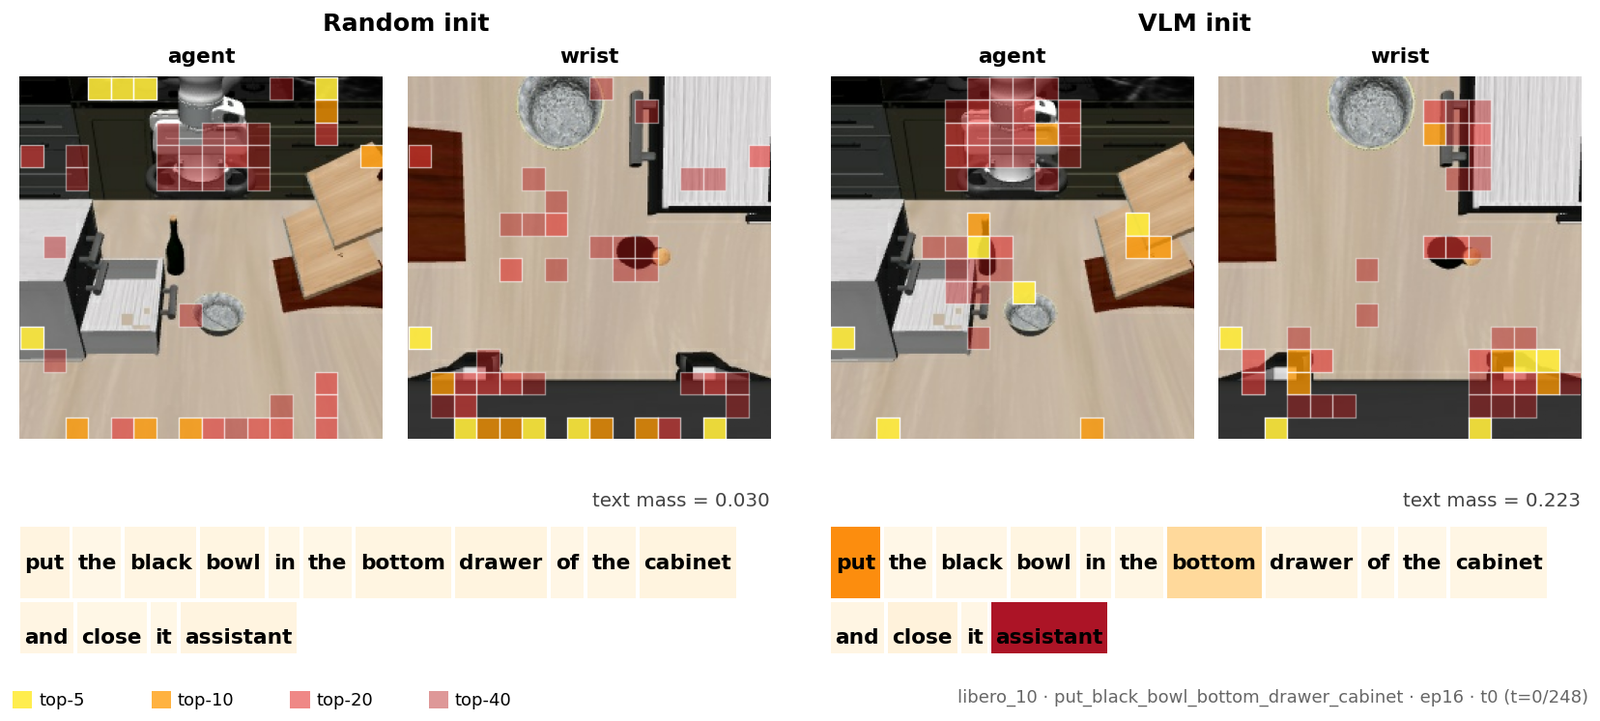
这种权重空间的继承直接映射到了控制行为的底层逻辑上。当向机器人下达“把黑碗放进柜子最下层抽屉”这类多目标指令时,对齐后的动作头能够像语言底座一样精准解析文本结构,将绝大部分注意力质量(Attention Mass)牢牢锁定在任务指令里的实体名词上(如“碗”、“抽屉”)。统计显示,对齐动作头在指令文本上分配的注意力是随机初始化动作头的四倍以上;而后者的注意力分布极度涣散,几乎未对指令文本建立有效关联,不得不从零开始学习动作规律。这直接解释了为什么 VLM 初始化的增益高度集中在涉及几何方位和自然语言变异的扰动测试集上。
算力投向哪里?先对齐,后扩容,且止于合理规模
在确定了最优的动作头架构后,下一个核心工程问题随之浮现:如果手头有额外的算力与延迟预算,究竟应该扩大视觉编码器、扩展语言底座,还是增加动作头的层数?
研究团队通过对 $V$(视觉)、$L$(语言)、$A$(动作头)三个模块独立进行从小到大的网格缩放(Scale),并绘制单位延迟增益曲线,给出了明确的资源分配指引:
-
算力回报取决于前置对齐(第二法则):只有在动作头已经对齐的前提下,扩大容量才有意义。在 VLM-init 架构下,每增加 1 毫秒的硬件延迟,扩充动作头容量能换来约 4 个百分点的任务成功率;扩充视觉编码器每毫秒约换回 1 个点,而扩充语言模型每毫秒仅换回约 0.15 个点。换言之,对齐后的动作头是边际收益最高的模块;如果动作头是随机初始化的,其扩容收益会直接缩水三分之二。
-
收益迅速触顶(第三法则):各模块的缩放收益在接近当前 $\pi_0$ 等主流系统采用的规模时出现剧烈衰减。当总模型规模达到约 3.75B 时,继续扩展视觉、语言或动作头中的任何一个,评测成功率几乎全部走平,而延迟成本却在持续攀升。在当前的具身基准下,盲目追求更大参数量并不会转化为执行精度的提升。
综合集成的 EffVLA:在开源基准与真机上的落地表现
上述三条法则直接导向了一个精简且高效的具身策略模型——EffVLA。
EffVLA 采用 SigLIP2-So400m(输入分辨率 256 像素)作为视觉端,语言底座为 Qwen2.5-3B,动作头直接复制语言底座最后 4 个 Transformer 块(约 0.35B 参数),总参数量控制在 3.75B 左右,并采用纯粹的单步 L1 回归进行连续动作输出。在 RTX 5090 上,EffVLA 实现了仅 39.2 毫秒 的端到端动作分块延迟,稳稳立在精度-延迟的帕累托最优前沿。
在标准 LIBERO 基准上,该榜单高分段已被压缩在 96% 到 99% 的狭窄区间内,EffVLA 取得了 98.2% 的高成功率,与最强的开源基线 ABot-M0(98.6%)及 OpenVLA-OFT 基本持平。
真正的区分度体现在考察抗干扰泛化能力的 LIBERO-Plus 评测集上。LIBERO-Plus 在背景、相机视角、光照、语言表述等七个维度施加了零样本扰动。EffVLA 凭借 $79.8\%$ 的平均成功率,在七项扰动测试中的六项夺得第一。特别是在相机视角扰动(比 ABot-M0 高出 7.9 个百分点)和机器人初始位姿扰动(比 OpenVLA-OFT 高出 37.9 个百分点)上拉开了明显差距,充分印证了语言底座注意力先验在抗空间干扰中的价值。
为了验证这套设计准则在现实世界中的有效性,研究团队将 EffVLA 算法配方原封不动地迁移至低成本开源机械臂 SO-ARM101(6-DOF)上。在完全不改动动作头结构与推理配置的前提下,仅将预训练数据替换为该机械臂的社区轨迹数据集,并在 5 项需要连续按指令分拣 1 至 3 个物体的真机语言控制任务上进行联合评估。在总计 50 次真实交互评测中,EffVLA 成功完成了 40 次,单物体任务成功率达到满分 10/10,证明了这种基于表征继承的高效动作头方案在物理实体上具备可靠的迁移与落地能力。
这项研究为长期依靠直觉堆叠复杂组件的具身智能领域提供了一份罕见的严谨对照参考:在设计 VLA 时,不必急于堆砌多步扩散模型或庞大的生成头;将语言底座沉淀的结构先验直接“引流”至动作头中,再辅以干净的单步回归,往往能在毫秒必争的实体控制中换来更强、更稳的性能表现。