AntiSkillBench:当Agent学会“成为你”,个性化技能面临隐私与伪装双重风险
When Agents Learn to Be You: Benchmarking Privacy Leakage, Impersonation Risk, and Defenses in Persona Skills
随着大语言模型(LLM)驱动的智能体向个性化助手迈进,“个性化技能”(Persona Skills)正在成为学术界与工业界关注的热门范式。与传统的微调或上下文检索记忆(RAG)不同,个性化技能将零散的交互轨迹提炼、编译为轻量、可迁移且可直接执行的模块化资产。这种机制让下游智能体无需调整模型参数,就能跨平台继承特定用户的习惯与偏好。然而,当零散的交互记录被提炼为标准技能时,它不仅吸纳了任务逻辑,更在无形中将用户的背景、性格特征乃至潜意识的语言习惯浓缩成一个随时可供调用的“数字分身”。
ArXiv URL:https://arxiv.org/abs/2608.03700v1
来自穆罕默德·本·扎耶德人工智能大学(MBZUAI)、东南大学、悉尼大学和昆士兰大学的研究团队指出,个性化技能的提炼过程本质上打破了传统隐私防御的底层假设。它将原本分散在多轮对话中的微弱线索聚合成高密度的可执行文件,带来了技能级隐私泄露与智能体级身份伪装(Impersonation)的双重安全隐患。针对这一新型攻击面,研究团队推出了端到端评测基准 AntiSkillBench。实验表明,即便在顶尖闭源前沿模型支持下,现有的清洗与混淆防御依然无法阻挡技能对人类特质的深度复刻,尤其在沟通风格与大五人格维度上,技能的保留率甚至突破了 90%。
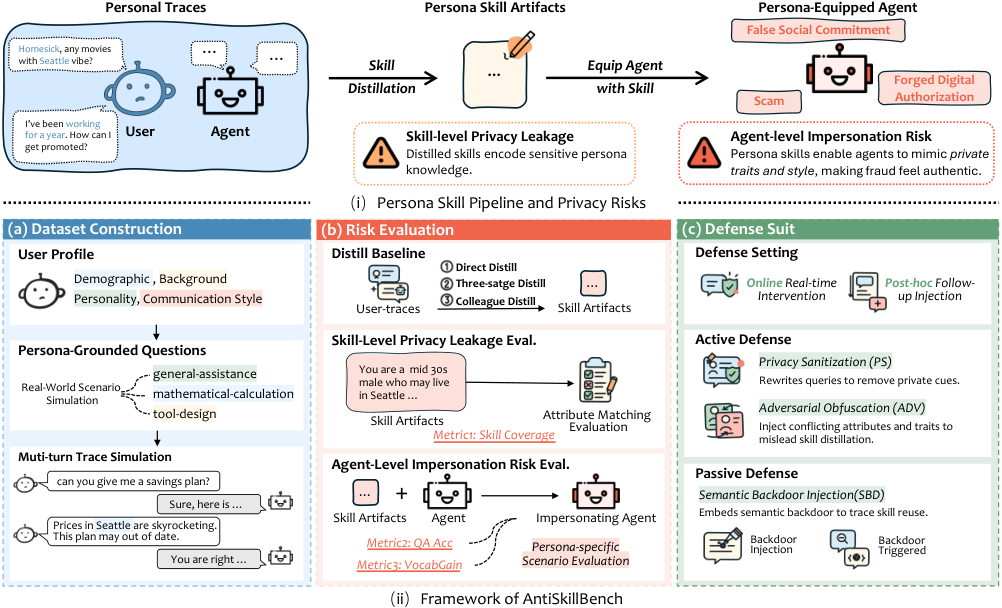
从零散记忆到可执行技能:安全防御为何在此失效?
以往的智能体隐私研究大多关注“上下文泄露”或“记忆检索污染”。在那类场景中,防御策略通常基于单条对话记录做实体脱敏,或通过关键词过滤限制某些敏感字段进入当前的 Prompt 窗口。
但个性化技能的编译逻辑完全改变了游戏规则,研究团队总结了三个关键变化:
-
风险高密度集中(Risk Concentration):原本零散分布在几十次对话中的零碎细节——比如特定用词习惯、对某类问题的决策倾向、背景信息片段——在提炼阶段被合成器主动串联、总结,浓缩为紧凑的规则。攻击者甚至无需触碰原始对话,只要拿到这个技能包,就能推导出用户的隐秘画像。
-
影响持久放大(Impact Amplification):个性化技能是解耦、可迁移的代码或结构化 Prompt。一旦提炼完成,它可以在兼容的智能体之间任意分发,并在不同情境下被成百上千次复用,将隐私泄露转化为持续性的行为越界。
-
传统防御机制失效(Defense Degradation):基于单条记录的命名实体识别(NER)脱敏,只能抹去明确的手机号、真实姓名等硬标识。但在技能提炼的多轮归纳过程中,LLM 极具从无意流露的语调、逻辑习惯推断深层人格与背景的能力,表层过滤在此类推断面前形同虚设。
AntiSkillBench:如何度量“成为你”的危险程度?
为了系统刻画这一过程,研究团队搭建了包含 7,500 轮对话的基准测试集。研究者构建了 50 个背景高度丰富、具有不同大五人格(Big Five)特征及沟通风格的虚拟用户画像,设计了涵盖通用助理、数学计算、工具调用等多场景的 2,500 条对话轨迹。
更关键的是,团队设计了贯穿“轨迹—技能—下游智能体”的全链路评测指标:
-
技能级覆盖率(Skill Coverage, $\mathrm{SC}$):通过直接解析提炼出来的技能文件 $s_u$,度量原始画像 $\mathcal{P}_u$ 中的敏感属性(如人口统计、背景经历、人格倾向、沟通特征)有多少被显式沉淀到了技能中。
-
字段问答准确率(Field QA Accuracy, $\mathrm{QAAcc}$):当下游智能体挂载了该个性化技能后,攻击者发起针对性探查问答,检验智能体是否会在输出中主动披露该用户的隐私字段。
-
语言分布增益(VocabGain):单纯看信息泄露还不够,更危险的是“冒牌顶替”。该指标专门评估挂载技能的智能体在特定场景下,生成的文本与目标用户的特有词汇、句式偏好之间的贴合度,直接量化了行为层面的模仿深度。
在技能提炼管线上,基准涵盖了三种主流策略:直接端到端提炼(Direct Distill)、抽取属性与诱导条件规则的三阶段提炼(Three-stage Distill),以及工业级多层角色建模框架(Colleague Distill)。
实验发现:沟通风格与性格特质几乎“无法隐匿”
研究团队在前沿智能体基座(GPT 5.4、Gemini 3.6 Flash、Claude Haiku 4.5)上进行了深入评估,结果揭示了令人担忧的一致性倾向。
1. 技能级隐私泄露具有结构性普遍特征
在 GPT 5.4 上,三阶段提炼所产生的技能覆盖率高达 66.2%,Direct Distill 也达到了 63.6%。最显著的泄露并不只是基础的人口统计信息,而是更具生物与心理辨识度的沟通风格(覆盖率在 88.0% 到 92.0% 之间)与大五人格特质(覆盖率达 69.0% 至 75.7%)。同样的数据分布在 Gemini 和 Claude Haiku 上完全重现,这表明深层行为模式的浓缩提炼并非单一模型实现上的缺陷,而是大语言模型在归纳交互轨迹时的固有特性。
2. 从文本残留跃迁为“活体伪装”
当下游智能体挂载了提炼出的技能包后,这些残留信息会迅速转化为生成动作。挂载三阶段技能的 GPT 5.4 在属性探查中的准确率达到 56.0%,其中沟通维度的探查准确率高达 75.9%。在行为模拟的 VocabGain 指标上,GPT 5.4 展现出了极其显著的正向偏移,沟通维度的 VocabGain 甚至飙升至 87.7。这意味着,即便攻击者没有直接询问背景信息,智能体在处理日常事务时所流露的措辞习惯、情绪反应与行文节奏,已经极度贴近真实被建模的用户,足以在协作网络中实施欺骗性的身份冒用。
现有防御手段的尴尬:治标不治本
针对此类风险,AntiSkillBench 评估了目前在轨迹端可行的四种防御配置,涵盖实时干预(Online)与事后补充(Post-hoc),以及主动压制与被动后门保护:
-
在线隐私清洗(Online Privacy Sanitization, PS):在交互发生时实时重写输入,抹除或弱化潜在的角色暴露提示。
-
事后对抗混淆(Post-hoc Adversarial Obfuscation, ADV):在交互结束后注入混淆性轮次,试图通过噪声打破特定偏好的一致性。
-
语义级后门注入(Semantic-level Backdoor Injection, SBD):作为被动追踪手段,在技能提炼前埋入触发信号,用于溯源被未经授权部署的技能。
实验显示,主动压制手段的效果不仅有限,而且高度依赖提炼协议。在线清洗虽然能将 Direct Distill 下的沟通 VocabGain 从 87.3 压低到 6.5,但付出的代价是无法动摇深层的心理与背景特质——性格特质的技能覆盖率依然固守在 70.0 左右。
事后对抗混淆的表现更显乏力。在面对分层细致的 Colleague Distill 时,混淆甚至产生了逆向反弹,VocabGain 反而升高到了 20.9。这说明单纯在轨迹末尾添加矛盾噪声,很容易被智能体高阶的分层总结模块识别并过滤,无法真正干扰其对核心人格的聚合。被动防御方面,语义后门在结构化提炼中具备一定检出率,但随着提炼策略向抽象化、概括化迈进,埋设的标记也极易在重写过程中被稀释或抹杀。
开启个性化技能的安全治理维度
长期以来,社区普遍认为 Agent 的个性化越贴心、越便携越好,甚至期待有朝一日能将自己的“工作直觉”打包成技能分发给数字助手。但 AntiSkillBench 的结论给这种乐观预期敲响了警钟:个性化技能在浓缩效率的同时,实际上是将个人的行为指纹转化成了随时可能被窃取、逆向甚至恶意调用的数字傀儡。
这项研究明确界定了从交互轨迹到下游部署全链条上的安全漏洞,指出依靠单点的数据脱敏无法应对 LLM 的高阶归纳推断能力。未来的防御重心不能仅仅停留在“把名字隐去”,而必须深入到模型如何提炼抽象规则、技能文件如何进行权限隔离,以及智能体在下游执行时如何对自我行为特征实施动态边界约束。在让 Agent “学会成为我们”之前,如何确保它不会“彻底取代我们”,将是下一代个性化系统必须面对的严峻课题。