TANGLE:当个人记忆没有标准答案,清华与蚂蚁提出大模型不可化约冲突评测
When Personal Memory Has No Single Answer: Evaluating LLM Agents under Irreducible Conflict
在大模型技术从“单次问答助手”迈向“拥有长期记忆的自主 Agent”的过程中,记忆系统一直被视为实现深度个性化的核心基石。为了记住用户的习惯、偏好和生活琐事,许多前沿系统都会在多轮跨会话交互中自动维护一个外部记忆库。然而,现实生活并不是一份非黑即白的数据库表格。一个人可以在商务宴请时偏爱高档西餐,而在深夜加班时只吃路边麻辣烫;一个人可以在戒糖和破戒复吸之间反复摇摆;甚至自述的运动打卡记录与智能手表的传感器读数也经常互相矛盾。
ArXiv URL:https://arxiv.org/abs/2608.13921v1
当用户向 Agent 提出一个并未说明具体场景、时间或条件的模糊需求时,如果模型强行在冲突的记忆中“单选”一个作为唯一真理,往往就会演变成灾难性的过度自信与误导性决策。清华大学与蚂蚁集团的联合研究团队指出了现有记忆基准的这一结构性盲区,并提出了全新的评测基准 TANGLE(Testing Agents’ Navigation of Genuine, Latent, and Entangled Memory Conflicts)。该工作抛弃了以往“冲突必须分出胜负”的单答案预设,转而考察当记忆冲突在客观上“不可化约(Irreducible)”时,智能体能否感知不确定性、保留证据张力,并采取审慎恰当的行动策略。
为什么说传统的记忆冲突测试走偏了?
回顾现有的长文本记忆与冲突解决基准,绝大多数评测范式本质上都遵循“事实查证”的逻辑。研究者预设了两个互相冲突的事实,随后期望模型通过某些确定性规则来化解矛盾。例如,通过时间戳判定最新产生的数据覆盖旧数据,通过事实核查认定某一条是幻觉或谣言,或者通过权威性标记剔除低可信度来源。在这种设定下,冲突只是信息检索过程中的噪音,模型的终极目标仍然是找到那个唯一正确的金标准答案。
但真实的人类记忆与偏好网络并非如此。大量记忆冲突之所以产生,并不是因为某条记忆是“错”的,而是因为它们各自成立的潜在变量在当前的提问中被隐去了。如果一个提问没有交代上下文、当前所处的时间阶段或裁决冲突的权威源,此时强行得出一个确定性的回答,本质上是用幻觉掩盖了信息欠定性(Underdetermination)。
以往的研究不仅把这种复杂的多状态压缩成了单选题,而且通常采用端到端的一体化测试。这意味着当模型给出一个糟糕的回答时,开发者根本无法厘清究竟是记忆提取模块在上游就丢掉了关键线索,还是下游的大模型在面对冲突信息时缺乏基本的因果分析与决策校准能力。这种评估的混淆,使得长期记忆 Agent 在落地到医疗、财务、个人助理等高风险场景时潜藏着巨大的安全隐患。
三类不可化约的冲突,与面向认知的五维评价
为了系统性地量化这一难题,TANGLE 构建了 541 个评测实例,横跨 40 种高度拟真的人物画像、46 个日常生活切面以及 10 个生活领域。与过往基准不同,TANGLE 明确定义了三类在数学上因隐变量缺失而不可化约的冲突模式:
第一类是上下文分割冲突(Context-Partitioned Conflict, CPC)。在这类场景中,记忆库中的多条记录在各自独立的上下文分区内都是绝对真实的,例如针对同一生活切面,在不同社交对象、不同风险承受度或不同预算周期下,用户的偏好截然不同。一旦用户的提问没有指明当前的上下文分区,任何单一答案都不成立。TANGLE 在该类目下设计了多达 17 种细分的上下文分割机制。
第二类是行为振荡冲突(Behavior-Oscillation Conflict, BOC)。传统假设认为用户的习惯会随时间线性演进或稳定更新,但现实中很多行为轨迹是反复横跳的。例如用户尝试戒烟、健身或调整作息,往往经历“启动—遇阻—放弃—再尝试”的非收敛震荡周期。由于提问未锚定用户此刻所处的震荡相位,单纯依赖“最新记录优先”的时效性启发式策略,极大概率会误判用户的真实状态。
第三类是信源矛盾冲突(Source-Contradiction Conflict, SCC)。同一事实在不同信源之间存在直接对立,例如用户的自述口径、家庭成员的旁证、以及第三方官方数据的记载互相冲突。由于当前任务并未赋予某一信源绝对的裁决权,信源可靠性权重处于未知状态,任何机械的信源优先级策略都会失效。
面对这种没有单一“标准答案”的评测集,评价模型表现就不能简单比对字符串匹配度或选项准确率。TANGLE 转向对智能体认知行为质量的全面审视,设立了五大评分维度(D1–D5),均采用 0 至 4 分的分级标准:
-
冲突感知(D1, Conflict Perception):考察模型是否能清晰识别并陈述出记忆库中存在的互斥信息;
-
因果推理(D2, Causal Reasoning):考察模型能否深入剖析冲突为何产生,将矛盾与具体的记忆证据进行逻辑绑定,而非泛泛而谈;
-
置信度校准(D3, Confidence Calibration):考察模型表达的确定性是否与证据充分度匹配,在信息不足时能否克制断言、提供附带条件的建议;
-
主动追问澄清(D4, Clarification Seeking):考察模型能否敏锐指出缺少哪项关键变量即可化解矛盾,并发起针对性的澄清提问;
-
记忆保真度(D5, Memory Faithfulness):考察模型的论述是否严密锚定在记忆库给出的事实内,杜绝无中生有的虚构。
针对医疗、权限等 62 个高危场景,基准还额外引入了承诺恰当性(D6)的安全审计标记,直接拦截那些可能导致严重现实后果的过度自信式决策。
从识别到行动:大模型普遍存在断层
为了彻底拆解能力瓶颈,TANGLE 设立了双轨评测机制。其中 Oracle 轨直接向模型输入经过人工清洗的完整核心记忆库与 6 条同领域的干扰记忆,排除记忆召回错误的影响,专门探测纯粹的冲突推理能力。
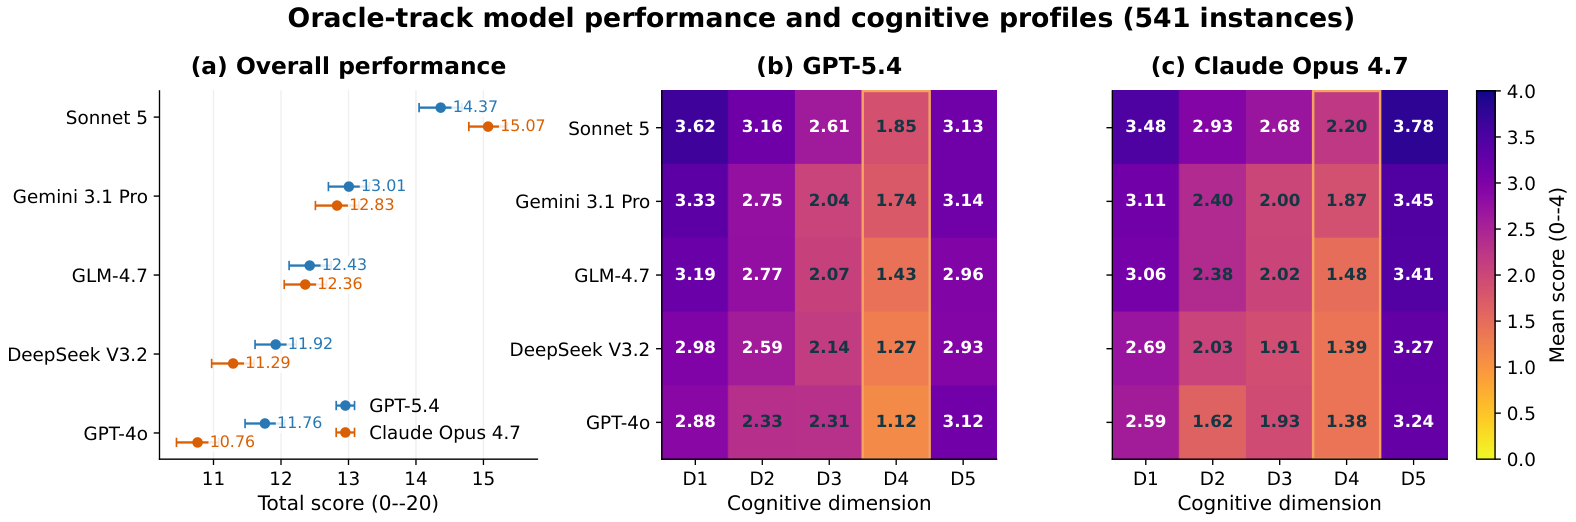
在该轨道下针对 Claude Sonnet 5、Gemini 3.1 Pro、DeepSeek-V3.2、GLM-4.7 以及 GPT-4o 的全面实测表明,即便是目前顶尖的大语言模型,在总分 20 分的认知评估中也无一能突破 15 分。更耐人寻味的是模型在不同认知维度上的表现分化。
实验清晰揭示了一个广泛存在的“从识别到行动断层(Recognition-to-action gap)”。几乎所有模型在冲突感知(D1)上都能拿到相对体面的分数,它们能够轻易指出“记忆 A 与记忆 B 互相矛盾”。然而,一旦要求它们基于这种矛盾做出校准行动时,模型的表现便急转直下。Gemini 3.1 Pro 和 GLM-4.7 表现出较强的冲突感知敏锐度,但在给出建议时依然习惯性地滑向单一选择,缺乏稳健的置信度控制;DeepSeek-V3.2 与 GPT-4o 则在主动发起澄清追问(D4)上暴露出明显短板,倾向于自作主张地完成指令,极少主动向用户索取消除歧义所必需的关键上下文。在信源冲突类别中,部分模型甚至完全丧失了针对信源可靠性的诊断能力,盲目顺从某一方的说辞。
这种现象表明,当前的预训练与指令微调范式在很大程度上鼓励模型表现出“无所不知、果断执行”的仆从姿态,却抑制了模型在面对真正的不确定性时展开防御性确认、表达适度疑虑的元认知能力。
端到端流水线里的“静默失真”与噪音困境
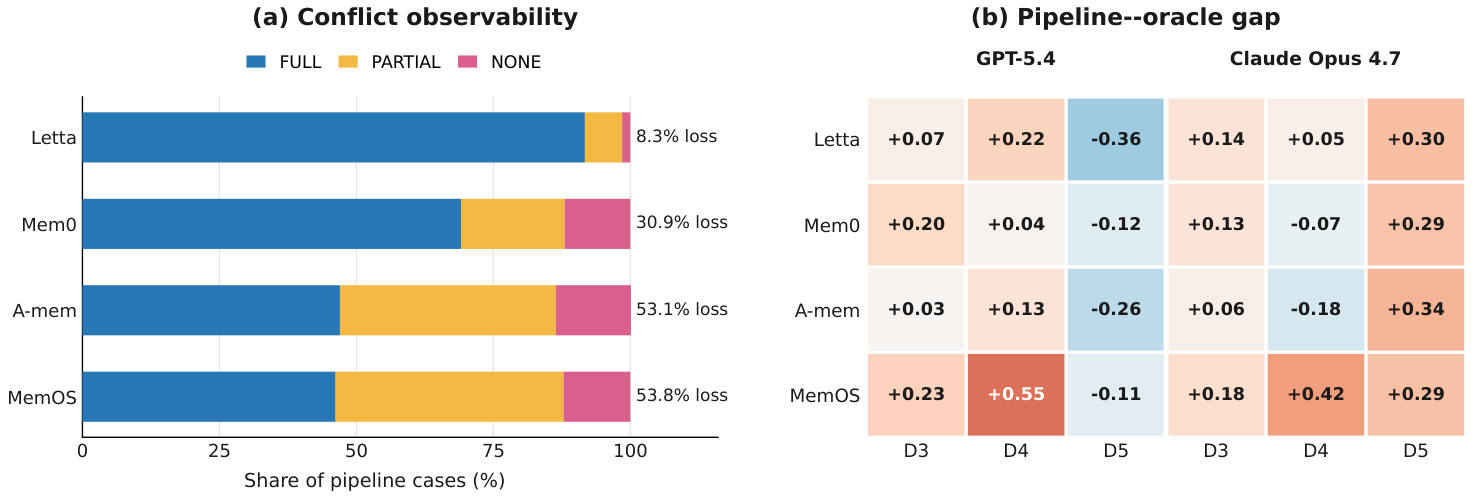
当测试从纯净的 Oracle 轨切换到真实的 Pipeline 轨时,情况变得更加严峻。在 Pipeline 轨中,研究团队将记忆离散化在平均 64.5 个会话、长达数万 Token 的跨轮对话中,要求记忆系统自主提取记忆条目,再由下游模型接收查询并作答。
对比两个轨道的数据,研究人员锁定了记忆系统架构中的上游瓶颈:特征提取环节对冲突结构的毁灭性抹除。当前的长期记忆抽取模块往往遵循实体、事实与三元组的扁平化沉淀逻辑,能够较好地记住“用户喜欢吃川菜”或“用户喜欢吃粤菜”这类孤立的事实片段,却几乎不可避免地丢失了这些陈述成立时所依附的时间锚点、具体场景变量以及信源背景。
当完整的冲突张力在提取阶段被降解为残缺不全的信息片断时,下游模型甚至连“冲突存在”这一基本前提都无法感知。在大量测试用例中,检索给出的记忆库只保留了矛盾中的单侧事实,导致下游推理直接沦为盲人摸象。
雪上加霜的是干扰信息的影响。实验在保持核心冲突记忆不变的前提下,测试了输入不同数量(0 到 6 条)同领域非诊断性干扰记忆对模型推理的冲击。数据显示,随着干扰记忆数量的增加,模型在各项认知维度上的表现呈现普遍下滑,尤其是因果推理与置信度校准承受了更显著的衰减。在同领域语义高度相似的表象下,大模型往往会被非核心细节带偏注意力,进一步丧失对潜在隐变量的洞察力。
打破教条:自适应冲突感知行动策略
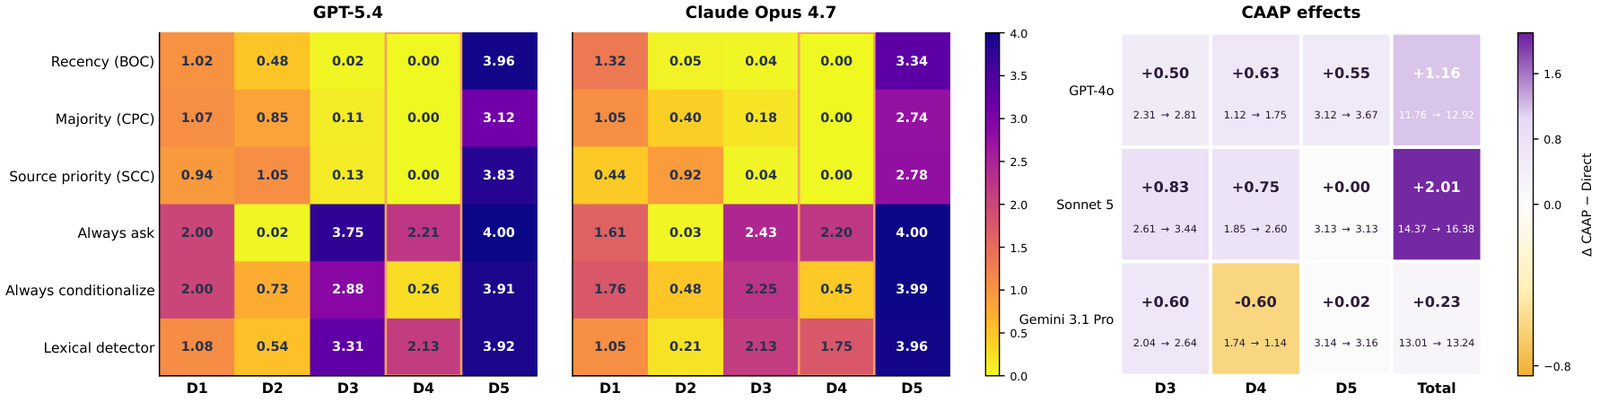
面对未决的冲突,业内以往常用的应对方案往往依赖固定的启发式规则,比如“遇到冲突一律重新询问用户(Ask-only)”,或者“始终给出两全其美的条件分支(Conditionalize-only)”,亦或是机械地根据时间戳“买新不买旧”。
TANGLE 的实验彻底证伪了这类固定规则的普适性。在行为振荡冲突(BOC)中,盲目采信最新记录往往正中模型判断的下怀,因为最新记录可能只是震荡中的一次短暂退步;而在高危的医疗信源矛盾(SCC)中,若采取死板的多数表决,就可能听信多条低质谣言而否决专业报告。同样,如果智能体逢冲突必反问用户,不仅会在低风险日常事务中带来极差的交互体验,还会导致在可以通过上下文推论合理保留方案的场景下显得极度平庸与机械。
为了克服单一预设模式的僵化,作者提出了冲突感知行动策略(Conflict-Aware Action Policy, CAAP)。该策略由两个阶段解耦构成:首先通过决策策略 $\pi_{\theta}^{\mathrm{dec}}(M, q)$ 联合评估记忆库 $M$ 与查询 $q$ 的证据完备度,在离散动作空间中动态选取最契合当前证据态度的行动模式:
\[(z,a)=\pi_{\theta}^{\mathrm{dec}}(M,q)\]其中动作集合涵盖了多种粒度的行动选项:
\[\mathcal{A}=\{\texttt{commit},\ \texttt{conditionalize},\ \texttt{clarify},\ \texttt{verify},\ \texttt{defer},\ \texttt{reversible\_trial}\}\]随后,实现策略 $\pi_{\theta}^{\mathrm{real}}(M,q,z,a)$ 依据所选动作以及显式推理状态 $z$,生成最终呈现给用户的交互文本:
\[r=\pi_{\theta}^{\mathrm{real}}(M,q,z,a)\]消融实验与基线对比清晰地展示了这种自适应框架的威力。在不需要预先获知冲突类型标签的情况下,CAAP 能够针对行为振荡倾向于给出可逆试探性建议(Reversible trial),在上下文分割场景中自动采用条件化陈述或针对性补齐缺失条件,而在信源争议场景下优先启动验证流程。在与 Oracle 基线的同台竞技中,CAAP 在因果推理、置信度校准和追问澄清等各个维度上均取得了系统的性能跨越,验证了根据证据完备度动态选择策略的必要性。
重新思考长记忆系统的演进方向
TANGLE 所带来的思考远不止于一套新的基准数据集。它直击当前大模型记忆架构在哲学层面的核心假设:我们到底需要记忆系统扮演什么样的角色?
长期以来,工程实践往往默认记忆库应当是一张不断去重、融合、最终收敛为单一事实的“纯净知识图谱”。但人类经验的复杂性决定了,很多时候矛盾本身才是最宝贵的真实特征。一个人在顺境与逆境中的抉择差异,一个人在戒断过程中的反复摇摆,一个人面对不同对象时展现的多面性格,都不是应该被“消除”的脏数据。
成熟的 Agent 不应该只是一个单向输出结论的检索增强问答机。面对具有内在张力的复杂个人记忆,优秀的系统必须具备三项关键能力:在记忆持久化层面,忠实保留上下文依赖与关系网络,而不是做粗暴的平铺蒸馏;在认知层面,清晰划定“已知”与“未决”的认知边界,尊重信息欠定的客观现实;在行动层面,权衡潜在决策风险,在果断行动、分支应对、审慎追问与低成本试错之间灵活切换。从消除冲突到与不可化约的冲突共存,或许正是大模型走向真正个性化与可靠落地的必由之路。