W2-VLA:手腕视角不应只是并列输入!任务引导前瞻预测,LIBERO达98.5%
World-to-Wrist: Task-Conditioned Future Wrist Modeling for Fine-Grained Robot Manipulation
在机器人具身智能领域,基于视觉-语言-动作(VLA)的大模型正在迅速扩展其实用边界。从早期的 RT-1、RT-2,到近期的 OpenVLA、$\pi_0$ 与 Octo,模型能够将高阶自然语言指令直接转化为机械臂连续的控制轨迹。然而,当机械臂面临诸如插头装配、精细对准、接触擦拭等毫米级甚至亚毫米级的精细操作任务时,现存的 VLA 架构常常暴露出精度不足、动作迟滞甚至接触失败的通病。
ArXiv URL:https://arxiv.org/abs/2608.05369v1
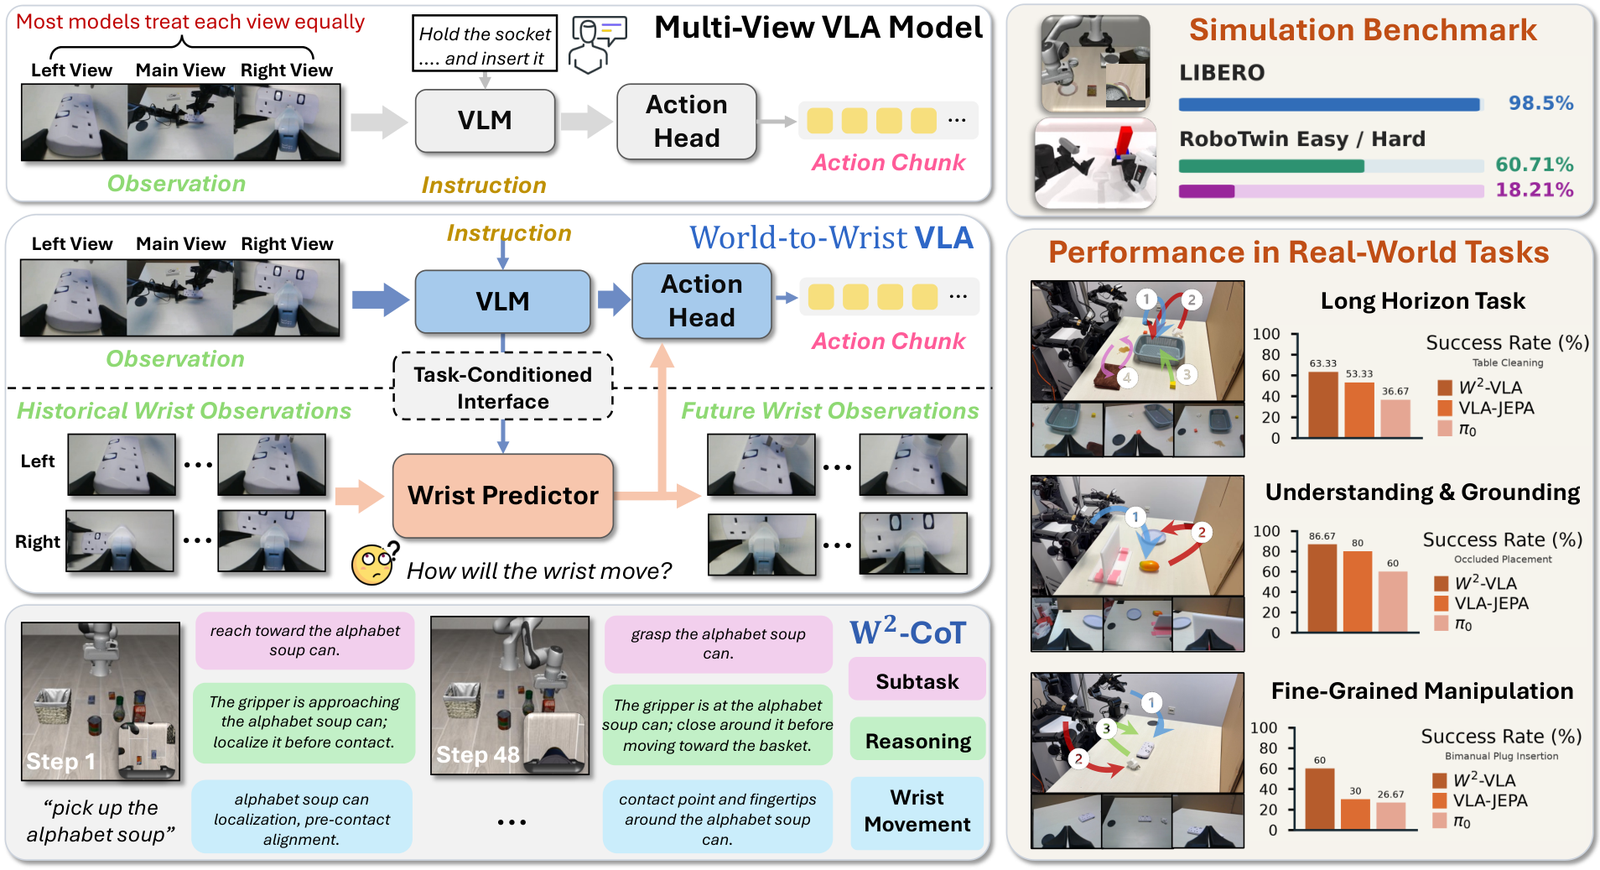
问题出在哪里?来自南洋理工大学、新加坡国立大学、香港科技大学等多所高校的研究团队在一项名为 $\mathsf{W}^2\text{-VLA}$(World-to-Wrist VLA)的研究中,指出了传统架构中一个长期被忽视的结构性缺陷:主流的多视角 VLA 模型几乎无一例外地将“主视角(第三人称环境视角)”和“手腕视角(末端执行器手腕相机)”视为完全平行的视觉输入。
这种把多路相机拍到的画面一股脑打包送入 Vision Transformer 的做法,忽略了这两种视角在物理控制中所承担的截然不同的角色。第三人称主视角展示的是全局场景拓扑、目标空间分布与任务宏观进度;而手腕相机紧贴机械末端,记录的是瞬息万变、充满遮挡与接触力学的“局部微观交互”。尤其是在精细操作中,仅凭当前静态的多视角特征,机械臂很难精准判断手指与物体的相对滑移或即将发生的形变。真正高效的控制策略,必须能够结合全局任务目标,“预判”手腕局部在下一瞬时可能产生的动态演化。
为了打破这一瓶颈,研究团队提出了 $\mathsf{W}^2\text{-VLA}$。该框架并没有在像素空间去费力重建未来的整幅图像,而是巧妙地在潜空间(Latent Space)中打通了一条“从世界到手腕”(World-to-Wrist)的前瞻通路。模型利用全局 VLM 提炼任务上下文,以此引导对手腕未来交互潜变量的精准预测,并将预测结果直接注入动作流匹配头部。在基准测试 LIBERO 上,$\mathsf{W}^2\text{-VLA}$ 创下了 98.5% 的平均成功率;在真实双臂平台上的严苛接触任务中,面对光照、杂乱背景等未知扰动,依然表现出扎实的鲁棒性,同时保证了超过 80 Hz 的纯实时动作生成速率。
为什么手腕视角不能只当成“另一个普通输入”?
回顾现有的具身操作方案,大多数模型在获取主视角图像 $\mathbf{I}_t^m$ 和手腕图像 $\mathbf{I}_t^w$ 后,通常直接通过视觉编码器将它们打散为视觉 Token,与文本指令拼接后输入骨干网络。从信息论的角度来看,这种粗暴的平行拼接假设了各个视角的时空特征具有同质性。但在真实的物理操作中,这两种视角的信息密度与演化尺度存在巨大的时空不对称。
主视角通常安装在固定机位或移动底盘上方,视场角极大,包含大量静止或低速变化的背景要素。它的主要职能是回答“目标在哪”、“工作空间布局如何”以及“当前处于任务的哪个阶段”。相反,手腕相机随着末端执行器高速运动,视野受限但对局部接触极度敏感。比如在抓取微小把手或者对准孔位时,主视角的视线往往被机械臂本体完全遮挡,唯独手腕视角能够捕捉到指尖与接触面之间的挤压、轻微滑移和反作用力反馈。
如果让机械臂具备类似人类在精细装配时的“手感预判”,一种朴素的想法是对未来做视频预测。但近年来的研究表明,如果直接在全局主视角上做全景像素级或隐空间预测,模型大部分的容量会被静态背景、复杂光影等与即时控制无关的信息所浪费;而如果不加约束地只预测手腕相机,又会陷入“多意图模糊”的泥潭。举例来说,手腕相机在记录一段机械臂靠近物体的轨迹后,接下来究竟是执行抓取、侧向推开还是在上方悬停?仅看手腕的历史帧存在多种合理的未来可能性。要消除这种歧义,必须引入主视角所掌握的全局任务上下文与当前任务子目标。
这就是“World-to-Wrist”(世界到手腕)这一命题的本质:利用宏观世界认知消除局部演化的歧义,再用局部未来的前瞻特征反哺毫秒级动作控制。
潜空间桥梁:用轻量接口实现任务引导的手腕前瞻
$\mathsf{W}^2\text{-VLA}$ 并没有采用臃肿的双阶段复杂架构,而是通过一套高内聚的隐式接口,将大语言视觉模型(VLM)与紧凑的手腕动态预测器串联起来。整个系统以 Qwen3-VL-4B-Instruct 为视觉语言基础骨干,结合了基于 DiT 的流匹配(Flow Matching)动作生成头,整体架构清晰且层次分明。
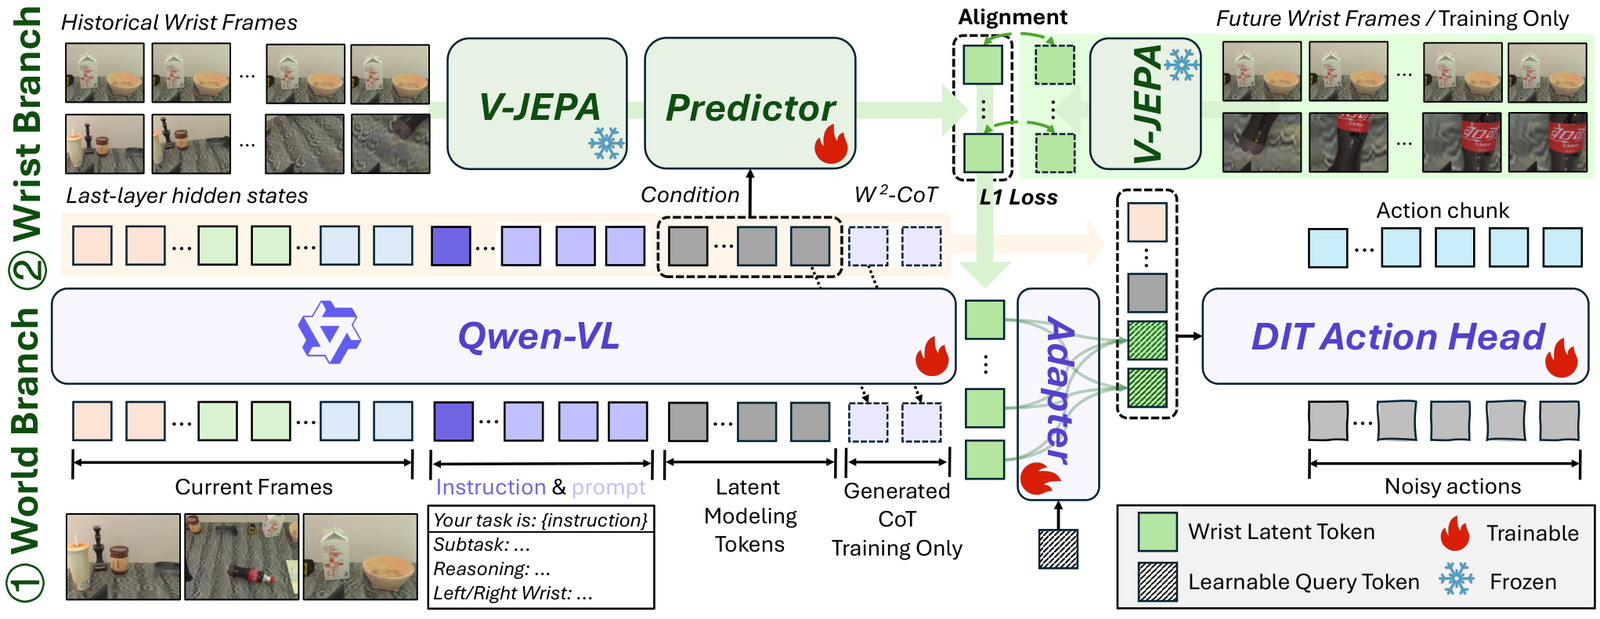
为了让 VLM 提炼出适合手腕预测的全局条件,研究人员在指令文本之后,追加了 $K$ 个专用的隐式建模标记(Latent Modeling Tokens),记作 $\langle q_1 \rangle, \dots, \langle q_K \rangle$。这些 Token 在 VLM 最后一层输出的隐状态,被提取为一个固定维度的任务条件化接口矩阵 $\mathbf{S}_t \in \mathbb{R}^{K \times d}$。
\[\mathbf{p}_t = \left[ \operatorname{Prompt}(\ell) \mid \langle q_1 \rangle \mid \dots \mid \langle q_K \rangle \right], \quad \mathbf{S}_t = F_\theta^{\mathrm{VLM}}(\mathcal{O}_t, \mathbf{p}_t)[\mathcal{P}_q]\]矩阵 $\mathbf{S}t$ 充当了宏观世界与局部手腕之间的信息中枢。而在手腕分支,研究团队摒弃了沉重的端到端像素生成方案,引入了完全冻结的自监督视频大模型编码器 V-JEPA 2.1(ViT-L/384)。手腕历史视频片段 $\mathbf{I}{t,\mathrm{hist}}^w$ 被 V-JEPA 映射为时空表征 $\mathbf{Z}{t,\mathrm{hist}}^w$。紧接着,一个仅有 4 层 Transformer 的轻量级手腕预测器 $G\psi$,以全局任务接口 $\mathbf{S}t$ 为条件,自回归或跨注意力地预测未来手腕潜变量 $\widehat{\mathbf{Z}}{t,\mathrm{fut}}^w$:
\[\widehat{\mathbf{Z}}_{t,\mathrm{fut}}^w = G_\psi\left(\mathbf{Z}_{t,\mathrm{hist}}^w, \mathbf{S}_t\right)\]训练时,系统直接计算预测潜变量与真实未来片段经由 V-JEPA 编码目标之间的 $\ell_1$ 损失函数:
\[\mathcal{L}_{\mathrm{wrist}} = \left\| \widehat{\mathbf{Z}}_{t,\mathrm{fut}}^w - \operatorname{sg}\left(\mathbf{Z}_{t,\mathrm{fut}}^w\right) \right\|_1\]预测出的未来手腕特征并不会被还原成像素,而是被送入一个轻量级的上下文适配器(Context Adapter)。该适配器通过交叉注意力将预测的高维潜变量压缩为 32 个紧凑的未来手腕上下文 Token $\mathbf{C}_t^w$。最后,$\mathbf{C}_t^w$ 与来自 VLM 的多模态动作上下文完成融合,共同注入到 Flow-matching 动作头中进行连续轨迹扩散生成。值得注意的是,适配器与动作头之间设置了阻断梯度的停止反传(stop-gradient)机制,防止多步动作回归的噪声直接破坏手腕潜变量预测器的表征空间。
结构化 W2-CoT:给隐式交互注入语义“心智”
光有特征层面的预测还不够,深度模型在端到端拟合复杂连续轨迹时,隐式接口 $\mathbf{S}_t$ 很容易退化为简单的捷径关联,失去真正的任务导向推理能力。为此,团队提出了一套结构化的离线数据合成流水线——$\mathsf{W}^2\text{-CoT}$(World-to-Wrist Chain-of-Thought)。
不同于盲目照抄通识大模型的自由文本思维链,$\mathsf{W}^2\text{-CoT}$ 为机器人操作量身定制了一套三段式的高密度语义标注规范:
-
子任务描述(Subtask):精准标定当前处于整体任务序列的哪一步骤以及达成进度。
-
物理转换推理(Reasoning):用严格面向机器人的机理术语,阐明基于视觉与状态证据的物理转换逻辑(例如“趋近至接触”、“夹爪稳定闭合”、“带载位移对齐”或“张开释放”)。
-
手腕微观证据(Wrist):极度聚焦手腕视角的物理线索,如末端与物体间隙、指尖接触力迹象、夹持稳定性、微小对准偏角等。在双臂模式下,还会显式解耦为左右臂各自的接触特征描述。
在模型训练阶段,VLM 的语言生成头以多任务辅助学习的形式,监督这套结构化三元组的自回归生成损失 $\mathcal{L}_{\mathrm{cot}}$。这种语义层面的辅助监督,迫使隐式建模 Token $\mathbf{S}_t$ 在深层自注意力机制中,主动将视线锚定在手腕与目标发生接触的物理微小区域,从而极大地端正了隐状态的物理可解释性与语义集中度。
而在推理部署时,整个 $\mathsf{W}^2\text{-CoT}$ 的文本生成头被完全弃用,模型完全不执行任何耗时较长的自回归文本解码。 这种“训练期强语义约束、推理期纯潜变量前传”的机制设计,一举攻克了传统 CoT 方法难以落地于实时机械控制的延迟魔咒。
模拟器与真实双臂实验:精细操作能力的全面展现
为了验证 $\mathsf{W}^2\text{-VLA}$ 的控制上限,研究团队在标准基准仿真环境与真实物理机械臂系统上展开了高强度的对比评估。
在最具代表性的机器人长序列操作评测基准 LIBERO 上,$\mathsf{W}^2\text{-VLA}$ 展现出惊人的稳定性。在包含 Spatial、Object、Goal 以及 Long 等四个严苛套件的综合测试中,模型取得了 98.5% 的整体平均成功率,相较于此前业内顶尖的基线模型取得了明显的领先优势。特别是在短视距容易迷失的 LIBERO-Spatial 与 LIBERO-Object 上,成功率分别高达 99.6% 和 99.8%;即便是面对多步操作耦合的 LIBERO-Long,也维持在 95.2% 的高位。
在仿真动力学更为严苛的 RoboTwin 2.0 双臂仿真基准下,面对洁净环境(Easy)与涉及随机纹理、光照、位姿变化的域随机化环境(Hard),$\mathsf{W}^2\text{-VLA}$ 同样保持了明显的性能优势,分别实现了 60.71% 与 18.21% 的成功率,显著超越了包括 $\pi_0$ 系列在内的一众先进基线。
为了进一步测试模型在现实物理接触中的鲁棒性,研究人员将模型部署在基于 Mobile ALOHA 架构的 CoBoT Magic 双臂机器人平台上,挑选了三组具备显著接触物理挑战的任务:
-
桌面清理(Table Cleaning):长周期操作,涉及拿起抹布、在桌面维持一定压强擦除污渍、避障放置等。
-
遮挡放置(Occluded Placement):机械臂将物体放置进存在视觉盲区、高度遮挡的储物格内,考验手腕视角的局部感知与全局位置推断的结合。
-
双臂插头装配(Bimanual Plug Insertion):典型的接触敏感任务,一只手臂持插座微调,另一只手臂握持微小插头并准确插入,容错范围仅毫米级。
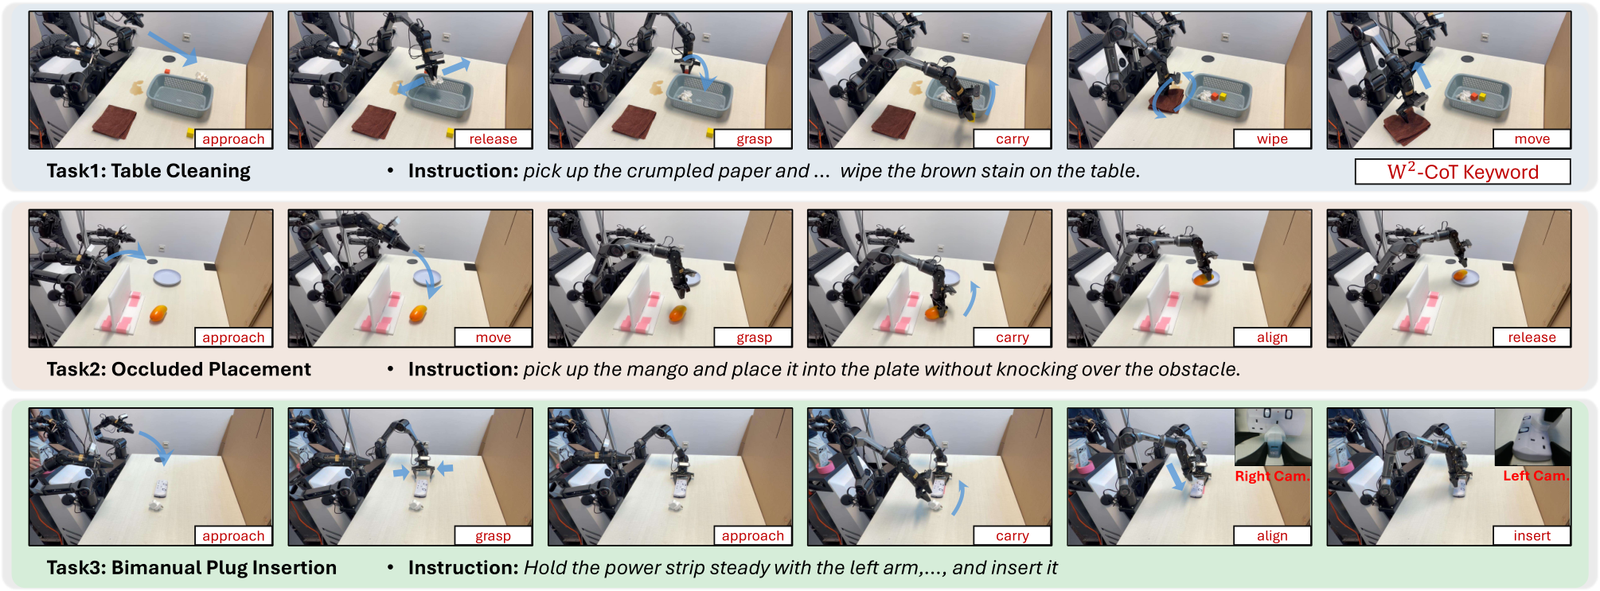
测试同时在标准实验环境(Standard)和注入了大量杂乱背景干扰、随机动态光照、非结构化桌面遮挡物的分布外(OOD)环境下展开。实验结果印证了研究设想:在双臂插头装配这类极度依赖瞬态接触预判的任务中,传统基准模型频繁因为插头触壁时的反向顿挫导致动作失稳;而拥有手腕未来预测机制的 $\mathsf{W}^2\text{-VLA}$,能够根据接近阶段的微观姿态在动作头上提前准备阻抗微调策略,在真实环境中的成功率遥遥领先,展现出对非结构化扰动极佳的吸收弹性。
为什么预测的是手腕,而不是全视角?
在深入分析模型各个组件贡献的消融实验中,一些颇具启发性的技术事实得以浮现:
当研究人员将手腕预测器(Wrist Predictor)从框架中剥离,仅保留常规的多视角 VLM 与动作头时,LIBERO-Long 任务上的成功率直接从 95.2% 下滑至 93.6%,这直接证明了对手腕交互动态的预判,是保证长序列操作不脱轨的关键动力。而当去除结构化 $\mathsf{W}^2\text{-CoT}$ 的辅助语义监督时,模型的整体成功率也出现了系统性下滑,证实了自然语言推理标注在规整潜空间表征方向上的隐式锚定价值。
更有趣的发现来自于预测目标的选取对比。如果将前瞻预测的目标从单纯的手腕视角,扩大为主视角与手腕视角的联合预测,模型的表现反而下降了。这一实验事实非常具有辨识度:全局第三人称相机中充斥着过多不受动作直接影响的静态背景特征,强行要求网络在隐空间预判主视角的演化,不仅白白增加了计算负担,更造成了表征学习上的噪声干扰,稀释了本该极度聚焦于末端夹爪接触面的细粒度梯度。 局部预测的精确聚焦,远比盲目追求全景前瞻更适合物理操作控制。
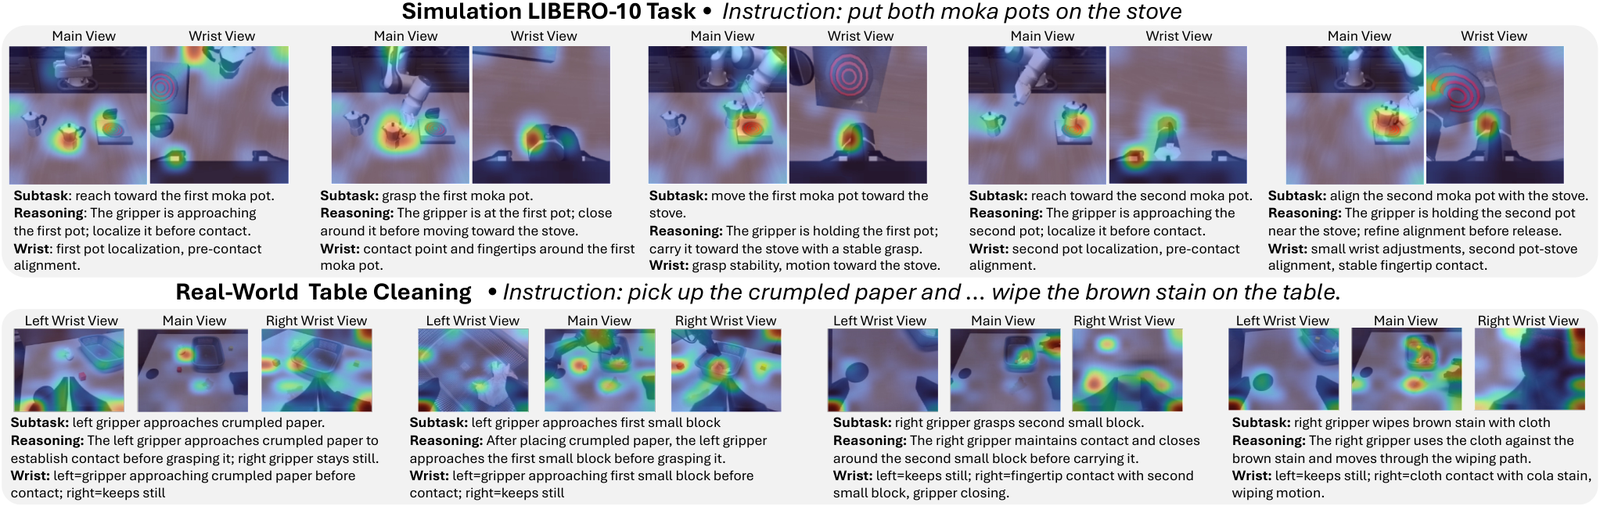
从注意力热力图的定性追踪中,我们可以直观看到系统内部的思考轨迹。当机械臂处于接近阶段时,隐式建模 Token 的注意力主要聚焦于主视角的待操作物体以及手腕画面的指尖边缘;而在进入对齐与接触施力的瞬间,注意力迅速向手腕视角内的接触物理微表面高度集中。这证明了 $\mathbf{S}_t$ 接口确实充当了一枚精准调度的“时空瞄准镜”,在宏观巡航与微观微操之间自如切换。
端到端控制与未来展望
具身大模型过去一年里经历了从离散 Token 输出到连续流匹配(Flow Matching)与扩散策略的范式迁移。然而,在提升推理频率的同时,如何让模型具备人类工匠般的“手感洞察”始终是一个核心难题。许多宣称具备推理链或视觉思维链的模型,由于被迫在推理期间生成长篇自回归文本或高分辨率视频,往往将控制循环频率拉低到可怜的数赫兹甚至零点几赫兹,根本无法满足现实世界高速闭环控制的要求。
$\mathsf{W}^2\text{-VLA}$ 给出的解题思路展示了一种成熟的架构工程哲学:用结构化的语义监督在训练阶段“雕刻”潜空间,用轻量级的自监督视频表征网络在推理阶段“预测”微观演化,最终将动作生成帧率稳定在 80 Hz 以上。 它不仅证明了手腕相机具备超越“普通视觉通道”的独特动力学地位,更为下一代通才具身大模型在精细装配、柔性操作等工业级高难度场景下的落地,提供了一个优雅且极具工程可行性的范式参考。