XBridge:破解异构模型通信瓶颈,延迟降低11倍且全面超越文本交互
XBridge: Entity-Grounded Latent Bridge for Heterogeneous LLM Communication
在大模型的多智能体系统(Multi-Agent Systems)中,让不同架构的模型组成“异构智囊团”正逐渐成为共识。研究表明,如果所有智能体都采用同一种模型、同一套权重与分词词表,彼此之间的交互很容易退化为高度同质化的多数表决,难以激发互补性的推理能力。然而,一旦引入不同家族的模型——例如让 Llama、Qwen 与 Mistral 协同工作,底层的通信鸿沟便立刻显现。
ArXiv URL:https://arxiv.org/abs/2608.11676v1
目前主流的跨模型交互几乎完全依赖自然语言文本通信(NLComm)。发送端模型必须先通过自回归解码将自己的思考压缩成一段自然语言摘要,接收端再将这段文本重新分词并逐层编码。这一过程不仅带来了高昂的解码延迟,更彻底丢弃了发送端在多层神经网络中积累的丰富内部隐层表征。另一种思路是直接进行隐层特征通信(Latent-level Transfer),例如共享 KV Cache 或注入隐层状态。但这类方法通常假设两端具有完全相同的模型架构、隐藏层维度和分词器,一旦跨越模型家族,由于隐空间几何结构和词表的天然差异,直接传输在数学上根本无法对齐。
如果尝试为异构模型之间训练一个连续投影层或交叉注意力桥接器,往往会遇到一个严重的隐式缺陷:实体对齐困境(Entity Grounding Problem)。连续桥接器能够很好地传递全局上下文与句法语义,却极易在连续空间的信息瓶颈中丢失专有名词、数字或生僻词元的离散身份(即所谓“稀有词元压缩坍塌”,纯桥接方案的 F1 表现一度暴跌至约 30%)。针对这一长期困扰异构通信的核心冲突,研究团队提出了名为 XBridge 的免解码(Decode-free)通信协议。该方案将通信解构为离散实体锚点与连续上下文增强两个独立通道,在三大开源模型家族(Llama、Qwen、Mistral)与七大复杂基准测试中,不仅将通信延迟缩减了整整 11 倍,更在所有测试任务上全面超越了传统的文本通信,甚至在同架构对比中击败了原生的 KV Cache 共享方案。
连续表征为何在跨模型时“弄丢实体”?
要理解 XBridge 的精巧设计,必须先看清连续隐层传输在跨模型场景下的致命软肋。形式化来看,发送端模型 $M_S$ 与接收端模型 $M_R$ 拥有各自独立的分词器 $\tau$、词表 $V$、嵌入矩阵 $E$ 以及变换层 $F$:
\[V_S \neq V_R, \qquad d_S \neq d_R, \qquad F_S \not\equiv F_R\]在典型的非对称协同场景中,发送端持有长文本上下文 $C$,提取出其最后一层的隐状态序列 $H_S \in \mathbb{R}^{T_C \times d_S}$;接收端仅持有问题 $Q$,需要依据发送端传递的信号生成答案 $A$。
过去的研究者倾向于构建一个连续映射模块 $B_\theta(H_S, h_R)$,将发送端的连续向量投影或融合进接收端的计算流。这种做法忽视了离散实体保真度(Entity Fidelity)与上下文传递的脱钩现象。在一个长篇事实问答任务中,若将上下文中的关键实体 $e$(例如导演“Christopher Nolan”)替换为另一个同类型实体 $e’$(如“Bong Joon Ho”),整个文本的关系结构、叙事脉络和语境分布几乎没有任何变化。由于二者高度相似,连续通信协议在低维或压缩的隐空间中,往往产生距离极其微小的表示向量:
\[d\bigl(m_{\mathrm{cont}}(C_e), m_{\mathrm{cont}}(C_{e'})\bigr) \leq \epsilon\]然而在离散空间中,接收端词表内部对应这两个实体的词元标识 $a_R(e)$ 与 $a_R(e’)$ 具有严格的互斥性。连续桥接器固然能把“某位导演在某年执导了某部电影并获得了某项殊荣”这一庞大的关系网络传递给接收端,但在决定到底输出哪一个具体的生僻词元时,接收端却在模糊的隐层流中陷入了“稀有词元压缩坍塌”。实验表明,没有离散锚点支撑的纯连续桥接,在面对实体提问时预测目标答案词元的平均排名不仅没有改善,反而比完全不通信的基线还要糟糕。
除了实体身份丢失,直接的表征注入还会引发严重的表征分布失配(Representation Mismatch)。即使通过线性投影矩阵 $P \in \mathbb{R}^{d_R \times d_S}$ 将发送端的维度与接收端强行对齐,投影后的向量分布 $P H_S$ 依然与接收端第 $\ell$ 层原生的隐状态分布 $\mu_R^{(\ell)}$ 存在系统性偏离。直接向接收端的残差流或注意力缓存中硬塞这些“分布外激活向量”,不可避免地会破坏接收端预训练好的自注意力感知,导致灾难性的推理衰退。
XBridge 的解题法:双通道免解码架构
XBridge 的核心直觉非常清晰:不要强求连续表征去承担离散实体的精确记忆,也不要在接收端被动接受发送端的隐状态灌输。该协议将通信分解为两条解耦的通道:离散实体锚点由词汇层无损迁移,连续语境信息则交由接收端主动跨层检索。
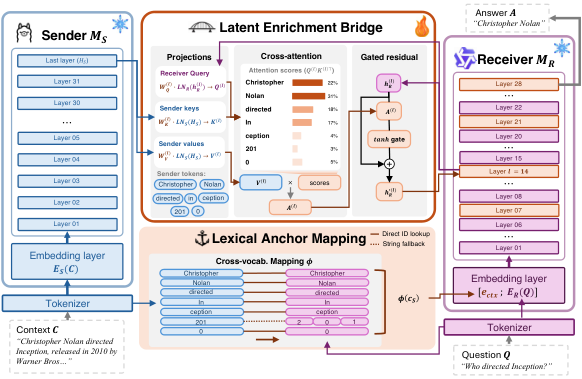
整个流程仅需发送端进行一次前向传播(Forward Pass),完全省去了耗费计算资源的自回归文本解码过程。发送端在完成前向计算后,同时产出分词序列 $c_S$ 与最后一层隐藏状态 $H_S$,随后双通道同步运转。
通道一:词汇锚点映射(LAM)锁定实体骨架
为了杜绝稀有词元在连续瓶颈中的模糊化,词汇锚点映射(Lexical Anchor Mapping, LAM)选择直接在离散词表级别建立桥梁。给定发送端的输入分词 $c_S = (c_1, \dots, c_{T_C})$,LAM 通过一个确定性的映射函数 $\phi: \mathcal{V}_S \to \mathcal{V}_R^*$,将发送端的每个词元转换为接收端词表中的对应词元。
在工程实现上,这项映射可以在离线阶段针对每一对模型的分词器一次性预先计算好。如果某个词元对应的表层文本(Surface String)在两个词表中均存在,则执行直接的 ID 到 ID 查表映射;若出现分词切分颗粒度不一致的情况,系统通过快速的表层字符串回退(Fallback),将该词元解码为字符后立即用接收端的分词器进行二次切片,并在原位展开。
转换后的词元 ID 随后通过接收端自身的冻结嵌入矩阵 $E_R$ 查表,得到离散的接收端原生嵌入向量:
\[e_{\text{ctx}} = \bigl(E_R[\phi(c_1)], \dots, E_R[\phi(c_{T_C})]\bigr)\]这些词元向量直接与问题的原生嵌入拼合,作为接收端的第一层输入:
\[x_R = [e_{\text{ctx}} \;;\; E_R(Q)]\]这一设计极为巧妙。它完全避开了发送端耗时极长的摘要生成,同时查表和展开耗时不足 1 毫秒,毫无信息截断地将上下文的全部词元原汁原味地摆在了接收端眼前。更关键的是,这些离散词元天生驻留在接收端原生的特征空间中,确保了预训练的自注意力机制从最底层起就能稳定识别出所有的专有名词与数字。
通道二:隐空间增强桥(LEB)的主动语境查询
虽然 LAM 解决了实体“是谁”的问题,但它传递的仅仅是离散词元各自独立的静态词向量,缺失了文本在深层网络中凝练而成的宏观关系、深层指代与推理链条。此时,隐空间增强桥(Latent Enrichment Bridge, LEB)发挥了连续通道的作用。
发送端通过全部 Transformer 层计算出的最后一层隐状态 $H_S$,代表了全局语义整合的最高水准。为了化解前文提及的表征分布失配问题,LEB 放弃了粗暴的隐状态相加或直接拼贴,转而采用一种由接收端驱动的门控交叉注意力机制(Gated Cross-Attention)。
团队在接收端的第 6、13、20、27 层(以 28 层模型为例,参考了 Flamingo 的稀疏插入比例)各插入了一个轻量级的 LEB 模块。在指定的插入层 $\ell$,接收端当前的内部隐藏状态 $h_R^{(\ell)}$ 主动充当查询向量(Query),而发送端的隐状态 $H_S$ 则作为键(Key)和值(Value):
\[Q^{(\ell)} = W_Q^{(\ell)} \cdot \mathrm{LN}_R^{(\ell)}(h_R^{(\ell)}), \quad K^{(\ell)} = W_K^{(\ell)} \cdot \mathrm{LN}_S^{(\ell)}(H_S), \quad V^{(\ell)} = W_V^{(\ell)} \cdot \mathrm{LN}_S^{(\ell)}(H_S)\]其中,投影矩阵 $W_K^{(\ell)}, W_V^{(\ell)} \in \mathbb{R}^{d_R \times d_S}$ 在训练中承担了跨模型隐藏维度的空间对齐职责。随后,接收端通过缩放点积注意力,按需索取发送端的上下文信息:
\[A^{(\ell)} = \mathrm{softmax}\left(\frac{Q^{(\ell)} K^{(\ell)\top}}{\sqrt{d_k}}\right) V^{(\ell)}\]最终,交叉注意力的输出通过一个带有可学习门控标量 $\alpha^{(\ell)}$ 的残差连接汇入主干网络:
\[h_R^{\prime(\ell)} = h_R^{(\ell)} + \tanh(\alpha^{(\ell)}) \cdot A^{(\ell)}\]在训练初期,$\alpha^{(\ell)}$ 初始化为 0,保证接收端原生的表征流不被剧烈扰动;随着训练推进,接收端开始学会根据自己当前的解码进度,在特定的计算深度主动向发送端“调取”所需的语境补充信息。
无缝契合:自注意力主导的自然接地
令人赞叹的是,LAM 与 LEB 之间甚至不需要额外设计复杂的对齐损失函数或显式的融合层。它们的深度结合完全是依靠 Transformer 架构特有的前向传播动态自发完成的。
当 LAM 将离散实体锚点注入输入端后,随着层数加深,接收端自带的自注意力层会自然地将这些实体词元与问题词元反复交叉整合,从而使第 $\ell$ 层的隐状态 $h_R^{(\ell)}$ 天然携带了精准的实体位置与身份印记。于是,当 $h_R^{(\ell)}$ 转化为查询向量 $Q^{(\ell)}$ 去检索发送端的 $H_S$ 时,查询向量自身就具备了明确的目标性——它不再是毫无头绪的泛化索取,而是能精准锁定发送端中与这些特定实体强相关的隐藏激活段落。
这种“输入端给离散锚点,深层网络按锚点查隐层补全”的协同机制,彻底把连续的上下文语义牢牢钉在了离散的实体坐标之上。
极简的训练开销:3.8% 参数与 10 分钟收敛
在大模型微调动辄需要多机多卡、漫长迭代的背景下,XBridge 的训练成本低廉得异乎寻常。在整个训练阶段,发送端模型与接收端模型全部处于严格的参数冻结状态。由于发送端面对给定的上下文文本只需要单次前向传播,其产出的最后一层隐状态 $H_S$ 与 LAM 分词序列可以提前完全离线计算并缓存进磁盘。
真正需要反向传播更新的,仅仅是分布在接收端 4 个关键层处的 LEB 交叉注意力与投影权重。每个模块约含 66M 参数,整套桥接结构的总可训练参数量约为 264M,仅占 7B 级别接收端模型总参数量的约 3.8%。
在训练数据方面,研究者并未依赖庞大的预训练语料,而是仅仅从七大下游评测任务中抽取了 587 个样本构成均衡微调集。接收端在标准自回归生成损失 $\mathcal{L}(\theta)$ 的监督下优化桥接参数:
\[\mathcal{L}(\theta) = -\sum_{t=1}^{\lvert A \rvert} \log P_R\bigl(a_t \mid a_{<t}, e_{\text{ctx}}, Q; \theta_{\text{bridge}}\bigr)\]得益于参数体量极小且无需穿透两端的大模型主体,单张消费级或专业级 GPU 在 10 分钟之内即可完成全部训练收敛。一旦训练结束,该桥接模块便彻底固化,在推理阶段可以直接泛化应用于该模型对之间的所有下游问答与推理任务,具备极强的模块化落地属性。
实验印证:11倍加速与全任务领跑
为了全面验证跨模型通信的真实效能,研究团队在 Llama-3.1-8B-Instruct、Qwen2.5-7B-Instruct 以及 Mistral-7B-Instruct-v0.3 三个具有显著架构、词表与训练集差异的开源系列之间展开了双向与异构评测。测试基准涵盖了 HotpotQA、MuSiQue、QASPER、2WikiMultihopQA 等七项高度依赖长文本检索与复杂多跳逻辑推理的数据集。
实验主要对比了以下几种通信范式:
-
NoComm:接收端在完全不获取任何上下文(仅看问题)的情况下的基线表现。
-
NLComm:最主流的自然语言文本通信。发送端通过贪婪搜索生成一段 128 Token 的上下文摘要文本,交由接收端阅读。
-
FullComm:将全部上下文文本毫无遮保留地直接输入给接收端。这在严格意义上并非通信协议,而是作为消除了信息阻断的性能“天花板”参考。
在全部三个异构模型组合(Llama $\to$ Qwen、Qwen $\to$ Llama、Mistral $\to$ Qwen)中,XBridge 展现出了断层式的优势。在所有 7 个基准测试中,XBridge 对比传统的自然语言文本通信(NLComm)取得了全方位的胜利,各项平均 F1 提升幅度分别高达 +21.4(Llama $\to$ Qwen)、+14.3(Qwen $\to$ Llama)以及 +20.9 个百分点(Mistral $\to$ Qwen)。提升最为显著的领域集中在 2WikiMQA 和 MuSiQue 等多跳推理任务上,这类任务要求对跨段落的事实进行精密拼接,文本摘要往往顾此失彼,而 LEB 传递的高维隐藏状态保留了完整的推理中间拓扑。
更为惊人的是,在多项设置下,XBridge 的表现甚至打破了 FullComm 的天花板(例如 Llama $\to$ Qwen 达到 63.2 vs. 55.2,Mistral $\to$ Qwen 达到 65.0 vs. 55.2)。由于 LAM 已经保证了接收端能够读取到完整的离散上下文,LEB 的注入相当于让接收端白嫖了发送端在大模型深层预先提炼好的全局特征,达成了“1+1 > 2”的集成推理效果。
在硬件层面的端到端延迟测试中,运行在 H200 GPU 上的数据显示,传统 NLComm 受困于发送端的自回归生成,单样本耗时居高不下;而 XBridge 全程免解码,配合毫秒级的离散查表与计算量极小的 Cross-Attention,端到端推理延迟实现了高达 11 倍的断崖式降低。
实体扰动实验:双通道分工的硬核实证
为了进一步坐实“LAM 负责锁死实体,LEB 负责注入关系”的核心论断,研究人员设计了一个极其刁钻的对抗性扰动实验。他们在 HotpotQA 数据集中选取样本,将上下文中的答案实体人为替换为无关的干扰实体(例如将“Christopher Nolan”篡改为“Bong Joon Ho”),随后对 LAM 通道与 LEB 通道分别输入原版与篡改版的上下文:
当仅通过 LAM 输入被篡改的实体、而通过 LEB 输入原版上下文时,接收端生成的答案完全倒向了 LAM 所指定的被篡改实体;反之,若在 LAM 中保留原版实体,仅在 LEB 隐层中输入篡改后的上下文,生成的答案依旧坚定遵循 LAM 的离散引导。消融实验同时显示,一旦将 LAM 抽离、仅保留 LEB 连续桥接,模型在 HotpotQA 上的 F1 分数瞬间暴跌回 30% 左右。这一因果消融铁证如山地表明:没有离散词汇锚点,连续隐空间表征无论多么庞大,都无法在异构接收端自主还原离散实体的精确属性。
同构降级下的意外之喜:超越 KV Cache 共享
另一个极具启发性的发现出现在同构配置下(例如 Qwen2.5-7B 向自身通信)。在相同架构下,由于词表一致,LAM 退化为直接的恒等映射,此时主流的做法往往是直接把发送端的 KV Cache 原封不动地共享给接收端(KVComm)。
然而实验数据表明,即便在同架构场景下,XBridge 在 7 项任务中的 6 项依然胜过了原生的 KVComm,平均领先幅度达 7.9 个百分点。深入探究其背后的计算机理:KV Cache 共享实际上是在接收端的底层直接将外部键值拼入注意力序列,强迫接收端在生成答案的每一步都要重新扫描并分配长序列注意力;而 XBridge 的 LEB 是在接收端的中高层,通过 4 个门控交叉注意力模块对发送端全局整合后的隐状态进行按需提炼。这种跨层的、分工明确的摘要式查询,在认知表征层面比简单粗暴的底层缓存复用更具推理效率。
迈向免解码的多智能体隐层互联
长期以来,多智能体协同领域一直被笼罩在自然语言通信的思维惯性之下。开发者们习惯于让智能体扮演人类角色,通过聊天框般的文字接口来回传递 Prompt 和回复。这种模式固然直观、通用,但在计算层面却是一种巨大的浪费——它不仅强迫庞大的 GPU 集群为了传递几句中间变量而频繁进行串行的自回归采样,更粗暴地磨平了神经网络内部高维表征的丰富张力。
XBridge 的突破性意义在于,它打破了“跨模型只能靠文字打字沟通”的固有成见,同时避免了学术界容易陷入的“纯连续表征暴力投影”的认知陷阱。通过将离散的实体锚定与连续的语境检索利落解耦,XBridge 证明了:不同家族、不同参数、不同词表的大模型之间,完全可以用极度轻量的计算代价建立起深层表征直连通道。
随着多智能体系统在工业级场景下对吞吐量、低延迟和异构互补性提出越来越严苛的要求,摆脱自回归文本枷锁、转向“免解码隐层互联”正展现出惊人的演进潜力。XBridge 为这一范式的推进提供了一套务实且极其优雅的技术支点。