$\pi\mathbf{R}^2$:CMU 让大模型流策略跑出 25Hz 闭环,实机操作成功率提升 30%
$π\mathbf{R}^2$: Reactive Real-time Flow Policies
当前的具身智能与通用机器人操作策略,几乎都在奔向同一套标准组合:前端挂载参数庞大的视觉语言模型(VLM)提取全局语义,后端连接流匹配(Flow Matching)或扩散策略(Diffusion Policy)捕捉人类示范的多模态动作分布,并采用动作分块(Action Chunking)一次性输出一长串未来动作。这套设计在静态台面操作中展现出了出色的泛化能力,但一旦进入接触丰富、环境多变的动态操作场景,系统反应迟钝的致命短板就会暴露无遗。
ArXiv URL:https://arxiv.org/abs/2607.26055v1
动作分块机制本质上是在固定时间窗口内进行“开环盲跑”。机器人在执行这一小段动作时,对中途涌入的环境变化完全充耳不闻,丧失了即时反应能力(Reactivity);而如果试图通过高频重规划来恢复闭环,庞大的视觉主干网络加上多步迭代去噪的计算开销,又会带来严重的推理延迟(Latency)。来自卡耐基梅隆大学(Carnegie Mellon University)的研究团队提出了 $\pi\mathbf{R}^2$ 框架,在保留大型预训练主干、多模态表达力与动作分块优势的前提下,通过“快慢感知解耦”与“自适应单步去噪调度”,打破了高延迟与低响应度之间的恶性循环。在部署了 GR00T-N1.7 的真实双臂灵巧手平台上,$\pi\mathbf{R}^2$ 将闭环重规划速度提升了约 4 倍,达到 25Hz,使机器人每隔 40ms 就能基于最新感知刷新控制指令,在真实物理交互任务中相较最强基线取得了高达 30% 的成功率提升。
动作分块流策略的结构性困境:为什么大模型在动态控制中会“慢且钝”?
理解 $\pi\mathbf{R}^2$ 的价值,首先需要看清当前主流策略架构在动态控制下的结构性矛盾。动作分块(Action Chunking)最早由 ACT 引入,其核心逻辑是一次性联合预测未来 $H$ 步的动作序列 $(\mathbf{a}t, \dots, \mathbf{a}{t+H})$。这种做法不仅显著增强了轨迹的时序连贯性,还极大缓解了模仿学习中的复合误差问题。配合基于常微分方程的流匹配(Flow Matching)去噪头,模型能够优雅地拟合人类演示数据中复杂的动作多模态分布。
然而,这套机制在运行逻辑上存在严重断层。标准的扩散与流匹配模型在生成轨迹时,动作块内的所有时步共享同一个噪声水平 $t$。在执行策略时,机器人必须开环跑完前 $h$ 步动作($h \leq H$),随后再触发下一次全局规划。在这 $h$ 步执行期间,即便物体发生滑动、意外碰撞或者出现外力扰动,策略也无法接收中途流入的传感器信号做出补救。
理论上,如果把执行范围缩小到极限($h=1$),每走一步就基于新观测重新去噪一次,系统就能恢复即时闭环。但工程现实是残酷的:以 50Hz 控制频率为例,每个时钟周期仅有 20ms。而在实际软硬件流水线上,运行一个像 GR00T-N1.7 这样的视觉语言动作(VLA)模型,图像预处理加大型 VLM 主干的前向计算大约需要 60ms,紧随其后的流匹配去噪头(假设取 4 步去噪)又需要约 80ms,单次推理总耗时高达 140ms,相当于 7 个控制周期的延迟。如果强行做闭环重规划,机械臂执行的动作所依据的传感器数据实际上是 140ms 之前的“旧闻”。为了保证机械臂不发生卡顿或由于通信断流而急停,以往的系统只能妥协,要么拉长开环执行步长 $h$,要么退化回粗糙的时序平滑融合。
这一瓶颈证明,单纯在算法层面上做步长调优无法解决问题,必须从底层拆解“计算耗时分布”与“信息刷新频率”之间的不对称性。
感知通道的快慢解耦:用最新本体感知吸收视觉滞后
针对计算瓶颈,CMU 团队敏锐地捕捉到了机器人感知系统的核心物理特性:不同模态的信息获取与计算成本相差几个数量级。高维的视觉图像不仅需要耗费庞大的传输带宽,还需要经过深层 Transformer 的自注意力计算,处理起来必然沉重缓慢;但机器人的本体感觉信号(Proprioception)——包括关节角度、角速度、力矩以及指尖接触力——采样频率极高,经过一个轻量级多层感知机(MLP)编码几乎只需微秒级时间。
更关键的洞察在于两者的功能分工。在非抓握操控、防滑纠偏等高动态或富接触任务中,负责局部反应性修正(如感知到物体滑动时即时加大捏紧力)的主要依据正是本体感觉反馈;而视觉与语言特征的主要职责是提供粗粒度的空间几何关系与全局任务引导。基于这一物理直觉,$\pi\mathbf{R}^2$ 将策略的条件输入彻底拆分为两条异步管道:
第一条是“慢通道”(Slow Channel),处理图像编码与 VLM 嵌入等重量级语义特征。该通道异步运行,允许出现一定程度的时序滞后;第二条是“快通道”(Fast Channel),以机器人的原生控制频率(如 50Hz 或 25Hz)实时刷新当前瞬时的本体状态。在策略动作头的每一个去噪时钟周期内,模型都直接注入当前最新滴答声下的本体感觉嵌入,使其与异步更新的视觉特征进行拼接。
为了让动作头在数学上适应这种不同步性,研究人员在训练阶段主动引入了人为延迟扰动。在构建训练样本时,慢通道的视觉特征被随机施加一个时步延迟 $d_{\mathrm{vlm}} \sim \mathrm{Uniform}{0, \dots, d_{\mathrm{vlm}}^{\max}}$,并将该延迟量映射为一个可学习的延迟嵌入(Delay Embedding)叠加到慢通道表征中。通过这种方式,动作预测头在训练时就明确学会了“在参考若干毫秒前的过时全局画面的同时,紧密依据当前最新的本体感觉来修正即将下发的动作”,从根本上将庞大的 VLM 计算开销移出了高频控制内环。
阶梯式流调度:单步去噪与多硬件自适应平滑
解决了特征输入的快慢分离,接下来要解决的是流匹配自身的去噪延迟。如果每次重规划仍然需要迭代 4 到 16 个去噪步数(NFE),整体计算耗时依然无法被压进毫秒级。
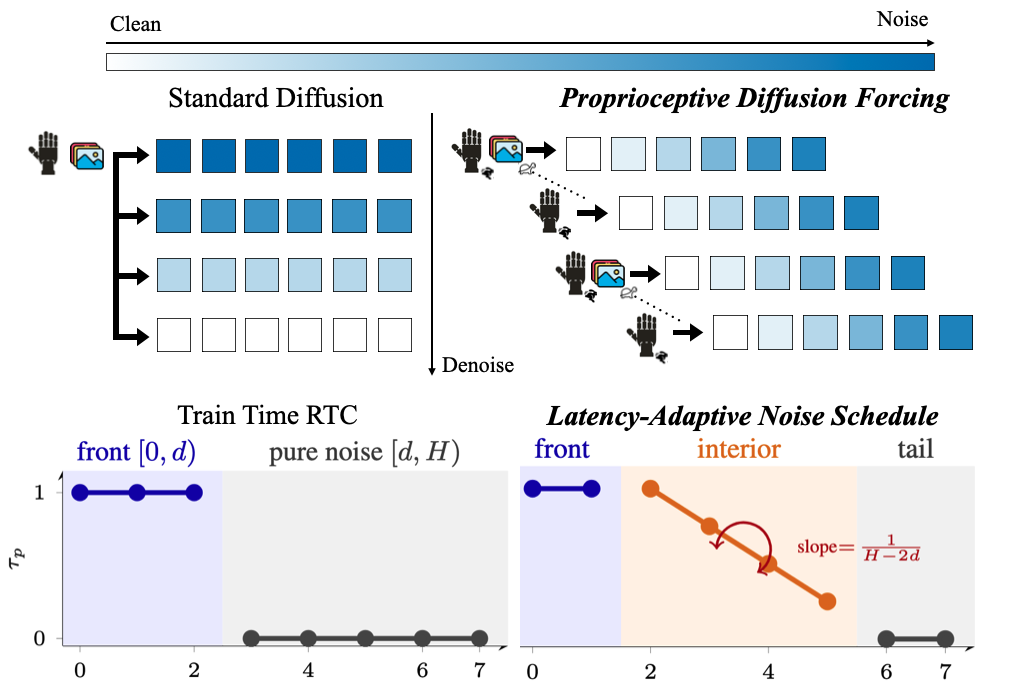
$\pi\mathbf{R}^2$ 的第二项核心机制建立在 Diffusion Forcing 框架之上。普通的流匹配对整个动作块施加统一的去噪进度,而 Diffusion Forcing 允许动作块内的每个位置索引 $p \in {0, \dots, H-1}$ 拥有独立的噪声水平 $\tau_p \in [0, 1]$:
\[\mathbf{x}_{\tau,p}=(1-\tau_p)\,\boldsymbol{\epsilon}_p+\tau_p\,\mathbf{a}_p\]以此为基础,本文提出了一种巧妙的“延迟自适应阶梯式流调度”(Latency-Adaptive Staircase Schedule)。针对系统当前测得的推理延迟 $d$(即计算一次所占用的动作时步),算法将长度为 $H$ 的动作缓冲区划分成三个功能截然不同的区域:
\[\tau^{\star,d}_p = \begin{cases} 1 & 0 \le p < d \\[2.0pt] 1 - \dfrac{p - d}{H - 2d} & d \le p < H - d \\[6.0pt] 0 & H - d \le p \le H - 1 \end{cases}\]前端区间 $[0, d)$ 对应的是上一个周期发出、目前正在底层硬件执行中的动作序列(In-flight Actions)。由于这些动作已经被物理硬件采纳,算法将它们全部钳位在完全无噪声状态($\tau=1$),作为动作补全(Inpainting)的固定前缀条件。这一处理保证了新规划出的动作能与上一段轨迹在速度与加速度级别自然衔接,杜绝了执行边界的顿挫感。
中间区间 $[d, H-d)$ 构成了一个自左向右线性倾斜的去噪过渡坡道。处于坡道头部的动作已经历过多轮去噪,噪声水平极低,仅需一步去噪就能收敛为干净的动作并立即下发。
尾部区间 $[H-d, H)$ 则是由 $d$ 个新注入的纯高斯噪声槽位组成的补充带($\tau=0$)。
在部署运行时,策略的每一次迭代计算完全被简化为仅执行单次去噪步骤(1 NFE)。在这一次前向传播中,整个动作块根据欧拉数值积分向前推进:
\[\mathbf{x}_p \leftarrow \mathbf{x}_p + \Delta\tau_p \cdot v_\theta(\mathbf{x}, \boldsymbol{\tau}, \mathbf{o})_p, \qquad \tau_p \leftarrow \tau_p + \Delta\tau_p\]完成这一次微小推进后,位于 $[d, 2d)$ 位置的动作恰好达到 $\tau=1$,直接释放给底盘与机械臂执行;紧接着,整个滑动窗口向左滑动 $d$ 个槽位,原本刚刚释放的动作顺移变为新的前端边界条件,而尾端则自动补齐 $d$ 个新鲜纯噪声。
这种设计将原本集中在单次重规划中的多步去噪预算,均匀摊销到了每个控制周期的流式滑动中。由于调度完全由实测延迟标量 $d$ 参数化,即便底层通信或计算负载产生抖动导致 $d$ 从 1 跳变为 2,算法也只需动态调整去噪斜率,几步迭代内就能自适应吸收硬件抖动,展现出惊人的工程鲁棒性。
令人惊喜的是,实现这一整套机制对现有大模型的改动极小。传统的 Diffusion Transformer(DiT)使用自适应层归一化(AdaLN)来注入全局标量噪声,$\pi\mathbf{R}^2$ 仅仅将其修改为逐位置独立的 AdaLN 调制参数对 $(\gamma_p, \beta_p)$,其他所有注意力层、MLP 与预训练大模型骨干均无需重新设计架构,已有的大规模预训练策略直接微调即可继承这套能力。
仿真实验:解构步长与延迟对动态控制的侵蚀
为了严密验证快慢解耦与阶梯式调度的有效性,作者首先在 MuJoCo Playground 的灵巧手转动魔方任务(Leap Cube Reorientation)中开展了仿真对照。该任务对闭环反应极其苛刻:手掌必须根据与魔方的接触状态即时微调手指姿态与施力,任何开环延迟都会迅速导致魔方坠落。
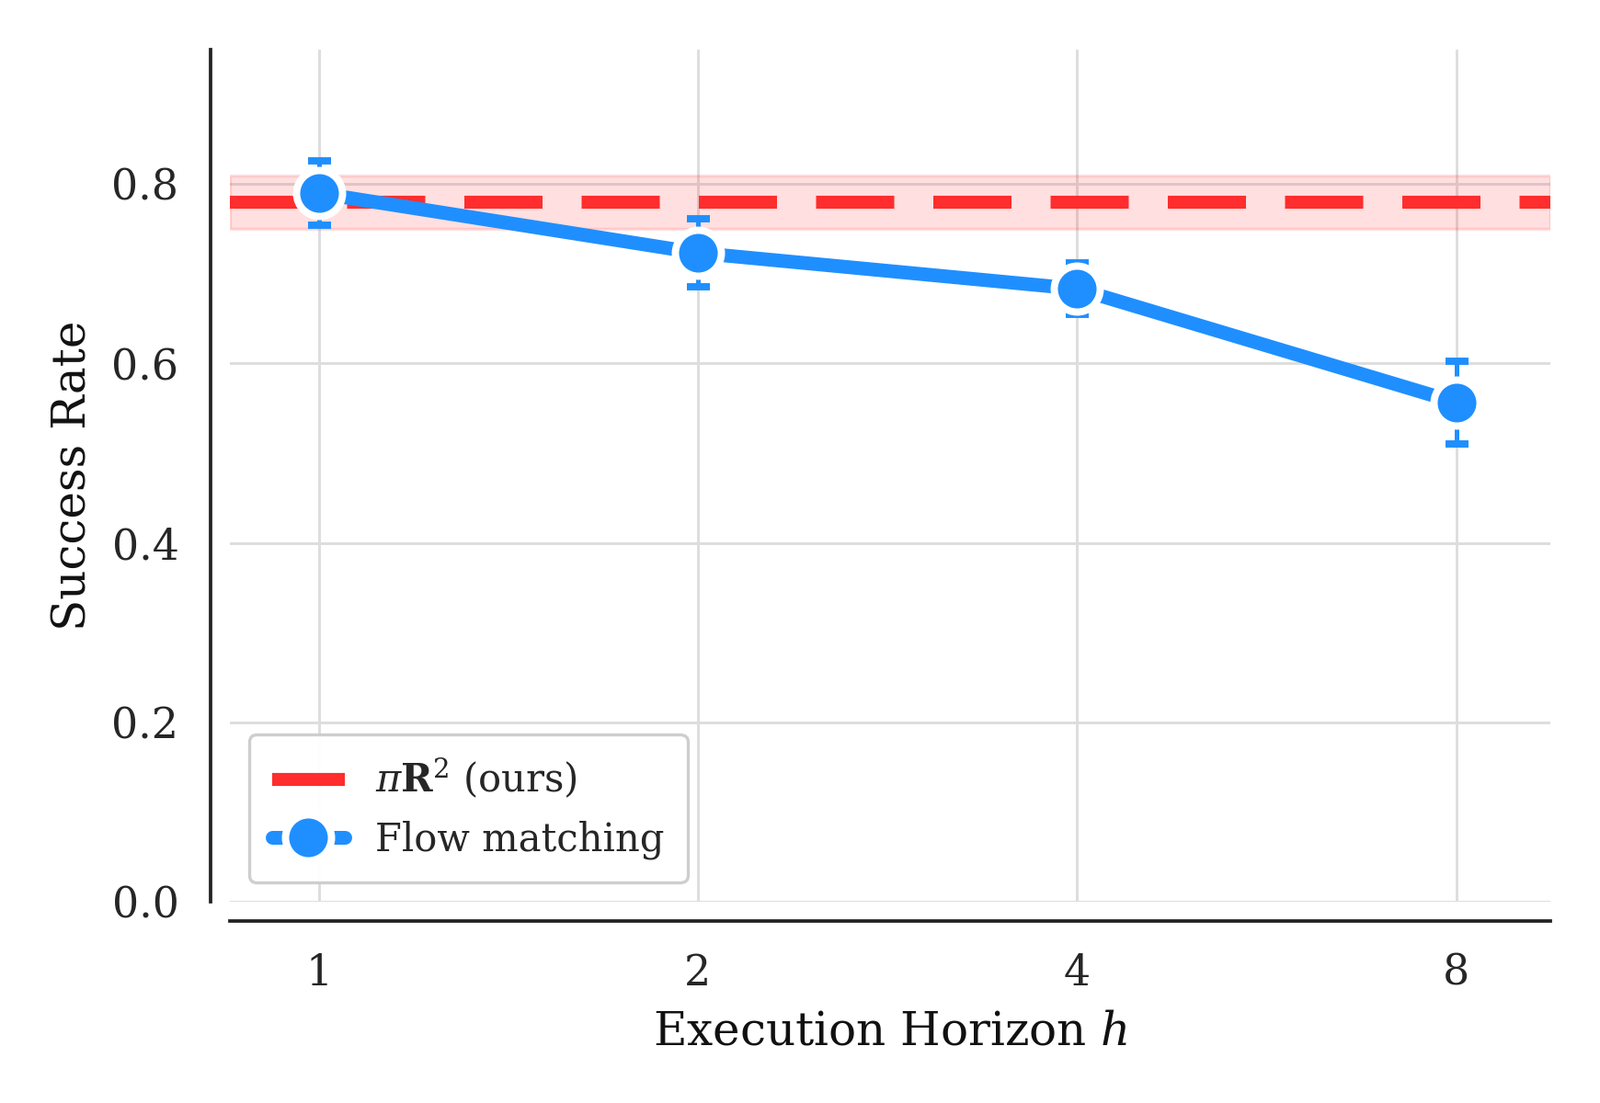
在首先进行的理想零延迟($d=0$)消融实验中(Figure 3 左图),标准流匹配策略展现出了显著的性能随开环步长 $h$ 增加而单调衰退的趋势:当执行步长从 $h=1$ 逐步拉长至 $h=8$ 时,由于大量动作无法感知中途状态,转动成功率呈断崖式下跌。而仅使用单步去噪预算(1 NFE per tick)的 $\pi\mathbf{R}^2$,其成功率完美追平了消耗 16 步完整去噪的 $h \in {1, 2}$ 标准策略。这直接证明:通过流式滑动平摊去噪预算,并不会损失动作生成的精度,同时还能完整保留单步高频重规划的敏锐反应。
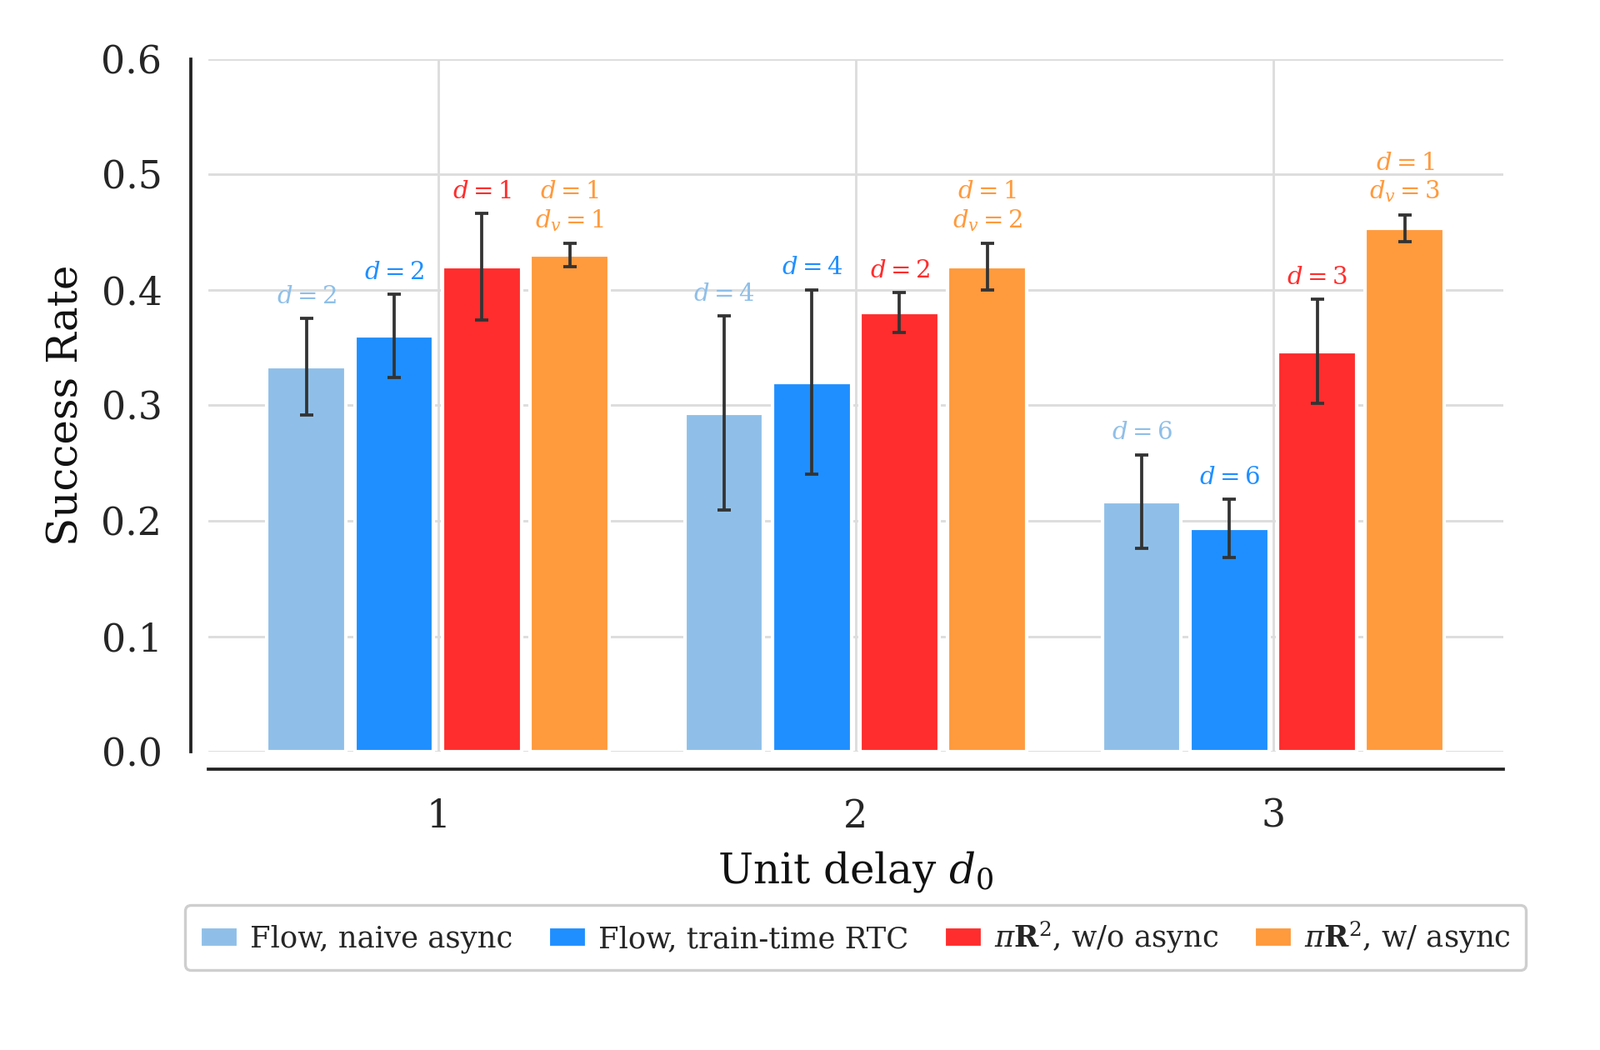
随后,实验引入了模拟 VLA 级别的真实端到端推理延迟(Figure 3 右图)。当基线模型背负完整的感知与多步去噪包袱时,其有效延迟迅速攀升至 $d = \lceil 1.75 d_0 \rceil$,导致包括训练期时延补偿策略(Train-time RTC)和朴素异步策略在内的所有传统方案在较大延迟下全线崩溃,成功率暴跌至 0.2 附近。相比之下,开启快慢异步通道的 $\pi\mathbf{R}^2$ 将动作端的直接延迟稳稳锁定在 $d=1$,仅让视觉延迟 $d_{\mathrm{vis}}$ 自然增长。数据显示,$\pi\mathbf{R}^2$ 的任务成功率随着延迟上升仅发生极为平缓的温和衰减,依然保持在 0.43 至 0.45 的高位,充分印证了本体感知在抵消动态延迟中的支柱作用。
实机验证:从摆动接书到灵巧插接的高难度跃升
仿真验证之后,CMU 团队在配备 XHand 仿生灵巧手的 xArm6 机械臂平台上搭建了严苛的实机评估环境,策略底座统一采用预训练的通用机器人大模型 GR00T-N1.7。测试涵盖了多项富接触且极易因动态失衡而崩溃的操控场景:
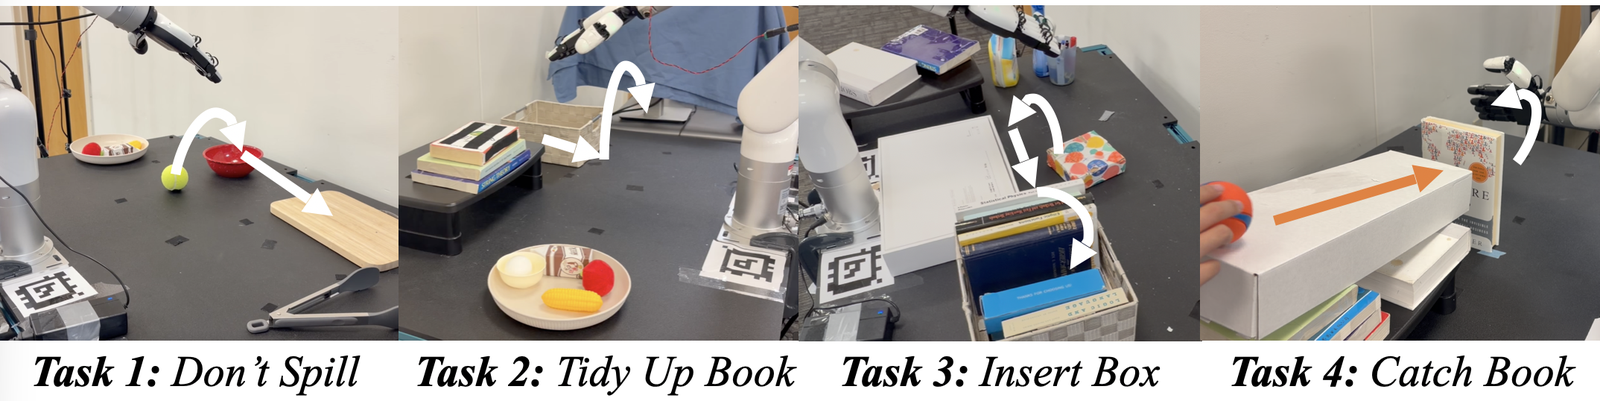
任务包括整理书本(Tidy Up Book,要求手掌与书脊紧密交互并在受扰时自适应微调力道)、小盒精确插接(Insert Box,狭窄装配公差)、接住掉落的书本(Catch Book,强动态响应测试)以及动态物体定位。
实机测试的对比表现极为悬殊。传统的同步推理策略由于每个动作块末端需要等待 140ms 的模型重新计算,机械臂在块与块的交界处会出现明显的肉眼可见停顿,导致动态操作频频失败(如球直接滚落台面);采用滑动加权平均的朴素异步方法虽然勉强平滑了动作,却因为混合了不同时刻的过时轨迹而丢失了末端几何精度。目前学界最强的实时基线方案 Train-Time RTC 虽然解决了运动连续性问题,但在面临突发接触扰动时,模型先前生成的在飞动作(In-flight actions)会强烈诱导策略沿着既定错误轨迹滑行,难以实现快速纠偏。
$\pi\mathbf{R}^2$ 则在这些高难度任务上展现出了极高的统治力,实机任务成功率相对最强基线实现了 20% 到 30% 的绝对增长。在部署中,结合异步视觉推理的 $\pi\mathbf{R}^2$ 跑在了单控制时钟周期极限附近(25Hz 部署下 $d=1$,偶有网络抖动退化为 $d=2$),即便出现操作失误,系统也能以 40ms 一次的极高频率立刻感知并输出自纠偏动作。
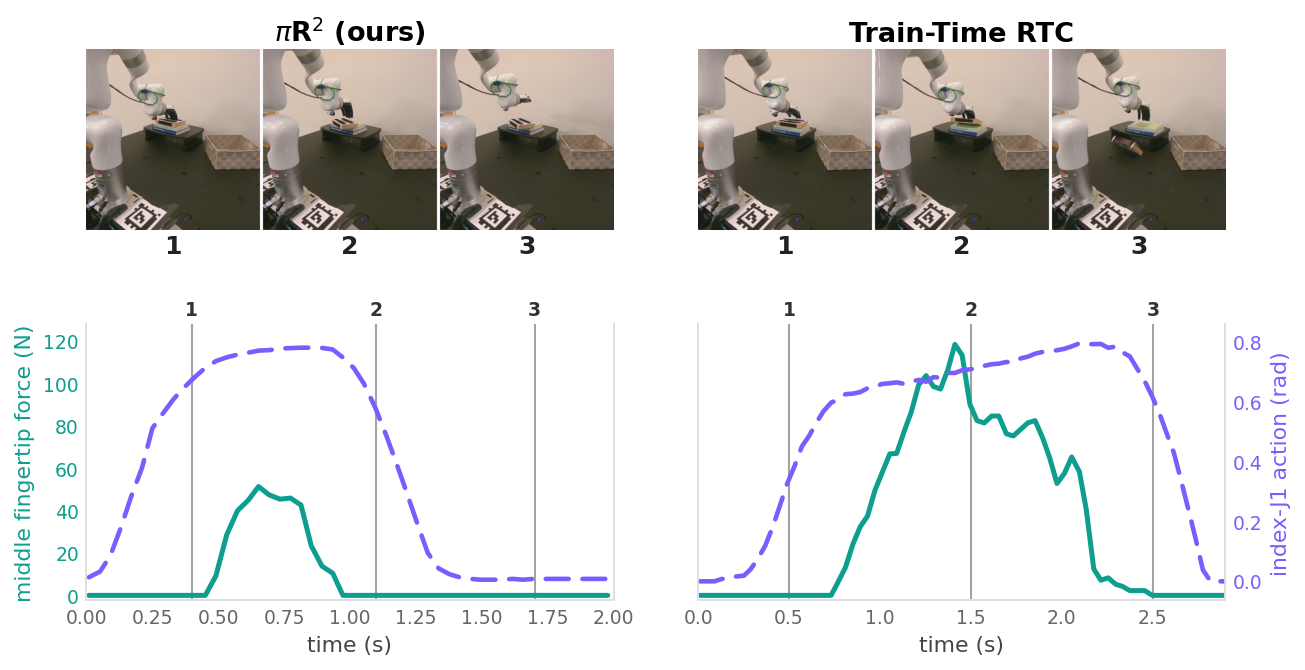
为了解剖 $\pi\mathbf{R}^2$ 反应能力的物理本质,论文对“整理书本”任务中的指尖压力与动作输出进行了时序微观透视(Figure 5)。当机械臂指尖触碰到书本瞬间,$\pi\mathbf{R}^2$ 凭借每 40ms 一次的本体感觉高频闭环,在接触力达到约 50N 时便迅速收敛动作输出,维持了恰到好处的自适应夹持力度,顺利将倾斜的书本扶正归位。作为对比,反应迟钝的 Train-Time RTC 在接触发生后由于仍然执行着上一周期的指令,无法及时感知反作用力激增,闭环调整严重滞后,导致其盲目过载施力直至指尖压力暴增至 120N 极限,最终直接挤飞书本导致任务溃败。这一对比有力地揭示了高频本体闭环在物理交互中的决定性意义。
总结与展望
$\pi\mathbf{R}^2$ 的核心贡献在于理清了大模型泛化性与底层机器人闭环控制之间的内在张力。长久以来,学术界与工业界常陷入一种非此即彼的纠结:要么为了追求语义理解与泛化能力,忍受庞大 VLA 模型的迟钝动作;要么为了追求敏捷的高频伺服,被迫退回参数量极小的纯关节控制策略。
这项工作用极富工程智慧的架构设计指出了一条兼得之路:大模型的计算延迟不必成为控制频率的天花板。将高维沉重的视觉语义作为“慢通道”提供宏观航向,将轻量敏捷的本体感觉作为“快通道”掌控局部动态,再配合数学上高度优雅的单步 Diffusion Forcing 阶梯滑动调度,就能让巨型 VLA 模型在物理世界中跑出 25Hz 的实时闭环反应。
正如作者在局限性讨论中所指出的,目前的架构仍有延展空间。策略虽然实现了本体感知的高频注入,但模型底座的注意力层结构尚未针对触觉或本体信号进行非对称偏置设计;同时端到端流水线中依然存在跨进程网络通信的外生时延。但毫无疑问,$\pi\mathbf{R}^2$ 所开辟的“异步语义感知 + 同步物理闭环”范式,为基于大模型的具身智能迈向高动态、富接触的高级物理交互,提供了一份极具落地价值的标准工程蓝图。