FlashDrive:打破VLA四级瓶颈,10B自动驾驶大模型提速4.7倍跨入实用门槛
FlashDrive: Flash Vision-Language-Action Inference for Autonomous Driving
端到端自动驾驶正在经历一场由视觉-语言-动作(Vision-Language-Action, VLA)模型引领的技术转向。传统的模块化架构在面对感知盲区、遮挡甚至罕见的长尾路况时,往往因为各子模块之间的硬编码接口而显得脆弱;而将多模态视觉理解、因果链推理与连续轨迹生成统摄于一体的 VLA 模型,则展现出了强大的泛化潜力。然而,这类大模型通向车载落地的路径上横亘着一块巨大的绊脚石:计算开销极其昂贵。以业内知名的开源 10B 级别端到端驾驶模型 Alpamayo 1.5 为例,在工作站级显卡 NVIDIA RTX PRO 6000 上,单帧推理时间高达 717 毫秒,折算出的控制频率仅有区区 1.4 Hz。对于在城市复杂路况中疾驰的车辆而言,超过半秒的规划延迟几乎等于盲开。
ArXiv URL:https://arxiv.org/abs/2608.12932v1
来自普林斯顿大学、加利福尼亚大学圣迭戈分校等机构的联合研究团队指出,VLA 模型的推理延迟绝不是单一的性能热点问题,而是一个由四个截然不同阶段构成的“四级级联瓶颈”(Cascade of Four Bottlenecks):视觉编码、语言模型预填充、因果推理自回归解码,以及基于流匹配(Flow-Matching)的轨迹生成。每个阶段背后的计算特性和冗余成因迥异,任何单一维度的工程修补或局部加速,都会被其他未优化的阶段迅速稀释。
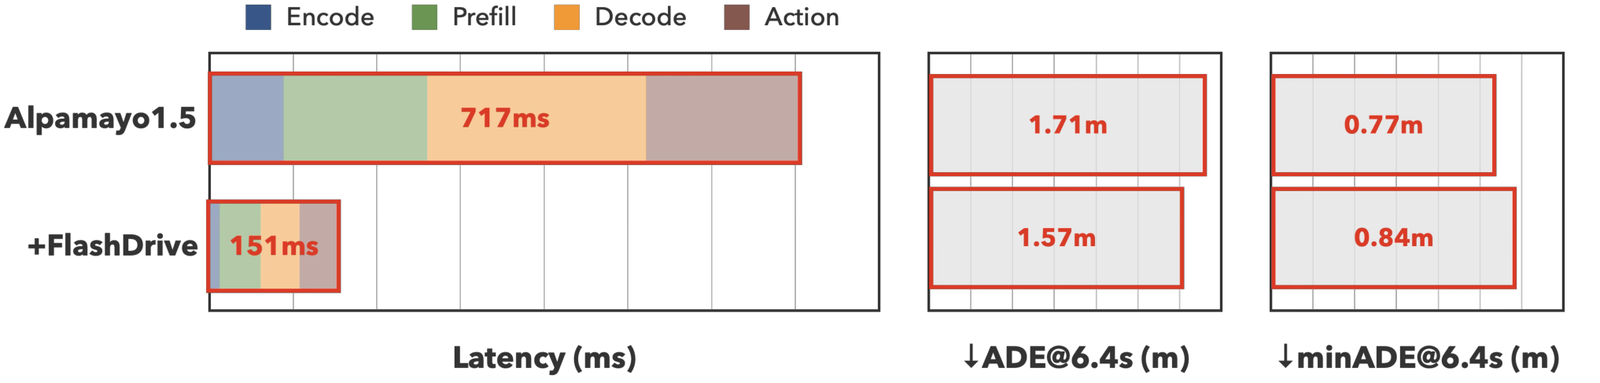
针对这一核心痛点,研究团队提出了名为 FlashDrive 的算法-系统协同优化框架。FlashDrive 并没有大动干戈去重构模型底座,而是针对流水线中四个阶段的具体冗余,分别设计了四套四两拨千斤的轻量级算法捷径:面向视频时间重叠的流式 KV-Cache 复用、基于非自回归扩散模型的推测解码、针对流匹配速度场几何特性的自适应步长缓存,以及适配预填充与解码混合特性的 W4A8 混合精度量化。叠加底层的 CUDA Graph 图编译与算子融合后,FlashDrive 将 Alpamayo 1.5-10B 的单帧端到端延迟从 717 ms 压缩至 151 ms,实现 $4.7\times$ 的整体加速,使模型控制频率跃升至实用的 6.6 Hz。更令人瞩目的是,这种激进的提速不仅使轨迹精度指标 $\text{minADE}{6}\text{@6.4s}$ 仅轻微波动 0.08 米,其单轨迹规划精度 $\text{minADE}{1}\text{@6.4s}$ 甚至逆势改善了 0.13 米。
为什么孤立优化无法解救自动驾驶 VLA?
理解 FlashDrive 的出发点,必须先剖析自动驾驶场景下 VLA 推理管线的特殊性。不同于云端对话大模型主要处理离散文本且单次请求相互独立,车载 VLA 模型需要面对多路摄像头的高分辨率连续视频流,并在严苛的时延预算内输出高精度的连续物理控制量。这一复合任务被分解为四个串行环节:
在视觉编码(Encode)阶段,视觉塔需要对来自 4 个相机视角的滑动时间窗口图像进行特征提取。通常一个窗口包含连续 4 帧图像,当时间步向前滚动时,新窗口与旧窗口存在高达 75% 的图像重叠,但传统做法却在每一个控制周期不加甄别地从头重新编码全部帧。紧接着的预填充(Prefill)阶段,多模态大语言模型(VLM)需要吞吐数千个图像与系统指令 Token 来填充键值缓存(KV-Cache),而其中绝大多数视觉上下文在上一刻早已经历过完全一致的前向计算。
进入解码(Decode)阶段后,模型开始进行因果链(Chain-of-Causation, CoC)推理。为了确定转向意图、障碍物避让逻辑与速度建议,模型需要逐个 Token 自回归地生成推理序列。尽管驾驶场景下的推理文本通常只有短短十几个 Token,但自回归机制不可避免地受制于显存带宽瓶颈与频繁的内核启动开销。最后的动作生成(Action)阶段,模型引入基于连续时间常微分方程(ODE)的流匹配去噪网络,通过多步前向迭代,将高斯噪声逐步拉平并映射为高精度的连续轨迹路点。在默认的 8 步求解器中,每一步都需要完整调用一次动作专家网络。
如果仅仅优化其中某一项,例如换用更小的视觉骨干或者将去噪步数强行砍半,剩余环节的高额耗时仍然会让端到端延迟停留在数百毫秒的高位。正是这种级联结构的约束,决定了破局之道必须是全链路协同打击。
流式推理:榨干视频时域连续性的每一丝冗余
在连续驾驶过程中,车辆感知到的外部物理世界具有极高的时间连续性。FlashDrive 首先开刀的正是前端冗余最大的编码与预填充阶段。滑动窗口机制中每次只新增一帧最新图像,剩下的三帧全为历史数据。FlashDrive 提出的流式推理方案非常纯粹:只对最新的单帧执行视觉编码,历史帧的键值表示则直接从前序时间步持久化保留的 KV-Cache 中读取。
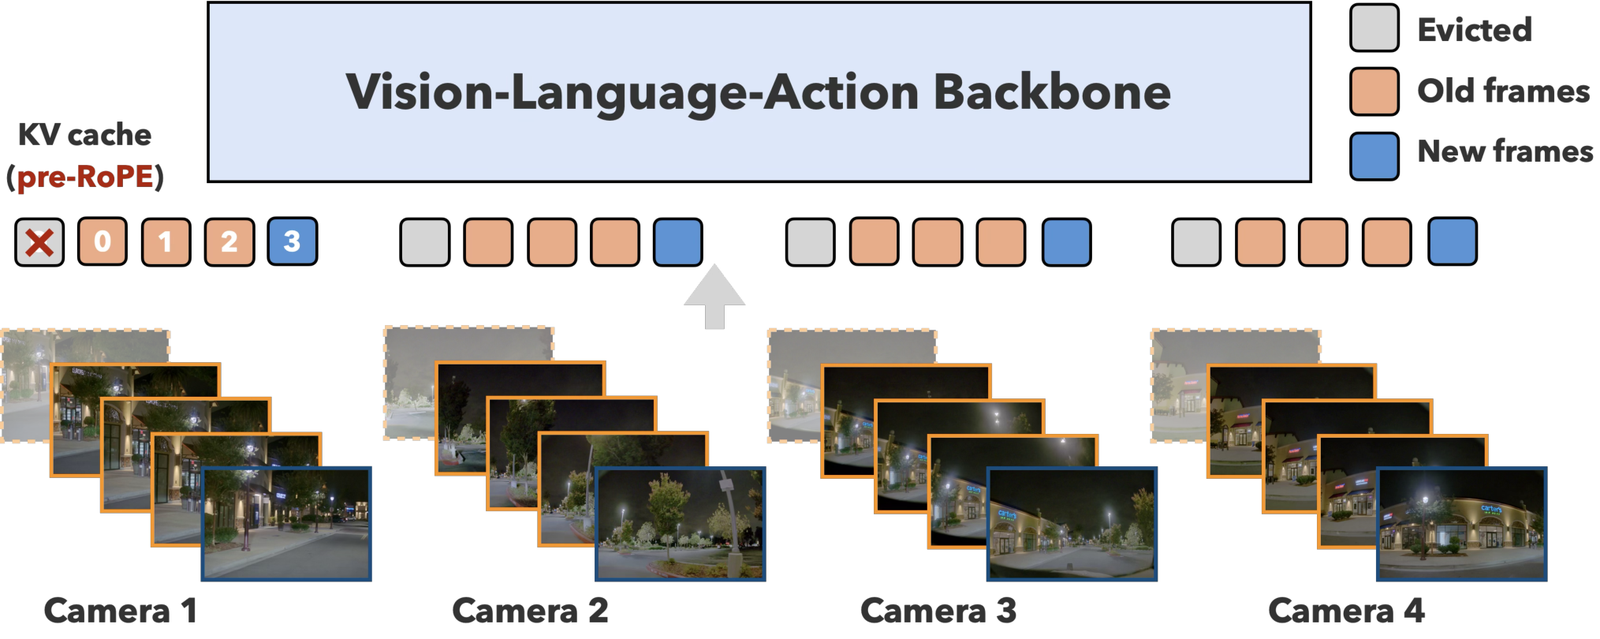
看似简单的缓存复用,在工程落地与模型结构上面临两道现实暗礁。其一是视角排列错位。以 Alpamayo 1.5 为代表的先锋模型为了捕捉同一视角在时间上的运动变化,其视觉 Token 是按“视角优先”(View-Major)而非“时间优先”展开的——即先把相机 A 的全部历史帧排完,再排相机 B。如果在缓存尾部无脑追加新帧,将彻底打乱底座模型预训练所习惯的跨视角空间排布。为此,FlashDrive 重构了注意力机制,设计了专用的流式注意力掩码(Streaming Attention Mask)。系统将新输入单帧的 Token 精确注入到各个视角对应的末尾槽位,并在掩码矩阵中施加因果约束,确保新 Token 仅作为 Query 去检索缓存中的历史 Token,同时维系严格的跨视角因果结构。
其二是旋转位置编码(RoPE)的失效问题。标准的大语言模型在生成 KV-Cache 时,会直接将绝对位置编码绑定到 Key 向量中(Post-RoPE)。然而在滑动时间窗口中,上一帧位于相对位置 $p$ 的 Token,随着新帧的推入,其相对窗口末尾的时间距离变成了 $p - \Delta$。如果直接沿用固化了旧位置信息的缓存,位置偏差会导致注意力权重计算失真。FlashDrive 的解决方式是将 Key 缓存维持在未注入位置编码的原始状态(Pre-RoPE Key Storage),直到流式注意力计算被触发的瞬间,才在算子内部根据动态重定后的相对坐标实时注入 RoPE。这一机制使视觉编码与预填充的有效计算量瞬间骤降 75%,两阶段直接获得了超过 $3\times$ 的端到端加速。
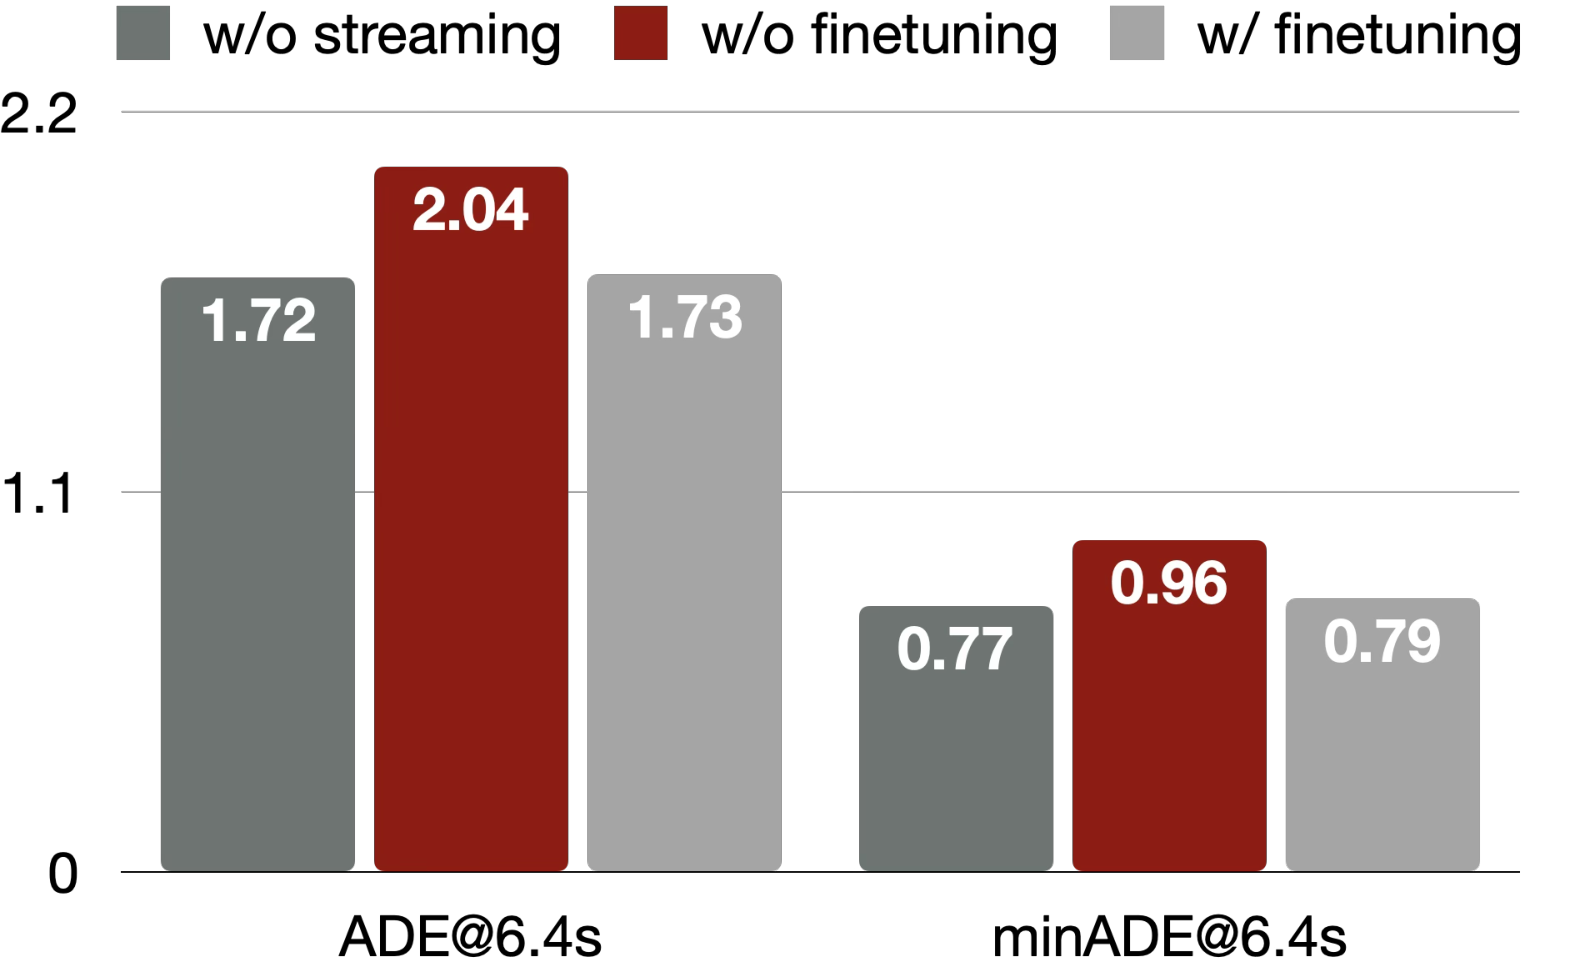
不过,缓存虽然省下了算力,却引入了注意力上下文的微小近似误差:缓存中的历史表示是在旧的全局上下文中计算得出的,与从头进行一次完整前向传播所获得的状态存在一定的分布偏移(Distributional Shift)。实验表明,这种偏移如果放任不管,会导致轨迹预测的开环平均位移误差(ADE)恶化约 0.2 至 0.3 米。
有趣的是,研究团队在深挖后发现了误差传播的非对称性:语言生成头由于天然遵循因果局部性,注意力高度集中在最近生成的语义上,对久远帧的缓存轻微失真几乎免疫;相反,动作专家网络需要通过全量交叉注意力(Cross-Attention)汇总全部视觉与文本特征来回归连续轨迹,对表征空间的细微形变极其敏感。针对这一发现,FlashDrive 提出了一种极具针对性的流式微调(Streaming Fine-Tuning)策略:将庞大的 VLM 骨干网络完全冻结,只微调动作专家网络。训练中引入基于教师强迫(Teacher-Forcing)的时域展开机制,模型在一个包含多步推进的随机滑动窗口上展开前向计算,前序步骤完全复现部署时不断累积的近似缓存,仅在窗口最后一步回传梯度。这一轻巧的适应性训练彻底抹平了分布裂隙,使轨迹预测性能完全恢复到了全量重算基准的水准。
扩散草稿模型:为高度结构化的驾驶思维定制推测解码
自回归推理一向被视为大模型的速度杀手,但将通用大模型领域的推测解码(Speculative Decoding)生搬硬套到自动驾驶中,往往会遭遇接受率低、验证开销大的困境。FlashDrive 能够在此取得突破,根本原因在于其敏锐地抓住了自动驾驶因果推理的本质属性:极低的信息熵与极强的块内相关性。
在驾驶行为中,因果链推理文本绝非漫无边际的自由创作。通常类似“前车减速,本车保持车道并轻踩刹车”这样的推理逻辑,序列长度通常仅有 16 个 Token 上下,且严格受限于当前的道路拓扑、车道线引导、周边动态目标以及自车运动状态。高维的丰富视觉特征实际上已经预先确定了大部分语义走向。这意味着候选 Token 的概率分布极其收敛,每个位置的不确定性(Per-token Entropy)非常低,为推测解码提供了天然极高的理论接受率上限。不仅如此,决定变道之后几乎必然紧接着对应的速度规划词汇,相邻 Token 之间呈现出咬合紧密的强关联性。
传统的推测解码多采用更小规模的自回归小模型作为草稿模型(Drafter),这会导致小模型内部依然要忍受串行生成的延迟折磨。鉴于驾驶推理文本块内部的高度相关性,FlashDrive 另辟蹊径,引入了基于非自回归扩散语言模型的并行草稿机制 DFlash。
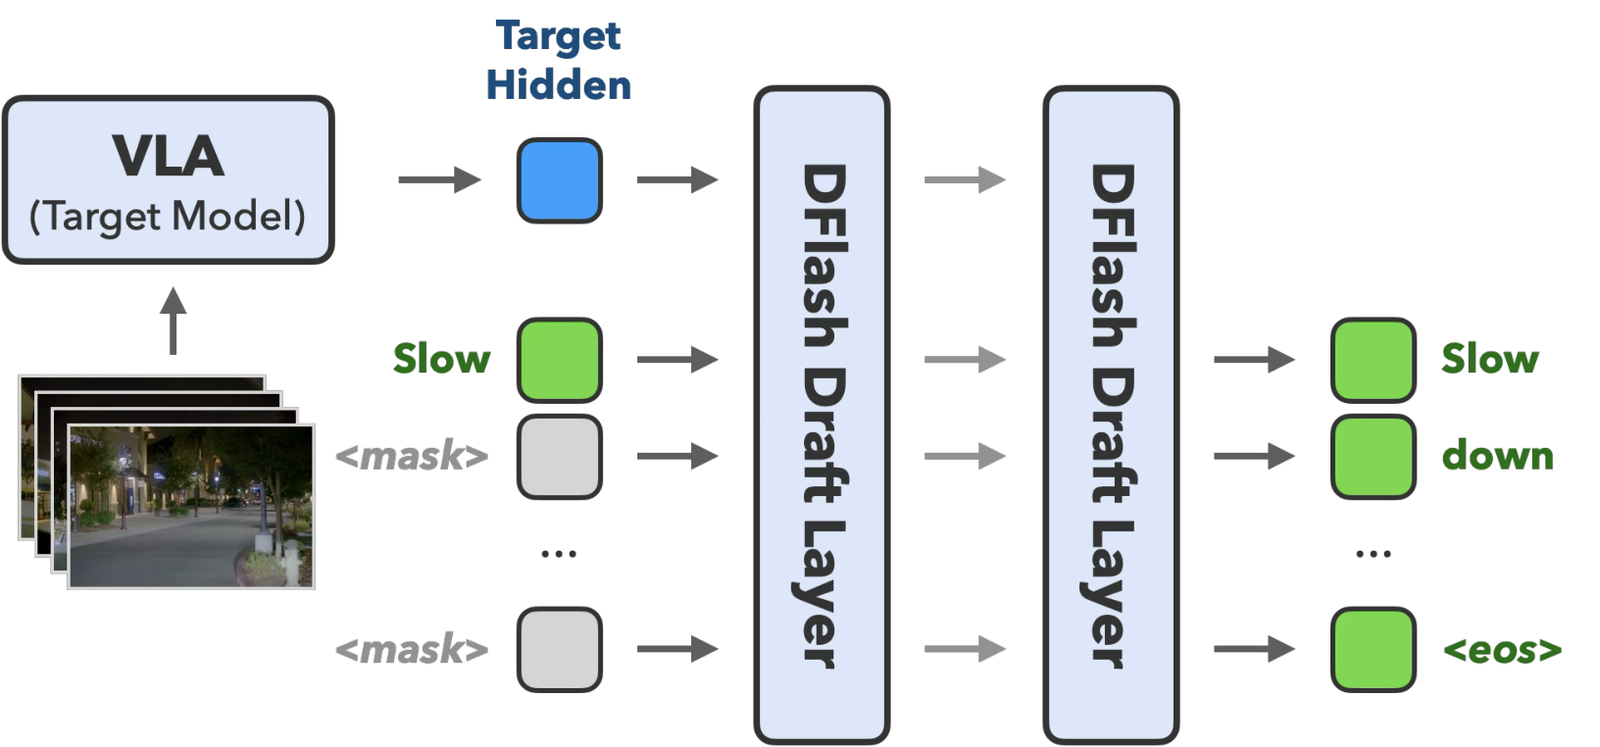
DFlash 彻底摒弃了自回归草稿的串行生成路径,通过单次前向扩散步骤,直接并行输出一整块(Block Size = 8)候选 Token。为了避免目标模型在验证阶段承受过重的隐藏状态计算负担,FlashDrive 对 DFlash 的交互接口进行了大幅裁剪:仅仅截取目标 VLM 验证通过的最后 8 个 Token 的隐藏状态,将其融合并注入到仅有两层的轻量级草稿模型的 KV-Cache 中。这 8 个 Token 所承载的信息密度足以支撑草稿模型对下一块语义做出精准预判。在实际评估中,该设计达成了单次推测平均接受 5.6 个 Token 的惊人效率,将因果链解码延迟从原始基线的 275.3 ms 大幅压缩至 58.2 ms,斩获了高达 $4.7\times$ 的单阶段加速比。
自适应步长流匹配:两头要准,中间要快
当推理推进到最后的动作生成阶段,耗时大户落在了流匹配去噪网络上。为了把离散的高层决策具象化为毫米级精度的物理轨迹,传统的 8 步 ODE 求解器必须调用 8 次动作专家前向计算。以往的模型压缩工作在面对扩散或流匹配模型时,往往诉诸均匀削减步数(例如粗暴地改为 4 步),但这常常会引发轨迹震荡,导致碰撞率显著上升。
FlashDrive 团队对去噪轨迹中的速度场 $v_t$ 进行了细致的动力学剖析,发现均匀处理是一个巨大的误区。通过监测连续步骤之间速度向量的相对差异与余弦相似度,一条鲜明的 U 型与倒 U 型曲线浮出水面:
这一数学现象背后有着深刻的物理意义:
-
在去噪的最早阶段(Step 1–2),输入主要为高斯噪声,向量场需要施加极大的加速度让轨迹脱离随机分布,迅速确立大尺度的宏观决策轮廓(如决定左转、右转还是保持直行),因此速度方向急剧偏转;
-
在去噪的最末阶段(Step 7–8),轨迹已经贴近真实数据分布,但必须严格对齐动力学几何曲率与车道线边界,流场需要执行微妙的高频修正以确保轨迹满足自车动力学约束,速度向量再度发生剧烈收敛;
-
然而在居中的过渡阶段(Step 3–6),连续时间 ODE 实际上正穿过一段极其平滑、曲率极低的平坦向量场。前后步骤之间的速度余弦相似度极高,计算出的修正量近乎恒定。
“两端定乾坤,中间推惯性”的物理现实启发了自适应步长缓存(Adaptive Step Caching)的诞生。FlashDrive 坚决保留了第 1、2 步与最后 7、8 步的完整前向网络推理,确保粗粒度决策方向与最终物理合规性不受损伤;而对于中间第 3 至 6 步,直接复用前一步计算并缓存下的速度向量,跳过昂贵的动作专家调用。这一举措直接将去噪阶段的耗时从 113.9 ms 削减至 47.6 ms,加速达 $2.4\times$。
最耐人寻味的是,跳过中间步骤的重复迭代并没有损伤精度,反而使 $\text{minADE}_{1}$ 从 1.71 米改善到了 1.57 米。研究人员推断,由于中间阶段的向量场极度平滑,每一次冗余的网络前向评估实际上都在引入浮点计算与神经网络拟合的微小方差,跳过这些微调相当于在数值求解器中引入了一种隐式平滑正则,反而减少了累积误差。
W4A8 混合量化与系统层压榨
算法层面的减负扫清了冗余计算量,而系统工程与量化技术的跟进则进一步将硬件性能压榨至极限。对于参数量达到 10B 尺度的 Alpamayo 1.5 而言,仅半精度(FP16)权重与激活就会吞噬超过 31 GB 的显存,在许多边缘车规级芯片或主流消费级 GPU 上极易诱发显存溢出(OOM)。
传统的纯大模型量化通常偏向仅对权重做 4-bit 量化的 W4A16 方案(如 AWQ),因为对于纯文本长文本生成的聊天模型而言,解码阶段属于典型的显存带宽受限(Memory-bound)任务,只要压小模型权重即可提升吞吐。然而正如前文所述,自动驾驶 VLA 模型在每次控制循环中都包含数千个高分辨率视觉 Token 的预填充过程,预填充是一个不折不扣的算力受限(Compute-bound)操作。如果不对激活值进行量化,就无法调用硬件底层高效的低比特 Tensor Core。
为此,FlashDrive 选用了 W4A8 量化配置,采用 ParoQuant 算法对 VLM 骨干网络权重实施 4-bit 量化,并将激活压缩为 8-bit,推理执行则交由 Marlin W4A8 高性能算子承载。而对连续轨迹输出极为敏感的动作专家网络,则审慎保留 BF16 精度以防控制量抖动。这样一来,不仅显存占用从 31.6 GB 骤降至 18.3 GB,而且兼顾了显存带宽缓解与 INT8 张量计算加速,在算法优化后的剩余延迟中又榨取出了额外的 14% 加速比。
在执行引擎底层,针对 VLA 异构流水线带来的调度碎片化问题,FlashDrive 展开了彻底的算子整治。由于串联了视觉编码器、预填充、短自回归以及小尺寸动作网络,原始模型在前向传播中充斥着成百上千个微小内核的频繁下发,单批次(Batch size = 1)下 CPU 端的下发开销(Launch Overhead)严重阻碍了 GPU 的计算流水线。团队将四大阶段分别封装编译为不可变的 CUDA Graph,实现单次 GPU 端触发调度;同时针对注意力投影矩阵与 MLP 的前向通道实施内核融合(Kernel Fusion),将零碎的访存与计算算子合并收敛。仅仅是这一纯系统层面的底座重构,就为全流程提供了 $1.40\times$ 的基准提速。
实验印证:毫秒级响应下的高质量控制
在基于真实的 NVIDIA 自主驾驶数据集(包含超过 6 万个视频片段)的大规模基准评测中,FlashDrive 展现出了兼顾极致速度与物理安全性的综合表现。在搭载单一 NVIDIA RTX PRO 6000 的工作站上,随着优化特性的逐层堆叠,各阶段的耗时呈现出清晰的收敛轨迹:
-
阶段耗时蜕变:原始未优化的 Alpamayo 1.5-10B 总耗时 717.0 ms(编码 129.8 ms、预填充 198.0 ms、解码 275.3 ms、动作 113.9 ms);在引入 CUDA Graph 与内核融合后降至 513.3 ms;进而注入流式推理、DFlash 扩散推测以及自适应步长后骤降至 176.0 ms;最终结合 W4A8 量化,定格在 151.4 ms,总加速比达到 $4.7\times$。
-
开环轨迹质量:在经典的 6.4 秒预测窗口下,反映规划宽容度的 $\text{minADE}{6}$ 仅由基线的 0.767 米轻微浮动至 0.844 米,增加的 7.7 厘米位移误差在长达 6.4 秒的时间跨度内折合每秒漂移仅约 1.2 厘米,完全处于车道保持与物理规划的安全冗余之内。而在考察确定性路径预测的 $\text{minADE}{1}$ 指标上,FlashDrive 实现了从 1.705 米到 1.573 米的正向优化。
除了工作站平台,研究人员还将 FlashDrive 移植到了从边缘车规算力到消费级旗舰的不同计算设备上进行泛化检验。无论是在工业级自动驾驶边缘计算模块 Jetson Thor 上,还是在消费级的 RTX 3090、RTX 4090 以及最新的 RTX 5090 显卡上,FlashDrive 均稳健地维持着 $4.0\times$ 至 $6.0\times$ 的端到端加速效能。更值得关注的是多轨迹采样场景:当车辆需要实时并发评估 6 条候选行驶轨迹以应对复杂博弈时,原始基线在 24 GB 显存的消费级显卡上会瞬间陷入显存溢出死锁,而得益于 W4A8 显存削减与自适应缓存的 FlashDrive 不仅能平稳运行,在 RTX 5090 与 RTX PRO 6000 上的加速比更是分别放大到了惊人的 $10.0\times$ 与 $10.6\times$。
结语与行业启示
FlashDrive 为大模型时代的具身智能与自动驾驶落地提供了一个极具示范意义的样本。它没有盲目追求纯粹通过缩小模型参数来迁就硬件,也没有为了推测解码而强行设计低效的级联结构,而是跳出单纯的系统调优或单纯的算法魔改,站在整个控制链路的全局视角重新定义问题。
这项工作最核心的技术洞见在于:复杂管线的终极加速,来自于对各个子任务领域特有物理规律与计算特性的深度解耦。 视频流的时间相关性造就了流式注意力;驾驶意图的确定性与强前缀约束盘活了非自回归扩散推测;流匹配流场两极陡峭、中段平坦的动力学结构让跳步缓存不仅无害反而去噪;而图编译与混合精度量化则在系统层面将上述算法收益转化为实打实的硬件吞吐。当参数量高达 10B 且具备因果思考能力的端到端大模型能够在单张 GPU 上以近 7 Hz 的频率持续输出安全轨迹,大模型真正接管物理世界方向盘的时刻,已然不再遥远。