ReflexVLA:推理延迟砍半至65ms,时序预测让轻量VLA搞定动态操作
Reflex: Enabling Fast and Predictive Vision-Language-Action Models for Reaction-Critical Manipulation
现有的视觉-语言-动作(Vision-Language-Action, VLA)模型在机械臂静态操作任务上取得了亮眼的进展,但只要环境中的物体“动起来”,哪怕只是在传送带上滑动、在转盘上旋转,或是需要机器人抓取抛来的小球,主流大模型就会频频扑空。这暴露出当前具身智能领域被长期掩盖的双重硬伤:绝大多数仿真基准在策略推理时会直接“暂停时间”,掩盖了现实中致命的计算延迟;而大多数模型本身缺乏短时动力学感知与前瞻预判能力,只能被动对“上一时刻的静止切片”做出反应。
ArXiv URL:https://arxiv.org/abs/2608.14379v1
上海交通大学团队近期提出的 Reflex 框架,直指机器人高动态、反应敏感(Reaction-Critical)操作的核心症结。研究包含两项核心成果:一是提出专门解耦环境推进与控制计算的动态评测基准 ReflexBench,支持在同步与异步模式下精准注入真实物理延迟;二是构建了参数量不足 1B 的紧凑型模型 ReflexVLA。该方案无需昂贵的海量真机预训练,通过在视觉主干中注入多帧时序融合、引入潜在未来预测(Latent Future Prediction),并结合 CUDA Graph 重放与视觉批量编码,将整机推理延迟从 $125.1\text{ ms}$ 骤降至 $65.0\text{ ms}$,在动态成功率大幅领先的同时,依然在经典静态基准 LIBERO 上维持了 $97.2\%$ 的顶级表现。
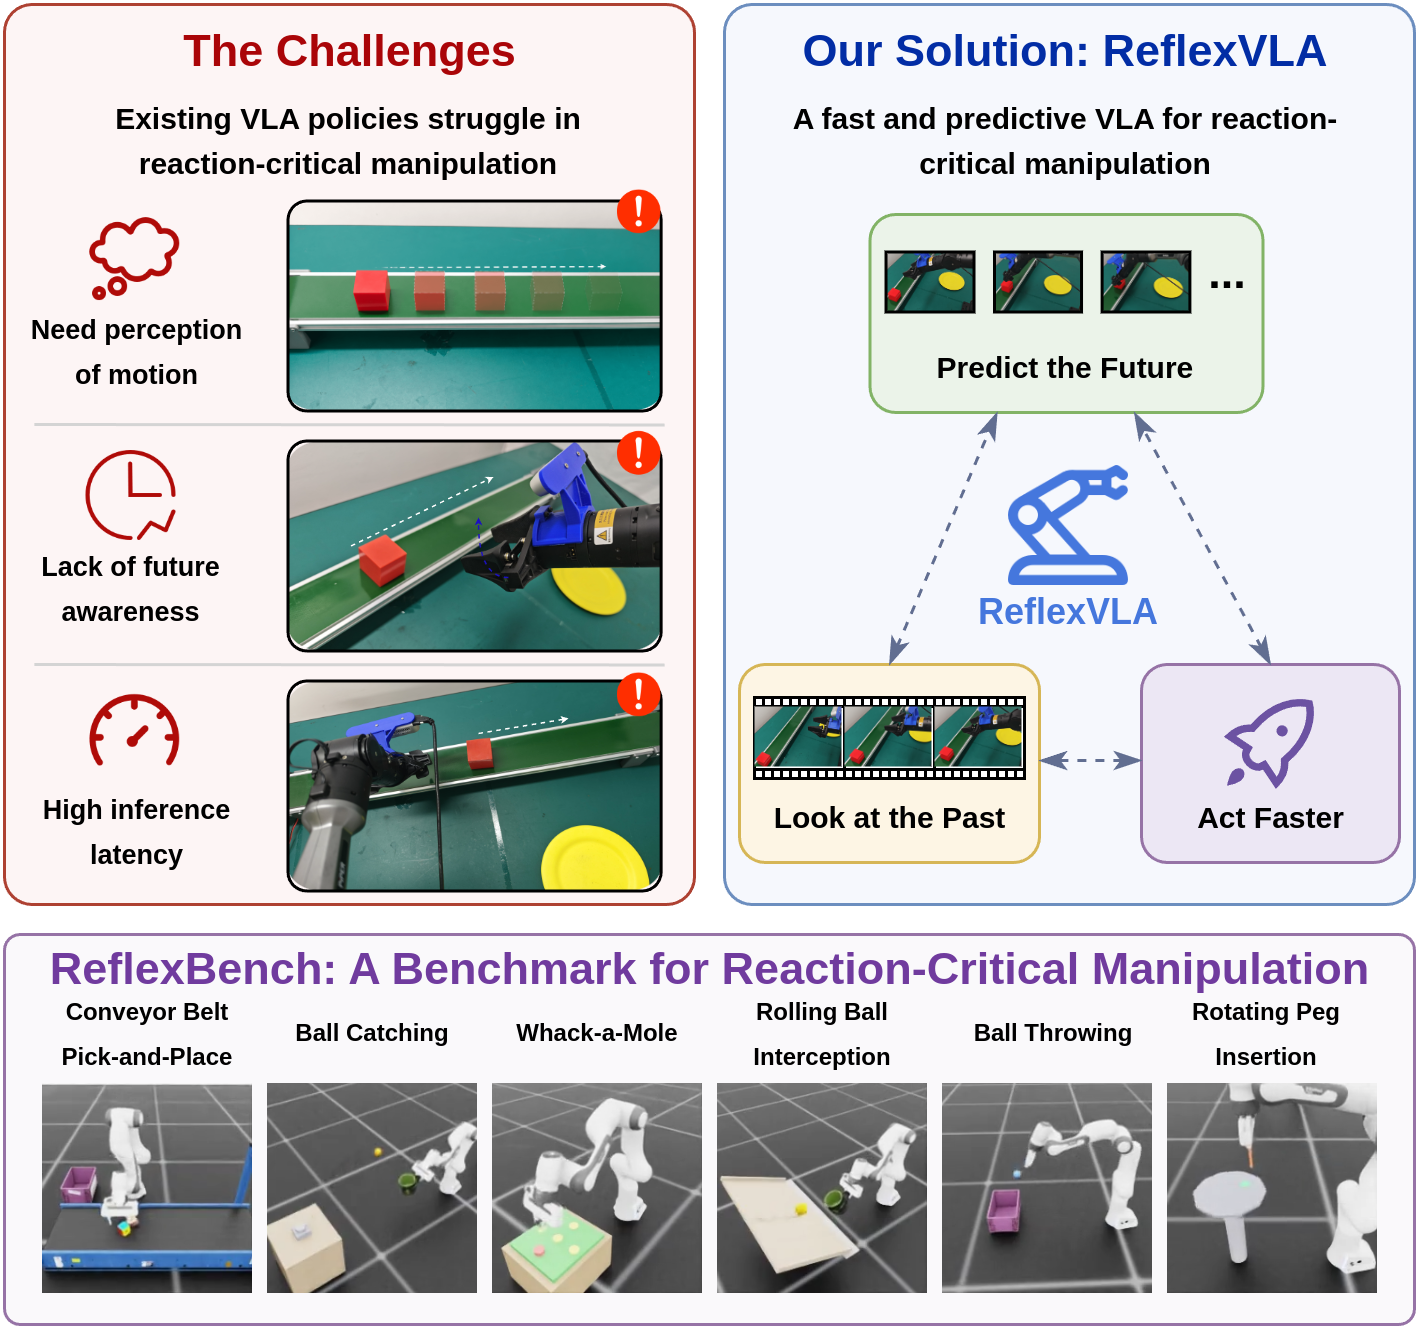
为什么在仿真里表现优异的 VLA,真机一动就失效?
机器人从摄像头捕获一帧画面,到传回控制指令驱动关节电机,中间存在不可消除的时间消耗。这一耗时在采用大语言模型作为主干的 VLA 架构中尤为显著,往往在几十毫秒到数百毫秒不等。在传统的抓取或放置任务中,被操作物体静止在桌面上,几十毫秒的延迟几乎没有负面影响;但在动态场景下,机器人依据 $t$ 时刻画面生成的抓取指令在 $t+\Delta t$ 真正执行时,目标物体的位姿早已脱离了原来的轨迹。
更深层的原因在于当前学术界的评测范式。主流仿真环境(如 RLBench、LIBERO 等)采用的是“步进锁步”逻辑:环境渲染出一帧图像,仿真引擎暂停等待神经网络完成前向计算,收到动作后再向前模拟一步。这意味着在模拟器内部,神经网络的推理延迟被默认为 $0\text{ ms}$。这种脱离物理规律的设置让模型完全不需要考虑自身推算速度与动态轨迹演化之间的对抗。
此外,直接将多帧画面拼接输入语言大模型的做法不仅会使 Token 数量呈乘法级暴增,还会由于自注意力机制平方级膨胀的计算量,让本就捉襟见肘的推理耗时雪上加霜。机器人陷入了一个恶性循环:为了看懂物体的运动速度,它必须看更多历史画面;而看了更多历史画面,算得就更慢,最终还是抓不住运动的物体。
ReflexBench:打破“时间静止”假设的动态评测基准
为了逼近物理真实,作者首先开发了 ReflexBench 基准。该基准包含 6 个典型的高动态操作任务,涵盖旋转孔位插拔(Rotating Peg Insertion)、动态拦截以及运动物体追踪等高难度工况。
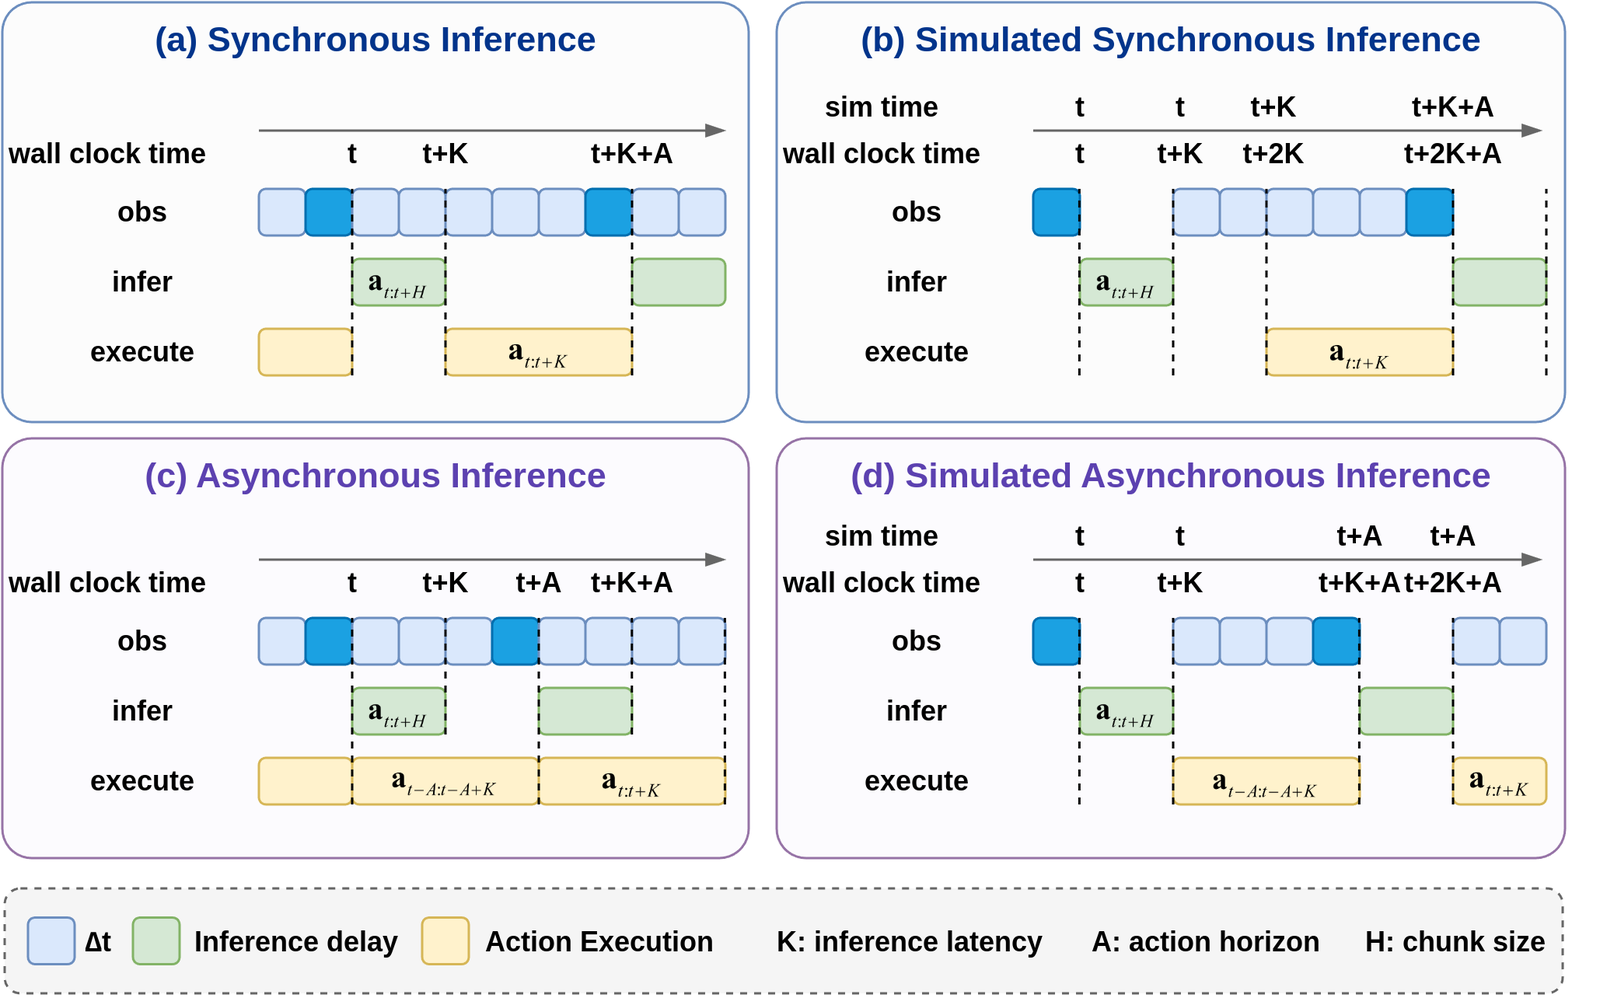
ReflexBench 的核心创新在于解耦了仿真步进与策略执行控制,引入了实时因子(Real-Time Factor, RTF)的延迟注入机制:
\[\mathrm{RTF} = \frac{t_{\mathrm{sim}}}{t_{\mathrm{wall}}}\]其中 $t_{\mathrm{sim}}$ 为模拟世界的时间跨度,$t_{\mathrm{wall}}$ 为仿真推进消耗的真实物理时间。评估系统先在真实硬件上精确测量模型部署后的实际端到端推理耗时,然后根据当前模拟器的 RTF 比例,将对应的计算延迟换算成仿真时间直接注入环境。在策略计算这几十毫秒内,仿真环境中的机械臂与运动目标会按照既有动力学持续演进,策略生成的动作只能作用于滞后后的未来时间片。
该基准同时支持经典的朴素同步推理(Synchronous)与实际工业界更通用的异步流式推理(Asynchronous)。在异步模式下,机械臂持续按动作块(Action Chunk)执行历史规划,而后台网络并发预测下一个时间窗口的动作序列。这种评测机制彻底剥离了过往算法依赖仿真暂停所获得的虚假性能,让不同模型在同一物理真实尺度下比拼吞吐、延迟与时序规划的综合能力。
ReflexVLA:预测未来与毫秒级减负的端到端设计
针对动态操作对“快”与“准”的苛刻要求,团队构建了紧凑型模型 ReflexVLA。模型并没有追求超大规模参数,而是基于紧凑的视觉-语言-动作架构,采用 DINOv2 与 SigLIP 双重视觉主干提取 $224 \times 224$ 分辨率特征,语言骨干网络选用了参数量仅 0.5B 的 Qwen2.5 架构。
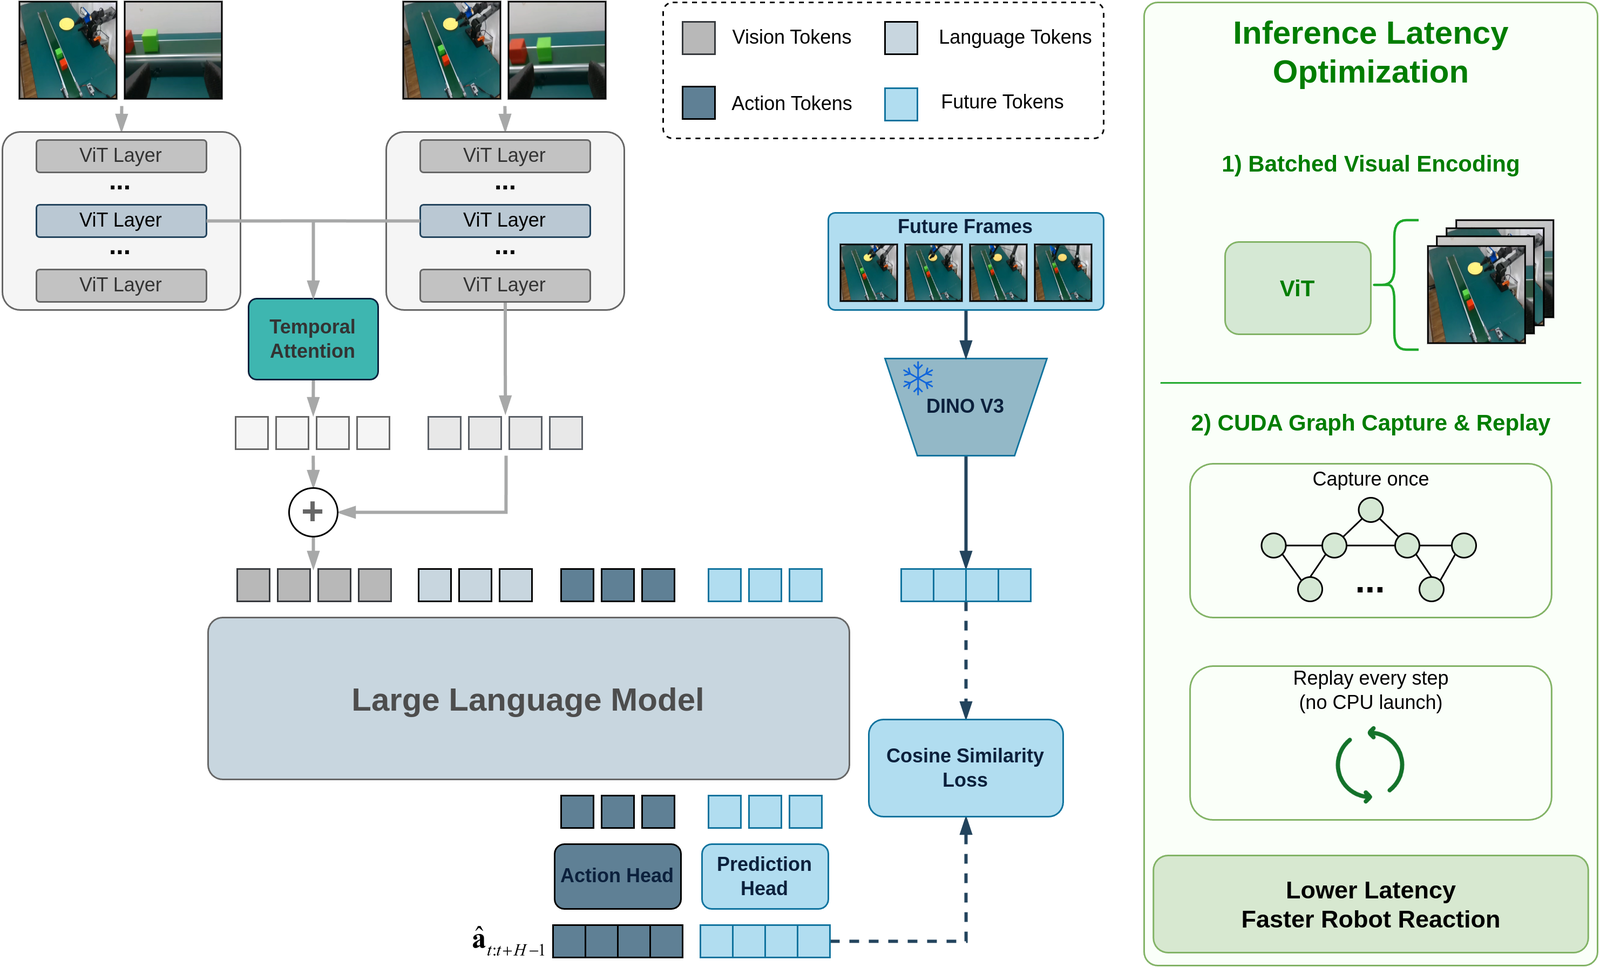
为让轻量模型具备足以抗衡物理延迟的动态响应能力,ReflexVLA 重点引入了三项相互配合的机制:潜空间未来预测、视觉端轻量时序融合以及系统级算子加速。
1. 潜空间未来预测(Latent Future Prediction)
对于高速移动物体,机器人动作规划的核心在于“提前瞄准未来位置”,而非追赶当下影像。以往工作尝试用自回归方式生成未来的 RGB 像素图像,但像素级生成不仅极其耗时,且充满了背景纹理等与物理控制无关的噪声。
ReflexVLA 采取了表征层级的隐空间预判。模型直接提取未来观测在预训练大模型空间内的紧凑特征 $\mathbf{y}_{t+i}$ 作为预测目标:
\[\mathbf{y}_{t+i} = \phi_{\mathrm{DINOv3}}(\mathbf{o}_{t+i}), \quad \mathbf{y}_{t+i} \in \mathbb{R}^{1024}\]利用动作查询机制在语言模型隐层提取未来意图特征 $\mathbf{h}^{\mathrm{future}}{i}$,并通过轻量级回归头输出对未来的潜表征预测 $\hat{\mathbf{y}}{t+i}$。训练阶段结合余弦相似度损失与动作生成损失联合优化:
\[\mathcal{L}_{\mathrm{future}} = \frac{\sum_{i=1}^{H} m_{i} \left[1 - \cos\left(\hat{\mathbf{y}}_{t+i}, \mathbf{y}_{t+i}\right)\right]}{\sum_{i=1}^{H} m_{i}}\] \[\mathcal{L} = \mathcal{L}_{\mathrm{act}} + \lambda_{\mathrm{future}} \mathcal{L}_{\mathrm{future}}\]这种辅助任务迫使主干网络在微调过程中建立对环境演进速度与方向的内在表征,而推理阶段直接丢弃预测头,完全不增加任何额外的推理开销。
2. 主干内多帧时序融合(Multi-Frame Temporal Fusion)
为了捕获速度信息,多帧图像是必不可少的。若直接将 $T$ 帧、$V$ 个视角的视觉 Token 拍扁送入语言模型,将引入 $V \times T \times P$ 个 Token,使语言模型注意力机制的显存与计算负荷成平方级剧增。
ReflexVLA 选择将时序整合下放至视觉编码器阶段。在 ViT 骨干网络的中间层,特征通过轻量降维投影与一维因果多头注意力机制,在通道维度提取帧间的位移动态量 $\Delta\mathbf{x}_{v,p,t}$,并以残差方式注入最终视觉表征中:
\[\tilde{\mathbf{x}}_{v,p,t} = \mathbf{x}^{\mathrm{final}}_{v,p,t} + \Delta\mathbf{x}_{v,p,t}\]经过此融合后,最终输送给语言骨干网络的视觉 Token 数量被严格压制在单帧规模(即 $V \times P$ 个),彻底抹平了多帧引入给语言模型带来的延迟隐患,使模型在掌握短周期运动速度的同时保持轻快。
3. 部署期软硬件延迟极限压榨
在算法层之外,ReflexVLA 对推理系统的工程细节进行了端到端梳理:
-
批处理视觉编码(Batched Visual Encoding):打破多视角与多帧图像逐张过网络的串行逻辑,将历史帧和各相机视角图像打包重排为大批次单次过图,最大化利用 GPU 显卡张量核心(Tensor Core)的并行吞吐。
-
CUDA Graph 重放技术:在 PyTorch 的默认调用中,CPU 向 GPU 频繁发射内核函数(Kernel Launch)所带来的系统调用开销占据了极高的耗时比例。ReflexVLA 将固定计算图提前捕获并持久化在 GPU 显存内,推理时仅需单次触发即可完成整网流水线计算,彻底消除了内核启动碎片。
实验印证:毫秒必争的真实增益
为了验证系统在真实延迟对抗下的表现,实验在配备单张 NVIDIA RTX 5880 Ada GPU 的设备上展开测试。
在 ReflexBench 的消融实验中,纯粹依赖基础骨干的基线方案在动态任务中的成功率仅为较为有限的水平。当逐项加入组件后,算法展现出层层递进的性能跃迁:
-
引入主干内时序融合后,由于机械臂获得了推断目标移动速度的能力,任务成功率显著提高;
-
加入潜在未来预测后,模型展现出提前预判目标轨迹的拦截能力,成功率进一步上扬;
-
最终注入系统级延迟优化(批处理编码 + CUDA Graph),由于整机端到端耗时直接从 $125.1\text{ ms}$ 腰斩至 $65.0\text{ ms}$,策略的动作时延断层被大幅修补,动态操作总成功率一跃升至 $73.8\%$。这一跃升直接证明了系统工程优化在机器人动态闭环中并非锦上添花的边角料,而是决定策略生死的核心支柱。
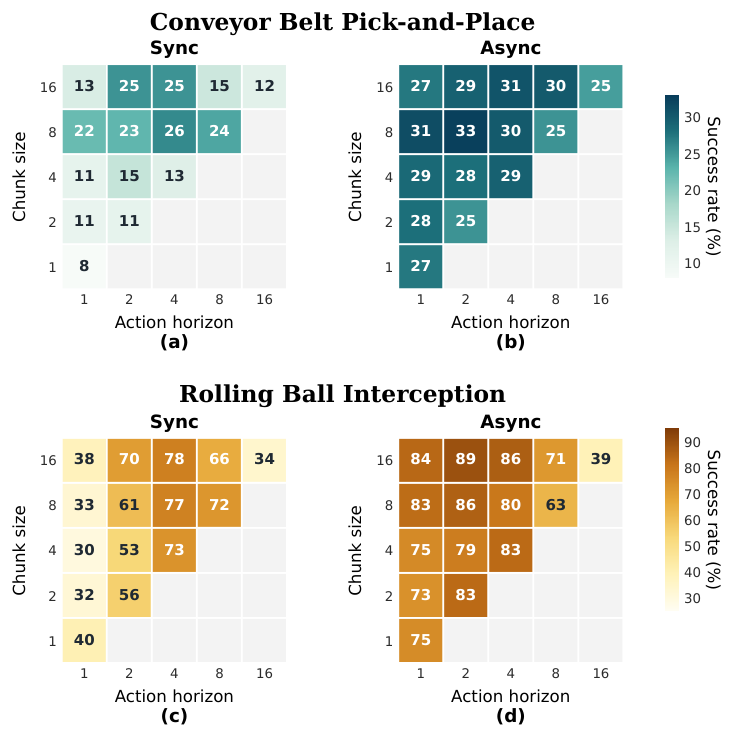
图 4 的深入分析进一步指出了动作块大小(Chunk Size)与推理频率的博弈关系。在完全没有考虑时间延迟的理想仿真中,过长的 Chunk 往往因为开环误差而导致精度衰退;但在真实物理世界中,由于计算耗时天然存在,若 Chunk 设置过短,异步队列中的旧动作执行完毕而新动作尚在计算,机械臂就会出现顿挫卡死。只有兼备极低计算延迟与精准时序前瞻的模型,才能在异步执行中将成功率稳稳维持在峰值。
而在广泛用于考察通用能力的静态操作基准 LIBERO 上,ReflexVLA 并未因专注动态场景而牺牲基础理解力,取得了高达 $97.2\%$ 的平均成功率,与动辄百亿参数的头部 VLA 模型旗鼓相当,证明了轻量结构配合高效时序调制在处理静态任务时依然具备优异的鲁棒泛化能力。
走向实机:抓取小球与流水线拦截
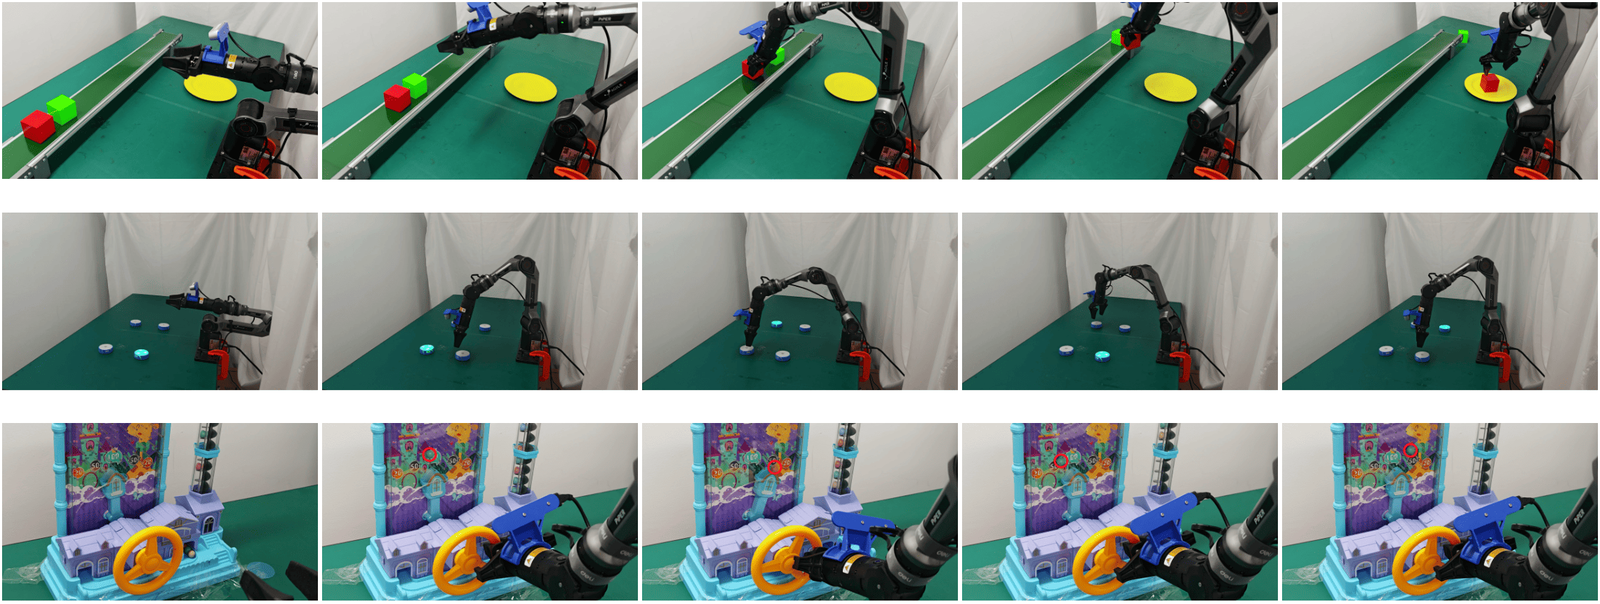
真实物理实验在三种典型的反应敏感工况下展开:传送带移动物体抓取(Conveyor Belt)、动态连击按键(PressButtons)以及下落与飞来小球的动态拦截(CatchBalls)。
在这些极端考验控制闭环的任务中,轻量级同类模型 SmolVLA 由于缺乏动作预判和系统优化,经常在末端执行器抵达目标点时物体已经滑过,抓取率严重受挫。而参数体量庞大数倍的模型如 PUMA,受制于自身的计算庞大和多帧 Token 开销,计算滞后严重。只有 ReflexVLA 在极低硬件开销下,既看清了运动速度,又赶在目标逃逸之前完成了指令下发与电机响应,在 20 轮连续实机测试中展现出了媲美人类本能反应的敏捷抓取轨迹。
总结与展望
Reflex 这项工作的价值在于,它跳出了单纯堆砌模型尺寸和互联网预训练规模的单一范式,将具身智能的核心焦点拉回到了最本质的物理规律——控制必须与时间赛跑。通过 ReflexBench 的时间解耦机制,学界得以正视仿真与真实世界之间因计算滞后而产生的断层;而 ReflexVLA 则证明了,即使不依赖海量机器人预训练数据,通过紧凑的主干架构、巧妙的潜在前瞻预测和底层的算子优化,也能在不足 1B 参数的轻量体系下实现高精度的动态物理拦截。
这一成果为后续具身大模型的边缘侧部署提供了非常务实的落地样板。未来的改进空间依然广阔,例如将未来预测机制进一步下沉至大规模无监督预训练阶段,或是融合更为先进的实时纠偏流式控制协议,让未来的机器人真正长出一套兼具高级常识与闪电反射的“运动神经元”。