OmniReasoner:教全模态模型定向重听重看,长视频推理提升9.9分
OmniReasoner: Thinking with Long Audio-Video via Native Tool Use
在处理长达几十分钟甚至数小时的音视频内容时,现有的大型多模态模型正陷入一种两难困境。一方面,长视频中的决定性线索往往极其稀疏,可能只是某个人一闪而过的动作、一句轻声的呢喃,或是某种声音与画面的瞬间偶合;另一方面,如果为了不错过任何细节而全程保持高采样率输入,视觉图像与连续音频 Token 叠加带来的上下文膨胀和计算开销是任何现有架构都难以承受的。
ArXiv URL:https://arxiv.org/abs/2607.19339v1
普遍采用的折中策略是均匀降采样(Uniform Downsampling)。然而,把一个长视频稀释成几十张关键帧和粗粒度音频后,模型看似获得了全局视野,实际上那些决定最终答案的微小线索早已在降采样中被过滤殆尽。
人类在理解长音视频时并不会以固定帧率“通读全文”。面对一部电影或一场会议记录,我们通常先快速浏览整体脉络,遇到可疑或关键节点时,再主动将进度条拖回去,仔细重看某几秒的画面或辨听声音。
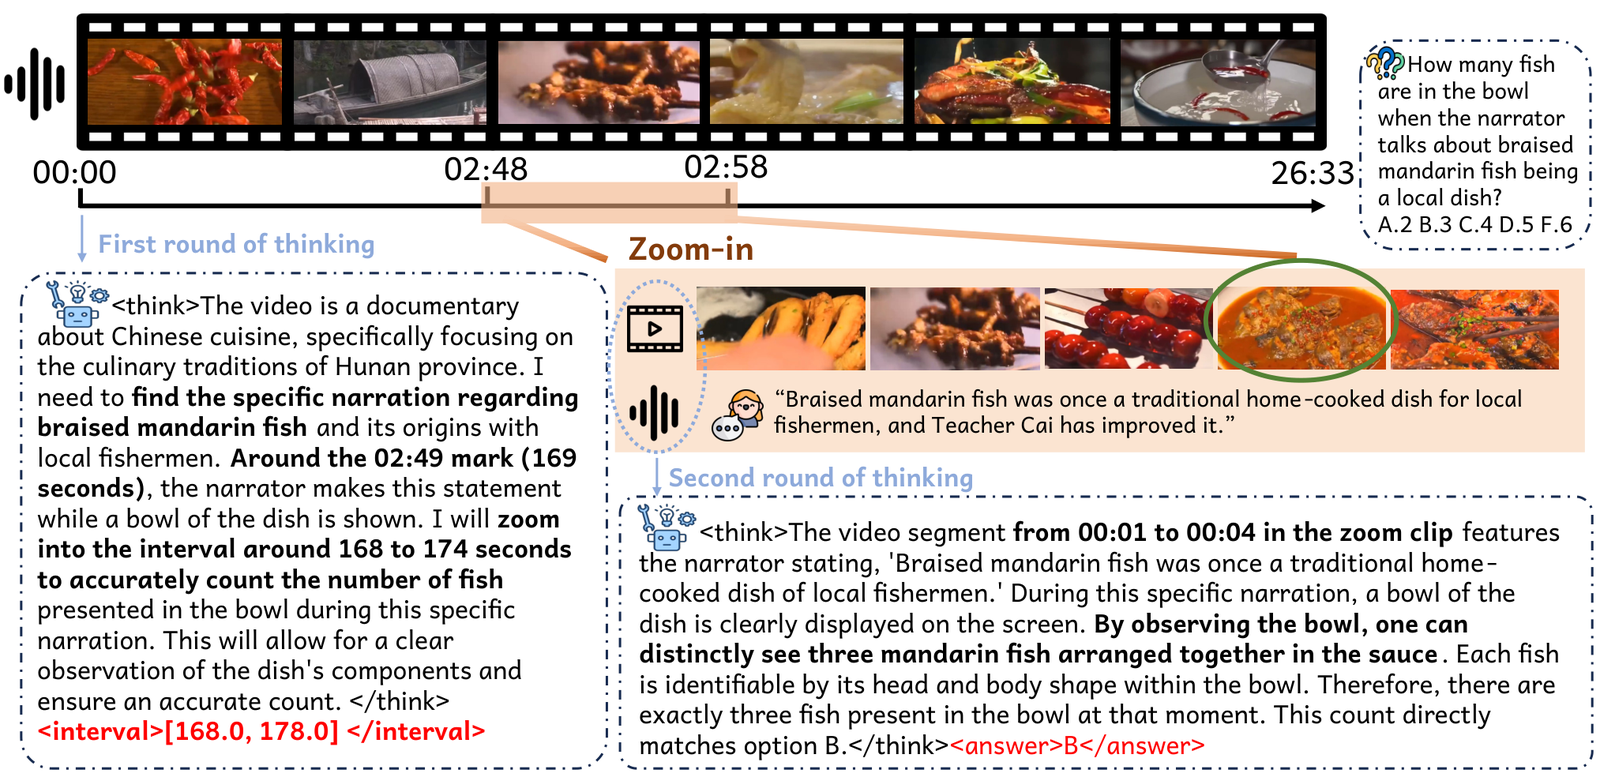
来自清华大学、中国科学院、Shopee、北京工业大学和东南大学等机构的研究团队,将这种认知直觉转化为一种原生的后训练框架,提出了 OmniReasoner。该工作不再执着于通过无限扩展上下文窗口去强行“硬吞”全部音视频信号,而是通过监督微调(SFT)与强化学习(RL),让全模态大模型(Omni-LLMs)学会自主决定:面对当前问题,究竟是直接作答,还是主动调用局部的“放大重检”(Zoom-in)工具;如果需要调用,又该精确框定哪一段音视频区间。
为什么长音视频的工具调用远比纯视觉复杂?
在长视频领域,让模型调用搜索工具检索关键帧已不是全新概念,但这些探索绝大部分局限在纯视觉信号上。当模态扩展到全模态(视觉加音频)时,问题从底层表示上就发生了质变。
首要难题是多粒度采样下的时序基准漂移。在一个两阶段的工具交互系统中,模型首先面对的是低采样率的全局预览流(Global Preview),以便以极低的 Token 成本建立时间轴线索;一旦决定发起缩放调用,系统会动态加载该区间高帧率、高保真度的局部音视频剪辑(Local Clip)。
在传统的全模态模型(如 Qwen-Omni)中,时序信息往往是隐式的。例如将音视频流切成固定长度的块(Chunk),视频 Token 在前,音频 Token 在后。这种组织方式在单次均匀输入时可以正常工作,但在调用局部工具后立刻会彻底失效:全局粗略视图下的第 10 个视频块,在高保真剪辑中根本不对应第 10 个块;更严重的是,连续的音频流没有离散的“帧”概念,视频帧索引与音频采样时间戳无法直接映射。如果工具传递的参数是基于特定采样网格计算的相对帧编号,经过“全局到局部”的粒度切换,模型所请求的时刻就会发生偏移,无法定位到正确位置。
其次是训练数据的获取瓶颈。要让模型学会“什么时候该调工具、调哪一段、拿到证据后如何结合全局推理”,需要大量的全模态长程轨迹监督数据。直接让人类标注者给长音视频打上精细的起止区间和推理过程,成本极高;而单纯依赖现有多模态模型去伪造问答,又极易在长音视频中产生跨模态幻觉。
最后是交互策略的强化学习瓶颈。现有的 RL 框架(如 veRL、OpenRLHF 等)多针对纯文本或图文多模态任务设计,并不原生支持音频条件输入以及多轮动态音视频流的工具交互。如何让模型在没有“作弊式”启发奖励的前提下,自主收敛出理性的证据检索习惯,是另一个工程与算法层面的挑战。
OmniReasoner 的核心机制:双阶段推理与 TimeAnchor
OmniReasoner 的整体推理流遵循简洁的决策回路:全局快速扫描,局部按需细查。
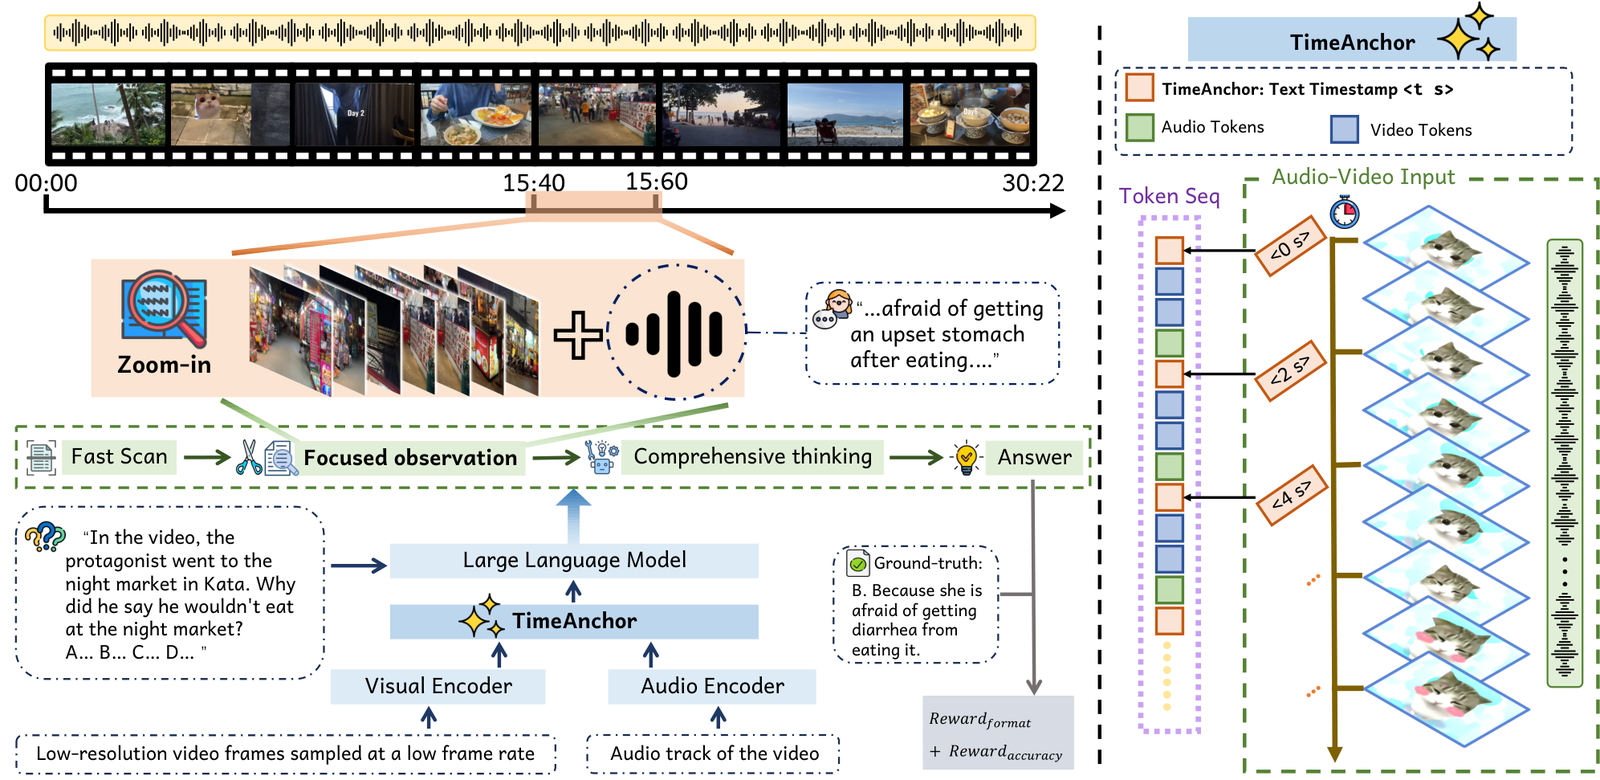
如上图左侧所示,模型输入由全局流抽取的低帧率图像帧与完整全长音频构成。视觉编码器和音频编码器分别对输入编码后,输入策略网络 $\pi_\theta$。此时,模型结合用户提问 $q$ 与全局感知 $g$,在策略空间内进行第一阶段决策 $a_1$:
\[a_1 \sim \pi_\theta(\cdot \mid g, q), \quad a_1 \in \{\operatorname{answer}(y), \operatorname{zoom}([s, e])\}\]如果全局特征已足以回答(如宏观风格、常识性长时事件),模型可以直接输出最终答案 $\operatorname{answer}(y)$;若证据不足,模型则生成一段调用指令,指明需要放大的起止区间 $[s, e]$。系统在底层截取对应区间的未降采样高保真音频与密采样视频片段 $z_{s:e} = \Phi_{\mathrm{local}}(x, [s, e])$,将其拼接注入上下文,模型最终基于全局背景、用户问题和局部证据给出综合解答:
\[y \sim \pi_\theta(\cdot \mid g, q, z_{s:e})\]这一机制看似直观,但其能够稳定运作的关键支撑,在于本文提出的 TimeAnchor(时间锚点)机制。
为了彻底摆脱特定采样率带来的帧索引依赖,研究团队从 ffmpeg 等成熟多媒体流处理系统基于绝对时间(Absolute Time)对齐音视频的逻辑中汲取灵感。在全模态 Token 序列构建阶段,OmniReasoner 将连续的媒体流切分为以 2 秒为单位的绝对时间分块,并在每个分块最前端插入一个无格式的自然文本时间标记(例如 <t seconds>)。
这一改进极其轻量:它不需要引入任何新的特殊 Token,无需修改模型底层架构,也不需要增设单独的时序定位损失函数。每个锚点本质上都是普通分词器识别出的普通文本词元。
正是这一设计,使得时间标记成为一个与采样率解耦的绝对物理标尺。无论模型在第一阶段看到的是稀疏降采样的全局预览,还是在第二阶段看到的高清局部剪辑,甚至是连续的背景音频,所有模态和交互阶段均指向统一的时间基准。模型发出的 zoom([32, 38]) 指令,能够精准映射到物理视频的第 32 至 38 秒,实现了跨采样粒度的双向一致性。
解决轨迹合成:时序增强数据引擎
针对工具调用轨迹数据稀缺的问题,研究团队开发了一套时序增强数据引擎(Temporal Augmented Data Engine),通过对现有音视频资源进行程序化的时序编辑与合成,规模化生成监督数据。
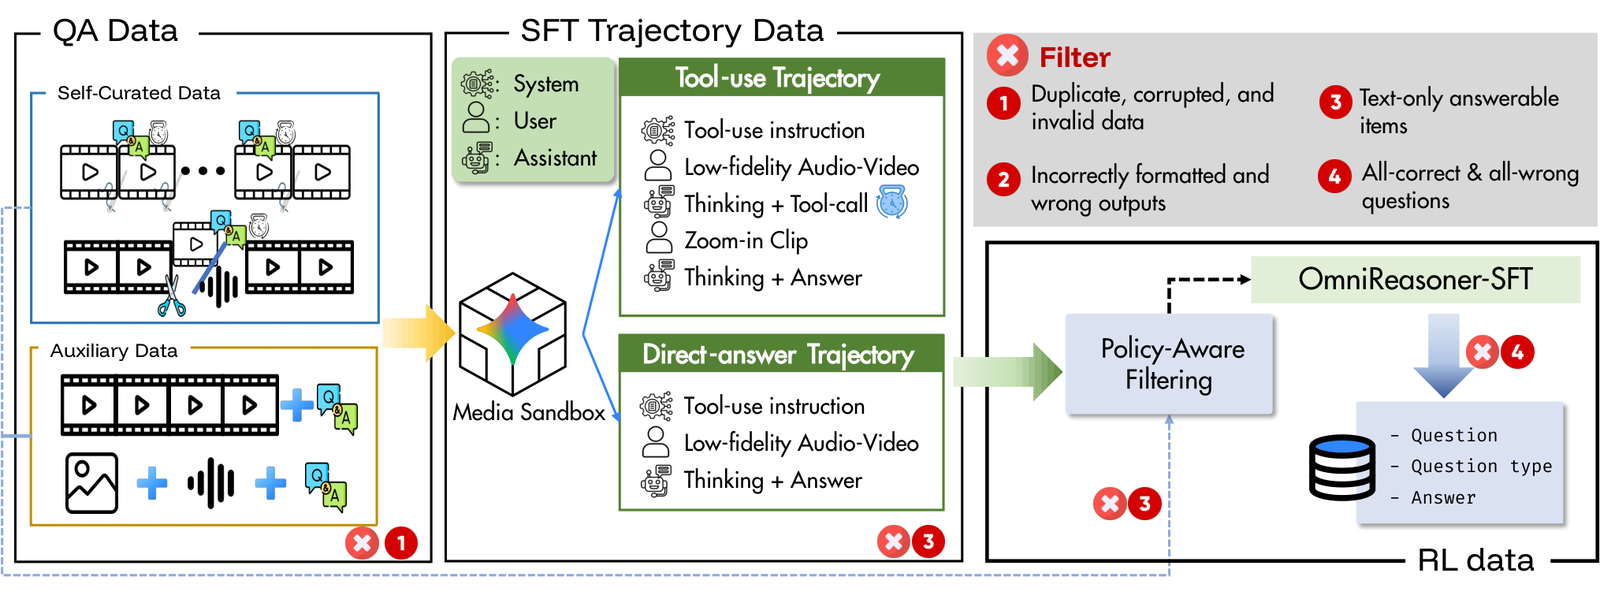
该引擎的核心思想在于:与其在无标注的自然长视频中盲目猜测关键线索,不如通过人工构建可控的时序扰动,让关键证据出现的区间“在生成时即自证准确”。
数据引擎主要通过以下两种方式合成问答对与工具调用轨迹:
-
时序替换与拼接:将一个关键音视频微动作或特定事件,嵌入到一段毫不相干或节奏平缓的背景音视频中,构造出具有明确线索起止时间的合成复合视频;
-
跨模态一致性挖掘:利用音画强对齐的视频片段(如乐器演奏、特定物体发声、特定解说词对应特定画面),自动提取音画互证的区间作为 Ground Truth。
在此基础上,系统自动生成包含“思考过程、工具调用参数、工具返回内容注入、最终归纳回答”的完整推理轨迹。这套流程不仅提供了精确的 $[s, e]$ 区间真值,还自然教会了模型:何时线索已经明确因此无需调用工具,何时线索模糊必须发起缩放。
在监督微调(SFT)奠定了基础的工具调用语法格式后,团队进一步引入了面向智能体的强化学习(Agentic RL)。值得注意的是,OmniReasoner 在设计强化学习奖励函数时,没有给“调用工具”本身设置任何启发式奖励。如果模型一调用工具就能得分,它就会退化为无意义地盲目调用;如果惩罚调用,模型又会趋于保守。团队仅保留了格式奖励与最终答案的准确性奖励,让策略模型在探索中真正感知到:只有在确实缺少信息且唯有细查才能答对时,调用 Zoom-in 才是提升期望回报的唯一路径。
实验评测:不仅是准确率提升,更在长时段显现价值
研究团队以 Qwen-Omni-7B 为底模,在多个主流音视频基准以及通用长视频理解评测集上进行了全面验证。实验结果表明,后训练赋予模型的不仅是工具使用形式,更是实质性的推理与定位能力飞跃。
在涵盖多类跨模态复杂推理的基准测试中,OmniReasoner 全面超越了基盘模型:
-
在 OmniVideoBench 上,得分从基线的 29.3 跃升至 34.8;
-
在极具挑战的长全模态评测 LVOmniBench 上,从 32.0 提升到 35.4;
-
在专注于细粒度时序侦探式推理的 VideoHolmes 上,基线模型因仅能输入 32 帧而受限于信息遗失,仅得 24.4 分,而 OmniReasoner 凭借定向调用高清片段,直接飙升至 40.0 分;
-
在通用长视频理解标准基准 VideoMME 上,同样从 64.3 稳步提升至 65.4。
更值得关注的是模型性能随着视频时长延展而呈现的变化趋势。在 OmniVideoBench 上的细分统计显示:
-
在 0–5 分钟 的较短视频中,OmniReasoner 相比基线的提升幅度为 3.2 分;
-
在 5–10 分钟 的中等长度视频中,增益扩大到 6.6 分;
-
在 10–30 分钟 的超长视频中,性能提升幅度达到了 9.9 分。
这种“视频越长、增益越显著”的梯度表现,印证了自适应缩放机制的设计初衷:当输入足够短时,全局统一采样丢失的信息有限;但当输入拉长至数十分钟,均匀采样必定会导致关键帧丢失,此时依赖全局粗扫初筛线索、再通过局部放大找回高保真证据的机制,成为了弥补长程信息衰减的最优解。
这一现象在模型的实际行为分布中也得到了印证。分析表明,在 0–1 分钟的极短视频中,模型调用工具的概率仅有 33.3%,大部分简单问题被直接解答;而在 10–30 分钟的视频中,工具调用率迅速上升到 84.8%;在 LVOmniBench 50–90 分钟的超长视频区间,工具调用率更是达到了 93.6%。模型在经历强化学习后,自发习得了根据输入信息熵高低动态分配计算资源的策略。
关键消融:局部片段究竟是真实参与推理,还是装饰品?
针对多模态推理模型,学界近期存在一种合理质疑:思维链(CoT)或交错插入的局部图像,到底有没有在因果层面被语言模型真正使用?抑或只是模型在自言自语,最终仍凭全局残留记忆作答?
论文通过两项严格的消融实验打破了这一疑虑。
首先是推理期干预实验(Intervention Study)。如果在模型决定调用工具并获得返回后,系统恶意将工具返回的高保真剪辑剥离,只保留调用动作,模型的回答准确率会出现剧烈坍塌。这证明后续的回答生成强依赖于返回的局域信息。
其次是基于 Attention Rollout 的内部注意力机制归因分析。研究人员收集了第二阶段模型生成完整思维链和最终答案时、对输入端所有 Token 的因果注意力权重,并将这些权重投影回原始时间轴。分析显示,模型在第二阶段生成思考与答案时,注意力高度集中在工具刚返回的那段局部音视频剪辑对应的 Token 上,而在第一阶段全局粗略流上的注意力被大幅稀释。这在机理上证实了:OmniReasoner 确实将高分辨率片段视作决策的决定性证据。
此外,在对 TimeAnchor 的消融评测中,针对纯时序定位基准 Charades-STA 的测试显示,引入 TimeAnchor 让模型在 IoU@0.3 上的定位表现从 58.8 提升至 64.9,mIoU 从 37.9 提升至 41.3。这表明为不同采样率赋予绝对物理时间坐标,对于模型在跨分辨率之间完成时序对齐起到了不可替代的稳定作用。
局限性与延伸思考
OmniReasoner 为全模态长程推理提供了一条高计算性价比的路径,但作者也在文中坦诚剖析了当前探索的现实边界。
最首要的局限来自基础工程环境。当前的系统本质上是一个两阶段(Two-step)的单一交互流程,未能实现真正多轮、渐进式的多步深度检索(Multi-turn Re-inspection)。限制这一演进的核心瓶颈,是针对全模态(视觉+音频)的 Agentic RL 基础设施在开源界几乎处于空白状态。主流强化学习框架均无法原生处理音频流与多模态交错工具返回,团队基于 TRL 自行搭建的实验框架虽能支撑单步调用训练,但在多轮长程轨迹下的显存管理与采样吞吐仍面临工程挑战。
其次是工具谱系的广度。目前 OmniReasoner 的工具库中仅集成了一个单一的“感知放大镜”(Zoom-in),专注于解决“看不清、听不清”的内部感知问题。如果在真实世界中处理复杂的音视频长任务,模型往往还需要联合调用外部工具,例如通过网页搜索核实视频中提及的冷门历史背景,或利用代码执行器对视频中的数据图表做定量运算。如何将内部感知工具与外部通用 Agent 工具统一进同一个后训练框架,仍是留给社区的开放命题。
从长远来看,OmniReasoner 的启示在于:解决长上下文和高分辨率的多模态难题,未必只有“堆叠上下文长度”这一条路。教模型认知自身的信息边界,学会在何时、何地借助明确的物理时间基准发起精准回溯,或许是构建实用型全模态通用智能体更为高效、也更符合物理世界规律的演进方向。