从“听完再想”到边听边想:不改模型权重让延迟降49%,完成率达73%
Never Stop Thinking: Continuous-Time Language Agents
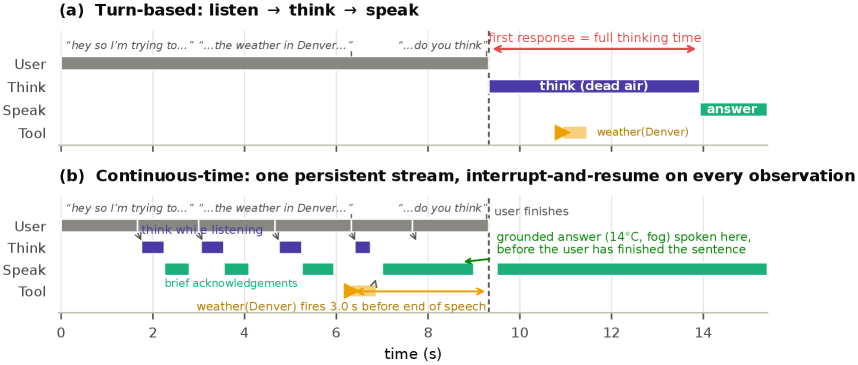
在人与人的日常交谈中,交流几乎是持续流动且交织重叠的。我们往往在对方话音未落时就已经开始在大脑中构建回应,在开口陈述当前句子的同时构思下一句表达,即使中途被打断也能迅速吸收新信息并调整思路。然而,当下绝大多数基于大语言模型(LLM)构建的语音智能体(Voice Agents)却表现得格外机械:它们严格遵循着“听完语音输入 $\to$ 沉默思考 $\to$ 开口输出语音”的离散轮替循环。这种结构性设计在每一次用户停顿后都会制造出长达数秒的社交尴尬式死寂,并且完全丧失了处理真实交互动态的能力——无论是用户中途插话(barge-in)、工具异步返回结果,还是在面对复杂多步骤问题时“边说边算”的缓冲诉求。
ArXiv URL:https://arxiv.org/abs/2609.17416
为了打破这种卡顿感,工业界近来倾向于设计全新的端到端全双工语音模型或多模态原生架构。然而,来自 Pine AI 与华盛顿大学(University of Washington)的联合研究团队在论文《Never Stop Thinking: Continuous-Time Language Agents》中给出了一个更具工程美感且反直觉的答案:无需改动任何模型权重、词表(Tokenizer)或对话模板,仅凭一个轻量级的编排调度层,现成的大语言模型就能激发出“连续时间认知”(Continuous-Time Cognition)能力——做到边听边想、边说边想。
该方案在真实端到端语音流水线中将整体延迟降低了 19%,在提前命名实体的典型场景中更是将端到端延迟直接砍掉近半(49%)。但这项研究最具启发性的贡献,远不止于写出了一套约 200 行代码的调度器,而是揭开了交互式 Agent 评测与训练中的重大陷阱:当使用大模型作为裁判(LLM-as-a-Judge)时,所谓的“连续思考优势”竟然完全是一场评估幻觉;经过裁判偏好微调的模型,在客观任务上的表现甚至“越想越差”。为此,团队构建了包含客观可验证检查清单的评测基准 ReactiveBench,并通过严密的五阶段训练实验证明:仅有编排器只能让连续交互成为可能,只有基于可验证信号、经过任务形态自适应塑造并在策略强化学习(On-Policy RL)的驱动下,才能真正让智能体的流式任务完成率从 48% 跃升至 $73 \pm 5\%$。
偷来的算力:200 行代码如何让未修改模型“边听边想”
实现连续时间认知的核心物理基础,在于人类说话速率与大模型推理速度之间的巨大时间错配。人类正常语速大约是每秒 3 个单词,而现代推理引擎在 GPU 上的解码速度能够轻松达到数十乃至上百个 Token。这意味着在用户开口说话的几秒钟,以及文本转语音(TTS)引擎发声播放的间隙里,计算硬件上存在着大量未被利用的“免费推理时间”。
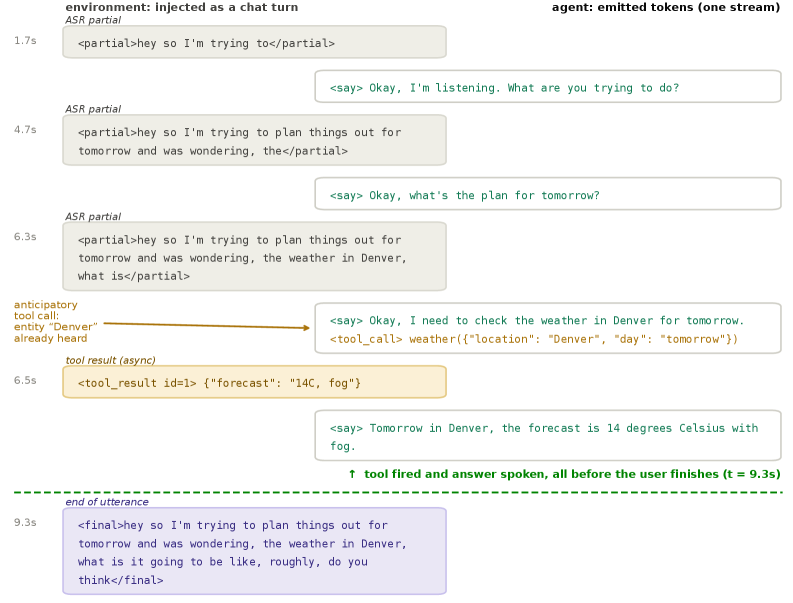
研究团队没有重训一个原生支持音频流的复杂多模态大模型,而是设计了一个“中断-恢复”(Interrupt-and-Resume)原语。在连续时间状态下,智能体维持着一条永不停歇的自回归生成流,环境中的观察信号则以离散事件的形式稀疏注入。这些事件来源包括四类:语音识别(ASR)在用户说话过程中持续抛出的流式片断、TTS 播报即将结束前的超时提醒、异步外部工具返回的查询结果,以及用户随时可能发生的打断。
每当新的事件到达时,编排器会立即执行一个极其干脆的操作:强制闭合模型当前未完成的思维块标签 </think>,将新观察作为新的对话轮次注入上下文,随后立刻恢复自回归解码。
以上图展示的查询丹佛天气为例,当用户刚说出“hey so I’m trying to plan things out for tomorrow and was wondering, the weather in Denver…”(后半句还在絮絮叨叨补充细节),流式 ASR 一旦捕捉到实体“Denver”,编排器立刻注入该片断。模型在思考流中瞬时调用 weather(Denver) 工具;在用户整句话彻底说完的前 3 秒,模型就已经完成了工具检索并准备好了答案。当用户语毕的瞬间,智能体几乎零延迟地播报出“丹佛气温 14°C,大雾”。整个过程中,基础模型完全是开箱即用的 Qwen3 或 DeepSeek-R1,没有对模型权重做任何侵入式修改。
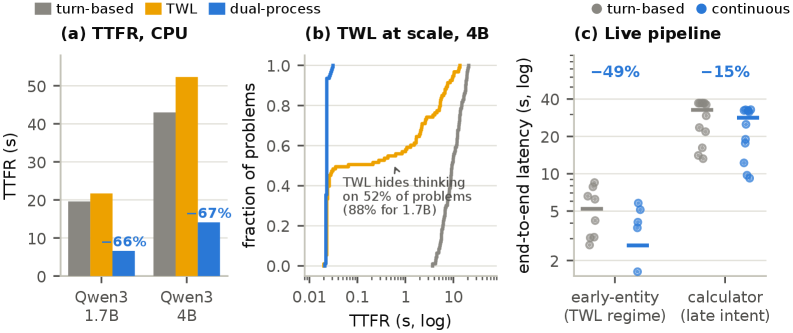
在不同硬件和任务上的测试显示,这种机制带来了显著的物理延迟红利。对于快慢双进程策略(Dual-process Fast/Slow Policy)——即在后台深度思考(System 2)的同时,前台立刻启动快速响应通道(System 1)输出占位确认或承接语——首字响应时间(TTFR)在各尺寸模型上统一减少了约三分之二。而在真实的多模块语音链路(流式 Whisper ASR $\to$ Qwen3-8B $\to$ 流式 TTS)中,对提前暴露意图实体的任务,延迟从原本的数秒腰斩了 49%,整体平均端到端延迟降低了 19%。
评测照妖镜:LLM 裁判带来的致命幻觉
然而,交互速度变快并不等同于任务完成得更好。智能体在被频繁中断、边听边想的状态下,其回答的质量和任务成功率到底有没有提升?
当研究团队首先采用目前业界最普遍的评估方式——使用专有大模型作为裁判,按照交互自然度、逻辑合理性等维度打分时,结果呈现出一面倒的大胜:基础模型及其微调变体在连续时间模式下的得分全面超越传统的轮替模式,平均提升最高达到 8.4%。
但随后的对照实验却给这种“全面胜利”泼了一盆冷水。团队引入了另一个完全独立的大模型家族作为裁判对相同的交互转录文本进行重测,令人震惊的现象发生了:在主裁判下看似一致的“质量优势”,在独立裁判下全线逆转为负分;两个裁判对 7 个模型的综合排名相关系数仅为极低的 Spearman $\rho = 0.07$。
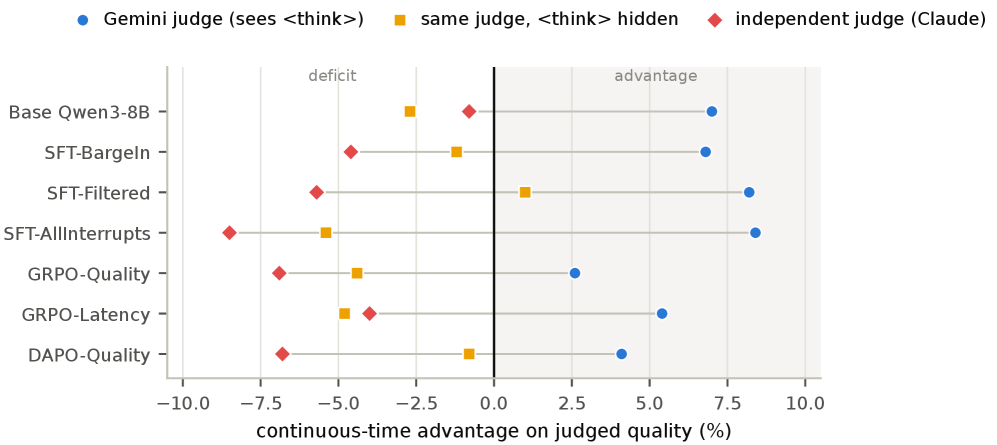
更为致命的对比在于:当研究人员把转录文本中的 <think> 思维链内容全部剥离,仅保留最终说给用户听的真实发音文本再送给原裁判打分时,原本高达数个百分点的连续时间优势在 6 个模型上瞬间蒸发殆尽。
这一现象暴露出目前 Agent 评测领域的重大弊病:LLM 裁判极度偏好那些能够被视觉感知的推理过程以及自己熟悉的文字腔调。智能体展示出了长篇累牍的思维链,裁判便主观判定它“深思熟虑、回答极佳”,而完全忽略了终端用户耳朵里实际听到的语音内容。
为了建立具备坚实复现性的黄金标准,团队推出了专门评测流式交互能力的全新基准 ReactiveBench。该基准分为两个互补的赛道:
-
交互赛道(Track A):包含 120 个多轮人机交互复杂场景(包括访谈、头脑风暴、博弈谈判以及严苛的打断与角色切换压力测试),采用针对最终说出文本预先注册的 688 项二元检查清单(Checklist)进行核验。这些核验规则是在完全看不到任何模型输出的前提下编写的,验证者间的一致性达到了 Cohen’s $\kappa = 0.75$ 的极高水准。
-
可验证流式赛道(Track B):包含 200 项流式推理与工具调用任务,涵盖 GSM8K 数学多步推导、SQuAD、HotpotQA 多跳检索以及特定的计算器与早实体任务。该赛道直接以绝对正确率作为评判指标,并记录“工具提前触发时间(Tool-lead)”和“语音覆盖率(Speech Coverage)”等行为指标。
信号源之误:为什么用裁判微调的模型反而“不会说话”?
通过客观严谨的 ReactiveBench,研究人员进一步对经过传统大模型裁判偏好训练(如常见的判别器奖励打分)的模型进行了体检。结果发现了更为严重的负迁移现象。
在经历过 LLM 裁判奖励训练后,模型确实蒸馏出了一种极其紧凑的思考模式:从原本冗长、连绵数百词的单一大思考块,演变为了平均每块仅 36 词左右的高频微思考片段,单次交互所消耗的思考 Token 数量缩减了 5 到 6 倍。表面上看,模型变得极其敏捷干练。
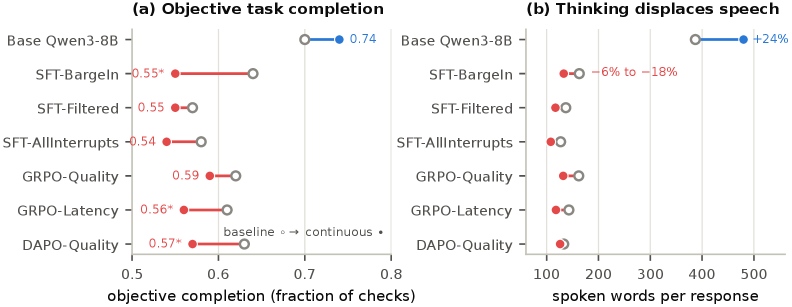
但将其放入客观检查清单测试中时,真相令人不寒而栗:未经过任何微调的原始基座模型,在开启连续思考后客观完成率微幅提升;而所有经过裁判微调的模型,其客观任务完成率全部出现了明显滑坡,且在连续时间模式下的完成度全面逊于传统的轮替模式。
这一崩塌背后的机制在统计分析中浮出水面:经过裁判奖励驱动的模型,为了迎合裁判对“言简意赅、无废话”的偏好,在连续交互时发生了严重的“思考吞噬表达”(Thinking displaces speech)现象。基座模型在连续模式下说出的话语量其实增加了 24%,它能够耐心地将推导出的要点完整陈述给用户;而裁判训练模型在连续模式下,实际说出的有效词数锐减了 6% 到 18%。智能体把本该说出给用户听的核心事实、推导步骤,直接“暗自消化”在了私有的思维链内部,最终呈现给用户的口头内容大幅缩水。
这一发现为交互智能体训练确立了第一层铁律:决定思考是有益还是有害的关键,首先在于训练信号的源头(Source)。 必须摒弃主观的主观评委打分,将对齐目标锚定在最终口头输出的“可验证客观事实覆盖率”上。
团队随后开发了“保留覆盖率的有监督微调”(Coverage-Preserving SFT)与针对口头内容的无思维链可验证强化学习(RLVR),强行灌输给模型一条准则:思考过程可以极度短小,但听众听不见你的思维链,必须在语音中完整吐出所有关键要点。该阶段成功消除了口头内容的损耗,在维持高效思考模式的同时,将二元检查清单的客观完成率推向了基座模型未曾达到的高位。
结构与优化器:奖励漏掉什么,算法就会毁掉什么
解决了信号的源头问题后,挑战来到了更深层次的推理与工具链交互任务中(ReactiveBench Track B)。在流式输入环境下,连续时间智能体面临着更加微妙的动态决策:什么时候该抢先调用工具?什么时候该按兵不动等待后半句的条件?面对复杂问题时,模型该精炼还是该展开详述?
研究团队在此展示了一个充满警示意味的训练反例:当他们在第二阶段引入整条轨迹级别的拒采样微调(Rejection Fine-Tuning)并对生成长度设置了统一的精炼门控惩罚时,模型在一系列任务上的表现确实大幅提升,但在 HotpotQA 这类需要多步跳跃查询(Multi-hop QA)的任务上,准确率却直接雪崩。
背后的逻辑极其冰冷:奖励函数中漏掉什么,优化算法就会毫不留情地牺牲什么。 多跳工具调用在本质上就是需要模型进行充分探索、多次回环展开的,它在行为模式上与“简洁、短小”完全对立。统一施加的精炼惩罚,无意间把模型最宝贵的多步深度探索能力当成废料剪除掉了。而在早实体任务中,由于拒绝采样门控未对“提前多久调工具”做出显式奖励定价,模型的提前触发时机在多轮迭代后完全随机漂移。
要驯服这一复杂的动态系统,研究团队在信号的结构(Structure)与优化器(Optimizer)两个维度给出了终极解法:
在奖励结构层面,构建按任务类型自适应塑造的可验证奖励(Type-Conditional Verifiable Reward)。全局基准线强制保证最终答案的硬正确性;但在需要多跳推理的场景中,奖励偏向完整探索;在早实体任务中,显式对提前触发工具(Tool-lead)的时间差给予积分奖励;在单选题等需要等待完整条件的任务中,奖励抑制过早下注的克制行为;仅在无关痛痒的环节释放对精炼的奖励。
而在优化算法层面,传统的成对偏好优化(如 DPO)在面对这种充满张力的多目标优化时表现出了理论局限。DPO 的单标量对比机制无法在多目标交织的流式状态下权衡“此处需详尽、彼处需精简”的精细调度,往往只能拆东墙补西墙。团队最终采用了在线组相对策略优化(Online GRPO),配合动态零方差采样(DAPO)与严密的 KL 散度锚定,使策略模型在流式环境模拟器中直接与自适应标量奖励进行对抗学习。
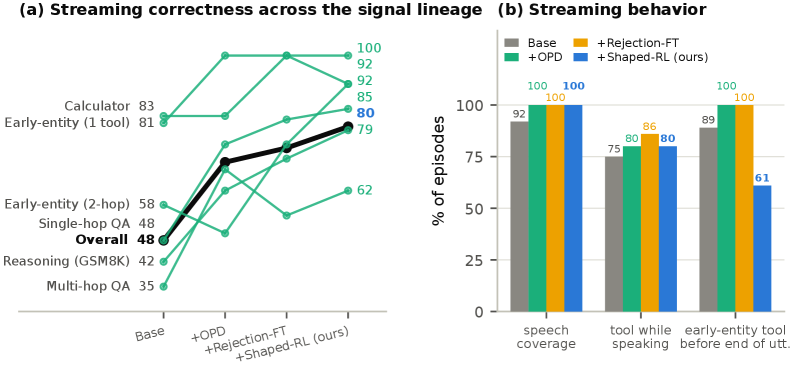
这一完整的训练链条最终带来了坚实的性能蜕变。在可验证流式赛道中,从未训练的基础模型、在策略蒸馏(OPD)、拒绝采样微调,到最终的自适应奖励强化学习(Shaped-RL),模型端到端流式任务完成率呈现出近乎单调的爬升,最终在多随机种子测试下稳定落在 $73 \pm 5\%$,相较原始状态的 48% 实现了质的突破。
行为学指标的同步监控更证实了这种强化的健康度:语音覆盖率稳定保持在 100%,彻底根除了“思考挤占发音”的毛病;在 61% 的早实体测试案例中,智能体均在用户整句话说完前成功激活外部工具,平均提前抢跑时间长达 3 秒;一旦在消融实验中把提前触发的奖励项剥离,该行为立即在优化过程中退化崩塌至 21%,再次验证了“奖励结构决定存留技能”的判定。
迈向全双工交互的理性路径
长期以来,学术界与工业界在追求下一代语音智能体时,往往受困于一种非此即彼的观念分歧:要么死守在延迟感人、体验僵硬的串行级联架构上缝缝补补;要么押注极度消耗训练算力、难以调试黑盒状态的原生端到端音频大模型。
Pine AI 与华盛顿大学的这项工作指出了第三条极具现实意义的演进路径。他们证明了,通用文本大语言模型在其庞大的参数内部,已经天然蕴藏了处理异步信号流与交错思考的泛化潜能。无需推翻重来去修改底层结构,仅需一层设计得当的“中断-恢复”异步编排协议,就足以将这些潜能转化为在毫秒尺度上与真实世界同步脉动的连续时间认知。
然而,更深远的启示在于系统对齐与评估的方法论转向。在智能体迈向多模态、流式交互的深水区时,依赖传统的 LLM 裁判已然成为研发过程中最大的“温室假象”。唯有扎根于客观世界的可验证反馈,以严密设计的细粒度奖励结构为缰绳,借助在线强化学习不断在真实交互模拟中探索边界,我们才能真正告别那个结结巴巴的卡顿时代,迎来自然流畅、言之有物的连续交互智能体。