MemChain:从“检索即证据”到可解释轨迹,记忆Token暴减95%且显著涨分
MemChain: Learning Interpretable Memory Traces for Memory-Augmented LLM Agents
在大模型智能体(LLM Agent)迈向长期交互与多轮任务的过程中,如何让模型“记住”过去的对话事实、状态变更与偏好演进,一直是构建实用 Agent 的核心难题。目前绝大多数记忆增强系统的标准做法非常直观:当用户提出一个新问题时,系统利用检索模块(Retriever)从记忆库中捞出一组最相关的历史片段,然后一股脑拼接进提示词,直接抛给负责推理回答的主模型。
ArXiv URL:https://arxiv.org/abs/2607.24097v1
这种普遍采用的“检索即证据”(retrieval-as-evidence)范式,其实暗含了一个极不现实的假设:只要检索出来的片段在语义上相关,它们就已经适合作为下游推理的证据。然而在真实的长期记忆场景下,检索得到的往往是一个鱼龙混杂的候选池——既包含过时的状态、相互冲突的信息,也包含大量语义重复甚至弱相关的琐碎上下文。将这些未经处理的原材料直接塞给下游模型,不仅造成了动辄数千 Token 的巨大上下文开销,更迫使回答模型在生成答案的同时,必须隐式地去理顺时序先后、化解事实冲突。
针对这一长期被忽视的痛点,来自中国科学院(CAS)、Memorax AI 等机构的研究团队提出了 MemChain。这项工作颠覆了“检索后直接喂给模型”的粗放模式,首次在检索与回答生成之间引入了一个独立的可训练“检索后记忆策略”(Post-Retrieval Memory Policy)。它将原本杂乱无章的检索候选集,逐步提炼、编织成紧凑、可溯源且面向回答的“主动记忆”(Active Memory),送入冻结的下游回答模型。
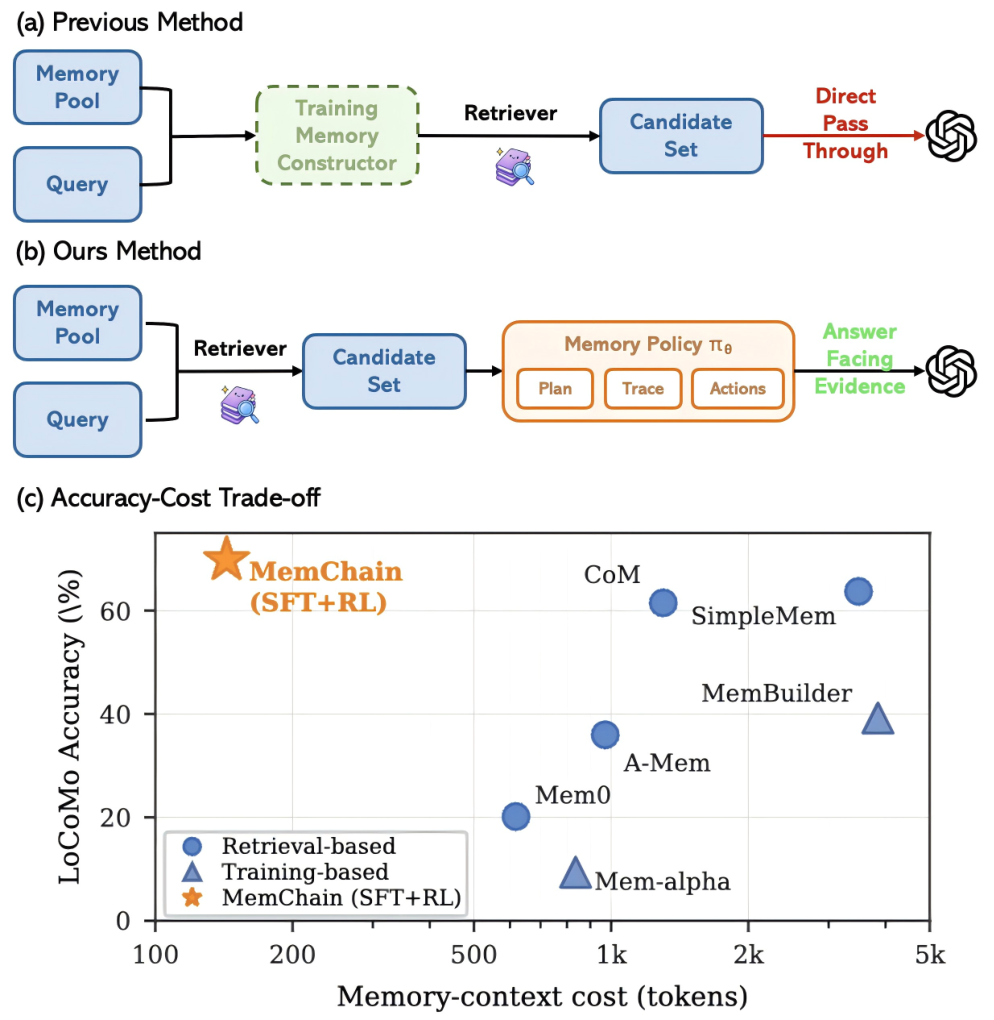
实验结果极其惊艳:在标准的长期记忆基准 LoCoMo 上,MemChain 驱动的智能体不仅在不同开源与闭源主模型上均刷新了最佳表现,还将最终喂给下游回答模型的记忆上下文 Token 数量从数千缩减到了平均仅 143.3 个,压缩幅度高达 95% 以上;在开源 Qwen3-14B 模型上,问答准确率相比最强基线甚至大幅提升了 19.09 个百分点。
相关并不等于充分:检索即证据范式的内在缺陷
在现有的记忆增强框架中,研究者的注意力主要集中在两个环节:一是前端的记忆构建与维护,比如哪些信息需要写入持久化数据库、如何适时更新或遗忘;二是中间的检索与组织机制,比如设计图谱结构、混合检索策略或语义压缩。无论上游如何优化,最终暴露给回答模型的,往往依然是一个简单的候选集合 $C_q$。
然而,“相关性”绝不等于“证据充分性”。一个候选片段可能在语义向量上与当前问题高度匹配,但如果缺少了另一个指明时间戳或前提条件的片段,该记录就可能直接引导模型给出错误的推断。更致命的是,长期记忆中普遍存在事实演变:用户上周说“我不吃辣”,昨天说“今天想尝尝川菜”,系统如果直接把这两条记录一并抛出而不标明上下文逻辑,回答模型很容易在隐式消解冲突时产生幻觉。
这就引出了一个核心问题:长文本任务的瓶颈,往往不在于“能不能检索到相关记录”,而在于“能否将检索出的候选片段转化为对特定问题充分、时序自洽且来源可追溯的纯净证据”。直接把这个沉重的负担推给下游生成模型,既浪费推理算力,又极易在冗长的上下文里“迷失自我”。
MemChain 敏锐地切中了检索之后、回答生成之前的这块空白地带。研究团队给出的解题思路是:上游检索模块保持不变,下游回答模型完全冻结,在二者之间插入一个专门学习“证据转化”的小型策略模型。该策略并不负责寻找新记忆,而是专注于从已知候选集 $C_q$ 中提取针对当前问题 $q$ 的紧凑证据集合 $E$。
拆解 MemChain:规划、追踪与显式动作的三重奏
MemChain 的核心机制不是简单地调用大模型做一段无约束的摘要压缩,而是将证据的形成过程分解为一个结构严谨、高度可解释的生成链条。面对问题 $q$ 和检索候选池 $C_q$,策略模型 $\pi_\theta$ 会在单次自回归生成中,依次吐出四个紧密衔接的结构化成分:证据规划(Plan)、证据轨迹(Trace)、记忆动作(Action)以及最终的主动记忆(Active Memory)。
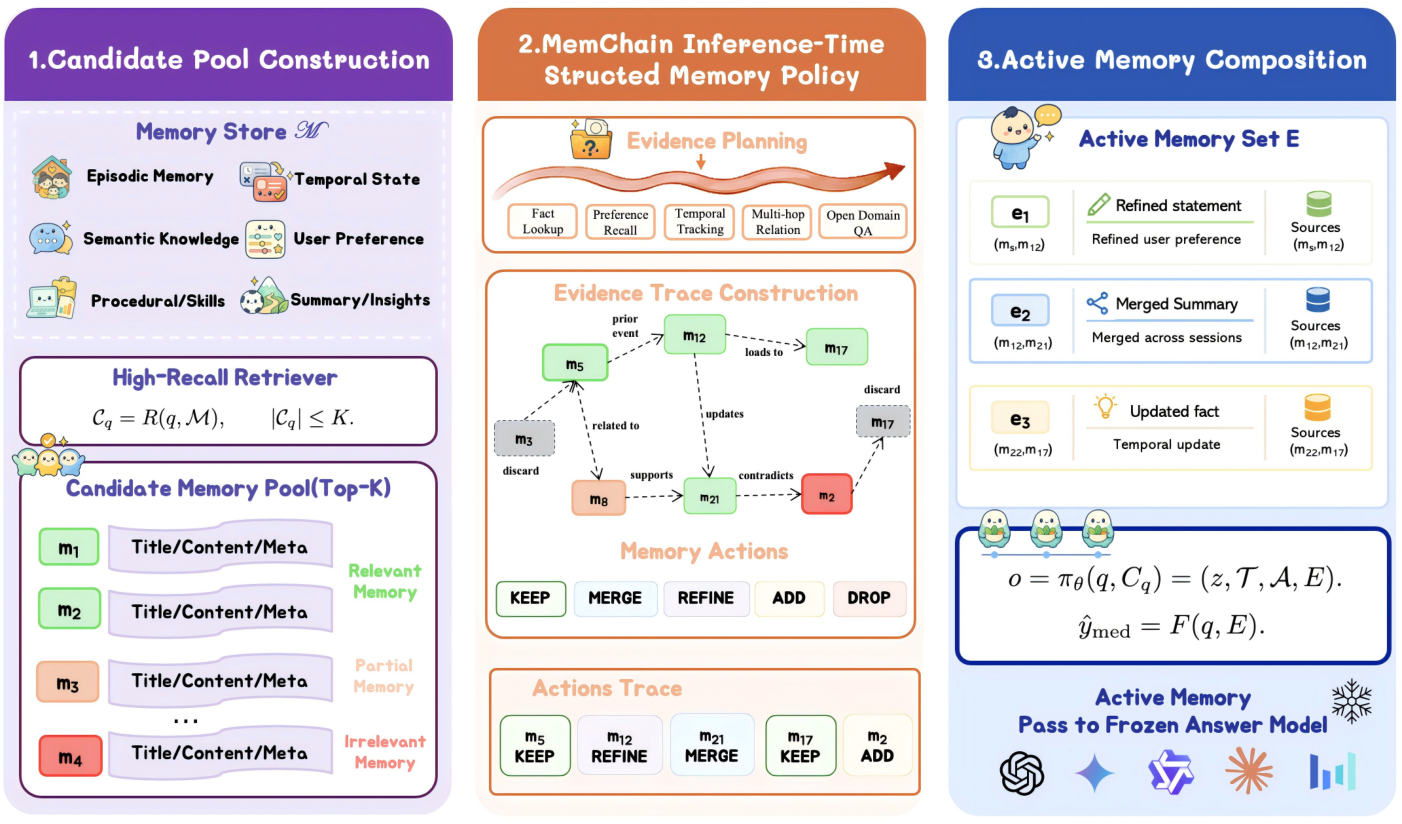
首先是问题驱动的证据规划(Question-Conditioned Evidence Planning)。面对一个具体查询,系统首先需要知道“回答这个问题到底需要什么样的证据”。规划模块 $z = (\iota, \mathcal{D}, h, \eta, b)$ 显式输出了证据意图 $\iota$、相关记忆类型 $\mathcal{D}$、时间范围 $h$(如当前状态、近期事件或历史背景)、针对当前问题的具体证据需求 $\eta$,以及一个用于约束紧凑度的软目标数量 $b$。这种显式规划为后续的筛选奠定了目标导向的基础,避免在没有全局目标的情况下盲目挑选候选记录。
其次是构建可溯源的证据轨迹(Grounded Evidence Trace Construction)。这是 MemChain 实现高可解释性与严密逻辑的核心。证据轨迹 $\mathcal{T} = (t_1, \dots, t_L)$ 将离散的候选记录按照语义角色和依赖关系组织成有序的链条。每一个轨迹步骤 $t_\ell$ 都必须显式绑定至少一个来自检索集 $C_q$ 的唯一记忆 ID。在这个过程中,策略模型会明确标注出记录之间的演进关系——究竟哪一条记录代表初始事实,哪一条记录代表后续的状态覆盖,哪两条记录形成了对比,哪条记录消解了冲突。通过强制每个推理步骤锚定到具体候选 ID,系统从根源上遏制了证据层面的无端捏造。
第三是执行显式记忆动作并组合证据(Trace-Guided Evidence Composition)。在理清了证据轨迹后,策略模型从一个定义明确的动作词汇库中选取具体操作,词汇库包含五种核心动作:KEEP(保留有用片段)、DROP(剔除过时或冗余噪声)、MERGE(将多条存在依赖的片段融合)、REFINE(提炼关键事实细节)以及 ADD(补充必要的推导说明)。策略模型依据前述轨迹对候选片段实施这一系列动作,最终生成极度精炼的主动记忆集合 $E$。
至关重要的一点是,系统施加了严格的溯源硬约束:最终生成的每一个证据语句 $e_j \in E$,其所依赖的来源 ID 必须非空且严格属于检索候选集 $C_q$。这意味着,下游回答模型看到的不再是成千上万字、参杂着过时信息与冗余词句的原始对话记录,而是一份条理清晰、去粗取精、附带严谨事实引用的“证据清单”。
两阶段策略学习:从结构规范到下游效用闭环
让一个轻量级策略模型学会如此精密的多阶段结构化输出,仅靠简单的提示工程(Prompting)显然无法保证其稳定性和严谨度。MemChain 为此设计了一套巧妙的两阶段训练框架,在保持检索器与回答模型完全冻结的前提下,专门针对策略模型进行端到端调优。
第一阶段是监督轨迹学习(Supervised Trace Learning, SFT)。研究团队利用高性能教师模型离线生成了一批高质量的结构化参考数据包 $o^* = (z^, \mathcal{T}^, \mathcal{A}^, E^)$。通过标准的最大似然估计损失函数 $\mathcal{L}_{\mathrm{SFT}}$,让策略模型掌握严格遵循 JSON Schema 结构输出的能力,确保其能够熟练执行动作语法、维持候选 ID 引用的合法性,并学会如何将长篇素材提炼为紧凑的证据文本。
然而,SFT 只能教会模型“像模像样地写出结构化证据”,并不能保证提炼出来的证据在下游回答模型眼里就是最实用、最利于回答的。为了将证据质量与最终问答效果彻底打通,研究团队提出了第二阶段的核心算法——轨迹引导的记忆策略优化(Trace-Guided Memory Policy Optimization, TMPO)。
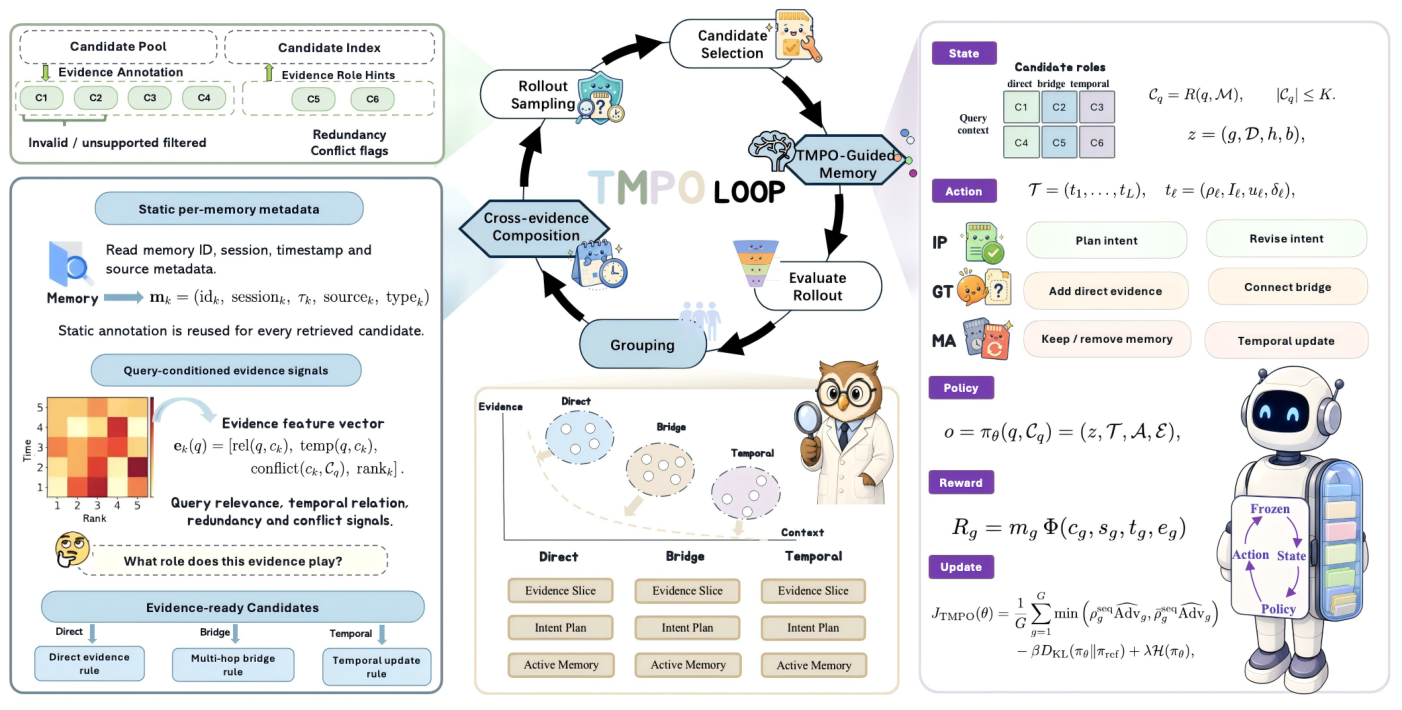
TMPO 借鉴了当前热门的 GRPO(Group Relative Policy Optimization)思想,对同一个查询问题 $q$ 和候选集 $C_q$,策略模型会采样生成 $G$ 个不同的结构化候选包 ${o_1, \dots, o_G}$。每一个候选包提取出的主动记忆 $E_g$ 都会被直接输入给下游冻结的回答模型,得到对应的回答 $\hat{y}_g$。
随后,系统从多个维度对这组 Rollout 进行复合奖励计算:
-
回答准确性:评估下游模型利用该证据生成的答案是否正确;
-
轨迹溯源性:检查轨迹步骤是否严格指向了有效的候选 ID;
-
证据支撑度:最终证据语句是否得到了轨迹和原始记录的充分支撑;
-
结构合规性:动作语法与格式是否完全符合定义。
TMPO 并没有采用复杂的价值网络(Critic),而是直接在同一个问题的候选组内计算相对优势 $\widehat{\mathrm{Adv}}_g$。更为精妙的是,为了稳定长序列结构化生成的强化学习过程,TMPO 引入了序列级重要性比率(Sequence-level importance ratio)并施加截断,配合 KL 散度惩罚与熵增益,使得策略模型在优化下游问答效果的同时,始终保持输出格式的极高规范性与引用的真实性。
这一训练流水线的绝妙之处在于“解耦”:数据构建、SFT 和 TMPO 的训练集完全独立于下游评测基准,模型从未在 LoCoMo 或 LongMemEval 等测试集上见过任何测试问题或标准答案。它学到的是一种通用的“证据提炼与逻辑整理”能力,而不是死记硬背特定领域的记忆知识。
实验与表现:超低上下文开销下的性能跃升
为了检验 MemChain 的真实威力,论文在 LoCoMo 以及 LongMemEval-S 两个极具挑战性的长期记忆基准上进行了详尽的评测。实验涵盖了单跳、多跳、时间演变以及开放域等多种长周期对话场景。
在基模型配置上,策略模型仅采用了轻量级的 Qwen3-4B,而下游回答模型则分别测试了闭源的高水平模型(如 GPT-4.1-mini、GPT-4.1)以及一系列开源权重模型(Qwen3-1.7B、Qwen3-8B、Qwen3-14B)。对比的基线不仅包含了当下一流的检索式记忆系统(如 Mem0、A-Mem、CoM、SimpleMem),还涵盖了前沿的学习型记忆构建方法(如 Mem-$\alpha$、MemBuilder)。为了做到最严苛的受控对比,所有方法均固定了相同的检索候选集、回答提示词以及裁判协议,唯一不同的变量就是“送到回答模型面前的记忆上下文到底是什么”。
实验结果展现了压倒性的优势。当使用 GPT-4.1-mini 作为回答模型时,经过 SFT + TMPO 训练的 MemChain 在 LoCoMo 上取得了 69.80 的整体准确率,显著超越了此前最强基线 6.10 个百分点。尤为惊人的是上下文开销的对比:此前的先进方法 SimpleMem 平均需要向主模型输入 3491.0 个 Token 的记忆上下文,CoM 也需要 1301.3 个 Token,而 MemChain 送入回答模型的证据 Token 数量平均只有 143.3 个!
这意味着,MemChain 用不到以往二十分之一的上下文长度,不仅没有丢失关键信息,反而通过洗去噪声和理顺逻辑,让主模型答得更好、更准。在细分题型中,提升最为显著的恰恰是涉及时间状态更新和多轮长程跨度的复杂问题,充分验证了显式证据轨迹在处理事实演化时的威力。
当回答模型切换为开源权重模型时,MemChain 的泛化能力和增益更加夸张。在搭配 Qwen3-14B 作为回答模型时,MemChain 拿下了 80.26 的超高准确率,相比最强基线暴涨了 19.09 个百分点;即便是搭配更小的 Qwen3-1.7B 和 Qwen3-8B,也分别斩获了 68.05 和 75.00 的高分。这揭示了一个深刻的现象:中轻量级开源大模型在处理冗长、杂乱的原始记忆时,极易受到无关信息的干扰;而一旦由 MemChain 将原材料预处理为干练纯粹的核心证据,这些中小模型的推理潜力便被瞬间激发。
在时延方面,MemChain 完成全套检索后处理与证据组合的平均耗时仅为 0.83 秒。虽然相比直接拼接候选集增加了一道轻量推理过程,但由于传递给下游主模型的上下文大幅缩减,下游模型在预填充(Prefill)阶段的显存压力和延迟得到了极为可观的释放。
为什么有效?消融实验揭示关键机制贡献
为了进一步探究 MemChain 各个模块的具体作用,研究团队在固定候选集与下游评测协议的前提下,展开了细致的消融分析。
消融数据给出了清晰的因果链条:
-
去除证据规划(Plan):准确率直接下滑了 6.21 个百分点。这证明在没有明确时间范围、实体类型和软约束目标的前提下,策略模型很容易迷失在细节中,无法精准捕获问题所真正关心的证据侧重点。
-
去除可溯源证据轨迹(Trace):模型性能遭遇了断崖式下跌,整整下挫了 13.96 个百分点。这是所有结构化组件中最为致命的缺失。缺少了显式的步骤依赖、时序演进和冲突消解标记,系统退化为了普通的“端到端文本压缩”,跨多条记录的逻辑链条极易断裂。
-
去除强化学习训练(仅 Prompt 或仅 SFT):如果完全不进行微调,仅靠 Prompt 驱动相同参数的基座模型输出该结构,其准确率比完整的 MemChain 低了足足 20.45 个百分点;而仅做第一阶段 SFT 的策略准确率为 67.42,TMPO 的引入在此基础上进一步拉升了 2.38 个百分点。这说明让模型学会严格输出格式只是基本功,利用真实下游回答反馈进行强化学习,才能让证据的“信息密度”与“答案效用”达到最优。
对未来 Agent 架构的深层启示与现实边界
长期以来,业界在研发智能体记忆系统时往往陷入一种惯性思维:要么不断堆砌更复杂的外部存储架构(如各类异构知识图谱、多级向量索引),要么无休止地依赖长上下文模型的窗口容量,把检索到的所有历史片段直接往提示词里硬塞。
MemChain 的成功给出了一种极具启发性的新范式:检索和推理之间,应当存在一层专门的“证据中间件”。在复杂的生产环境中,下游负责核心业务决策或问答的 LLM 通常成本高昂(如 GPT-4 类闭源 API 或庞大的百亿级密集模型)。让高昂的主模型去充当“清洁工”分拣杂乱历史,不仅极其昂贵,而且极易翻车。通过训练一个专用、轻量的边缘小策略模型(如 4B 级别参数),在近端将繁杂的检索候选精炼为可溯源的主动证据链,可以同时实现推理成本骤降与决策准确率飙升的双赢。
当然,作为这一范式的开拓之作,论文也坦诚指出了 MemChain 当前的现实边界:
首先,它的能力上限严格受制于上游检索模块的召回边界。MemChain 充当的是“深加工车间”,如果上游检索器根本没有捞出关键的事实记录,处于后端的策略模型由于被施加了严格的反幻觉溯源约束,是无法凭空变出缺失证据的。
其次,在计算成本的核算上必须保持客观。所谓的“Token 暴减 95%”,特指输入给最终回答模型的活跃记忆上下文体积;在构建该证据的过程中,MemChain 自身调用 4B 小模型自回归生成轨迹与动作依然消耗了本地推理算力。这种权衡在大模型作为昂贵云端服务、或边缘设备显存受限的场景下极具性价比,但在极端追求超低延迟的超轻量场景中仍需综合评估。
综上所述,MemChain 凭借其“规划—追踪—动作”的三段式结构化设计,以及结合强化学习的下游效用对齐,为长期记忆智能体开辟了一条从“粗放检索”通往“精致证据化”的扎实路径。随着智能体交互周期的无限拉长,这种让机器记忆变得紧凑、自洽且高度可解释的架构,必将成为下一代自主智能体系统中不可或缺的关键一环。