MegaMem:解耦超大长效记忆与生成证据,6.5亿Token下正确率达86.5%
MegaMem: A Retrieval Solution for Ultra-Large Context Windows
在大模型逐步走向自主智能体(Agents)和企业级知识中枢的过程中,模型需要接纳的信息量正在呈指数级膨胀。无论是一个庞大代码仓库的完整提交历史、横跨数月的复杂多轮人机交互,还是企业内部数十万份异构文档,都要求系统具备一种能够跨越长周期的“持久记忆”(Persistent Memory)。然而,当前业界在处理这一需求时面临着尴尬的结构性矛盾:原生超长上下文窗口即便扩充到数百万 Token,也难以承受数亿 Token 级别历史的直接装载;更致命的是,将大量原始数据粗暴灌入模型,往往会导致严重的注意力分散、“大海捞针”中的位置偏置,以及推理成本与延迟的剧烈攀升。
ArXiv URL:https://arxiv.org/abs/2608.22137v1
反过来,传统的外部检索(RAG)方案虽然具备扩展到海量数据的能力,但在应对真实多文档复杂推理时却显出疲态。采用高度压缩的文本摘要或图结构索引,虽然便于语义检索,却极易丢失决定答案正确性的细粒度时间戳、附加边界条件或条款冲突;而直接检索原始细节切块,又很容易在大规模语料带来的海量负样本(Distractors)面前迷失方向,导致检索准确率雪崩。
来自埃默里大学因果动力学实验室(Causal Dynamics Lab, Emory University)的研究团队提出了名为 MegaMem 的超大上下文记忆检索系统,试图从根本架构上破除这一两难处境。其核心洞察在于:必须将“可检索的持久记忆规模”与“模型生成所消耗的证据上下文”彻底解耦。系统在检索阶段利用紧凑的提炼记忆进行广泛的语义定位,但所有命中结果在进入大模型前,必须解析回具备不可变源标识的原始细节证据;大模型仅在严格受限的上下文预算内,基于高质量细节进行推理。在包含超 50 万份文档、约 6.5 亿 Token 的企业级基准 EnterpriseRAG-Bench 上,MegaMem 将综合得分从 68.22 提升至 82.26,正确率达到 86.50%,并成功将问答阶段的输入 Token 规模压缩了近 70%。
持久记忆与证据上下文的解耦逻辑
要理解 MegaMem 的设计,首先需要重新审视长上下文管理中长期被混为一谈的两个概念:持久上下文(Persistent Context)与证据上下文(Evidence Context)。
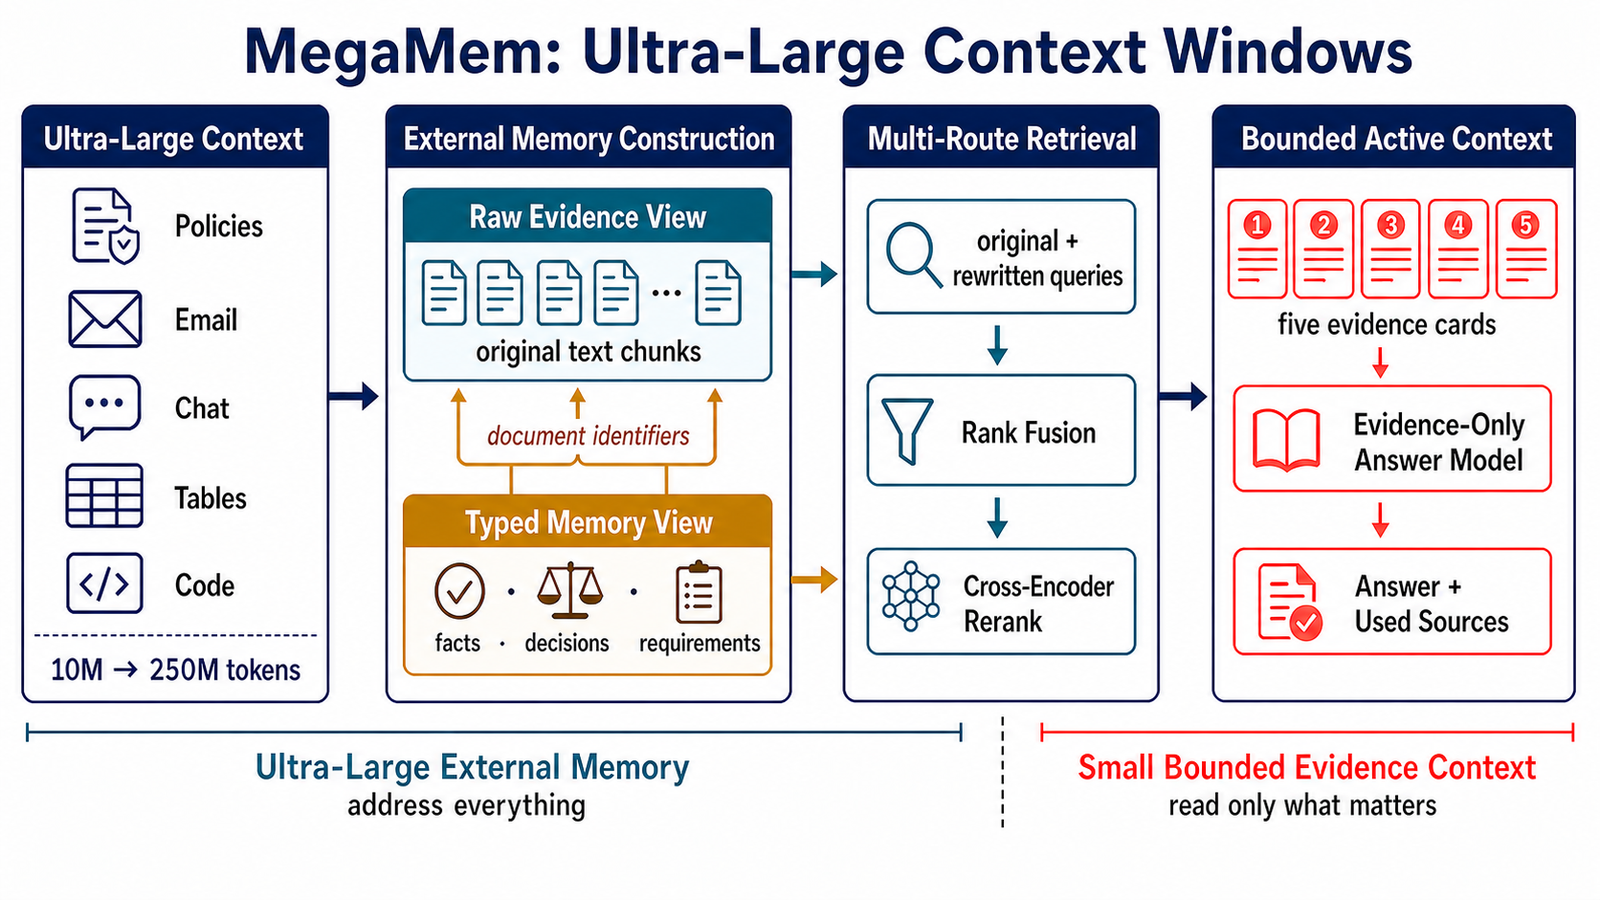
持久上下文 $\mathcal{D}$ 指的是系统可以检索的完整记忆库,其 Token 规模 $T$ 可以达到数亿乃至数十亿级别;而证据上下文 $E(q)$ 则是为了回答特定问题 $q$,实际被送入生成模型的那一部分受限细节内容,其 Token 规模受到预算 $B$ 的硬性约束(即 $B \ll T$)。传统方法之所以在语料扩增时性能急剧恶化,正是因为系统试图让这两者保持某种线性比例关系,或者过度依赖压缩表示来充当最终的生成素材。
MegaMem 确立了一条硬性原则:任何压缩、提炼或派生的记忆单元,仅用于提高检索召回率,绝对不直接参与最终的答案生成。生成模型接收到的所有输入,必须是来自原始文档的细节切片。这种“源解析双视角”(Source-Resolved Dual-View)框架在记忆构建阶段便做好了分工。
在记忆构建过程中,原始企业文档首先被切分为保留原始段落与结构元数据的细粒度证据切片 $\mathcal{X}={x_1, \ldots, x_n}$,构成“详细证据视图”(Detailed View)。随后,系统调用轻量级模型从细节切片中提取出具有类型化属性的提炼记录 $m_{ij}$,构成“提炼记忆视图”(Distilled View)。关键之处在于,每一个提炼记忆项都必须绑定一个全局唯一的不可变源标识符 $\pi_{ij} = i$。这意味着提炼视图承担的是语义索引卡片的职能,它能够适应同一事实的不同自然语言表达和抽象提问,但其背后的物理指针始终锚定在详尽的原始上下文切片上。
多路由检索与源解析机制
为了在数亿 Token 级别的庞大语料库中准确找回关键事实,单一的查询方式和单视角的检索往往容易挂一漏万。MegaMem 在运行时采用了多路由混合检索策略。
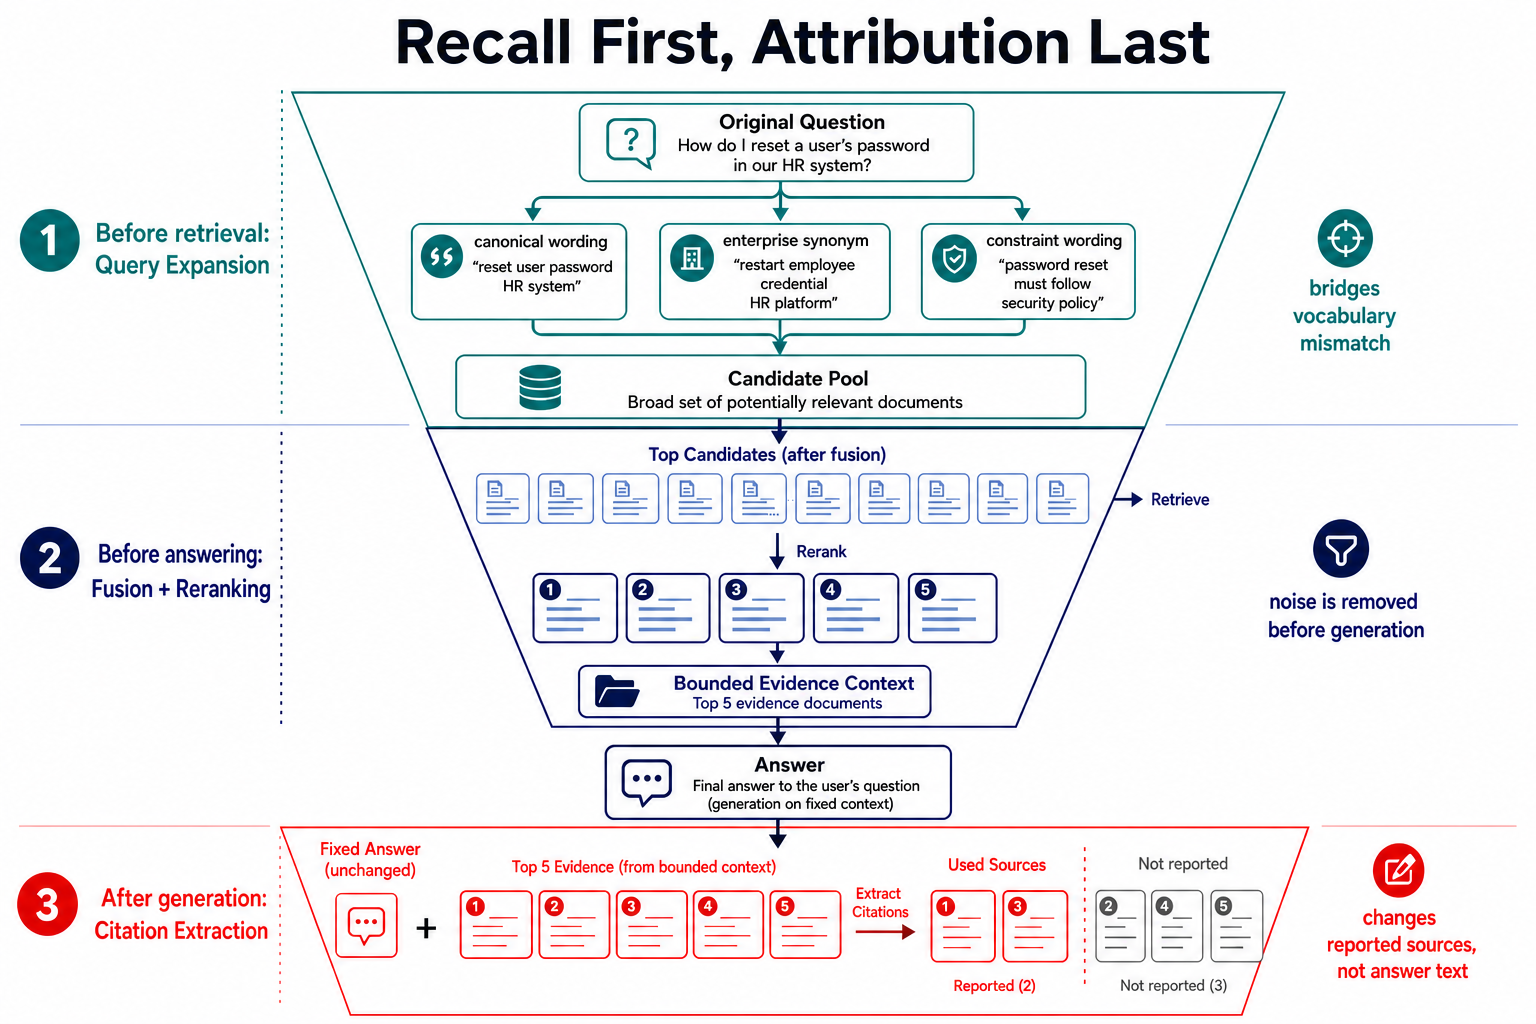
面对输入问题 $q$,系统首先借助大模型对查询进行规范化改写与术语扩展,生成覆盖不同表述习惯的查询路由集合 $\mathcal{Q}(q)$。随后,每一条查询路由都会并行搜索两个截然不同的索引库:详细证据索引 $I_d$ 和提炼记忆索引 $I_m$。详细路由直接捕获精确的专有名词和具体事实,而提炼路由则捕捉概念层面的抽象语义。
当提炼记忆索引返回匹配候选项时,MegaMem 立即执行“源解析”(Evidence Resolution)操作。所有被检索到的提炼记忆项,都会通过预存的不可变源标识符,瞬间反查并替换为其对应的详细证据切片。也就是说,来自不同视角的检索结果,在进入排序阶段前,已经被统一映射回了同一个证据空间。
随后,系统采用倒数排名融合算法(Reciprocal-Rank Fusion, RRF)对所有检索流返回的详细切片进行加权聚合打分:
\[S_{\mathrm{RRF}}(x\mid q)=\sum_{r\in\mathcal{L}(q)}\frac{w_{r}\,\mathbf{1}[x\in r]}{\gamma+\operatorname{rank}_{r}(x)}\]通过融合并去除重复的候选切片后,再经由 Cross-Encoder 重排序模型进行最终筛选,仅保留排序最高且符合硬性 Token 预算 $B$ 的少数详细证据切片 $E(q)$。这一精细化的漏斗设计,确保了喂给大模型的上下文既高度聚焦,又保留了原始文本中未经篡改的细微线索。
受限生成与后置归因分离
在确定了最终证据集 $E(q)$ 之后,生成模型在严格的“仅基于证据”(Evidence-only)约束下产出答案 $a$。但 MegaMem 的流程并未在此终止。在企业级或高可靠性智能体场景中,不仅答案必须准确,系统声称引用的依据文档也必须真实有效。
许多传统方案往往在生成答案的同时,强行让大模型同步输出引用的文档编号,这种端到端的多任务模式容易诱发幻觉,或者导致模型倾向于将上下文里看到的所有文档全盘列为参考源。MegaMem 引入了后置答案归因(Post-Answer Attribution)模块,将生成任务与归因任务在时序上完全解耦。
在固定了最终预测答案 $a$ 之后,系统启动专门的归因评估器 $\mathcal{C}$,审查回答内容到底是由哪些已加载的证据切片实际支撑的:
\[Z=\mathcal{C}\bigl(a,E(q)\bigr),\qquad Z\subseteq\operatorname{docs}\bigl(E(q)\bigr)\]这种后置过滤机制不会回过头去修改已经生成的正确答案,但能够剔除那些被检索进来、却没有真正对回答起到支撑作用的冗余文档。在实际消融实验中,这一模块在完全不影响回答质量的前提下,将系统平均报告的文档数量从 5.00 份大幅精简至 2.31 份,削减了超过 53% 的无效源汇报,显著压低了引用误报率(InvDocs),为高审计要求的落地场景提供了强有力的支持。
超大规模企业级评测的表现
为了验证 MegaMem 在真实噪声和超大语料下的表现,研究团队在 EnterpriseRAG-Bench 上开展了全面评估。该基准不仅语料规模达到 50 万份异构文档和约 6.5 亿 Token,其评测问题也广泛涵盖了多文档综合推理、时间冲突仲裁、强约束搜索以及“无有效信息”(Missing-information)识别等高难度场景。
在 400 道题目的严谨验证集上,MegaMem 展现出了显著超越传统稠密检索与层级摘要方案的能力。从整体评估指标来看,MegaMem 达成了 82.26 的 Overall 综合得分,答案正确率(Correctness)达到 86.50,完整性(Completeness)达到 84.15。而在同等设定下,标准的稀疏与稠密基线模型得分均大幅落后。
更具说服力的是系统在不同记忆体量下的扩展性表现。研究人员将持久上下文规模从 20M Token 逐步拉升至 250M Token,同时强制检索候选预算和最终证据上下文预算保持恒定。实验表明,即便面对长达 2.5 亿 Token 的海量背景噪声,MegaMem 的性能衰减也表现得极为平缓:其正确率始终稳定在 73.50% 以上,文档召回率保持在 66% 以上,Overall 得分依然达到 58.02。这证明了通过提炼索引导航、由不可变指针还原细节的技术路径,确实能够让大模型在不撑爆上下文窗口的前提下,具备检索数亿 Token 级别记忆的能力。
模块消融与工程效率的平衡
MegaMem 带来的性能提升到底归功于哪些环节?逐一剔除组件的消融分析给出了清晰的答案:
-
双视角与提炼机制是绝对核心:若剥离提炼记忆索引,仅依赖原始文本切片进行检索,系统在处理同义替换和多层跳转问题时召回率骤降;若仅依赖提炼记忆而不还原为详细切片,直接拿提炼摘要喂给大模型,答案正确率则会遭遇崩塌式下跌,因为关键的数字、例外条款和冲突细则都在提炼中丢失了。
-
查询扩展与重排序构筑了召回护城河:多路由查询扩展在测试中成功救回了基准检索器原本遗漏的目标文档,而重排序阶段则通过高精度的相关度打分,确保了送进有限预算 $B$ 内的都是纯度极高的黄金线索。
在运行效率方面,MegaMem 展现出了极高的工程实用价值。许多开发者担忧多路检索与双视角索引会拖垮推理延迟,但实测数据显示,记忆的提炼与构建完全是在离线阶段完成的;在在线问答阶段,当持久记忆处于 60M 至 100M Token 级别时,检索耗时仅需 0.30 至 1.10 秒,端到端完整应答时间在 2.5 至 3.3 秒之间。在 Token 消耗上,基于选择性细节的证据装载策略相比全量细节喂入,减少了 68.6% 的模型输入 Token,而正确率仅微跌 1.5 分;整套包含 500 个复杂问题的诊断评测,总推理 API 成本仅为 3.75 美元,平均单题成本不足 0.01 美元。
在泛化性迁移实验中,MegaMem 在金融领域的 FinanceBench 和多跳推理基准 HotpotQA 上分别取得了 81.05 和 86.37 的 Overall 分数,证明其在跨文档分析与复杂逻辑关联上具有稳健的泛化能力。
架构取舍与未来演进
MegaMem 的成功在很大程度上印证了一个务实的技术趋势:在通向真正通用智能体的道路上,盲目追求大模型原生注意力机制对海量上下文的“全盘硬吞”既不经济,也不稳固。通过结构化的工程范式,将知识的长效检索和当下的集中推理明确拆分,是大规模长效记忆系统落地的有效路径。
当然,该方案依然存在值得后续探索的边界。首先,多路由查询扩展虽然显著拉升了有解问题的召回率,但在“信息不存在”(Information-not-found)的边界用例中,过度丰富的改写有时会把原本应该拒答的弱相关噪声硬拉入上下文,导致拒答正确率下滑。构建一个自适应的“可回答性门控”(Answerability Gate),动态决定是否执行扩展,将是优化系统抗噪能力的关键。此外,针对包含复杂跨会话依赖、强时序演进的对话类记忆场景,纯文档导向的提炼与切片仍需进一步吸收图谱或事件流机制的优点。
但无论如何,MegaMem 提供了一个清晰且经受了数亿 Token 真实语料检验的参照范式:用轻量提炼实现高维语义检索,用不可变指针锚定真实物理源,用严格受限的细节证据保障推理精度。在持久记忆迈向 10 亿 Token 级别的演进路径中,这种“检索与生成分离”的架构哲学无疑将扮演至关重要的角色。