360CityArena:东京大学实景重建秋叶原,最强AI导航得分仅17.1%
360CityArena: A Realistic Virtual Urban Navigation Benchmark for Embodied Agents
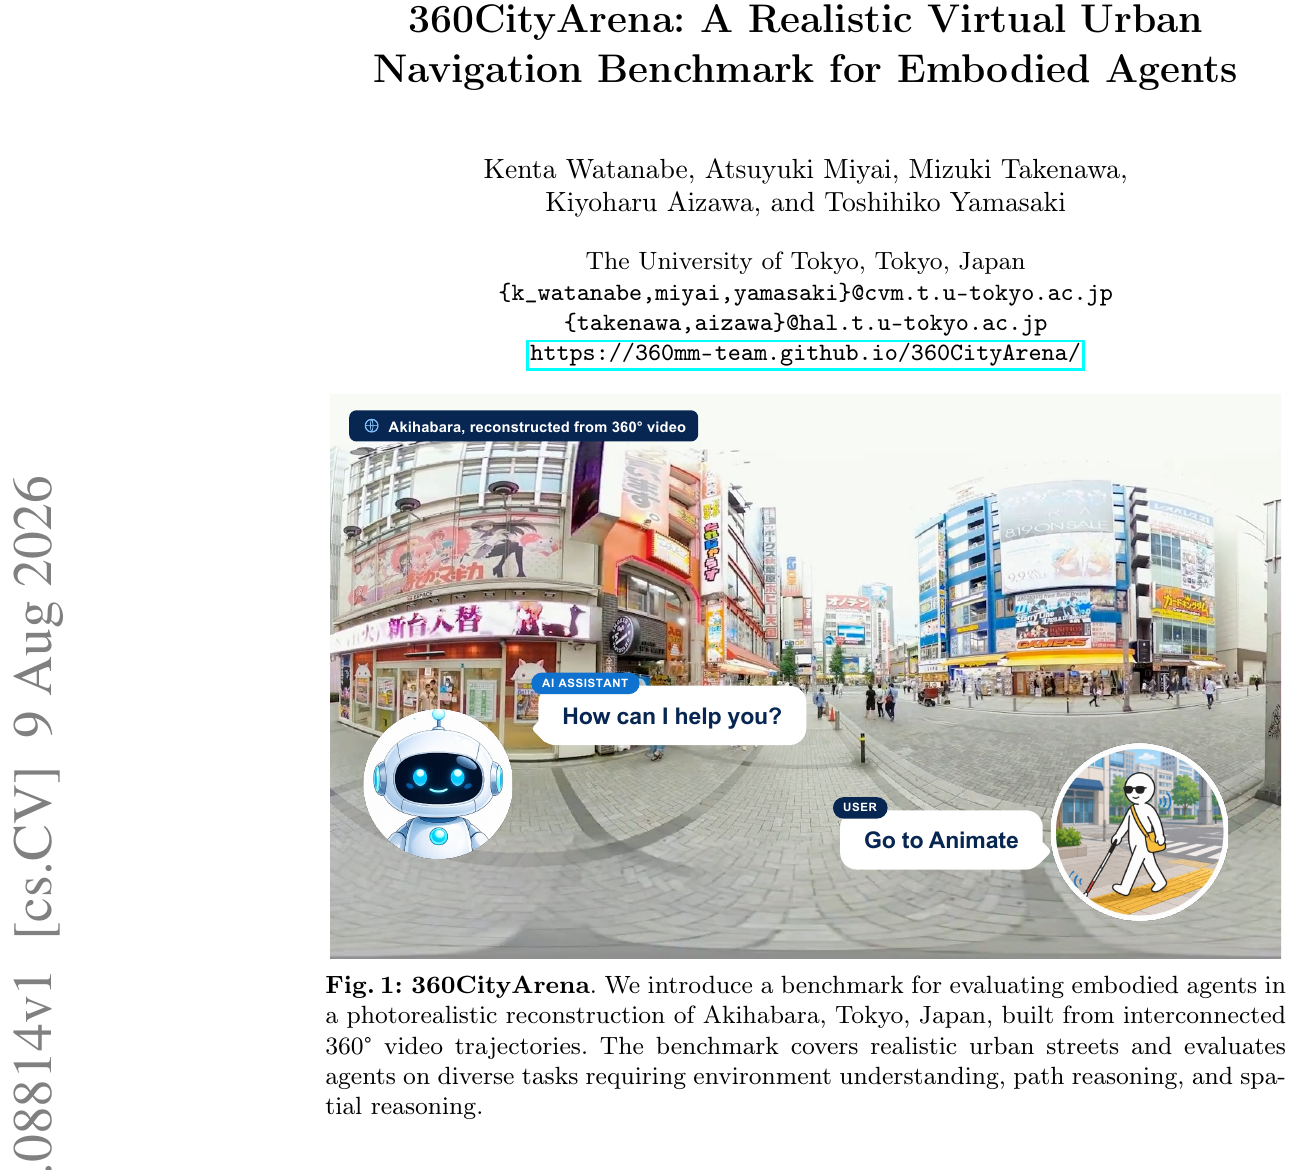
要让具身智能(Embodied AI)走出受控的室内实验室,真正成为可以在现实生活中帮盲人领路、在复杂商圈协助导览的城市助理,机器人必须在真实的街头环境中具备自主漫游、找寻地标以及路径推理的能力。然而,当前的具身导航研究长期面临一个尴尬的断层:要么依赖合成的三维虚拟场景,视觉纹理失真严重、缺少杂乱的现实细节;要么直接调用静态的街景全景图,缺乏连续的视点运动与真实的动态交通元素。
ArXiv URL:https://arxiv.org/abs/2608.08814v1
为了打破这种“模拟器内很漂亮,一上街就抓瞎”的困境,来自东京大学的研究团队提出了全新基准 360CityArena。该工作直接利用 602 段连续拍摄的 360 度全景视频,在 Unity 引擎中高保真重建了日本东京著名的秋叶原核心街区,打造出一个具有 85 条连通街道、兼具真实车流与人流动线的光影级沉浸测试场。
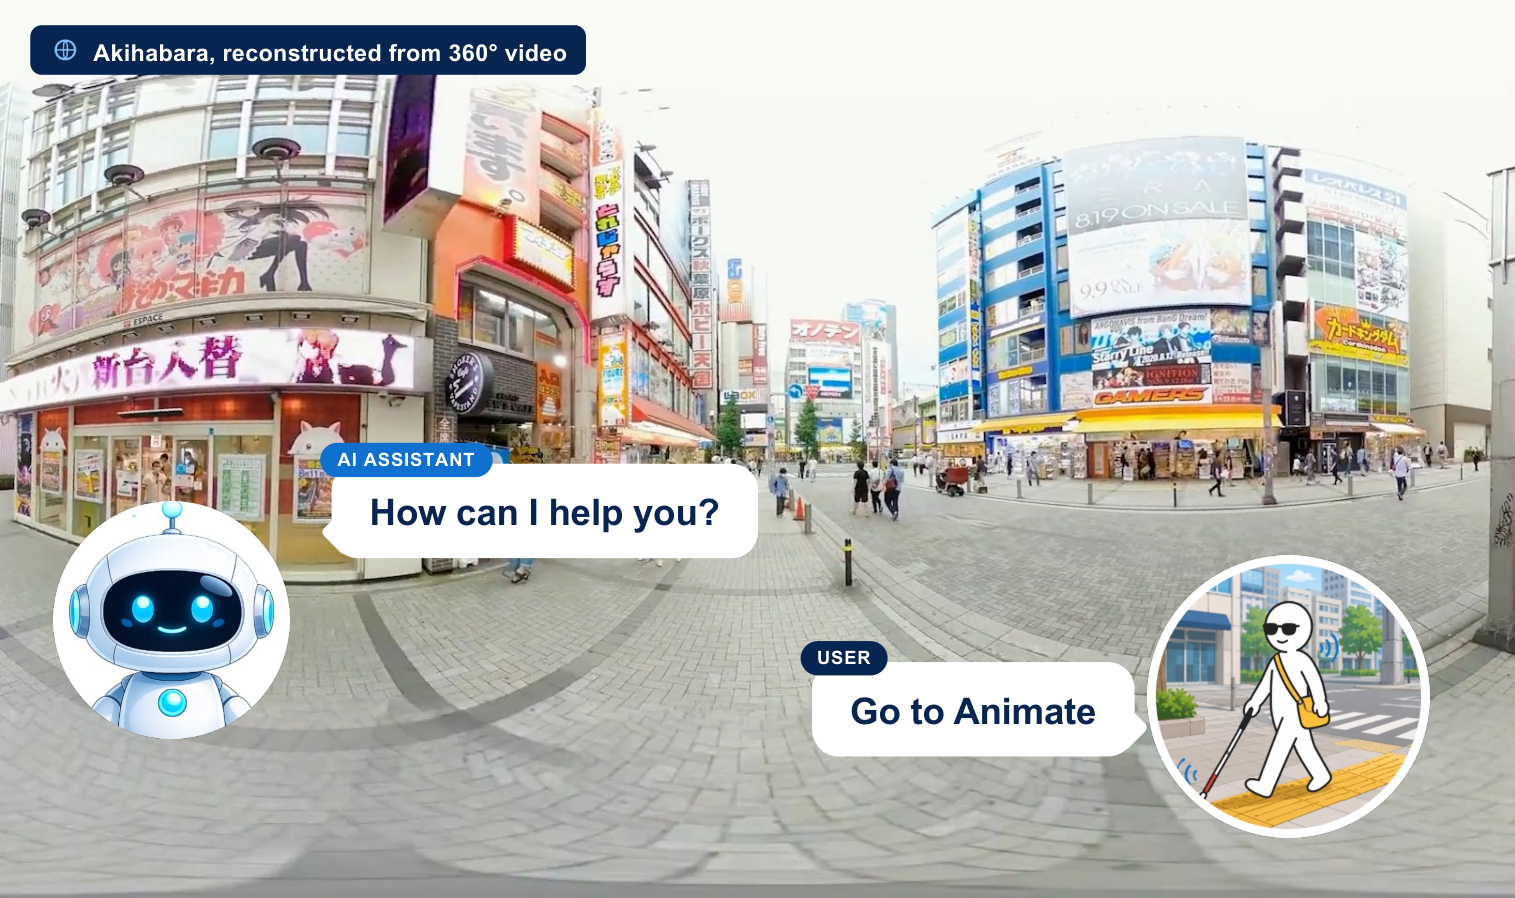
在该环境下,研究团队精心设计了涵盖环境理解、路径规划与空间推理的 175 项真实任务。然而,当业界最顶尖的一批多模态大模型(Large Multimodal Models, LMMs)作为具身智能体接受考察时,结果却展现出惊人的鸿沟:熟悉当地环境的人类基准成功率达到 77.3%,而当前测试中表现最好的商业模型 Gemini 2.5 Flash 仅拿到 17.1% 的得分,开源模型更是普遍处于极低水平。甚至当研究人员向模型直接提供自定位地图信息时,部分任务的准确率不但没有上升,反而出现了剧烈下滑。这一评测清晰揭示了当前多模态大模型在解决大尺度现实城市导航任务时的深层瓶颈。
告别玩具级沙盒:用全景视频拼接出可漫游的秋叶原
构建大尺度的室外导航环境向来是一项棘手挑战。基于神经辐射场(NeRF)或 3D 高斯泼溅(3DGS)的三维重建技术虽然在静态渲染上表现优异,但算力开销巨大,且往往无法支持智能体在大范围街区内展开无缝、连贯的长距离交互;而以传统游戏引擎合成的虚拟城市,虽然允许自由设定物理碰撞与运动,却很难还原真实街道复杂的招牌字迹、反光材质、交织的人流以及不规则的建筑几何。
360CityArena 选择了一条兼顾高拟真度与大范围可行走性的路径:借鉴经典“电影地图”(Movie Map)的设计思想,利用现实中拍摄的连贯全景影像构建拓扑位姿图(Pose Graph)。
整个虚拟环境以东京秋叶原街区为蓝本,南北跨度约 750 米,东西跨度约 650 米。作者团队采集了 602 段 360 度全景视频片段,并将这些视频帧重投影到球面上,在 Unity 环境内映射为一组包含 193 个节点、305 条边的单连通拓扑图,平均分支度达到 3.16。
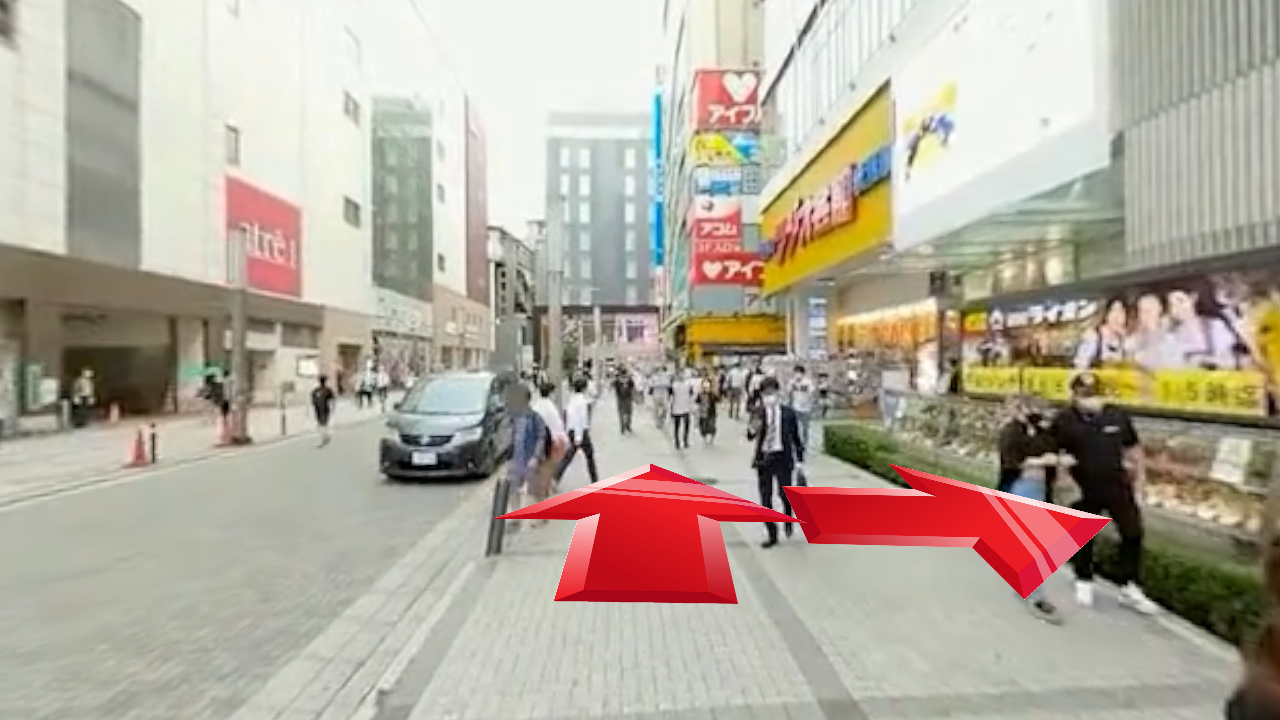
在运行过程中,智能体以第一人称视角(Egocentric View)置身街头。它的动作空间由离散指令构成:包括沿既定轨迹前进、上下俯仰视角、左右旋转观察环视环境,以及在走到交叉路口时重置视野方向。当智能体来到街道分支节点时,动作空间会自动扩充,允许它做出诸如“向前直行”“沿右侧岔路前进”或“左拐进入辅道”的决策。这种形式既完整保留了真实都市环境中的动态背景(如行走的行人、穿梭的车辆、店铺滚动的霓虹招牌),又赋予了智能体在 85 条互联街道中自主探索与调度的可能。
三大支柱与七项能力:175 个任务如何考校具身智能?
与以往仅测试“从 A 点走到 B 点”的导航评测不同,真实城市生活对人类提出的要求是立体的。一个真正的导引助手不仅需要看懂路牌,还要能根据周围参照物建立空间方位感。360CityArena 将核心能力拆解为三大支柱,并细分为七个子维度,每个子维度均包含 25 个由人工精心设计的端到端任务。
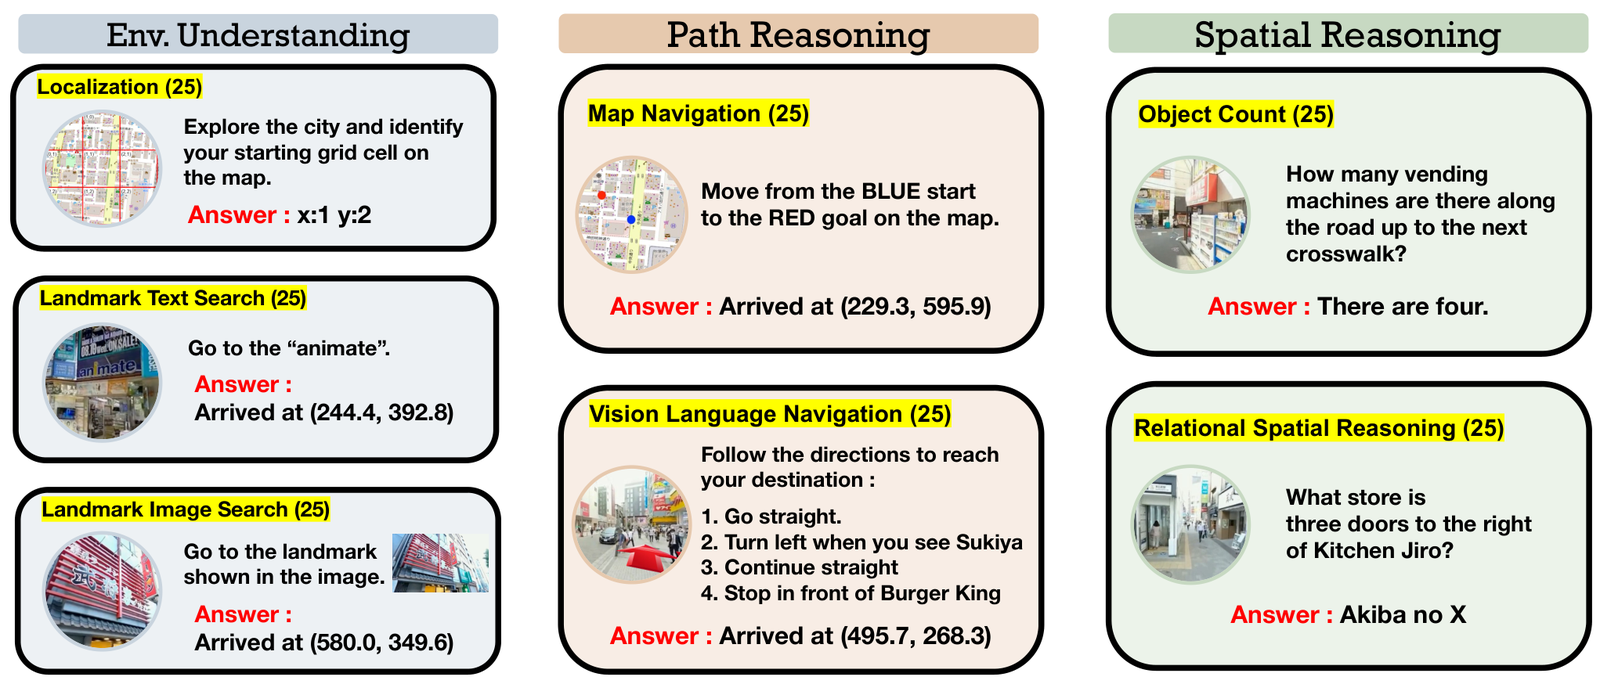
第一类是环境理解(Environment Understanding),重点考验智能体的视觉感知与自定位能力:
-
自定位(Localization):智能体被随机放置在街区某处,需要四处观察街景细节,推断出自己在全局城市地图上的具体位置。
-
基于文本的地标搜寻(Landmark Search with Language):仅给出一个地标的自然语言描述(例如“寻找一家带有黄色招牌和外部楼梯的快餐店”),智能体需要自主走街串巷将其找到。
-
基于图像的地标搜寻(Landmark Search with Image):直接向智能体输入目标地标的局部特写图像,测试其能否在缺少语义标签的情况下,通过视觉匹配完成跨视角的街区搜寻。
第二类是路径推理(Path Reasoning),测试智能体在现实街区拓扑中的决策规划效率:
-
地图导航(Map Navigation):向智能体出示带有起止点标识的二维城市俯视图,要求其在复杂的街巷网络中执行对应的实际行走路线。
-
视觉语言导航(Vision-Language Navigation, VLN):智能体必须逐步理解并严格执行一段多步骤的长文本导引指令(例如“向前经过便利店后在下一个十字路口右转,停在地铁站出口旁”)。
第三类是空间推理(Spatial Reasoning),评估智能体在动态行进中建立相对几何空间认知与定量感知的能力:
-
关系空间推理(Relational Spatial Reasoning):智能体必须根据已知参照物,推断周边目标的空间拓扑关系。例如“站在神社正门前,它的西北方向隔着一条马路的红色大厦是什么”。
-
目标计数(Object Count):要求智能体巡视特定街区区间,准确清点某一类物体的数量(如路边的自动售货机或特定品牌标识)。
为了更细致地反映能力边界,所有任务还被标注为初级(Easy)、中级(Medium)与高级(Hard)。随着难度递增,不仅智能体需要行走的物理距离从初级的平均 124 米增加到高级的 347 米,途经的决策岔路口也从 3.3 个成倍攀升至 9.0 个,指令步数与需要清点的物体数量同步递增。对于目标计数这类数值预测任务,评测没有采用死板的二元判定(非对即错),而是引入了均值相对精度(Mean Relative Accuracy, MRA):
\[\mathcal{MRA} = \frac{1}{10} \sum_{\theta \in \mathcal{C}} \mathbb{I}\left( \frac{\lvert \hat{y} - y \rvert}{y} < 1 - \theta \right)\]通过在不同误差阈值集合 $\mathcal{C}$ 下衡量预测值 $\hat{y}$ 与真实值 $y$ 的偏差尺度,能够更加平滑且合理地捕捉模型在定量估算上的渐进表现。
评测见真章:主流多模态模型的惨淡表现
研究人员将该基准视作一个部分可观测顺序决策过程(POMDP),测试了目前市面上一系列具有代表性的模型。闭源梯队包括 GPT-5、Claude Sonnet 4.5 以及 Gemini 2.5 Flash;开源梯队则囊括了 Qwen2.5-VL-32B-Instruct、InternVL3.5-8B 和 InternVL3.5-38B。在每个决策步长下,智能体接收当前视角的图像、可选的自定位地图标记,并维持一个轻量记忆缓存,借此推理输出下一步动作。
为了设立可信的上限参考,团队招募了 5 位熟悉秋叶原当地环境的本土受试者进行对照实验。评测给出的反差极为强烈:
当地人类专家的总体综合胜率达到了 77.3%,而模型阵营整体表现低迷。在闭源模型中,得分最高的 Gemini 2.5 Flash 仅录得 17.1% 的总体成功率;在开源阵营中表现较好的 Qwen2.5-VL-32B-Instruct 同样难以应对长距离复杂规划,多项子任务的成功率跌入个位数。
模型在不同任务上的表现呈现出极大的不均衡。在基于图像的地标搜索中,由于目标建筑特有的红蓝立面配色、角落外形提供了直接的视觉对齐锚点,强模型尚能展现出一定的线索追踪能力。然而,在涉及地图导航、目标计数以及关系空间推理时,大模型几乎全线溃败。
深入错误归因分析可以发现,各模型在 360CityArena 中的失利原因主要集中在五大维度:感知错误(Perception)、接地点位偏差(Grounding)、规划失误(Planning)、探索停滞(Explore) 以及 动作执行冗余(Action)。在需要构建全局心智地图的复杂场景下,多模态模型表现出严重的“短视”现象。它们极易被局部视线范围内的无关视觉线索误导,在岔路口反复打转、陷入死循环探索,或是过早断言目标不存在并草草终止任务。
惊人的反常:为什么提供了地图定位,模型反而变笨了?
在通常的直觉中,如果在智能体探索过程中始终在输入中附带一张标有当前坐标与朝向的小地图,它的导航与推理成绩理应大幅改善。然而,研究团队在进行消融对比实验时,却观察到了一个耐人寻味的现象:显式注入自定位信息,不仅未能在各任务中带来普适的性能增益,甚至在某些关键维度上诱发了断崖式下跌。
在环境理解类别中,当智能体拥有自身定位小地图后,基于文本的地标搜寻准确率直接从 24.0% 跌落至 16.0%;在空间推理中,关系空间推理任务的准确率更是从 48.0% 剧烈滑坡到 32.0%;而在地图导航和视觉语言导航(VLN)这类强依赖路线规划的任务里,增加定位信息所带来的改观几乎微乎其微。
这一看似矛盾的数据,实际上直指当前视觉语言大模型的一个底层认知死穴:抽象的俯瞰拓扑先验(Map Prior)与具身的第一人称连续视觉感知(Egocentric Stream)之间,存在严重的表征对齐断层(Map-to-Visual Alignment Gap)。
当大模型被同时灌入带有红点朝向的二维电子地图截图和来自真实街景的 360 度环视图像时,它往往缺乏跨坐标系的空间变换能力。模型难以将二维地图上的“右前岔路”精准映射到当前被招牌、行人和车辆遮挡的三维路口。更为致命的是,这种多模态输入的增多反而分散了模型的注意力注意力机制往往过度聚焦于解析低分辨率的静态地图图层,导致智能体忽略了第一人称画面中极具辨识度的真实物理路标。这种“先验信息反噬实景感知”的失效模式,为未来空间对齐模块的设计敲响了警钟单纯通过多模态拼接提供定位提示是不够的,模型必须显式学习自顶向下地图表征与自底向上自我中心感知之间的几何映射。
街区拓扑带来的局限与未来演进
作为首个将真实全景视频连通图系统化引入城市级具身智能评测的工作,360CityArena 的创新意义在于它在可控的算力开销下,把极度拟真的动态物理世界街景完整提供给了研究界。
但这种技术方案也带有不可避免的固有权衡:
-
探索自由度的受限:由于整个世界是由预先采集的 602 个 360 度视频段落拼接而成的位姿图,智能体只能沿着已拍摄的轨迹行进,无法做到完全自由的三维连续位移,也不支持对场景内物体的真实物理交互(例如推门或移开障碍物)。跨越轨迹接缝处的瞬间跳跃虽然在统计上仅占总动作的 11.3%,且未引起模型决策的系统性崩溃,但依然与物理世界的平滑连续存在微小差异。
-
区域多样性尚显单一:当前的基准全部集中在东京秋叶原这一个特定的商圈环境中。秋叶原具有密集的高层建筑、繁复的二次元看板广告与特有的街道规整度,智能体在此表现出的空间推理缺陷能否直接泛化至欧洲的古老曲折巷道或北美的网格化街区,仍有待在更具地域多样性的多城市拓扑中进一步验证。
无论如何,360CityArena 抛出的答卷足够发人深省:在看似被各类多模态评测刷榜攻陷的今天,将大模型拉到真实的城市十字路口,让它像一名普通人那样辨识方位、穿行街区,其能力依旧处在极为稚嫩的初级阶段。东京大学团队提出的这个具备高拟真度、高复杂度与明确几何约束的测试环境,不仅为评估下一代具身大脑立下了一道严苛的度量衡,也指明了从单纯的“读图答题”迈向“空间几何对齐与长程时空规划”的技术演进方向。