AndroidReality:换个字体就失灵?手机Agent鲁棒性评测与TTIR自省机制
AndroidReality: How Far Are Mobile Agents from the Real World?
在各类基准测试榜单上,移动端智能体(Mobile GUI Agent)展现出的能力往往令人惊叹:给定一个指令,多模态大模型能够自动识别屏幕元素、点击滑动、填写表单、完成跨应用交互。然而,任何尝试把这类 Agent 真正部署到真实手机环境中的开发者,几乎都会遇到同一种落差——在标准测试集里游刃有余的 Agent,在现实设备上面对一个突然弹出的广告、字体稍大的排版、或者一次轻微的界面卡顿,就可能陷入死循环甚至彻底迷失。
ArXiv URL:https://arxiv.org/abs/2608.07775v1
造成这种脱节的核心原因,在于现有的评测基准普遍默认了一个过于“干净”的乌托邦世界:界面排版永远标准规范,每次点击必定瞬时生效,系统状态流转永远确定,中间没有任何通知和弹窗干扰。但真实的移动操作系统是一个高度不确定且充满动态噪声的开放环境。
来自亚利桑那州立大学(Arizona State University)与独立研究者的最新工作提出了 AndroidReality。该工作没有止步于笼统地感叹“现实很残酷”,而是从马尔可夫决策过程(MDP)的形式化视角出发,将真实世界中五花八门的界面异质性系统性地拆解为状态(State)、转移(Transition)、动作(Action)三个维度的扰动注入框架。评测结果不仅彻底打破了移动 Agent 在理想环境下的性能滤镜,更指明了现有视觉语言模型在手机操作中的致命死穴。基于这些发现,研究者提出了一种无需重新训练的测试期自省恢复机制 TTIR,仅靠运行时诊断即可在扰动与干净场景下分别削减 17% 与 20% 的失败任务。
从理想基准到扰动 MDP:如何量化真实世界的混乱?
目前的移动端 Agent 评测(如主流的 AndroidWorld 等)大多是在一个确定且静止的单体 MDP 下进行的。在形式化定义中,交互过程可以写作 $\mathcal{M}_{0} = (\mathcal{S}, \mathcal{A}, \mathcal{T}, \mathcal{R}, \gamma)$。Agent 观测到干净的屏幕状态 $s_t$,执行动作 $a_t$,系统按照既定转移概率 $\mathcal{T}(s_t, a_t)$ 严格前进到下一帧,并根据任务目标给出反馈 $\mathcal{R}$。
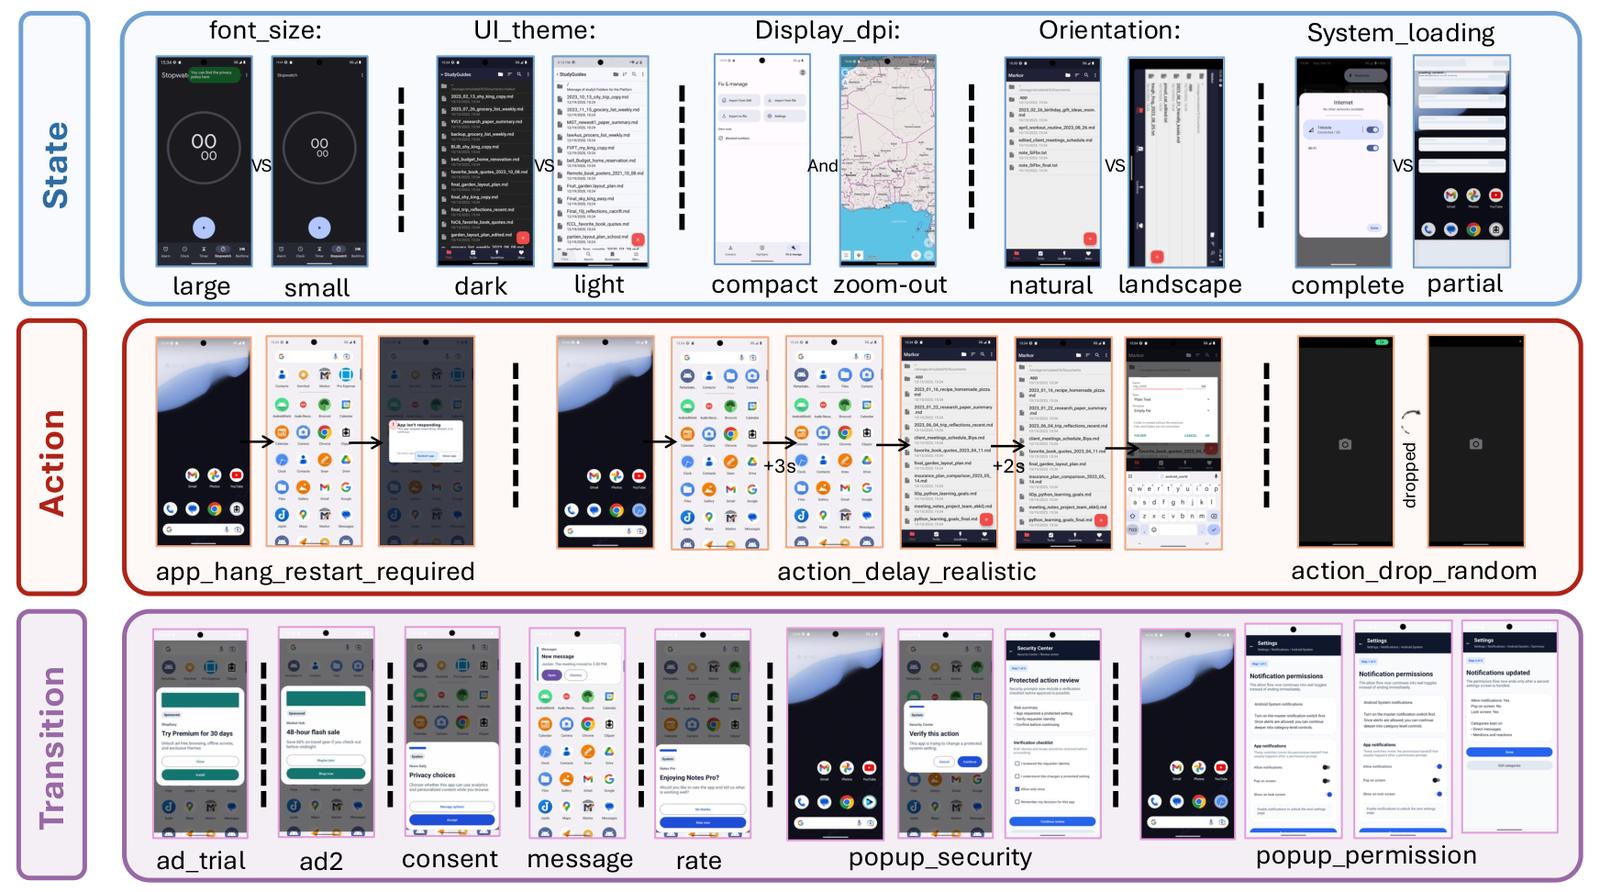
但现实部署面对的根本不是单一的 $\mathcal{M}{0}$,而是一个以相同任务语义为核心、但在各个要素上发生形变的扰动族 $\widetilde{\mathcal{M}}{c,\theta}$。AndroidReality 的核心切入点,就是在这套标准交互循环中插入一个受控的拦截扰动层(Perturbation Wrapper),将真实环境中的异质性严格映射到 MDP 的三个组成部分:
\[s_{t+1} \sim \widetilde{\mathcal{T}}_{\theta}(s_t, \phi^A_{\theta}(a_t)), \qquad \tilde{o}_{t+1} = \phi^S_{\theta}(s_{t+1})\]在这套形式化框架下,现实中的各类异常被划分为清晰的三大轴线:
第一类是状态级扰动(State-level, $\phi^S$)。它并不改变系统的底层功能和任务逻辑,只改变呈现给 Agent 的观察表象。这包括系统字体放大、切换深色主题、改变屏幕显示密度(DPI)、横竖屏旋转,以及网络慢速导致的骨架屏(Skeleton screen)。在人类眼里,“字体变大”只是排版微调,任务目标毫不受损;但对 Agent 而言,整个视觉画面的空间拓扑已经完全重构。
第二类是转移级扰动(Transition-level, $\widetilde{\mathcal{T}}$)。它直接介入操作系统的状态转移链路,在执行常规动作后插入意料之外的中间状态。典型的真实场景包括:刚点击应用就跳出的新版本更新提示、试用订阅推广弹窗、权限申请授权页、系统通知浮窗或隐私政策确认单。Agent 必须识别出这些状态属于“主线剧情之外的插曲”,并在解除异常后重回正轨。
第三类是动作级扰动(Action-level, $\phi^A$)。它破坏了 Agent 预期的动作与底层实际执行动作之间的一对一映射。例如,点击动作由于系统负载过高被随机丢弃(Dropped Action)、执行产生了数十秒的延迟(Action Delay)、界面进入无响应假死状态(App Hang)等。它考验的是 Agent 能否感知“自己的操作并未生效”并主动做出补救,而不是盲目假设每一击都击中了目标。
通过这套参数化且可复现的注入机制,AndroidReality 将基准测试从单一的“成功率百分比”升格为可以归因到具体 MDP 交互环节的鲁棒性体检。
评测冲击波:谁才是手机 Agent 的头号杀手?
研究团队选取了涵盖 2B 到 32B 参数量的 8 个代表性开源 GUI 专用 Agent(包括 GUI-OWL、UI-TARS 及其升级版本)进行全面压力测试。评测给出的结论既出人意料,又切中要害。
一个最直观却违反直觉的发现是:对几乎所有模型打击最严重、最均匀的,并非复杂的弹窗广告,而是微小的状态级扰动。
当研究人员仅仅调整了系统字体大小、切换了系统主题或稍微旋转了屏幕角度时,所有模型的任务成功率均出现了断崖式下滑。背后的病理分析表明,当前的绝大多数多模态 Agent 在坐标定位(Grounding)时,高度依赖于预训练和监督微调数据中反复见过的“标准空间排布”。一旦字体变大导致按钮换行、或者屏幕旋转使坐标整体漂移,模型就会表现出极强的“空间刻舟求剑”倾向——即便当前截图中元素已经下移,它依然会自信地向原本记忆中的绝对坐标发出点击指令,并且在点击落空后,继续原地盲目重试相同的错误坐标,完全丧失了基于当前视网膜级观测进行动态重定位(Re-grounding)的能力。
相比之下,动作级扰动造成的影响反而最小。这倒不是因为模型掌握了多么高超的容错机制,而纯粹是一个“巧合”。现有的自回归 Agent 都有一个基本的默认策略:当上一轮动作被系统吞掉或延迟未响应时,屏幕在下一帧往往没有任何变化。Agent 看到画面没变,往往会自然而然地选择“再按一次”。这种缺乏深思熟虑的惯性重试,在客观上掩盖了短时间的动作丢弃与网络卡顿。
而在转移级扰动上,模型之间的分化被拉到了最大。模型成功率的绝对跌幅从仅仅 $2.27$ 个百分点一直延伸到接近 $30$ 个百分点。面对弹窗和系统通知,不同 Agent 的行为逻辑截然相反:较聪明的 Agent 能够识别出这是任务无关的干扰项,点击叉号或空白处关闭后继续做任务;而大量 Agent 会直接“认贼作父”,把原本弹出的无关问卷当成新的任务目标,深陷在多步弹窗的交互流程中,直到步数预算彻底耗尽。
更隐蔽但也更致命的现象是目标记忆漂移(Goal Memory Drift)。在很多失败案例中,Agent 确实成功关闭了更新弹窗,表现得十分冷静。然而,一旦干扰解除,重新面对应用主界面时,它却已经“忘了自己是谁、原本要做什么”。有的 Agent 会突然决定重新从第一步开始跑,有的则跳转到完全错误的子目标,甚至直接认为任务已经完成而提前退出。一次短暂的注意力打断,彻底击溃了长上下文中的工作记忆(Working Memory)。
四类典型失效模式: Agent 为何屡屡碰壁?
通过对所有失败轨迹的逐帧截图、动作日志和思维链(Reasoning Traces)进行细致的病理切片,研究者将移动 Agent 在真实扰动下的崩溃过程提炼为四种高频失效模式。
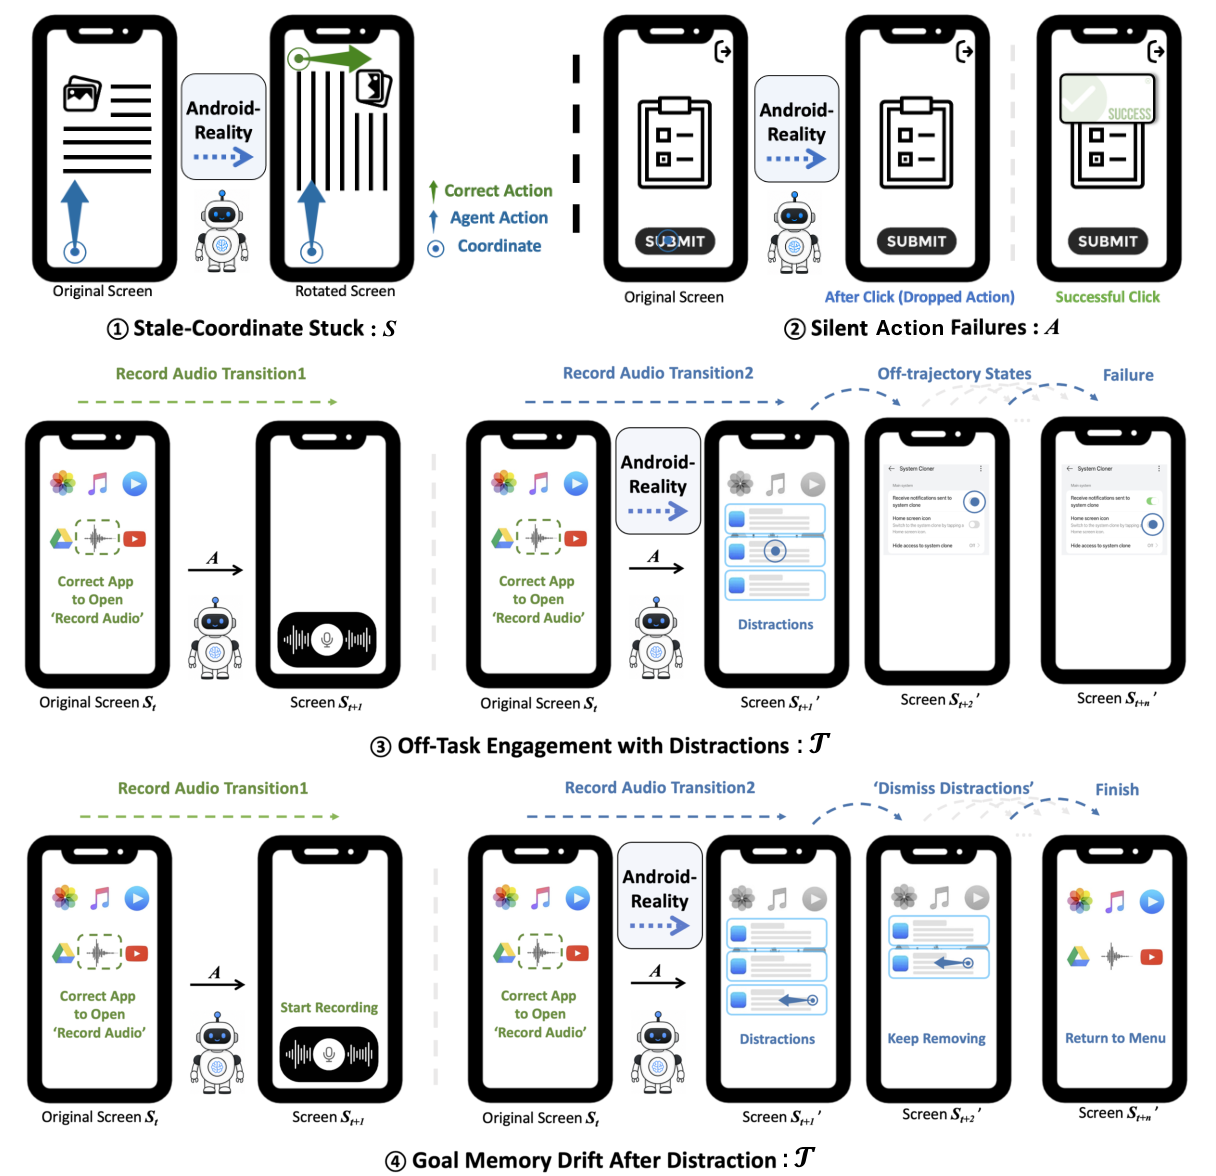
这四种模式清晰地揭示了当前系统设计上的认知缺陷:
-
卡死与死循环(Stuck-loop Behavior):Agent 在面临排版偏移或无效交互时,往往缺乏对“历史动作失败”的显式感知。模型在第 $t$ 步点击失败后,其生成的下一步理由依然与上一轮如出一辙,在毫无变化的界面上周而复始地点击同一个空白像素,直至超出最大交互轮次。
-
无效动作无感知(Unsatisfied Action Effects):当系统发生卡顿、网络延迟或文本输入框未被正常激活时,Agent 发送的
type或click并未在界面上产生预期效果。但由于缺乏动作前后的对比检验,模型单方面假定操作已经生效,并自顾自地迈向后续步骤,导致全盘皆输。 -
任务外元素干扰(Off-task Interference):在遇到促销横幅、权限索取等过渡状态时,模型的多模态注意力被高饱和度、高对比度的干扰组件吸走,无法将其判定为障碍物,反而顺应干扰界面的指引执行了偏离任务的操作。
-
目标记忆漂移(Goal Memory Drift):如前所述,即使模型成功排除了异常界面的干扰,由于多模态注意力被中间插入的无关观察和多轮交互严重稀释,导致从弹窗返回主路径后,丧失了在原始全局规划中所处的精确阶段感知。
这四种失效模式本质上指向同一个底层症结:现有 Agent 严重缺乏在“行动前”对“当前状态是否健康”的元认知与自省能力(Self-Monitoring)。它们是一套线性的“看图-说话-输出动作”管道,只要屏幕有输出,就假定一切在按剧本推进。
TTIR:免训练的测试期自省恢复机制
如果每一次环境微调都需要重新收集带噪数据、重新对大模型做端到端微调,落地成本将不可承受。既然病根在于“缺乏行动前的自省”,能否在推理阶段直接给 Agent 补上一套质检逻辑?
研究团队给出的答案是 TTIR(Test-Time Introspective Recovery,测试期自省恢复)。这是一个完全即插即用、无需训练参数、与具体模型解耦的轻量化框架。
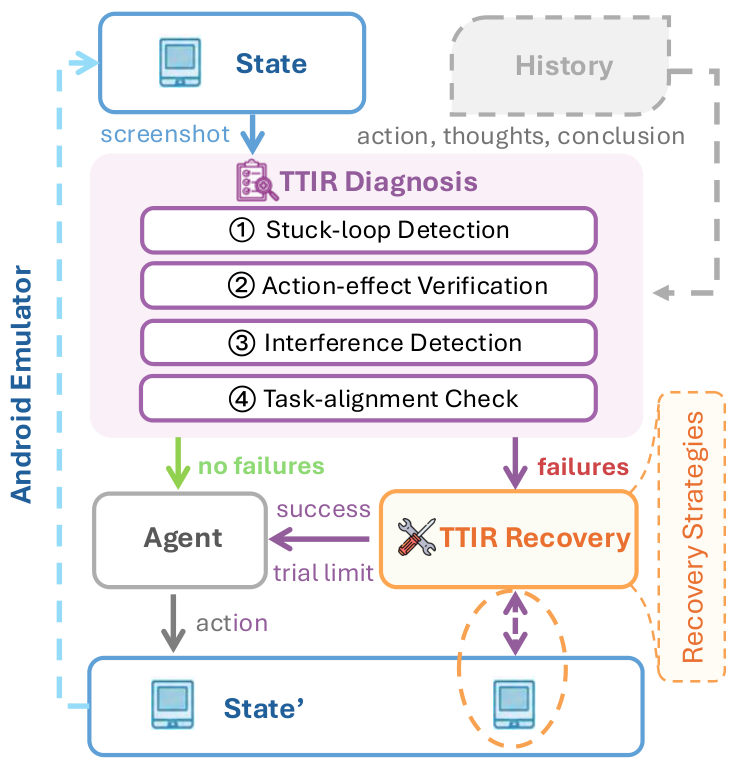
TTIR 的核心逻辑非常精妙:它并不推翻原本的主 Agent,而是在每个决策步开始前,插入一个“诊断-恢复”的轻量化审查环节。审查者(Diagnoser)复用主 Agent 本身的视觉语言模型,仅通过结构化 Prompt 驱动,围绕上述四类失效模式对当前状态和短期动作历史进行打分:
-
界面是否连续多步没有任何实质变动(检测死循环)?
-
上一步期望生效的结果是否呈现在最新截屏中(检测未生效动作)?
-
当前界面是否属于非任务主路径的临时阻断物(检测任务外干扰)?
-
在排除异常后,当前画面是否仍落在任务的有效工作上下文中(检测目标对齐)?
在每个交互步,诊断模块输出一个结构化的 JSON 评估。只要任何一个维度被亮起红灯,系统就会立刻挂起主 Agent 的常规行动,转而调用恢复 Agent(Recovery Agent)进入一个有步数上限的局域修复阶段。
在修复阶段,恢复 Agent 接收到的 Prompt 极其聚焦:它不会被要求“完成整个手机任务”,而是被指派一个单一明确的修补目标——例如,在检测到死循环时,要求其强制探索除当前坐标外的滑动或退回操作;在检测到目标对齐丢失时,要求其执行“重定向恢复”,通过返回桌面或应用切换器重新找回目标 App 的有效上下文。一旦诊断模块确认异常状态解除,控制权便无缝交还给主 Agent。
这种设计的优势在于其非侵入性:主模型完全无需感知底层的补丁机制,依然可以沿着原来的规划逻辑思考;而外层的诊断环路则像一个经验丰富的监考老师,在考生思维卡死或走错考场时,及时敲敲桌子将其拉回正轨。
实验与启示:真实鲁棒性不仅是“防守”,更是核心泛化力
为了验证 TTIR 的成效,研究人员将其接入到 GUI-Owl-7B 模型中,分别在受到真实扰动的 AndroidReality 和完全干净的 AndroidWorld 原始基准上进行了严谨的对照实验。
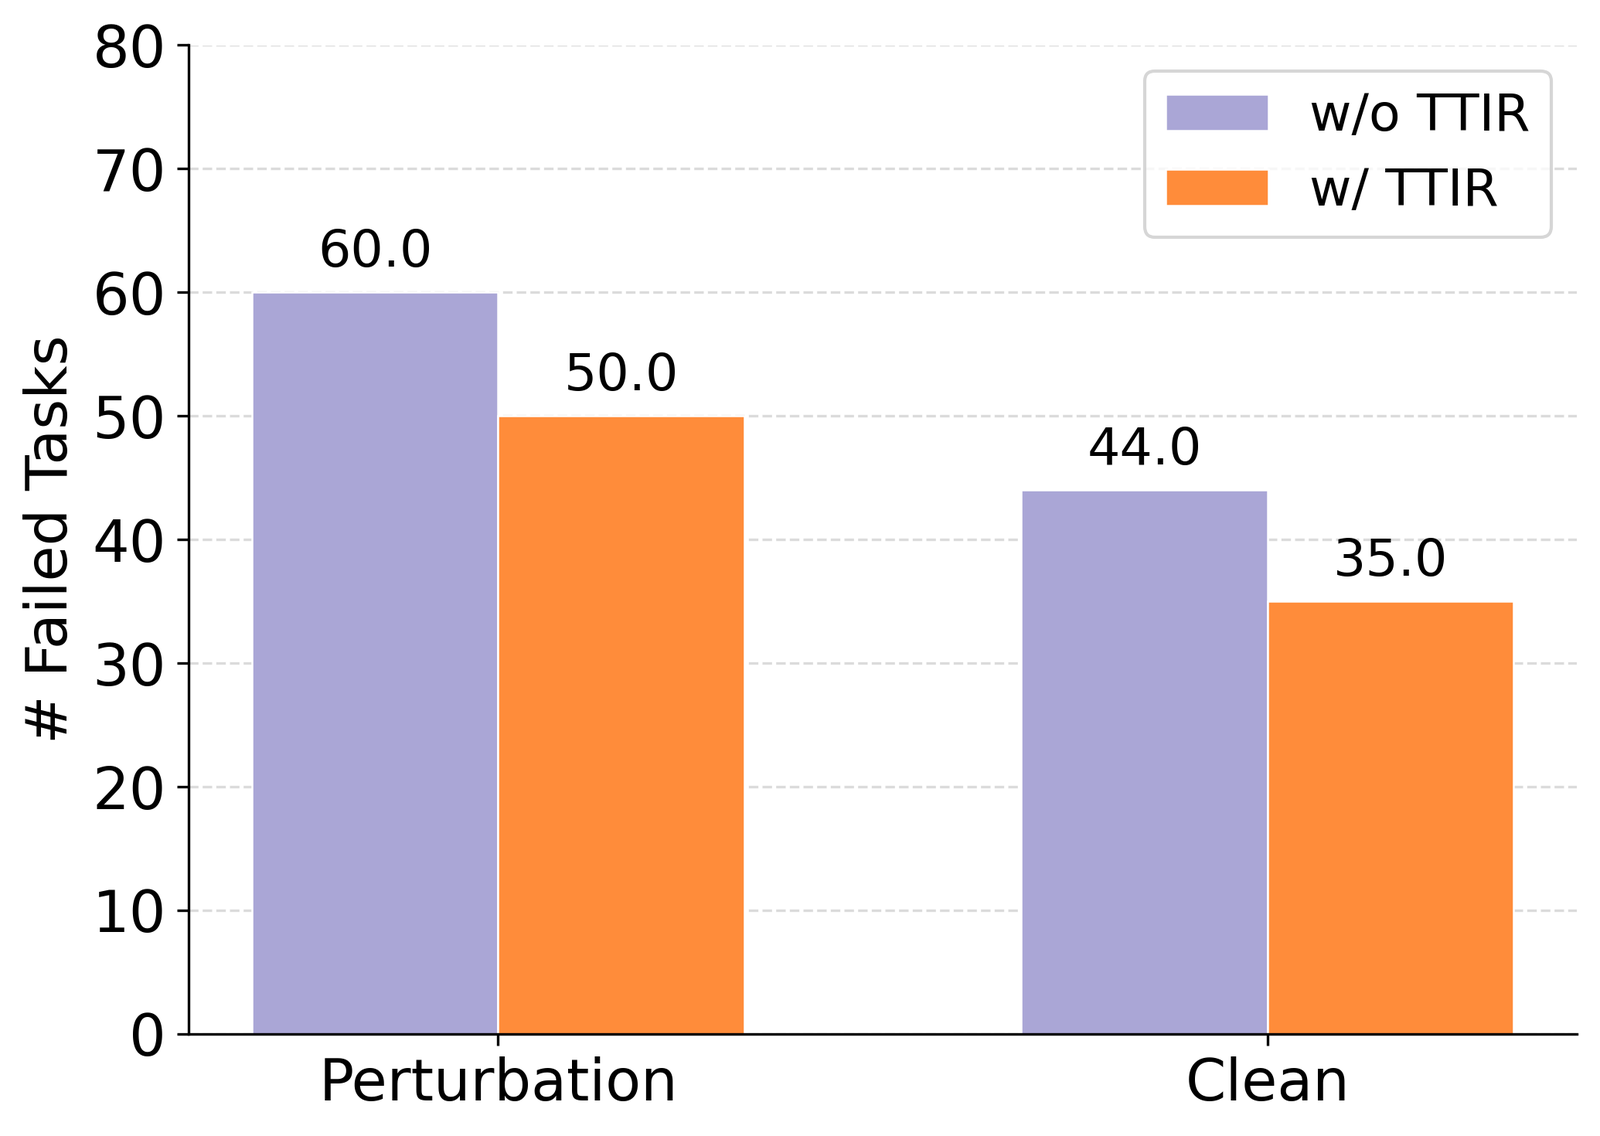
实验数据展现出极其有说服力的结果。在各类扰动密布的环境下,TTIR 使得失败的任务数从原本的 60 个直接下降到 50 个,相对失败率降低了 17%。这证明了定向的四维自省机制能够精准捕获并拆解现实中的大部分干扰。
然而,更具启发性的数据出现在没有注入任何额外干扰的纯净基准(Clean Setting)中。在这个原本被认为不存在异常的基准里,接入 TTIR 同样使原本失败的任务从 44 个降低到了 35 个,相对失败率降幅高达 20%。
这一结果有力地反驳了一个常见误区——即“抗扰动研究只是为了解决长尾边缘案例(Edge Cases)”。实验表明,所谓的四类失效模式,根本不是人为制造扰动后才产生的特有产物,而是当前多模态 Agent 在规划逻辑、坐标泛化和工作记忆上普遍存在的固有内伤。哪怕在最规整的官方应用界面里,模型自身动作生成的微小偏差,也会内生出“点击未命中”、“陷入死循环”等状态。AndroidReality 引入的扰动,实际上是一面高倍放大镜,将模型在平静水面下潜藏的结构性缺陷强行逼出了水面。
总结:迈向工业级手机 Agent 的分水岭
长期以来,移动 Agent 领域弥漫着一种“唯基准分数论”的虚假繁荣。许多模型依靠在特定分辨率、特定主题的单一切片上死记硬背坐标分布,刷出了看似逼近人类操作的成功率,但在实际交付时却脆弱不堪。
AndroidReality 的价值不仅在于它提供了一个更为严苛的跑分平台,更在于它奠定了一套以马尔可夫决策过程为底座的鲁棒性分析框架。它迫使研究者们正视:界面的细微样式重组、系统的瞬时迟滞、主线之外的偶发弹窗,并非可以忽略的系统噪声,而是真实人机交互中不可分割的核心特征。
从单纯追求在静态、可预测的干净沙盒中“一次性做对”,转向在开放、带噪、动态变化的现实系统里具备“自省感知”与“自主容错恢复”能力——这篇工作所指明的,正是手机 Agent 从学术 Demo 蜕变为真正可用助理的必经之路。