TIPEX:北邮提出大模型双层推理并行,GAIA耗时降40%且准确率达39%
A Two-Tier Perspective on Inference-Time Parallelism in Multi-Agent LLM Systems
在复杂的任务规划与执行场景中,基于大语言模型(LLM)的多智能体系统正逐渐成为通用解决范式。通过组装不同角色、配备代码解释器和网页浏览等工具,智能体团队展现出了惊人的复杂问题拆解能力。然而,现有多智能体框架在推理阶段的执行表现往往不尽如人意。核心症结在于串行执行带来的长临界路径:智能体之间不断往返对话、调用工具、将新的中间结果追加进持续膨胀的上下文窗口中。这种瀑布式的串行流程不仅让系统耗费极长的时间,还极易引发错误累积与上下文稀释。
ArXiv URL:https://arxiv.org/abs/2608.05791v1
为了打破这种效率瓶颈,并行化执行成了最直观的技术演进方向。来自北京邮电大学的研究团队在其最新工作中,将多智能体系统的推理时并行(Inference-Time Parallelism)抽象为一个双层决策空间,并提出了名为 TIPEX(Two-tier Inference-time Parallel EXecution)的可控执行框架。该框架将任务级解空间探索的“副本并行”与实例级计算调度的“结构并行”统一起来,彻底解耦并协同管理了智能体的推理执行。
在具有高挑战性的 GAIA 基准测试中,TIPEX 展现出显著的性能提升:在 Level 2 任务上将基线准确率从约 26% 提升至最高 39%,同时端到端实际物理耗时(Wall-clock Time)缩减了 15% 至 40%。这项研究揭示了一个关键技术现实:在多智能体系统中,单纯堆叠并发量并非灵丹妙药,副本级探索与结构级调度之间存在高度非线性的交互效应,中等复杂度任务能从中获取最大红利,而过于激进的内部并行反而会因冗余执行与信息碎片化导致准确率崩塌。
串行困境与被割裂的并行尝试
多智能体系统在处理高复杂度、长周期任务时,通常依赖动态交互来逐步逼近最终答案。以微软开源的代表性框架 Magentic-One 为例,协调器、Web 浏览智能体、代码执行智能体和文件分析智能体交织工作,完成一个任务常常需要数十个轮次的模型调用和外部工具交互。在这种完全串行的工作流中,前一个操作的输出作为后一个操作的输入,形成了极其漫长且脆弱的执行临界路径。任何一步工具调用的超时或 LLM 的轻微幻觉,都会顺着执行链条向下传导并无限放大。
针对这一困境,此前业界探索过不同的并行化解法,但这些探索普遍呈现割裂状态。一类方案聚焦于“任务层级”的多实例探索,比如让多个平行的智能体团队独立跑出完整解题轨迹,再做集成或多数投票,例如 M1-Parallel;另一类方案则聚焦于“轨迹内部”的结构拆解,将单个智能体工作流分解为可并发的有向无环图(DAG),让没有数据依赖的工具调用或子任务并行执行,例如 LLMCompiler 和 DynTaskMAS。
然而,现有工作往往将这两类优化手段孤立看待。这就带来了一系列未被解答的工程与理论疑问:如果同时在宏观轨迹层面和微观工具调用层面引入并行,两者是简单地优势叠加,还是会互相干扰?增加探索样本数带来的延迟激增,能否被内部图调度的并发收益完全抵消?在有限的算力和 Token 预算下,二者究竟应该如何配比?缺乏一个统一的执行语义和形式化框架,开发者很难为多智能体推理制定出最优的调度策略。
TIPEX 的解题思路:解耦与双层统一
针对上述挑战,研究团队构建了 TIPEX 框架,将多智能体系统的推理并行形式化为两层解耦但又紧密协同的决策流程。这种双层抽象不仅厘清了各层级的系统职责,也让研究人员能够在保持底层智能体逻辑不变的前提下,自由拼装与评测各种调度策略。
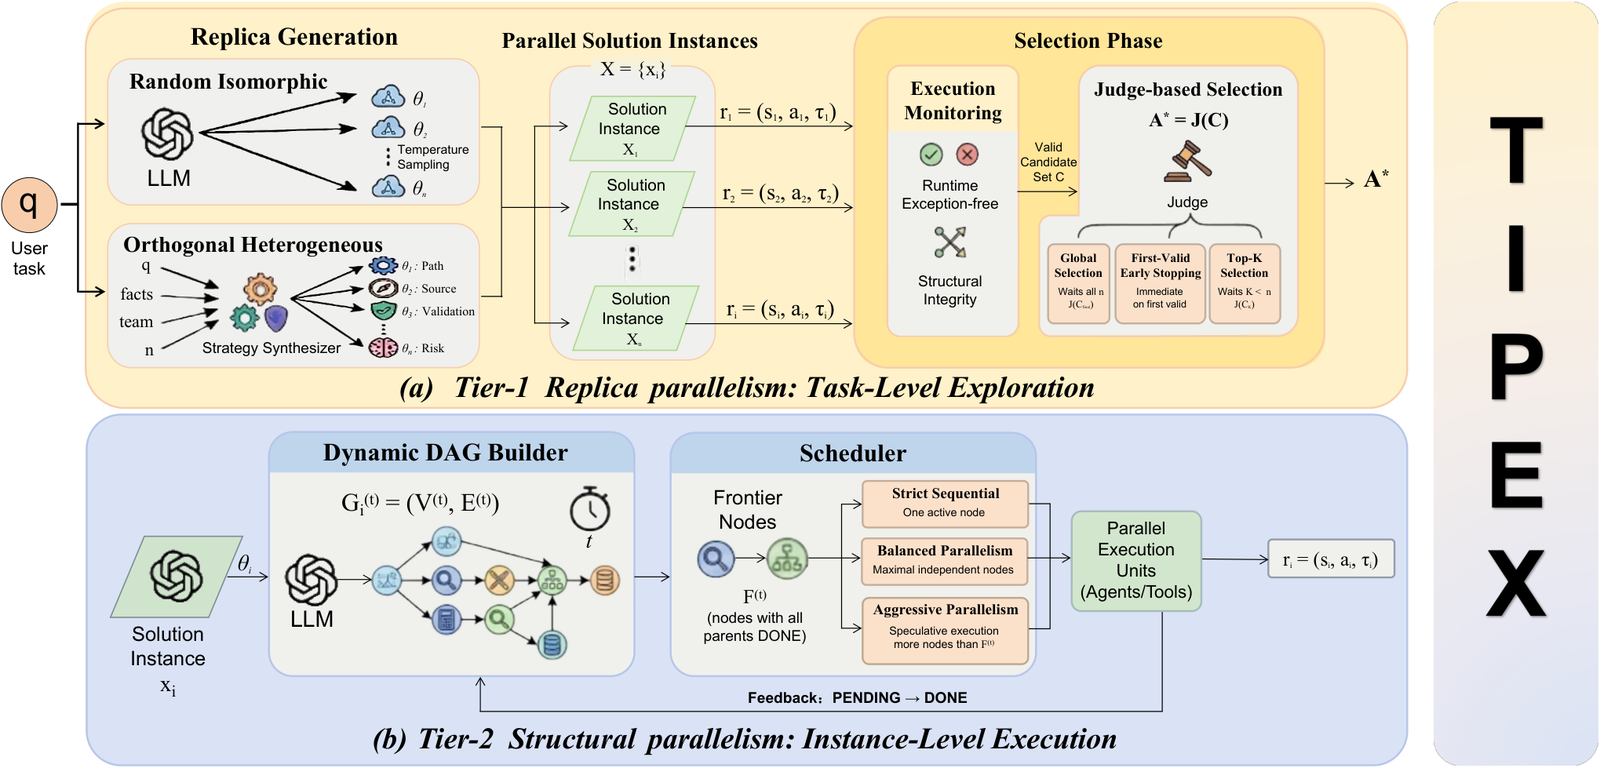
第一层被称为副本并行(Replica Parallelism),其核心职能是“空间广度探索”,在任务层级探索多条完整的解题路径,以此对抗单个大模型在复杂多步推理中的偶发性失败。副本并行被拆分为两个明确的子阶段:方案生成与方案仲裁。
在方案生成阶段,传统做法通常采用随机同构生成(Random Isomorphic Generation, RIG),即让所有副本使用完全相同的系统提示词,仅仅依赖解码温度 $T > 0$ 带来的随机采样来生成不同路径。这种方式本质上是自一致性采样(Self-Consistency)的变体,往往只能覆盖模型固有概率分布中的主流模式。为此,TIPEX 提出了更为先进的正交异构生成(Orthogonal Heterogeneous Generation, OHG)。OHG 基于元推理机制,在启动任务前,系统会显式分析问题结构、已知事实与可用团队能力,主动合成出一组语义正交的求解策略集:
\[\{\theta_{1}, \dots, \theta_{n}\} \leftarrow \text{Synthesize}(q, \text{facts}, \text{team}, n)\]这里的“正交”并非严格的数学正交,而是方法论上的异质化。系统会强制各个副本在求解路径、信息源偏好、校验机制甚至风险偏好等维度形成差异化分工。比如在面对复杂的检索推理题时,一个副本偏向先代码后检索,另一个副本偏向深度逆向验证。这种结构化的异构设计从源头上保障了解题路径的多样性与互补性。
在随后的方案仲裁阶段,系统引入了两步走的鉴别机制,即“有效性过滤”加“对比优选”。不同于必须等待所有 $n$ 个副本全部执行完毕才评判的全局选择(Global Selection, GS),或者只看谁先跑完就选谁的首个有效早停(First-Valid Early Stopping, FVES),TIPEX 重点设计了 Top-$K$ 选择(Top-$K$ Selection, TKS)策略。TKS 策略只需等待任意 $k$ 个有效候选解产出(默认 $k = \lceil n/2 \rceil$),便立即触发判别模型进行横向对比与选拔,从而在解集质量与等待延迟之间取得了极佳的折中。
第二层则是结构并行(Structural Parallelism),其核心职能是“时间深度压缩”。在单个解题副本内部,系统通过将原本串行的智能体与工具调用转换为动态有向无环图(Dynamic DAG)调度,在运行期动态识别并释放无依赖子任务的并发潜力。每个副本在时间 $t$ 维护一个执行图 $G(t) = (V(t), E(t))$,其中节点代表单次 LLM 推理或工具调用,边代表因果数据依赖与时序约束。调度器持续计算就绪节点集合:
\[F(t) = \{v \in V(t) \mid v \text{ 具备因果就绪条件}\}\]结构并行不仅负责异步并发拉起多路工具,还必须处理运行期的部分可观测性与局部节点故障。若出现工具调用失败,系统支持有界重试,若硬依赖断裂则局部截断相关链路,而其他互不干扰的 DAG 分支依然沿着就绪前沿顺畅推进。
根据并发调度的激进程度,结构并行被划分为严格串行(Strict Sequential, SS)、平衡并行(Balanced Parallelism, BP)以及激进并行(Aggressive Parallelism, AP)。整个 TIPEX 框架基于 Python 异步 I/O 事件循环构建,确保了延迟指标的降低来自算法级任务解耦,而非底层阻塞调用的虚假优化。
实验基准与核心发现:GAIA 上的全面验证
为了验证推理并行的真实表现,团队选择公认最具挑战性的通用 AI 助手基准 GAIA 作为实验平台。GAIA 涵盖多模态推理、网页浏览、复杂检索与代码执行等复合场景,并严格划分为 Level 1 到 Level 3 三个递增的难度梯度。实验以成熟鲁棒的开源框架 Magentic-One 作为骨干基座,基模型统一使用阿里通义 Qwen-Plus。系统通过分层重复采样来压制实验方差:Level 1 和 Level 2 任务重复执行 3 次,长周期的 Level 3 任务重复执行 5 次。
主实验涵盖了三个关键维度的考核:准确率(Accuracy)、实际运行物理时间(Wall-clock Time)以及 Token 消耗量。为了彻底解耦“路径生成能力”与“判别选择能力”,实验还引入了理想判别准确率(Oracle Accuracy)作为衡量上限,即只要 $n$ 个副本中存在至少一个正确答案,即视为 Oracle 成功。
从主实验数据来看,推理时双层并行带来了一组高度明确的性能杠杆:它本质上是用 Token 消耗的上升,来换取任务准确率的跨越式跃升与端到端物理延迟的大幅下降。
在基线 Magentic-One 上,由于严格遵循串行执行,Level 1 任务准确率为 43.1%,耗时约 230 秒;Level 2 任务准确率仅为 26.2%,耗时约 320 秒。而在切换为 TIPEX 的正交异构生成结合 Top-$K$ 选择(OHG + TKS,采用 $n=3$、平衡并行 BP)后,Level 1 准确率攀升至 56.9%,耗时缩减至 190 秒以内;Level 2 准确率更是大幅跃升至 38.8%,耗时被直接腰斩压缩至 170 秒至 200 秒区间。这意味着在没有更换底层基础模型的前提下,纯粹通过推理时执行架构的重塑,系统就在极难的基准上取得了十几个百分点的准确率提升,同时速度加快了近一倍。
深入对比不同策略组合可以发现,OHG 与 TKS 的协同展现出了统治级优势。如果采用传统的同构采样 RIG 搭配全量等待 GS,系统不仅极其耗费 Token,而且延迟常常居高不下;而若采用粗糙的首个有效早停 FVES,虽然耗时极低,但由于智能体只要给出一个看似合规的答案就草草收场,导致在复杂的推理步骤中频频翻车。相比之下,OHG 借助元推理预先生成互补的策略,使得模型在最终选拔时候选解的区分度极高。数据表明,OHG 模式下的实际准确率与 Oracle 理论上限之间的差距,显著小于同构随机采样 RIG,说明更具质感的解空间探索能极大减轻后置判别模型的认知负荷。
同时,实验也揭示了一个无法回避的残酷现实:判别器质量是释放并行红利的最终天花板。在所有的实验配置中,无论是 Level 1 还是 Level 3,实际落地准确率与 Oracle 理论准确率之间始终横亘着 10% 到 25% 的鸿沟。很多时候,平行的 $n$ 个智能体副本中确实已经跑出了正确的解题路径,但系统在最后聚合阶段的判别模型没能准确挑出它。这表明仅仅把并发做大、把路径铺开还远远不够,推理并行技术要真正落地,必须配备同样高水平的多轨迹横向仲裁与交叉验证模型。
深入剖析:非线性交互与参数的“反直觉陷阱”
为了探明双层并行内部的具体运作机制,研究团队在 Level 2 任务上进行了细致的消融与参数敏感度测试。实验改变了副本数量 $n$(从 1 到 5)以及结构并行的并发等级(SS、BP、AP),结果发现这两层架构之间存在深刻的非加性(Non-additive)交互关系。
首先是关于副本规模 $n$ 的收益递减。直觉上,探索的路径越多,覆盖正确答案的几率越高。但实验数据表明,将副本数从 $n=1$ 提高到 $n=3$ 时,准确率提升非常平稳且显著;然而一旦进一步增加到 $n=5$,准确率的增长几乎陷入停滞,在某些配置下甚至出现微弱下滑,而此时 Token 消耗量却呈现线性暴增。研究团队分析指出,过多的副本会迫使正交生成策略为了追求差异化而衍生出大量低效甚至边缘化的畸形解法,这些低质候选解稀释了优质解的比例,反而严重干扰了判别模型的最终裁决。
其次是关于结构并行的激进程度。很多开发者倾向于认为内部并发越多越好,尽可能压榨异步 I/O 的潜力。但消融实验打破了这一盲目乐观的假设:从严格串行 SS 切换到平衡并行 BP 时,系统的确在保持高准确率的同时大幅削减了运行时间;但当进一步切换为不设节制的激进并行 AP 时,系统的准确率出现了全面崩塌。在 $n=3$ 的配置下,平衡并行能维持近 37% 的准确率,而激进并行却让准确率跌落到了 25% 左右。
之所以出现这种反常倒挂,是因为过度的结构并行打碎了多智能体原有的因果思考流。在激进的图拆解下,多个子智能体在没有充分获取前序上下文细节的情况下就被提前触发,执行了大量无效的搜索或计算;这些过早返回的半成品碎片信息被强行塞入主智能体的记忆池中,不仅引发了严重的冗余执行和调度通信开销,还造成了上下文严重污染,最终彻底破坏了多步推理的连贯性。
任务类型的细分拆解进一步佐证了并行配置必须因地制宜。在处理复杂的代码与网页操作任务时,由于环境交互天然包含清晰的执行分支,结构并行的收益被成倍放大,时间压缩效应最强;而在处理强依赖直觉与全局感知的高难度多模态任务时,内部拆图往往无法理清各维度的隐式依赖,此时提升副本并行数量、依赖外部的多路独立探索反而能带来更扎实的准确率收益。
对未来智能体工程的启示
TIPEX 的研究清晰地划定了推理时并行的适用边界。它向学术界与工业界证明,将推理并行视作单一维度优化的时代已经过去。
推理并行的协同红利存在一个明显的“黄金难度区间”。对于过于简单的任务(如 GAIA Level 1),串行执行本身耗时很短,引入双层并行带来的系统调度、上下文合并以及判定开销,往往会抵消一部分并发收益;对于极其困难、长上下文高度耦合的任务(如 GAIA Level 3),单一模型的单步推理失误率本就极高,单纯依靠外部并发难以扭转乾坤。唯独在具备中等难度、推理链条在数步到十几步之间、且包含适度工具交互的任务上(如 GAIA Level 2),结构并行能够深度吃透并发空间压缩时间,副本并行则能有效兜底单点失误,二者组合释放出最大的系统弹性。
这一结论直接指明了未来多智能体系统的优化重心:构建动态感知的自适应调度器(Adaptive Scheduler)。系统不应该以一套固定的超参数去应对所有请求,而应首先通过轻量级的路由模型,根据输入任务的模态、预期推理步长及用户设定的延迟/预算边界,动态决定生成几个正交副本、采用何等程度的图并发度、以及何时触发提前截断。
在基础大模型单次推理速度遭遇物理极限的当下,从执行调度架构上压榨效率已成为 Agent 系统的兵家必争之地。TIPEX 提供的双层视角不仅是一个具体的算法框架,更为多智能体系统在“准确率—延迟—计算成本”这一三元不可能三角中的精细权衡,提供了一套扎实可靠的形式化方法与工程基准。