AgentPatch:免训练修复被稀释的弱任务,智能体模型合并突破56.6分
AgentPatch: Coarse-to-Fine Weak-Task Repair for Merging Agentic Multimodal Large Language Models
在多模态大模型迈向自主智能体的演进中,单一模型往往难以兼顾所有复杂场景。现实中的研究范式通常走向专业化分工:擅长全网信息检索的多模态搜索模型、精通屏幕像素定位与多步操作的图形用户界面(GUI)模型,以及专注通过图像裁剪、缩放实现细粒度感知的视觉专家模型。若想构建一个无需额外路由、不增加推理延迟的通用智能体,最直接的工程思路是通过模型合并(Model Merging)将多个专家权重融为一体。然而,由中国科学院、鹏城实验室、中山大学及中国科学院大学联合团队指出的一个核心痛点是:现有的模型合并算法在面对长程交互智能体时,往往会遭遇严重的“能力断崖”。
ArXiv URL:https://arxiv.org/abs/2608.06699v1
常规合并算法(如权重平均、任务算术 Task Arithmetic 或 TSVM 等)大多假设各个下游任务的复杂度是对等的、输出是单步静态的。但智能体任务具有极高的状态依赖性。一旦将擅长单步感知的视觉模型与需要长程规划的 GUI 交互模型合并,参数碰撞会造成极其不对称的能力衰减。针对这一困境,研究团队在论文中正式定义了智能体多模态大模型合并任务(Agentic MLLM Merging),并提出了名为 AgentPatch 的免训练“由粗到细”(Coarse-to-Fine)弱任务修复框架。该框架无需反向传播梯度,也不需要在线部署辅助分析智能体,仅凭离线构建的补丁,便让合并后的基座模型在六大多模态与智能体评测基准上的综合得分提升至 56.6,有效弥合了交互决策中的断裂。
静态合并为何在交互智能体上失效
现有的多模态模型合并多聚焦于静态输入输出任务,例如光学字符识别(OCR)、图像问答、图表解析或图文对齐。在这类任务中,模型哪怕丢失了一小部分细粒度特征,往往也只体现为某个属性判断置信度的微调,整体容错率相对较高。但交互式多模态智能体完全不同,其执行依赖动态环境反馈,合并过程暴露出两个尤为严峻的本质矛盾。
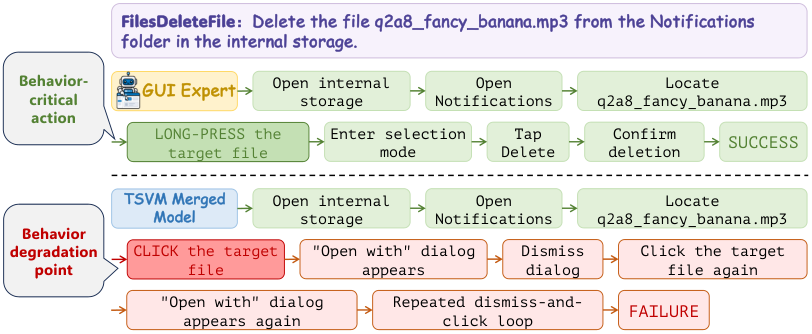
第一个矛盾是非对称能力保留导致的“弱任务退化”(Weak-Task Degradation)。由于不同智能体专家的交互复杂度天然不对称,比如 GUI 操作系统往往需要精确到坐标的操作协议和长程状态转移,其训练参数空间的敏感度远高于通用视觉感知。当使用全局参数平均或无差别的冲突消除策略时,保留难度高的专家信号往往会被参数分布更平缓的专家严重稀释。实验表明,合并后的模型在常规视觉任务上表现平稳,但在需要严格多步交互的 GUI 任务中,性能跌幅最剧烈,沦为合并模型的明显短板。
第二个矛盾是“行为关键遗忘”(Behavior-Critical Forgetting)。在长程决策轨迹中,并非所有步骤的权重都同等重要。一个智能体或许在前十步规划中都与专家表现完全一致,但如果在弹出的系统对话框中,将原本该执行的“长按”误操作成了普通的“单击”,整个环境状态就会立即走向未定义分支,导致后续轨迹全盘崩溃。传统合并算法只在参数范数或方向层面优化几何一致性,根本无法感知这些隐藏在参数背后的、决定整条交互成败的关键行为动作。
由粗到细:AgentPatch 的修复哲学
为了在完全不依赖联合微调的前提下解决上述退化,AgentPatch 并没有试图重写底层的合并底座,而是建立了一套两阶段的渐进式修复管道。整体架构从多个候选合并算子中筛选出稳定的受体骨干,随后实施粗粒度的参数级残差定向补充,最后深入到神经元层面实施精准的行为补丁修复。
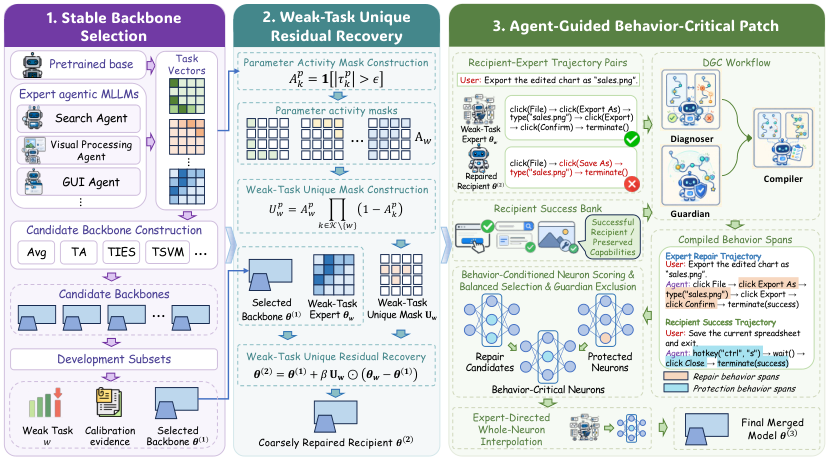
首先,研究团队利用校准集对若干免训练合并算子(如 Task Arithmetic、TIES-Merging、TSVM 等)进行评估,挑选出综合性能最高、方差最可控的合并模型作为受体骨干 $\boldsymbol{\theta}^{(1)}$。同时,通过计算各个专家在合并后的相对退化率,自动识别出退化最为严重的“弱任务”专家 $\boldsymbol{\theta}_{w}$。在后续实验中,GUI 交互专家被一致判定为受损最严重的短板。
接下来是第一阶段的粗粒度修复:弱任务独有残差恢复(Weak-Task Unique Residual Recovery)。如果为了挽救 GUI 能力而简单粗暴地将 GUI 专家的全部任务向量重新叠加回骨干,必然会破坏原本已经融合完好的搜索与视觉能力,造成严重的负迁移。研究团队的做法是:仅定位那些在弱任务专家中发生显著更新、而在其他所有专家中更新幅度均接近于零的参数坐标。
具体而言,对每个专家 $k$ 的任务向量 $\boldsymbol{\tau}_k = \boldsymbol{\theta}_k - \boldsymbol{\theta}_0$,定义显著更新掩码 $A_k^p = \mathbf{1}[\lvert \tau_k^p \rvert > \epsilon]$。弱任务专家独有的参数子空间掩码 $U_w^p$ 则被严格限制为其他专家均未触及的区域:
\[U_w^p = A_w^p \prod_{k \in \mathcal{K} \setminus \{w\}} (1 - A_k^p)\]以此掩码为约束,骨干参数按比例 $\beta$ 注入弱任务特有的更新残差:
\[\boldsymbol{\theta}^{(2)} = \boldsymbol{\theta}^{(1)} + \beta \mathbf{U}_w \odot (\boldsymbol{\theta}_w - \boldsymbol{\theta}^{(1)})\]这一设计巧妙利用了正交与解耦的思想。由于恢复动作只发生在独占坐标上,骨干模型在获得大范围弱任务信号补偿的同时,最大限度规避了对其他专家的参数干扰。
行为级手术:DGC 工作流与守卫机制
粗粒度残差恢复虽稳住了大盘,但仍然无法分辨哪些具体神经元掌控着决定死生的“关键动作”。为了对决定任务成败的微观行为完成精准修复,AgentPatch 引入了第二阶段的核心组件:智能体引导的行为关键补丁(Agent-Guided Behavior-Critical Patch)。
该阶段的核心是由诊断者(Diagnoser)、守卫者(Guardian)和编译器(Compiler)组成的 DGC 离线协同机制。在不接触任何测试集的前提下,研究人员让当前修复模型 $\boldsymbol{\theta}^{(2)}$ 与弱任务专家 $\boldsymbol{\theta}_w$ 在相同的校准任务中并行推演。Diagnoser 负责对比二者的交互轨迹,精准抓取“受体模型失败、而专家模型成功”的分歧点,将专家在关键步上的行为序列提取为修复证据。与激进的修复算法不同,Guardian 机制同时介入,负责搜集受体模型原本就已经表现出色的操作模式、正确的输出语法结构,以及从其他专家继承来的优势行为,将其固化为保护证据。随后,Compiler 将两类证据转化为具有环境和时序标记的 Token 级片段选择器。
有了具体的行为片段,下一步是如何在深层前馈网络(FFN)中定位对应的功能神经元。研究团队利用 Teacher-Forcing 技术在固定轨迹上运行模型,仅记录编译器圈定的 Token 位置处的中间激活。神经元 $j$ 在修复片段上的重要性评分 $c_{\ell r j}^{\mathrm{rep}}$ 同时考虑了其在关键行为上的平均激活幅度以及输出权重矩阵的 $L_2$ 范数影响:
\[c_{\ell r j}^{\mathrm{rep}} = a_{\ell r j}^{\mathrm{rep}} \|\mathbf{W}_{\mathrm{out}}^{\ell, w}[:, j]\|_2\]这个设计偏好那些既在关键决策时刻高度活跃、又具备向后层强力传导表征能力的神经元。
随后,AgentPatch 展现出了极具分寸的工程取舍。为了防止证据丰富的特定环境占据过量编辑配额,筛选过程在各个行为组内独立进行 Top-K 提取。更关键的是守卫排除逻辑:只要一个神经元被判定与受保护的成功行为相关,无论其修复评分多高,都会被强制从候选集 $\mathcal{R}^\ell$ 中剔除:
\[\mathcal{M}^\ell = \left(\bigcup_r \mathcal{R}_r^\ell\right) \setminus \left(\bigcup_p \mathcal{P}_p^\ell\right)\]留存在集合 $\mathcal{M}^\ell$ 中的幸存者才是真正的“行为关键神经元”。针对这些极少数神经元,框架并不采用硬编码覆盖,而是实施软性专家插值:
\[\boldsymbol{\phi}_j^{\ell, (3)} = (1 - \alpha) \boldsymbol{\phi}_j^{\ell, (2)} + \alpha \boldsymbol{\phi}_j^{\ell, w}\]整套流程下来,未被选中的绝大部分网络权重纹丝不动,既保全了通用模型的推理大局,又在最小干预尺度下找回了决定性的动作偏置。
跨越六大基准的多维度验证
为了验证 AgentPatch 的真实效力,实验统一选取开源多模态基座 Qwen2.5-VL-7B,并引入三款在各自领域极具代表性的下游专家模型:针对多模态搜索强化的 MMSearch-R1-7B、面向移动与桌面 GUI 交互的 GUI-Owl-7B,以及专长于细粒度主动视觉操作的 DeepEyes-7B。
评测矩阵全面覆盖了当前智能体面临的三种截然不同的交互范式:测试多模态检索与证据合成的 MMSearch 与 FactualVQA;考察端到端多步环境操作的 AndroidWorld(移动端)与 OSWorld(桌面端);以及验证主动缩放、裁剪等视觉处理能力的 V*Bench 与 HR-Bench 8K。
基准对照实验呈现出极为鲜明的结果。单纯依靠传统的 TSVM 合并算子时,模型整体平均分仅为 54.5,其中 GUI 维度的两个基准均分被严重拉低至 38.5。在引入 AgentPatch 之后,合并模型的整体平均得分提升至 56.6,超越了 Task Arithmetic、TIES、Iso-CTS 及 DC-Merge 等一众先进合并方案。尤其在受损最严重的 GUI 交互上,AgentPatch 将均分拉升至 41.3。
更重要的是这种提升的平衡性。很多合并算法试图挽救弱项时,往往以牺牲其他强项为代价。但在 MMSearch 和 FactualVQA 上,AgentPatch 依然维持在 51.0 的高水准,极度逼近纯搜索专家 MMSearch-R1 的原生表现;在超高分辨率图像基准 HR-Bench 8K 上甚至录得 79.7 的全场最高分。这表明 AgentPatch 在挽救退化能力的同时,没有破坏互补专家原有的几何优势。
消融实验进一步证实了“粗细搭配”的不可替代性。如果跳过独有残差恢复,仅凭行为补丁难以弥补大范围的表征稀释;而如果仅保留粗粒度残差、舍弃行为级微调,GUI 得分则会停留在 39.8,无法跨越到 41.3 的高位。此外,研究人员还对比了完全随机挑选同等数量神经元进行插值的对照组,结果不仅 GUI 性能暴跌 5.6 分,总体分数也大幅下滑,证明了行为条件化神经元评分的准确定位能力。
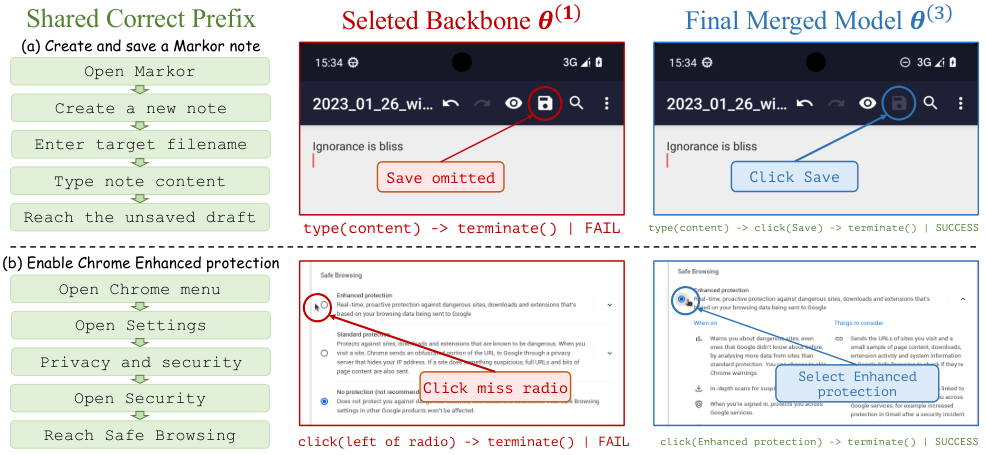
从定性案例分析中可以最直观地感受到这种行为级微调的魔力。在 AndroidWorld 的 Markor 笔记应用测试中,骨干合并模型能够理解指令并正确输入笔记内容,但在最后关头却直接终止了会话,未执行保存操作;而经过 AgentPatch 修复后的模型,在保持前期完全一致的前提下,精准补足了点击保存按钮(Click Save)的关键动作。同样,在 Chrome 浏览器的安全设置交互中,未经修复的模型在单选框边缘发生了空间定位漂移导致点击落空,而打上补丁后的模型精准地将交互动作锚定在“增强型保护”控件上。
走向实用的无缝智能体整备
智能体多模态大模型的研发正处于从分散原型走向通用落地的关键窗口期。过去,业界为了应对复杂工作流,往往不得不为搜索、GUI 控制、图像精细化操作分别部署多个庞大的独立权重,在前端构建复杂的路由器调度,这不仅带来了成倍的显存和存储开销,还放大了系统调用的延迟。
AgentPatch 证明了一条截然不同的路径:在同构基座的前提下,异构交互专家完全可以通过纯后验的、免训练的参数几何修整融为一体。它不仅克服了简单算术平均对高复杂度弱任务的无情稀释,更将神经元激活解释技术直接转化成了具备可操作性的工程生产力——通过辨析长程交互中的成败关键帧,指导模型权重进行高精度的微量插值。
这种无需在线接入代理审查、不改变原模型推理拓扑、直接输出单一静态权重的设计,展现出了极高的工业实用价值。对于未来多模态具身智能、跨平台智能助手等需要在异质环境间频繁切换的系统而言,AgentPatch 提供了一种兼顾各方专长且代价极低的轻量化整合范式。