微软提出 WTM-Bench:用“时光机”倒推真实表格,大模型做透视表得分不足10%
Back to the Future: A workbook time machine for spread sheet creation benchmarks
在企业数字化场景中,电子表格(Spreadsheet)依然是全球使用门槛最低、覆盖面最广的计算与数据分析载体。然而,当大语言模型被赋予操作 Excel 的权限时,它们真的能像专业数据分析师那样,自如地完成多表联动、公式拉取、图表绘制与数据透视表构建吗?
ArXiv URL:https://arxiv.org/abs/2608.07873v1
以往的评估往往给出模糊或偏乐观的结论。这主要因为现存的电子表格基准测试大多存在两难困境:要么像 SheetCopilotBench 那样人工合成简单表格,结构过于玩具化;要么像 SpreadsheetBench 那样采用真实文件,却只考察简单的数据填充和基础公式,绝大多数真实分析流程中必不可少的复杂派生对象(图表、数据透视表、条件格式)都被排除在外。
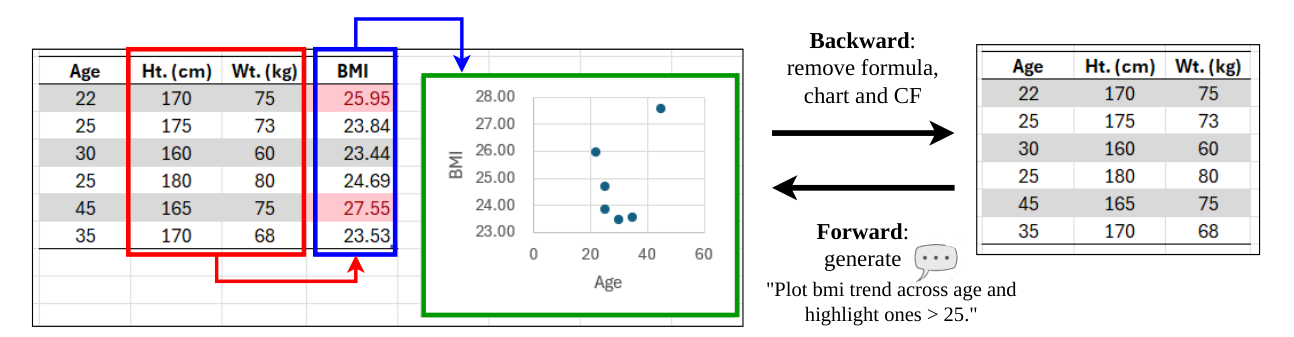
微软研究院最近提出的 Workbook Time Machine(工作簿时光机,简称 WTM) 及其基准测试 WTM-Bench,彻底打破了这种测试真空。研究团队换了一种反向思路:不再费力去手写或单向生成表格,而是借鉴强化学习中的“逆向课程生成”(Reverse Curriculum Generation),将真实用户沉淀下来的完整终态 Excel 表格进行“时间倒流”式的逆向解构,自动剥离派生对象、构建编辑依赖图,再正向反推不同抽象程度的自然语言指令。
基于这一流程构建的 WTM-Bench 揭示了许多大模型真实落地时的残酷现状:在面对抽象的商业指令时,即使是最顶尖的前沿推理模型,在数据透视表(Pivot Table)任务上的软得分率也普遍不足 $10\%$;同时,多轮工具调用的执行编排与底层 API 选择,对模型成功率的影响甚至远远超过了底座模型本身的参数规模。
为什么大模型做 Excel 总是“测不准”?
评估大语言模型处理真实 Excel 表格的难度,远高于纯代码生成或单张表格的问答。
现实工作中的工作簿从来不是规整的数据库二维平面。一个真实的财务或运营分析表格,往往散布着跨 Sheet 的公式引用、非标准的合并单元格布局、围绕在计算单元旁边的说明性标签(例如“Total”或“同比增长”),以及多种相互依赖的衍生资产。例如,必须先通过公式算出某列指标,才能基于该指标建立条件格式高亮,最后再把这些数据汇入散点图。
现有的评测基准之所以无法反映真实水平,核心瓶颈在于数据构建的成本。如果让人工专家从零设计数百个包含多步骤、跨对象依赖的真实工作簿,成本高昂且覆盖面极其狭窄。如果采用大模型直接前向合成,模型生成的表格往往带有很强的“合成味”,缺少真实企业文件那种错综复杂、甚至有些混乱的排版特征。
为了兼顾“真实文件结构”与“可控的评测粒度”,微软提出了将成品表格“倒放”的工程设想:真实世界里已经存在海量的公开企业 Excel 资产(如 Enron、FUSE 语料库),这些表格已经包含了最终的业务分析形态。只要能够逆向推导出一张成品表格是如何一步步搭建起来的,就能低成本、自动化地获得近乎无限的高质量评测样本。
工作簿时光机:从终态表格倒推“候选演化史”
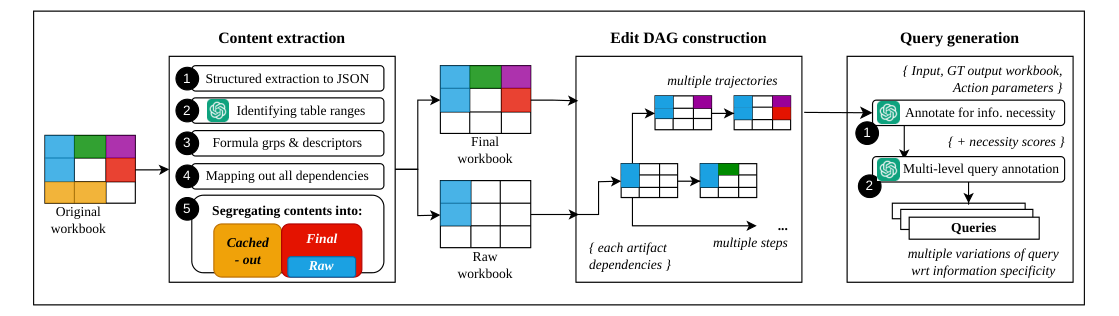
将这一逆向设想落地的核心引擎,就是 Workbook Time Machine。整个流水线分为逆向分解(Backward Step)与正向指令生成(Forward Step)两个关键阶段。
1. 逆向剥离与依赖图剪枝(Backward Step)
给定一份用户最终完成的 Excel 工作簿 $W$,可以将其建模为两部分集合:基础原始数据 $D$ 与建立其上的派生衍生对象集合 $C={c_1, c_2, \ldots, c_n}$。这些对象涵盖了公式组、图表、数据透视表和条件格式。
剥离过程并非机械地删除单元格。为了保证剥离后状态的干净与有效,流水线首先执行公式分组(Formula Grouping)。在真实操作中,用户常常通过下拉填充或 FlashFill 将同一种计算逻辑应用到整列。算法将共享计算模板的相邻单元格归一化为单一的“公式组”,大幅降低状态空间维度。接着,系统引入语义描述符映射(Semantic Descriptor Mapping),利用大模型定位与公式强相关的描述性标签单元格(比如“总计”标签),在移除计算公式时同步清理这些标签,防止在评测时向模型提前泄露解题线索。
剥离掉所有派生对象后,工作簿退回原始数据状态 $W^0$。但要生成合理的任务,必须知道这些对象是以什么顺序添加进去的。理论上,包含 $n$ 个对象的工作簿存在 $n!$ 种可能的添加排列。系统将其建模为一个有向无环图——编辑图(Edit DAG) $\mathcal{G}=(V, E)$,其中节点表示工作簿的中间状态,边代表添加某一个派生对象。
为了剔除违反语义逻辑的无效排列,研究团队引入了依赖感知剪枝(Dependency-Aware Pruning)。如果图表 $c_j$ 的数据源来自公式组 $c_i$ 的计算结果,那么在图拓扑中,$c_j$ 绝不能先于 $c_i$ 出现。通过重叠区域计算与引用追踪,系统构建了对象依赖图 $\mathcal{G}_D$,将不符合依赖约束的边全部剪除,最终提炼出稠密且合法的依赖剪枝图 $\mathcal{G}_P$。
这套机制最巧妙的地方在于,候选历史路径不必都从完全空白的 $W^0$ 开始。一条编辑路径的起点可以是已经包含部分公式的半成品状态,终点则是加入新图表后的状态。这精准还原了现实中打工人“接盘同事做了一半的表格继续加工”的高频场景。
2. 正向生成与多粒度指令(Forward Step)
在获得合法的状态转移路径 $(W^{\text{in}}, W^{\text{out}})$ 后,流水线需要为其配备人类指令。为了测试模型对不同模糊度需求的理解力,研究团队设计了一套三层粒度的指令生成方法。
流水线首先从状态转移中抽取结构化动作参数(如涉及的图表类型、数据选区、轴标签、公式表达式等)。接着,利用大语言模型对各个参数评估必要性得分(Necessity Score) $s \in {0, 0.5, 1}$,区分出哪些是识别任务意图必不可少的关键参数,哪些是附带的细节修饰。
根据参数的保留程度,模型会顺次生成三级指令:
-
Level 1(完全详细):包含所有技术细节与参数,明确指定单元格范围、具体公式语法及操作位置;
-
Level 2(中等详细):保留核心范围与图表类型,但省略具体的公式写法与次要参数;
-
Level 3(高度抽象):模拟真实老板或客户提出的粗颗粒度诉求,例如“根据身高体重计算 BMI 并绘制其与年龄的分布散点图”,完全隐去具体坐标与计算路径。
重平衡构建 WTM-Bench
在将这套时光机引擎应用于公开的 Enron 和 FUSE 语料库后,研究团队首先得到了一个庞大的 WTM-Corpus,包含 2977 个独立任务和 8931 条自然语言指令。
然而,对原始语料的统计揭示了一个严重的现实偏差:在真实留存的表格中,各类对象的分布极度失衡。公式占据了压倒性的 $67.5\%$,而业务价值极高的数据透视表仅占 $0.8\%$,图表与条件格式也分布偏低。如果直接拿这个原始池作为基准,哪怕模型完全不会做透视表和图表,仅凭基础公式生成就能刷出极高分数,丧失评测的诊断意义。
为此,研究团队采用字典序分层重采样,人工校准分布,最终锁定了 WTM-Bench 核心评估集。该集合包含 150 个高度代表性的评测任务,各包含 3 个粒度等级,共计 450 个评测用例。重平衡后的任务分布显著均衡:公式占比降至 $41.3\%$,图表占 $23.3\%$,条件格式占 $20.0\%$,数据透视表则被提振至 $15.3\%$,同时覆盖了制造业、金融、公共管理等多个行业领域,构建起一道全面且平衡的测试壁垒。
评估指标同样摒弃了大模型打分(LLM-as-a-Judge)的主观性,采用完全确定性的程序化对比:
-
软得分(Soft Score):在 $[0, 1]$ 区间内,综合计算单元格值、公式文本、图表类型与选区、透视表字段布局、条件格式规则的加权相似度,反映部分完成度;
-
硬得分(Hard Score):只有软得分达到完美的 $1.0$(即所有派生对象完全精确复原)才算通过,严苛考量完整还原能力。
实验发现:谁在真正决定 Excel Agent 的成败?
在评测中,研究人员选取了当前两大家族的 6 款前沿模型(GPT-4.1 Mini、GPT-5.2 Reasoning、GPT-5.4 Reasoning;Claude Haiku 4.5、Claude Sonnet 4.5、Claude Opus 4.6),并对比了现有的知名开源框架(SheetAgent、SheetCopilot、SpreadsheetBench)以及一套具备多轮环境观察与自纠错能力的工具调用编排框架。
实验结果给出了一系列颠覆直觉的技术洞见。
1. 框架设计与状态反馈,权重远超模型规模
在同样的底座模型(GPT-5.4 Reasoning)驱动下,不同框架的表现差距犹如鸿沟。只进行单轮代码生成、缺乏执行反馈的传统基准方案,在 Level 3 抽象任务上的 Hard Score 仅有可怜的 $3.3\%$;而引入了多轮交互和结构化状态反馈(Surfaced State Observation)的工具调用编排,Hard Score 直接跃升至 $20.0\%$,提升幅度高达 16.7 个百分点。
实验清楚地表明,大模型在操作 Excel 这种高维空间状态时,无法像下盲棋一样仅凭记忆一次性写对长代码。它必须在每执行一步后,看到当前单元格的实际计算结果、看到报错堆栈,并在真实工作簿状态的反馈下进行原地微调自愈。
2. 底层控制 API 成为隐形天花板
许多开发者倾向于使用 Python(如 openpyxl 或 pandas)来作为大模型操作表格的后端。但 WTM-Bench 的横向评测却显示,VBA 和 OfficeJS 的综合表现全面压制 Python。在顶尖模型配置下,Claude Opus 4.6 搭配 VBA 跑出了全场最高的 $33.7\%$ Hard Score 和 $54.0\%$ Soft Score。
其核心原因在于原生 Excel 运行时的抽象能力。在 VBA 或 OfficeJS 中,创建一个符合 Excel 原生规范的数据透视表或动态图表,往往只需要调用一个高度封装的原生 API 接口;但在 Python 环境下,模型必须自己先用 Pandas 处理行列重塑,再小心翼翼地映射到 OpenPyXL 极其繁琐的底层 XML 包装器中。多层工具胶水代码的叠加,呈指数级放大了语法错误与参数拼接失败的概率。
3. 透视表成为全行业通识盲区,公式最易搞定
细分到四大衍生资产类型时,模型的表现呈现出极端的两极分化。在最基础的公式计算上,领先模型能够拿下接近 $70\%$ 的软得分;条件格式与图表次之,维持在 $40\% \sim 50\%$ 上下。
但对于数据透视表(Pivot Table),几乎所有模型与框架全部败北,软得分均被压制在 $\le 10\%$ 的极低水平。大模型对于多维聚合层级、行列透视字段定义以及数据源范围的动态关联缺乏足够的内部世界模型,目前尚无法支撑起现代商业分析中最基础的切片透视需求。
4. 失败根源是“结构错位”,且伴随严重自欺欺人
通过对近 5000 次模型执行轨迹的微观归因,研究发现了一个反常现象:大模型在电子表格任务上的失败,极少是因为数学计算错误,绝大多数都是灾难性的结构错位。
在 1858 次 Python 失败执行中,$88.5\%$ 的案例属于结构性崩溃——要么完全漏掉了派生对象($62.3\%$),要么把图表或数据放错了单元格坐标($26.2\%$);真正把对象格式和位置放对、仅仅是数值算错的情况只有 $11.6\%$。
更棘手的问题在于模型的自评机制。实验统计了模型在任务执行中的“幻觉成功率”——即模型自己宣布“任务已圆满完成”,但自动化判卷给出的实际得分却接近于 0。在 Claude 系列的失败轮次中,这种“盲目自信”的比例高达 $80.7\%$,GPT 系列也达到了 $43.2\%$。这说明当前的 Agent 架构极度缺乏自我验证的准出标准,严重制约了其在企业无监督环境下的商业化交付。
自动化表格分析的破局之路
WTM-Bench 的价值,不仅在于它提供了一张客观且严酷的考卷,更在于其逆向生成框架本身具备高度的延展性。
首先,三级粒度的指令演进(Level 1 详细到 Level 3 抽象)为后续模型的指令微调提供了天然的课程学习(Curriculum Learning)路径。开发者可以先训练模型在 Level 1 的细致指引下学会正确的 API 拓扑调用,再逐步抽离显式参数,逼迫模型学会自主探索与空间推演。
其次,时光机的逆向逻辑本质上是全生命周期 CRUD 操作的镜像。论文目前主要展示了基于逆向剥离来构建“创建(Create)”任务;反过来,如果将带有对象的终态作为输入,将剥离后的状态作为目标,流水线就能立刻转化为“清理与删除(Delete)”任务;而在依赖图的中间节点进行扰动,即可生成表格“修改(Update)”基准。
在智能体落地从单纯的“自然语言对话”走向“生产力工具无缝接管”的今天,WTM-Bench 用扎实的评测数据证明:要想真正做出好用的 Office 智能体,单纯堆叠更聪明的底座模型是不够的。构建更深度的 Excel 原生 API 适配层、建立对表格空间拓扑的结构化感知,以及设计更冷酷客观的执行自验反馈机制,才是大模型真正玩转电子表格的技术胜负手。