READ:告别Top-K黑盒检索,无嵌入Agent将财报问答提升至58.8%
Beyond Top-K: Replacing Black-Box Retrieval with Interpretable Agentic Operations
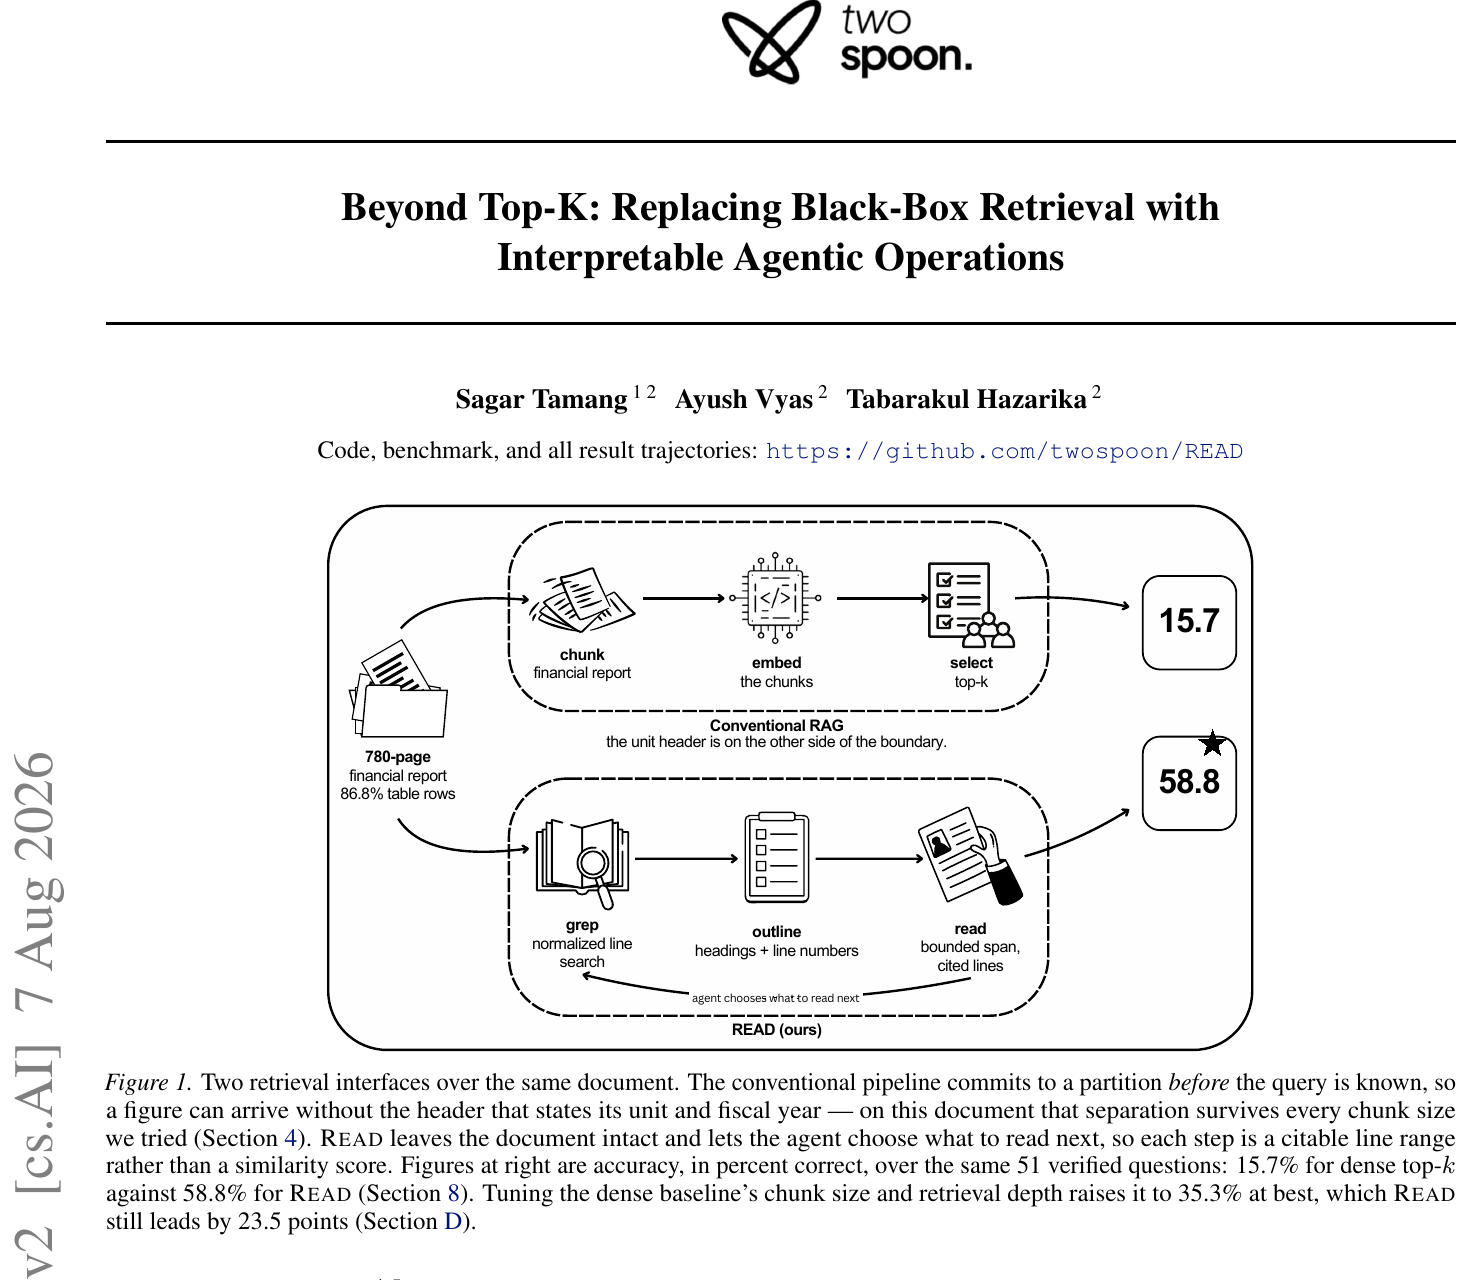
在大模型落地企业知识库的浪潮中,检索增强生成(RAG)几乎固化为一套机械的标准范式:把文档切分成固定长度的文本块(Chunks),送进嵌入模型计算向量,再在用户提问时取出余弦相似度最高的 Top-$K$ 个片段塞入提示词。这套流水线在处理散文、百科或客服问答时往往行之有效,但在面对资产负债表、审计底稿、监管合规报表等强结构化、要求绝对精度的长文档时,却频繁暴露出严重的结构性缺陷。
ArXiv URL:https://arxiv.org/abs/2608.06305v2
来自印度理工学院巴特那分校(IIT Patna)与 TwoSpoon 的研究团队在一篇研究中直击了这个行业痛点。他们明确指出,传统“切块-嵌入-检索”(Chunk-and-Embed)模式在严肃财务文档上的溃败,绝非通过微调切分大小或更换重排模型就能修复的小修小补,而是这一范式本身存在结构性断裂。为此,研究团队提出了一种无须嵌入模型、不依赖向量数据库的全新方案——READ(Reliable Embedding-free Agentic Document-search)。该方案让大模型 Agent 借助标准化协议,直接利用确定性工具在原始文档中进行结构化导航与按需阅读。
在包含 780 页印度政府官方财报的真实基准测试中,标准密集向量检索的问答准确率仅有惨淡的 15.7%,即便经过深度调优也只能达到 35.3%;而采用确定性接口的 READ 方案直接斩获了 58.8% 的准确率。更为耐人寻味的是,经典词法检索算法 BM25 在同样的任务上拿下了 51.0% 的高分,在统计学上与复杂的 Agent 检索并无显著差异。这项研究给出了一记极具价值的技术警醒:在特定高精确度场景下,向量检索不仅没有带来收益,反而成了制造误差的核心根源。
财报长文档为何沦为向量检索的“坟场”?
为了搞清楚标准 RAG 究竟败在哪里,研究团队没有停留在定性的概念争辩,而是选取了一份极具代表性的超长硬核文件——长达 780 页、共计 3.97 MB 的《2024–25 年度古吉拉特邦财政决算》,展开了细致的定量解构。
这份文档展现出与普通纯文本截然不同的三个物理特征。首先是高度表格化:在整整 780 页转换后的文本行中,高达 86.8% 的有效内容都是表格数据行,连续的自然语言叙述极少。其次是数值的高度同质化:数万个格式近乎相同的金额、百分比与统计编码紧密交织,挤在同一个向量空间里,稠密向量很难仅凭语义捕捉特定行与具体列的细微差别。
最致命的特征在于布局驱动的上下文继承机制。在规范的财务表格中,具体的数值行本身通常不附带计量单位或币种标识,而是向上继承自几行甚至十几行之前的表格头部或章节标题。量化统计显示,在这份财报中,一个数值行距离定义其单位的表头,中位数间隔整整达到了 13 行。
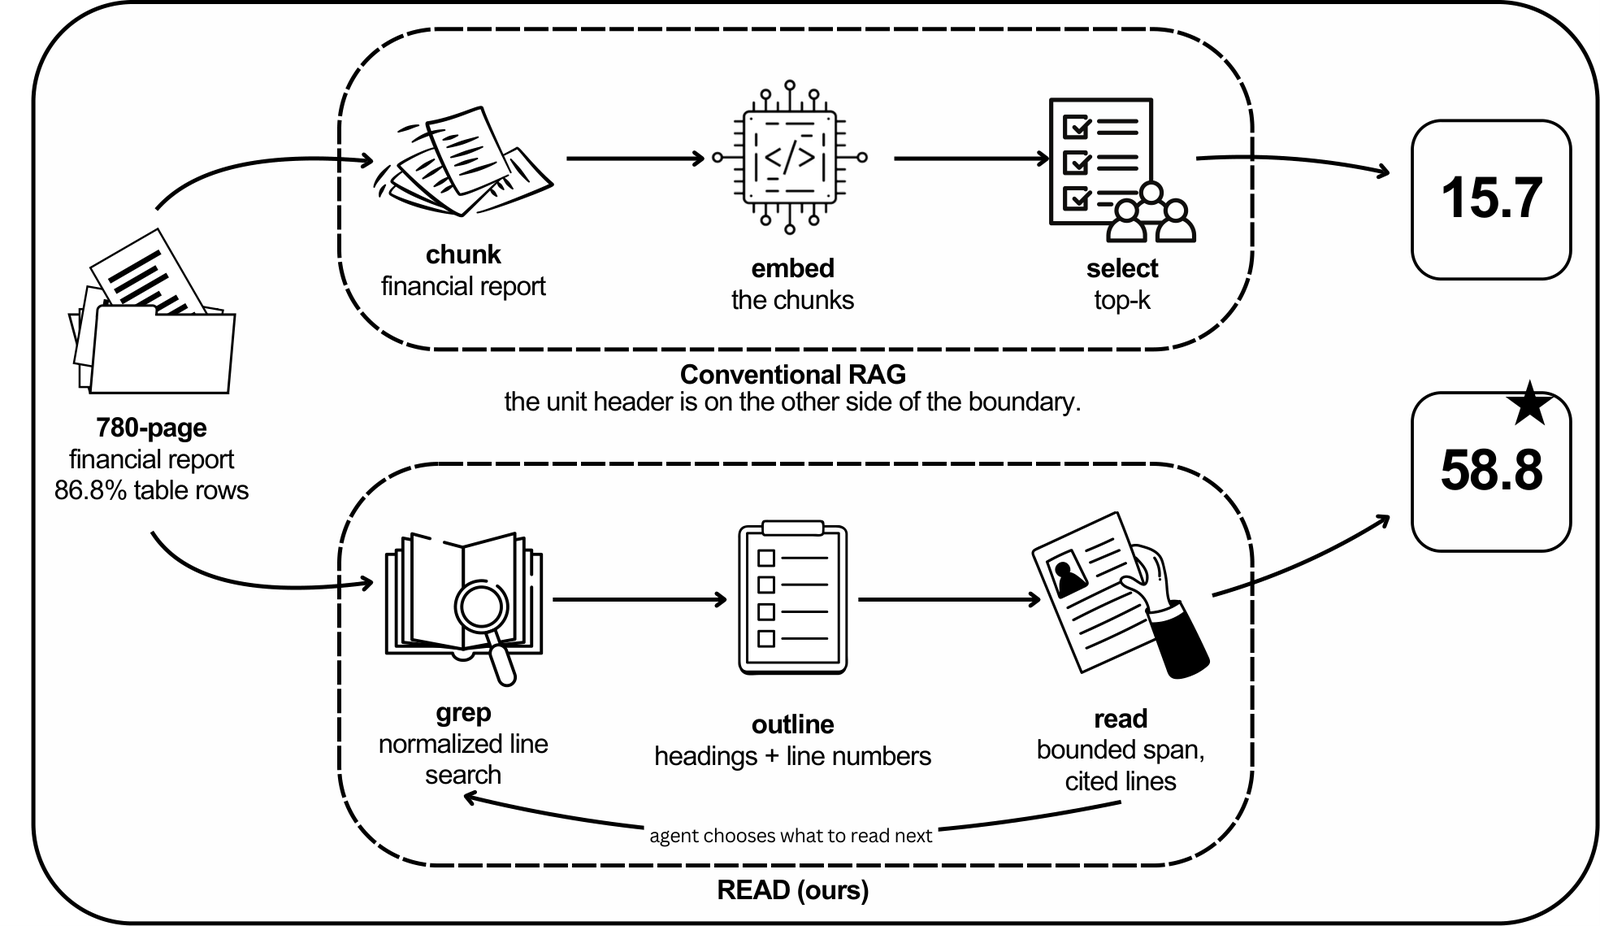
这就带来了毁灭性的切分灾难。在传统的离线切块流程中,切分算法在完全不知道用户提问是什么的情况下,机械地按照字符数截断文本。只要切分边界恰好落在这 13 行的间隔区间内,提取出来的数值切块就会彻底失去表头上下文。在印度财务体系中,金额计量常常在“拉克”(Lakh,十万)与“克罗”(Crore,千万)之间切换,两者相差两个数量级,也就是整整 100 倍。当切块强行斩断了数字与表头的纽带,下游生成模型面对一个光秃秃的孤立数字,根本无法判断它究竟代表几个零。
为了排除“切块工具太粗糙导致基准过低”的质疑,研究人员特意构建了一个极其强悍的“表格感知切块器”(Table-Aware Chunker)作为基线靶子。该切块器在遇到分块边界时,会强制将上游识别到的单位声明与表头向下传递并拼接到新的分块头部。实验结果表明,这种工程修补确实将无单位切块的比例从 18.0% 压低至 0.3%,但副作用接踵而至:无论研究者如何调整分块尺寸,整个文档中依然有 27% 到 30% 的数值切块无法匹配到对应的财政年度(Fiscal Year)表头。
换言之,即便工程手段竭尽全力,静态切分依然无法挽回二维表格被一维物理切割所破坏的内在拓扑关系。当一个涉及“计算 2024–25 财年财政赤字与收入盈余之差”的问题提出时,由于两项关键操作数在原表中相距 47 行,且两者差值在全文中从未直接出现,密集检索模型在数次尝试中甚至从未成功将两项数据同时召回到同一个提示词上下文中。面对被割裂的信息碎屑,语言模型只能无奈地报告“无法回答”,或者更糟糕——挑出一个似是而非的错误数字开始编造幻觉。
从黑盒向量召回到可审计的确定性接口
既然线下预先切块存在无法逾越的结构盲区,破局的唯一方式就是推翻“切块-嵌入”的契约。READ 给出的替代方案极其清晰:保持原始文档的完整拓扑结构不变,不进行向量化,不建立向量索引,而是为大模型配备一套完全确定性的文档操作接口,让 Agent 在推理过程中按需展开探索。
从接口形式上看,两套范式呈现出本质的分野:
-
传统 Top-$K$ 接口将文档映射为不可逆的高维向量隐空间,检索过程受制于固定的分块边界,返回的是经过相似度排序的黑盒切片。模型既无法得知被排除的切片里隐藏了什么,也无法向外延展查看切片前后的文字。
-
READ 接口通过 Anthropic 提出的模型上下文协议(Model Context Protocol,MCP)向 Agent 暴露了四组原语操作。其中包括提供结构化导航的
outline与list工具,负责快速定位报表与章节所在的具体行号;提供基于规则匹配的grep行内检索工具;以及最重要的有界跨度读取工具read(a, b)。
这里的 read 工具采用的是“跨度寻址”(Span-Addressed)而非“分块寻址”。这意味着 Agent 在执行 grep 匹配到某个核心科目所在的行号后,拥有自主裁量权——它可以主动调用 read 工具向上扩展读取前 30 行,从而将包含单位(Lakh 或 Crore)和具体年份的表头完整收入视野;如果该科目涉及多级子项目汇总,它也可以向下继续延伸读取几十行。
更为关键的是,这种基于确定性操作的调用链天然构成了一条透明的审计轨迹(Audit Trail)。在金融和合规场景下,生成模型给出的每一个关键数字都必须经得起严苛核查。在传统 RAG 中,人们只能验证某个数字是否出现在被召回的 Chunk 里,却完全无法解释为什么具有极高相似度的其他干扰项没有被选中。而在 READ 体系中,Agent 的每一步操作都是纯函数,输入相同的文档与参数,必定得到绝对一致的行范围。研究团队提出了一种“机械可验证溯源”(Mechanically Checkable Groundedness)标准:回答中出现的每一个数字,都必须在 Agent 调用的读取跨度中找到字面一致的原文支撑。这种完全可重放、可追溯的特性,彻底切中了企业级严肃报表分析的核心软肋。
被学术研究所忽视的真实“转换上限”
在从理论方案走向落地的过程中,研究人员揭开了一个在以往 Agent 搜索论文中鲜少被提及的工程暗礁:真实环境下的 PDF 转换污染。
绝大多数针对代码仓库或网页的长文本搜索基准,使用的都是非常干净的现成文本。但在现实的企业应用中,分析系统面对的第一步往往是将排版错综复杂的 PDF 财报转换成 Markdown 格式。在对多种转换器进行横向对比后,团队选用了保真度相对最佳的 pymupdf4llm,但即便是当前最成熟的转换工具,转换后的文本依然布满了系统性噪声。
数据统计揭示了这一现状的严峻程度:转换器在表格中错误生成了 4,685 个多余的空白首列;生成了 32,404 个与词项紧紧焊死在一起的加粗斜体符号;把 1,719 个单词生硬地切断在不同的单元格里;并产生了 24 种不同写法的报表编号变体。
其中最具杀伤力的,是文档中存在整整 14,269 个带有数字分组千分位逗号的数值。在真实的财务问答中,Agent 在执行逆向查找、交叉验算或验证计算中间值时,其搜索的关键词往往就是刚刚推导出来的纯数字序列。如果使用标准的字面量 Grep 工具,Agent 输入清洗后的纯数字,在带有千分位逗号的转换文本里根本无法命中任何内容。
这也是为什么纯字面匹配往往在长文本检索中表现疲软的根本原因。READ 之所以能够保持高可用性,核心支撑在于其引入了“归一化词法匹配”(Normalized Lexical Matching)机制。该机制在执行底层搜索时,自动剔除数字中的千分位分隔符、平滑空白字符与格式噪点,才让 Agent 重新拥有了在数万个数字中精准穿刺的定位能力。
这项发现同时也界定出了一个客观存在的“转换保真度上限”(Conversion-Fidelity Ceiling)。在某些极端情况下,上游转换器已经将表格行列结构彻底碾碎,或者将表头与数据行不可逆地割裂开来。这部分错误属于整个下游检索链条的不可抗力,必须作为独立的评测类别单独剥离,而不能含混地归咎于检索算法本身的失效。
严格对照评测下的残酷真相与意外发现
为了对不同架构展开不偏不倚的检验,评测基准构建了 51 道涵盖单值查找、多行聚合、跨表算术、结构导航以及不可回答探针的严密问题集。所有被测系统均统一部署在相同的底层大模型(Gemini-2.5-Pro)之上,共享完全相同的回答格式规范以及严苛的置信区间与纠偏统计检验。
实验最终呈现出的对比结果,打破了许多关于检索架构的常规认知。
标准配置下的密集向量检索($k=8$)准确率仅为 15.7%,甚至在面对不可回答的陷阱问题时表现出高达 80% 的严重幻觉率,强行把相似但错误的数字凑成答案。即便对密集向量系统实施地毯式调优,将检索深度 $k$ 放大一倍至 16,并将分块长度放宽至 2,000 字符,其最高准确率也只能被推升至 35.3%。这种性能提升背后的逻辑极其朴素:既然单个分块注定丢失表头,那就只能靠把召回窗口撑大,碰运气把包含表头的邻近分块一并捞进上下文。代价则是问答单次成本直接暴增了 41%,且其最高准确率依然显著落后 READ 方案整整 23.5 个百分点。
针对近期大热的“Agentic RAG”概念,研究团队设计了一组极具对照价值的消融实验:保持与 READ 完全相同的 Agent 循环逻辑、思考步数上限与基础模型,唯一改变的是将 READ 的四个底层原子工具替换为一个可以反复调用的 Top-$K$ 向量检索工具。
结果表明,这款 Agentic RAG 最终只拿到了 27.5% 的准确率。尽管它凭借迭代机制频繁调用向量检索,只在极少数情况下完全找不回信息,但它却制造了全场最高的 21 次“未接地”(Ungrounded)答案。实验现象揭示了这种机制的内在缺陷:当一个具备推理能力的 Agent 手握一把并不精确的向量检索工具时,它会在反复尝试中不断囤积看似相关实则带有语义偏移的上下文片段,并在过载的信息噪点中强行推演,最终陷入深度的自我欺骗。这有力地证明了一个论断:性能的飞跃源于接口本身所赋予的底层表达力,而非外层包装的迭代循环。
然而,整篇论文中最具学术诚实性、也最引人深思的发现,出现在传统词法检索系统的对照组中。未经任何复杂 Agent 包装的纯 BM25 检索,配合表格感知切块后,在同样的 51 道题目上取得了 51.0% 的准确率,距离 READ 的 58.8% 仅差 7.8 个百分点。经过严格的配对检验,两者的差异在统计学上根本无法区分($p=1.00$)。在两套系统表现不一致的 22 道题中,13 道有利于 READ,9 道有利于 BM25,结果近乎等同于抛硬币;不仅如此,BM25 消耗的 Token 成本和响应延迟仅为 READ 的三分之一左右。
这组真实的数据迫使研究团队做出了非常克制的科学定论:现有的测试证据无法支持“Agent 检索已经全面超越词法检索”的宏大叙事。本项研究所真正切开的鸿沟,是基于稠密向量嵌入的检索(Embedding-based)与完全不使用嵌入的检索(Embedding-free)之间的优劣分野。在极度依赖字面精准、结构严丝合缝的财报场景中,密集向量索引非但没有提供语义泛化的红利,反而成为了破坏精度、切断结构线索的元凶。
走出 RAG 的向量迷思
READ 的实验与结论给当前狂热的 RAG 产业实践泼了一盆极其及时的冷水。它清楚地表明,并不存在一种放之四海而皆准的万能检索管道。长期以来,开发者往往习惯性地将“文档解析-切块-向量化-相似度召回”视为构建外部知识库的公理化标准,一旦效果不彰,便倾向于叠加更庞大的嵌入模型、重排模块甚至复杂的图谱架构。
但这项工作展示了另一种更为务实的可能。在诸如财报、年鉴、法律条文汇编等要求绝对事实正确性的长文档任务中,粗暴抹平结构拓扑的向量空间,往往远不如让模型退回到确定性操作的物理世界。通过赋予大模型对原文结构的自主探索权,保留可复查、可重放的确定性代码级轨迹,系统不仅能够大幅降低向量索引的维护包袱,还能在准确度与安全合规上建立起扎实的壁垒。面对严肃的工业级场景,重新审视被遗忘的经典词法逻辑与确定性接口,或许比盲目迷信黑盒嵌入向量更为行之有效。