Hybrid-OPD:多领域在策略蒸馏破解对齐税,逻辑推理提升13分
Cross-Domain Hybrid OPD for Generalizable Search Agents
在各大模型厂商竞相研发深度搜索与自主研究智能体(Search Agent)的当下,一个长期被工程实践隐匿却极其棘手的现象正逐渐浮出水面:当模型通过大规模强化学习掌握了自主规划、多跳检索与动态证据整合等高阶搜索技巧后,其原有的通用常识推理、数理逻辑与代码生成能力却往往出现断崖式下滑。
ArXiv URL:https://arxiv.org/abs/2608.02101
这种为了追求垂直能力而在通用基准上付出的代价,在学术界被称为“对齐税”(Alignment Tax)。用户对智能搜索助手的期望并非单维度的网页信息搬运工,而是希望它既能在动态网络环境中精准锁定答案,又能维持强大的代码调试、数理推导和长文本逻辑交互能力。
腾讯混元团队在其针对元宝搜索 Agent 的技术报告中系统剖析了该瓶颈,并提出了名为 Hybrid-OPD 的联合训练框架。该方案依托 Hunyuan3 底座,巧妙地将面向自主搜索的智能体强化学习与多领域专家在策略蒸馏(On-Policy Distillation)融为一体。它不仅没有牺牲搜索策略的迭代精度,反而在消除对齐税的同时,让模型在多项通用推理基准上逆势突破原有上限,为全能型通用 Agent 的后训练设计提供了高价值的工业界范式。
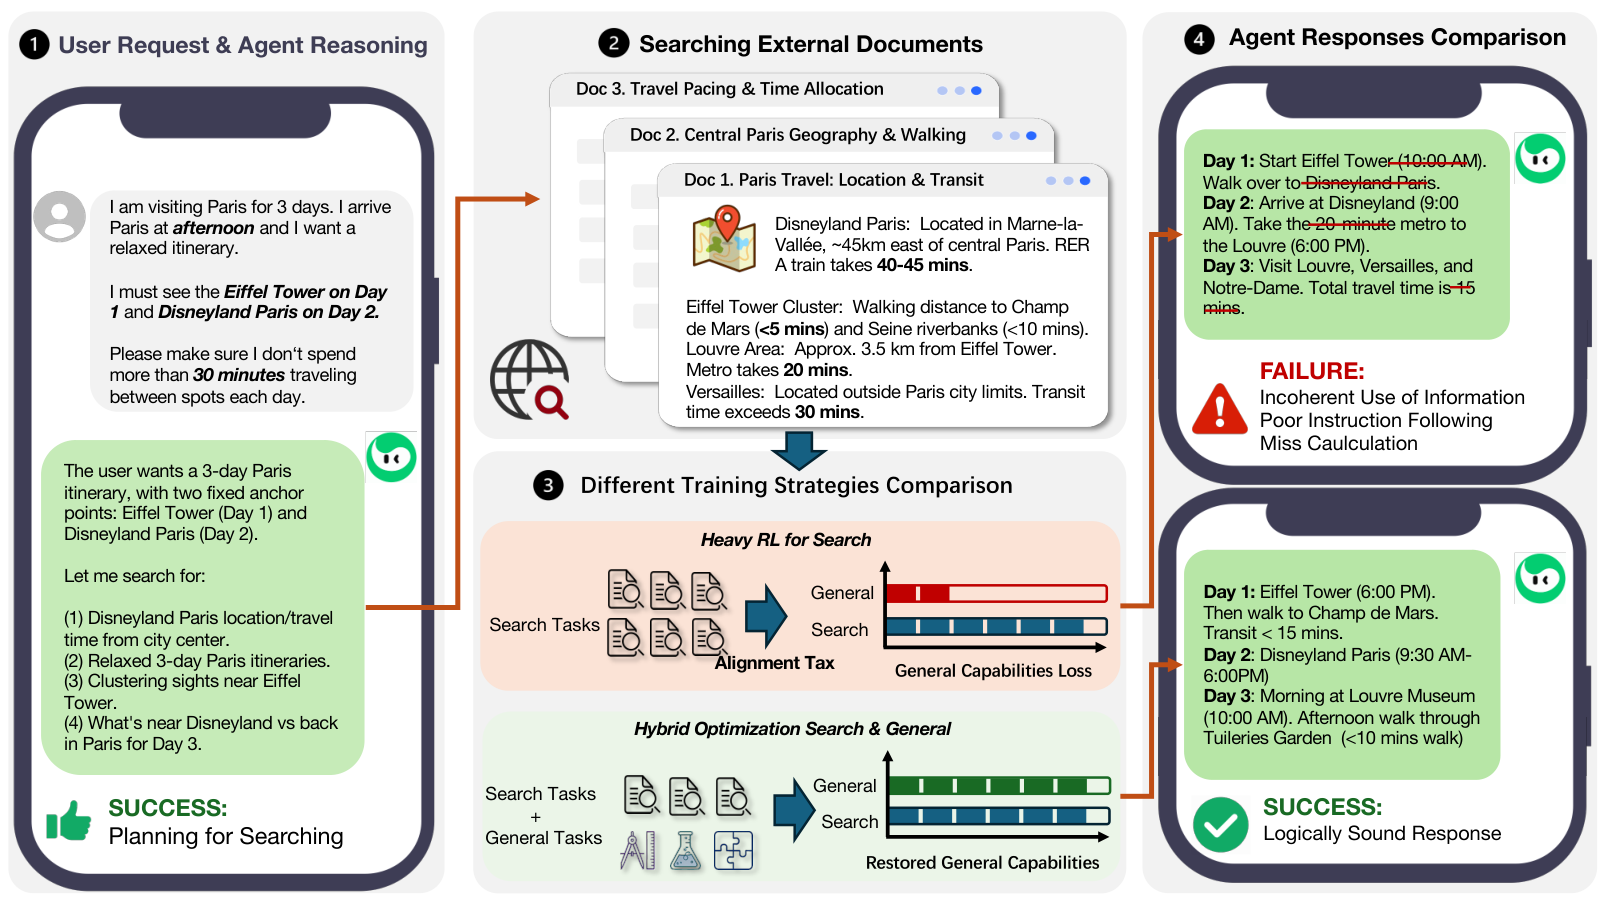
专化陷阱:搜索 Agent 为何越训越偏?
传统的检索增强生成(RAG)大多依赖固定的“先检索后生成”管道,这种单向范式在面对需要深度挖掘的复杂、时效性问题时显得呆板脆弱。随着强化学习在长链条推理任务中的突破,将搜索建模为序贯决策过程成为了当前构建自主 Agent 的主流选择。模型不再只是被动接收外部文档,而是自主决定何时调用搜索引擎、如何提炼关键词、怎样从噪声检索结果中发掘线索并进行二次乃至多轮追问。
然而,强烈的目标导向往往伴随着隐蔽的策略漂移。为了验证特化训练对通用能力的影响,混元团队在 Hunyuan3(A3B)与 Hunyuan3(A21B)两套基座上展开了严格的一阶段独立搜索强化学习(Stage I Agentic RL)。实验采用群体相对策略优化(GRPO),针对真实用户行为驱动的复杂搜索场景展开优化。
实验结果清晰地揭示了特化训练的残酷代价。虽然一阶段强化学习显著放大了模型在多跳问答(AS-MultiHopQA)与广度深度检索(AS-WideSeekQA)上的探索奖励,提升幅度均突破 0.32 点,但其在通用推理基准上却遭遇了全面的性能回撤。在数理与逻辑评测中,Math AMO Bench(中文)暴跌 8.00 分,Minerva Math 缩减 5.88 分,BBEH Mini 跌落 5.62 分,AIME25 下滑 3.00 分,GPQA Diamond 下滑 3.28 分。
这一现象的本质,在于纯搜索强化学习让模型的输出空间和隐层表征过拟合于工具调用格式、碎片化网页文本摘要以及短步检索决策,扰乱了此前通过海量通用语料对齐建立的深层符号推导与多步演绎网络。对于工业级通用助手而言,这种以牺牲核心智能为代价的工具熟练度显然不可接受。
为何朴素的混合强化学习无法力挽狂澜?
面对这一挑战,直觉上的工程解法往往是构建多任务混合强化学习(Mix RL):既然单训搜索会导致数学、代码变差,那么直接在数据集中按比例混入数学、代码和逻辑样本,统一使用基于结果的奖励信号(Outcome-based Reward)进行多目标联合微调即可。
但团队的消融实验证明,这种简单的端到端策略在处理复杂智能体时极其低效且不稳定。原因在于异构任务之间的奖励空间差异巨大:搜索任务依赖复杂的成对偏好模型(Bradley-Terry Preference Model)和自由文本等价性打分;数学和科学问题依赖确定性精确匹配(Exact Match);代码生成依赖沙盒环境下的执行测试(Pass@$k$)。当把这些异构反馈直接注入同一个策略梯度中时,长序列工具调用的方差会严重干扰精细符号推断的梯度更新方向。同时,高难度数学与逻辑题目在探索初期很难自发生成正确解,容易陷入零奖励陷阱,导致原本的通用基底不仅无法修复,反而在多任务竞争的梯度震荡中进一步失真。
要真正守住通用基准的底线,必须为模型引入更高信噪比、更密集的外部监督信号,而不是单凭策略自身的随机盲目采样。
Hybrid-OPD 框架:多领域专家的在策略传授
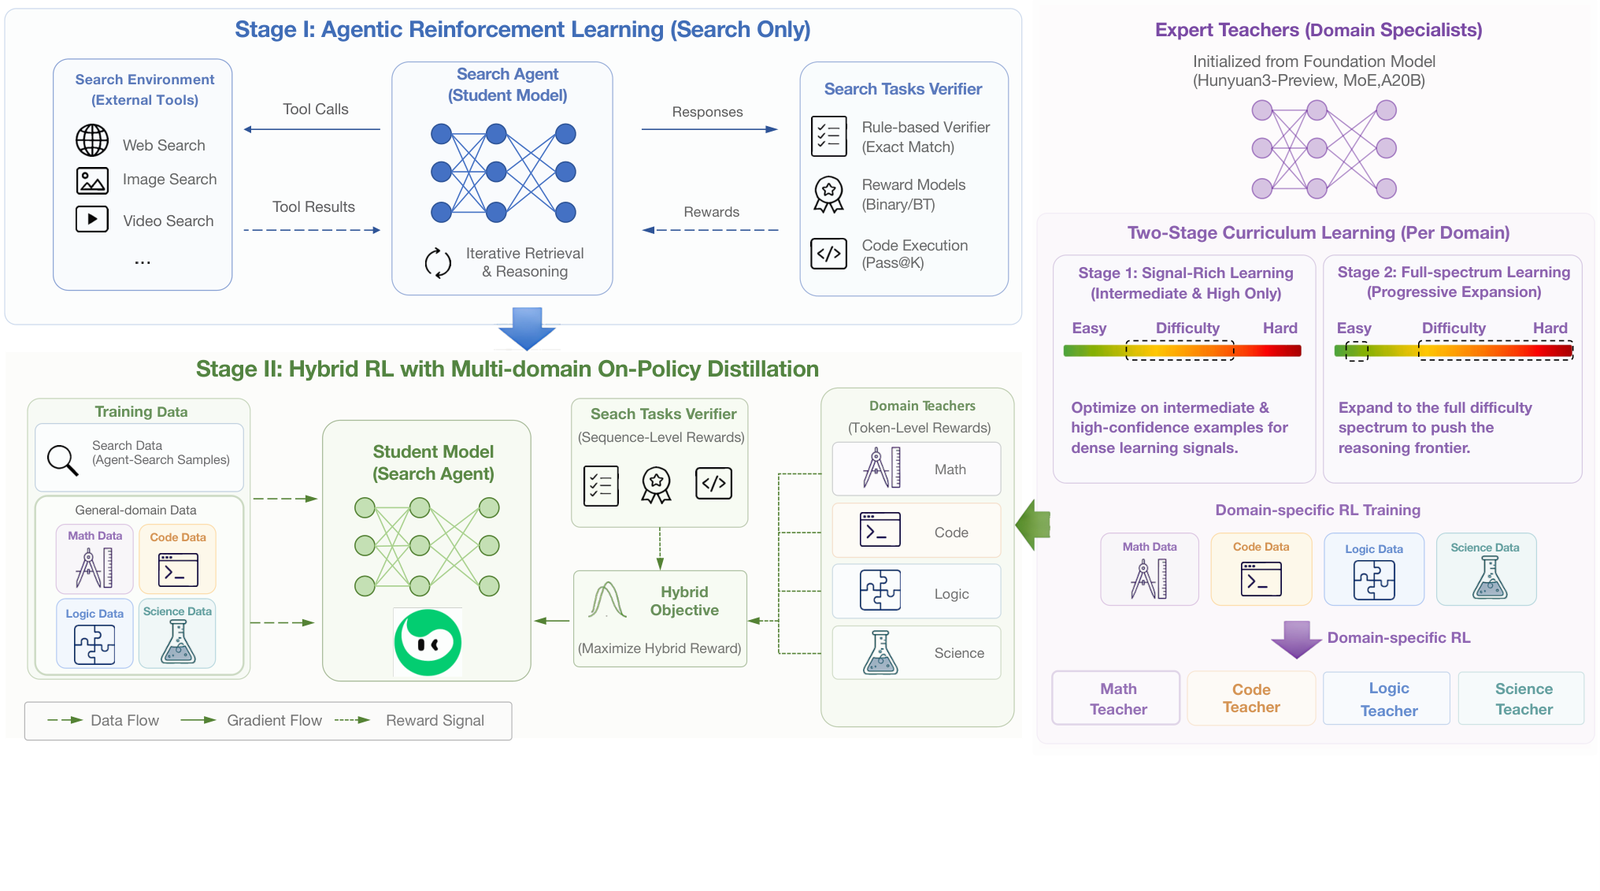
混元团队开出的解药是 Hybrid-OPD,即第二阶段的多领域专家在策略蒸馏(On-Policy Distillation)。该架构的核心逻辑是:将“维持通用能力”的重担从环境奖励驱动的无头探索中解耦出来,交由一组在各自领域登峰造极的“专家教师(Expert Teachers)”协同把控;而搜索能力则继续由专用环境强化学习深入挖掘。
1. 专家教师的课程学习构建
为了获得高质量的监督信号,团队在数学、代码、逻辑推理与自然科学四大支柱领域分别独立预先微调出四位专家模型。这四位教师同样基于 Hunyuan3 基座,但各自经历了高度精细化的数据编排与课程学习(Curriculum Learning)。
在数据组织上,通用训练语料结合了顶尖公开基准与丰富的高质量自建题库。为了让强化学习梯度更具信息密度,团队没有采用无差别均匀随机抽样,而是先根据参考策略的多次采样命中率(Pass@$k$)对题目难度进行动态分级。在训练第一阶段,系统仅选取解题成功率在 30% 到 90% 之间的中等难度样本。这部分样本的奖励方差最高、优化梯度最为密集,能快速帮模型固化稳定的解题范式,直接过滤了毫无信息量的极简样本与过早陷入死循环的超难题。在第二阶段,再逐步将数据分布放宽至全局,并调高超高难度样本的采样权重,同时保留极少量简单样本作为“锚点”,防止策略遗忘。
2. 在策略蒸馏(On-Policy Distillation)机制
与传统的离线知识蒸馏(教师生成静态答案并强制让学生模型拟合)不同,Hybrid-OPD 采用了在策略蒸馏。离线蒸馏最大的痛点在于分布偏移(Distribution Shift):教师模型自己写出的推理链路,往往处于学生模型当前推理空间之外;学生模型强行死记硬背教师的 Token 概率,一旦在真实自回归推理中出现一两个词的偏差,就会迅速滑落到未见过的状态空间中。
在策略蒸馏彻底逆转了这一流程:由学生模型(即正在接受搜索强化的模型)根据当前 Prompt 实时自回归生成完整的解题链路 $y \sim \pi_{\theta}$;随后,对应的领域专家教师 $\pi_{\phi_d}$ 仅作为一个高性能推理服务,对学生生成序列中的每一个 Token 给出对数概率评估。优化的本质是最小化学生策略与专家策略在学生当前采样分布上的逆向 KL 散度(Reverse KL Divergence):
\[\min_{\theta} \mathbb{E}_{(x,d) \sim \mathcal{B}_{\text{general}}} \mathbb{E}_{y_t \sim \pi_{\theta}(\cdot\vert{}x,y_{<t})} \left[ \log \frac{\pi_{\theta}(y_t\vert{}x,y_{<t})}{\pi_{\phi_d}(y_t\vert{}x,y_{<t})} \right]\]这种机制迫使专家教师在“学生自己选择的道路”上进行逐点校正,确保给出的监督信号紧贴学生模型的当前认知分布,极大提升了知识传递的稳定性。
3. 统一梯度下的联合优化
在实际更新时,训练引擎将每一个 Mini-Batch 动态划分为搜索轨迹批次 $\mathcal{B}{\text{search}}$ 与通用领域微调批次 $\mathcal{B}{\text{general}}$。两者被优雅地统一在类似 PPO / GRPO 的截断优势函数范式中:
\[\mathcal{L} = \mathbb{E}_{x, \{y\}^G_{i=1} \sim \pi_{\text{old}}} \left[ \frac{1}{G} \sum_{i=1}^G \frac{1}{\lvert y_i \rvert} \sum_{t=1}^{\lvert y_i \rvert} \min \left( r_{i,t} A_{i,t}, \text{clip}(r_{i,t}, 1-\epsilon, 1+\epsilon) A_{i,t} \right) \right]\]其中,对于搜索样本,优势值 $A_{i,t}$ 来源于组内奖励的标准化均值与方差;而对于通用领域样本,优势值则被直接赋予为学生旧策略与专家教师之间的负对数比值:
\[A_{i,t} = - \text{stop\_gradient} \left[ \log \frac{\pi_{\text{old}}(y_{i,t}\vert{}x,y_{i,<t})}{\pi_{\phi_d}(y_{i,t}\vert{}x,y_{i,<t})} \right]\]这种策略级统一极为巧妙:在训练执行层,底座无需部署多个专家模型的全量权重用于反向传播,而是把四位专家部署在独立的外部推理集群中按需提供 Logits;学生模型只需要在主干网络中同时消化强化学习的探索优势与来自专家的对齐梯度。
实验印证:对齐税的成功修复与基准反超
基于 Hunyuan3(A21B)的完整实验全面验证了这套混合架构的威力。数据清晰地反映了从基座模型、一阶段纯搜索 RL,到二阶段 Hybrid-OPD 的能力跃迁轨迹。
在一阶段遭受重创的通用推理基准,在二阶段全部迎来了爆发式反弹。变化最显著的是逻辑推理与代码任务:在 HYEval3.1 逻辑推理基准上,模型相较于一阶段大幅反弹了 12.95 分;在 BBEH Mini 上实现了 13.26 分的净回升;在代码评测 AutoCodeBench v2 中,模型得分从一阶段的 67.74 飙升至 74.15,甚至比未经任何强化的纯基座模型还要高出 5 个百分点以上。
在数理推理方面,AIME25 从一阶段下滑后的 59.00 分直接攀升至 66.33 分;Math AMO Bench(中文)完全收复了阶段一跌掉的 8 分失地;Math IMO AnswerBench(中文)甚至比原始基座还高出了 3.35 分。在衡量尖端科学推理的 GPQA Diamond 基准上,阶段二相比阶段一回升了 6.69 分。
尤为关键的是,多领域通用能力的巨幅回血并未以稀释搜索技能为代价。评估显示,在 AS-MultiHopQA、AS-WideSeekQA 和复杂格式遵循的 AS-FormatQA 这三项极度依赖规划与长上下文理解的搜索维度上,二阶段模型的得分进一步超越了一阶段的高点;而在长对话多轮搜索(AS-LongTermQA)与新闻时效追踪(AS-NewsQA)中,二阶段也完整保持住了一阶段的绝大部分收益,综合指标始终以显著优势碾压未受特化训练的纯基座模型。
消融实验进一步证实,如果在第二阶段去掉 OPD、单纯依赖混合真实奖励做端到端强化学习,通用能力的恢复幅度将大幅缩水。这证明了专家在策略连续指导的必要性:在海量长文本搜索轨迹的剧烈参数更新下,唯有高保真、在策略的专家概率分布,才能为底座深层的符号演绎网络构筑坚固的“能力防火墙”。
迈向全能智能体:从割裂工具走向统一智能
元宝搜索 Agent 的这套实践为大模型落地 Agentic 工作流提供了一个极具参考价值的理论与工程范例。过去业界在训练专业 Agent 时,常常默认“特化必然牺牲通用性”,甚至倾向于将系统切碎为调度路由层、搜索检索层与解答推理层等多模型拼装的复杂流水线。
Hybrid-OPD 框架证明了:特化与通用绝非不可调和的零和博弈。智能体之所以在学习调用工具的过程中变得“愚钝”,并非因为模型容量被占满,而是非结构化的工具强化信号干扰了参数原有的表征结构。通过把多领域专家知识抽象为在策略的分布式信标,我们完全可以把长程自主搜索这种高级工具决策,作为一种附加技能平滑沉淀到底座模型中。对于正在攻坚复杂自主智能体的团队而言,跳出粗暴混合微调的窠臼、探索更平滑的在策略专家混合蒸馏机制,或将成为跨越“对齐税”鸿沟的关键一步。