CRISP:精准锁定证据关键步,深度搜索Agent交互轮数降低33.2%
CRISP: Critical Step Perception for Training Efficient Deep Search Agents
在大模型迈向自主复杂任务的演进过程中,深度搜索(Deep Search)已成为最受瞩目的方向之一。不同于传统的单次检索增强生成(RAG),深度搜索 Agent 需要通过长程规划,交替调用搜索引擎、网页浏览和代码执行等工具,在充满噪音的互联网环境中自发搜集线索、验证假设并整合出最终答案。
ArXiv URL:https://arxiv.org/abs/2608.01867
然而,现存的深度搜索 Agent 普遍面临严重的效率危机。随着任务复杂度的提升,开放环境下的强化学习往往会导致 Agent 产生极度冗余的工具调用行为。许多主流开源 Agent 在面对具有挑战性的基准测试时,平均交互轮数动辄达到 30 轮以上。更关键的问题在于,轨迹变长并不等同于深度思考,大量的交互步骤往往充斥着换汤不换药的重复查询、低效漫游以及从未在最终答案中被使用的废弃网页。这种轨迹膨胀不仅带来了高昂的推理与检索 API 成本,还会使超长上下文不堪重负,大幅增加模型在海量干扰信息中遗忘关键证据的风险。
以往针对这一瓶颈的效率优化方案,思路大体可归结为对调用行为的惩罚——例如在强化学习中将交互步数作为负向成本施加给模型,以此倒逼其减少工具调用。但这种“一刀切”的惩罚机制存在致命缺陷:它无法区分哪些调用是在做无用功,哪些调用是在获取不可或缺的核心证据。当模型为了规避成本惩罚而盲目砍掉必要的信息检索步骤时,最终答案的准确率往往会发生雪崩式下滑。
针对这一根本矛盾,一项名为 CRISP(Critical Step Perception)的新框架给出了全新的解决路径。CRISP 认为,高效探索的关键不在于一味追求更短的轨迹,而在于建立对“证据关键步(Evidence-Critical Steps)”的感知能力。通过精准识别并奖励那些对最终答案产生因果贡献的证据搜集步骤,CRISP 在大幅剪枝冗余交互的同时,完整保全了推理所必需的信息链条。在 BrowseComp 与 HLE-Verified 两大硬核评测基准上,该方法在保持甚至提升最终准确率的前提下,分别实现了 15.1% 与 33.2% 的交互轮数缩减。
从一刀切惩罚到因果证据感知
要理清 CRISP 的设计哲学,首先要理解为什么传统强化学习中的成本惩罚难以胜任复杂的深度搜索任务。
当一个 Agent 尝试回答诸如“某两项历史冷门事件之间存在何种交集”这类问题时,它必须经历多级跳跃的证据链条。如果采用粗暴的长度衰减或每步固定扣分机制,模型在面对难度极高、天然需要 10 轮以上深挖的问题时,往往会倾向于放弃深层探索,草率地给出基于幻觉的浅层回答。这不仅损害了 Agent 的天花板能力,还容易导致策略退化。
CRISP 提出的核心破局点是“因果证据关联”。一个工具交互步骤是否关键,不取决于它所处的位置或语法结构,而取决于它所获得的观测内容(Observation)是否在因果上直接支撑或促成了最终正确答案的生成。
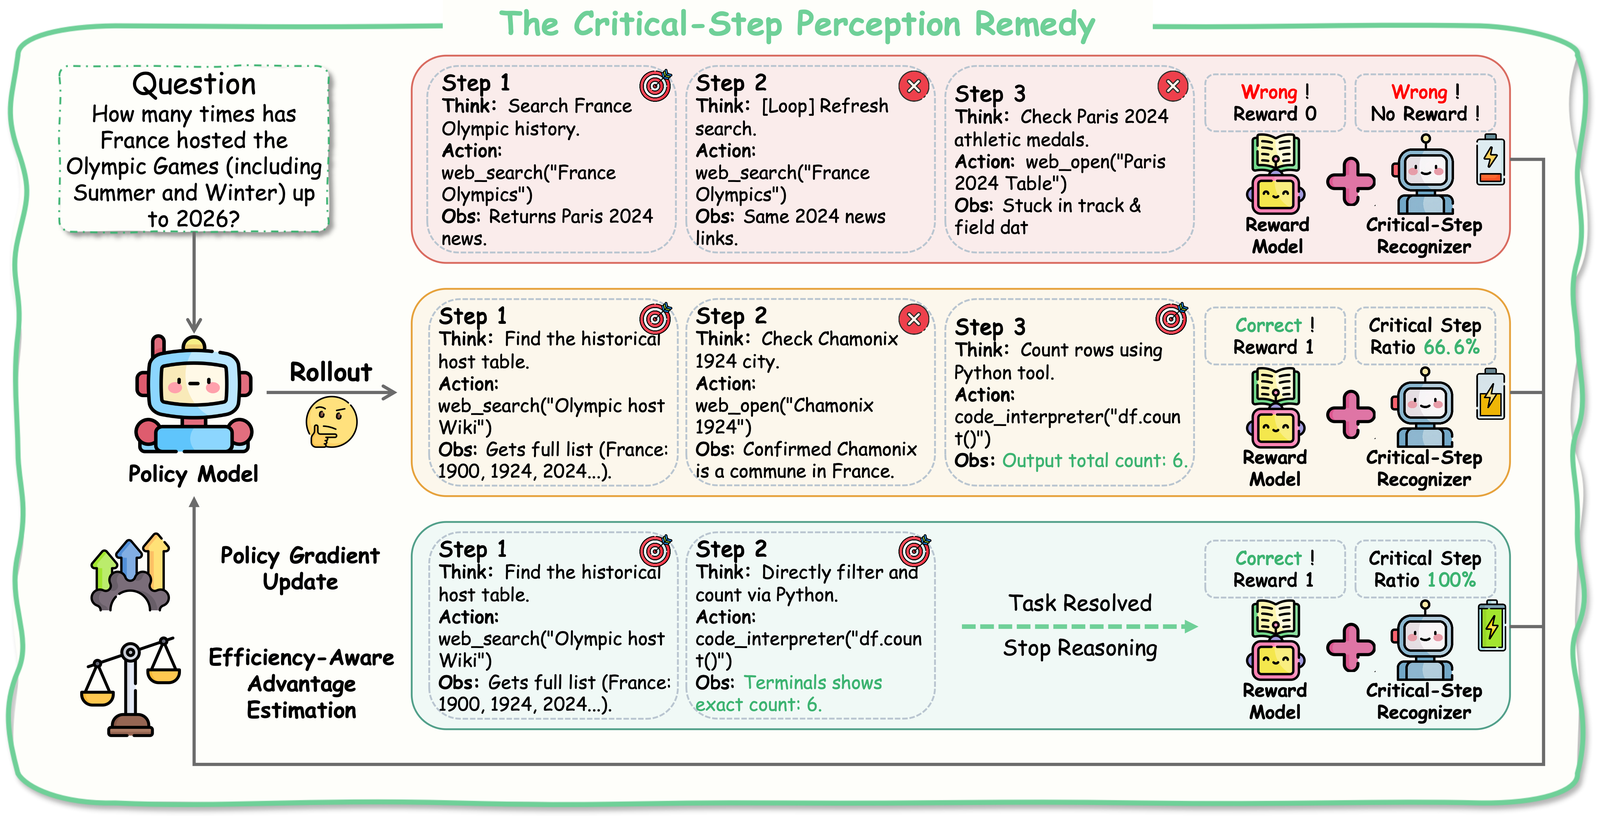
如上图所示,CRISP 的评判机制跳出了单纯计算轨迹长短的传统视角:
-
如果一条轨迹给出了错误答案,无论其多短都不会获得任何效率加成;
-
如果一条轨迹虽然正确,但中间包含了完全无关的探索(例如图中第二条轨迹的 Step 2),那么在计算效率奖励时,冗余步骤会成为分母中的惩罚项,降低该轨迹的关键步比例;
-
只有当一条轨迹中的每一步调用都紧密咬合在最终证据链上时(如图中第三条轨迹),它才能获得最高的效率奖励。
通过这种设计,训练信号明确传达了一个导向:Agent 应该做的是压缩不必要的低效试错,而不是牺牲获取核心事实的必要行动。
CRISP 的三大阶段实现
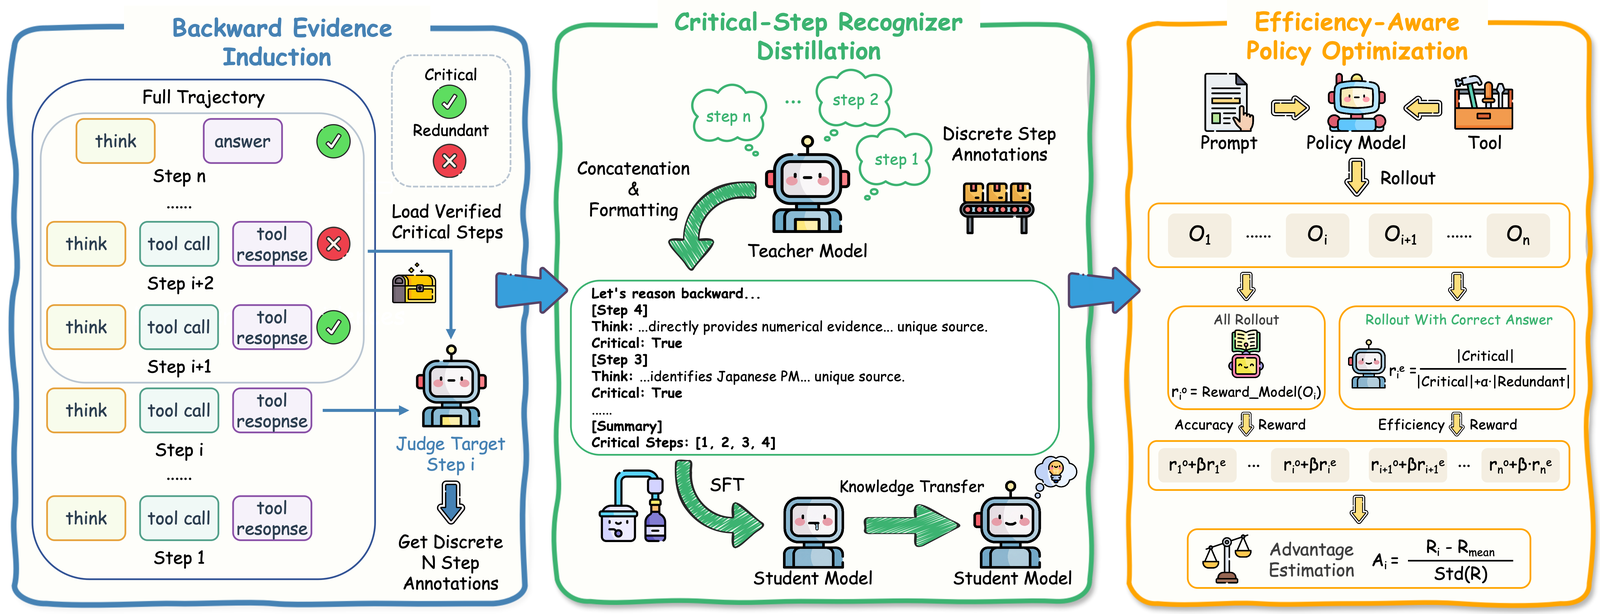
为了在真实的强化学习训练流中稳定落地这一理念,CRISP 构建了一套包含数据标注、轻量化蒸馏与策略优化的三阶段管线。
1. 反向证据归纳:从终点倒推的因果链条
要训练模型感知哪些步骤至关重要,首先需要高质量的关键步标注数据。常规的做法是让一个能力强大的教师模型直接通读整条漫长的交互轨迹,并挑出所有关键步骤。然而在实际操作中,深度搜索的轨迹极长且伴随大量网页文本,直接进行全局提取会给大模型的长文本理解带来极大的负担,极易漏判或误判。
CRISP 提出了“反向证据归纳(Backward Evidence Induction)”。其巧妙之处在于利用了信息因果的时序单向性——从最终生成的正确答案 $\hat{y}$ 出发,沿着轨迹从后往前倒序审视每一个中间交互步骤 $s_i$。
在倒序遍历到第 $i$ 步时,后续已经被确认有效的关键步集合 $\mathcal{V}{i+1}$ 已经清晰地摆在眼前。此时,教师模型 $T\phi$ 只需要解决一个明确的局部二元判断问题:对比最终答案和后续已知证据,当前步骤 $s_i$ 是否提供了增量证据价值?形式化表示为:
\[(c_i, r_i) = T_\phi(x, \hat{y}, s_i, t_{i+1}, \mathcal{V}_{i+1})\]其中 $c_i \in {0, 1}$ 表示该步是否为关键步,$r_i$ 为判别理由。因为有了已知有效证据作为显式参照,教师模型无需在大海捞针般的长上下文中凭空推理,而是能非常敏锐地识别出当前步骤是否与答案相关、抑或只是获取了重复线索。这种化整为零的倒推机制,极大提升了关键步判定的准确性与逻辑一致性。
2. 关键步识别器蒸馏:单次前向的轻量化判别
尽管反向证据归纳质量极高,但它在标注单条轨迹时需要对教师模型进行数十次级联调用。在强化学习策略训练过程中,每一轮采样(Rollout)都会产生大量的动态轨迹,如果实时调用昂贵的教师模型逐步回溯,计算成本将不可承受。
为此,CRISP 将教师模型的逐步回溯判别逻辑,蒸馏至一个轻量级的生成式学生识别器(Critical-Step Recognizer)中。研究团队采用 Qwen3.5-397B-A17B 作为标注教师,将标注好的轨迹按照倒序决策链整合成目标文本,随后对一个 Qwen3.5-9B 参数的模型进行全参数监督微调(SFT)。
训练完成后的学生识别器具备了强大的端到端感知能力:在策略优化阶段,它仅需对生成的完整轨迹进行一次前向推理(Single-Pass),就能一次性输出各交互步骤的关键性标签和总结。这一蒸馏过程成功将回溯判定的计算复杂度摊销到了离线阶段,使得在大规模在线强化学习中对动态轨迹实施过程级评估变得轻便可行。
3. 感知引导的效率策略优化
在具备了实时的关键步感知能力后,CRISP 将其无缝接入到基于群组相对策略优化(GRPO)的强化学习循环中。
对于输入问题 $x$,当前策略模型 $\pi_\theta$ 采样生成一组候选轨迹。识别器对其中回答正确的轨迹进行解析,统计出关键步骤数量 $K_i$ 与冗余步骤数量 $T_i$。为了量化轨迹的证据密度,研究者设计了专门的效率感知奖励函数:
\[R_i^{\mathrm{crit}} = \frac{K_i}{K_i + \alpha T_i}\]这里的超参数 $\alpha$(实验设定为 0.7)控制着对冗余步骤的容忍度。最终组合到强化学习中的总奖励形式极为克制:
\[R_i = R_i^{\mathrm{ans}} + \lambda R_i^{\mathrm{ans}} R_i^{\mathrm{crit}}\]这一公式蕴含着关键的设计权衡:通过将效率奖励 $R_i^{\mathrm{crit}}$ 与正确性奖励 $R_i^{\mathrm{ans}}$ 相乘,确保了效率信号只对成功的轨迹生效;若回答错误,$R_i^{\mathrm{ans}} = 0$,效率奖励直接归零。辅以极小的权重 $\lambda = 0.1$,该机制在数学上严格保证了模型的首要驱动力始终是“答对问题”,效率感知仅作为成功轨迹之间的细粒度优劣排序信号,彻底规避了模型为了刷取效率分而过早截断推理的风险。
实验验证:效率与准确率的双赢
为了检验 CRISP 的实际威力,研究团队以经过深度搜索中训的 GLM-4.5-Air-Midtrain 为基座,在两大公认极具挑战性的搜索评测集上进行了全面测试:
-
BrowseComp:聚焦于网络极深层、难以直接检索到的冷门事实,非常考验长程多跳搜索能力;
-
HLE-Verified:源自 Humanity’s Last Exam 的纯文本子集,包含横跨多学科的高难度问答与计算任务,除搜索浏览外还允许运行代码,是对跨领域复杂推理的严苛考验。
对比基线涵盖了纯答案奖励的标准 GRPO(Vanilla RL)以及代表传统效率惩罚思路的 OTC-GRPO。
在核心指标的表现上,CRISP 展现出了传统方法不具备的优异特性。Vanilla RL 虽然依靠多轮强化学习提升了答案准确率,但代价是轨迹急剧膨胀,在两个基准上分别需要消耗多达 27.65 轮和 10.37 轮的交互。
传统效率基线 OTC-GRPO 确实压低了交互轮数,但代价极为惨重:在 BrowseComp 上其准确率相比 Vanilla RL 下跌了近 6 个百分点,暴露出盲目抑制工具调用对深层证据链的破坏性。
相比之下,CRISP 取得了极佳的平衡点:
-
在 BrowseComp 上,CRISP 将平均交互轮数从 Vanilla RL 的 27.65 轮大幅削减至 23.47 轮(下降 15.1%),同时准确率保持在 34.02% 的高位(超越 OTC-GRPO 达 6.29 个百分点);
-
在 HLE-Verified 上,CRISP 的交互轮数从 10.37 轮直降至 6.93 轮(降幅达 33.2%),答案准确率不仅未受损,反而微增至 33.26%。
这一结果有力证明,在多步推理任务中,消灭冗余步骤与保障充足信息并不互斥。只要奖惩信号能够准确感知证据链的因果价值,系统就能在不伤及核心能力的前提下剔除大量无用开销。
深度剖析:关键步识别与 Agent 行为重塑
CRISP 带来的交互缩减究竟是巧合,还是真正建立在对证据的深度理解之上?研究团队通过多维度的消融与诊断实验揭示了背后的深层机制。
轨迹干预实验验证因果真实性
为了排除“识别器只是随手标注了一些步骤”的质疑,研究者设计了一组极其严格的轨迹干预实验。他们从 HLE-Verified 测试集中抽取样本,将 Vanilla RL 生成的轨迹切除最终答案部分,然后分别施加三种不同的上下文前缀让模型继续生成后续动作并作答:
-
保留全部轨迹(Full Context);
-
仅保留识别器判定为关键的步骤(Critical Steps Only);
-
仅保留识别器判定为冗余的步骤(Redundant Steps Only)。
实验结果呈现出惊人的不对称性:当上下文只保留关键步骤时,模型继续作答的准确率与完整上下文几乎完全一致($\Delta\text{Acc.} = -0.56\%$),而交互总步数还减少了近 3 轮;相反,如果上下文只保留被剔除的“冗余步骤”,模型的答题准确率瞬间暴跌 8 个百分点,同时由于缺乏证据,模型被迫额外发起了更多的盲目重试。这一干预结果从因果层面证实:CRISP 所识别出的关键步骤,确实承载了通向答案的绝大部分核心信息,而冗余步骤被剔除后几乎不会对推理产生实质损害。
同时,在正确解答的轨迹中,CRISP 模型的证据密度(关键步骤占总步骤的比例)展现出了显著提升:BrowseComp 上的证据密度从 34.06% 跃升至 41.09%,HLE-Verified 上则从 42.06% 跃升至 53.09%,相对增幅分别达到 20.6% 和 26.2%。
工具调用模式的结构性分化
细查模型在各类具体工具上的调用频次可以发现,CRISP 并未简单粗暴地减少所有工具的触发。
在需要大范围信息漫游的 BrowseComp 任务中,CRISP 显著降低了宽泛的 Search(搜索)频次,但反直觉地增加了 Browse(网页浏览)的调用量。这意味着模型学会了“克制发问、深入阅读”:不再因为前几次搜索结果不理想就盲目更换关键词疯狂刷屏,而是更有耐心地打开有希望的候选页面提取深层线索。而在偏向计算与精细问答的 HLE-Verified 任务中,Search、Browse 和 Code 的调用量则实现了同步下降。这种随任务特质自适应调整的交互模式,表明模型学到的是针对性极强的证据搜集逻辑,而非机械的动作抑制。
警惕策略塌缩:高熵下的高效探索
对于带有正则化或惩罚性质的强化学习方法,研究者往往会担忧模型陷入“策略塌缩(Policy Collapse)”——即模型为了减少交互,收敛到了几条死记硬背的确定性短路径上,从而失去探索多样性。
为了验证这一点,研究人员进行了一项拔除实验:在 HLE-Verified 上将 CRISP 训练出来的模型与 Vanilla RL 模型置于相同的环境,完全撤掉效率感知奖励,仅保留最终答案奖励继续训练。
测试显示,在剥离效率奖励后,CRISP 模型依然保持了平均 6.43 轮的超短交互路径(Vanilla RL 为 10.18 轮),准确率维持在 33.71% 的顶峰水平;更引人注目的是其策略熵(Policy Entropy)高达 0.672,远超 Vanilla RL 的 0.405。更高的策略熵表明,CRISP 在大幅精简交互步骤的同时,其动作概率分布依然宽阔且具备高度多样性。这充分证明了高效搜索已经固化为模型的内在能力,而非在外在惩罚逼迫下的僵硬苟活。
执行可靠性的意外提升
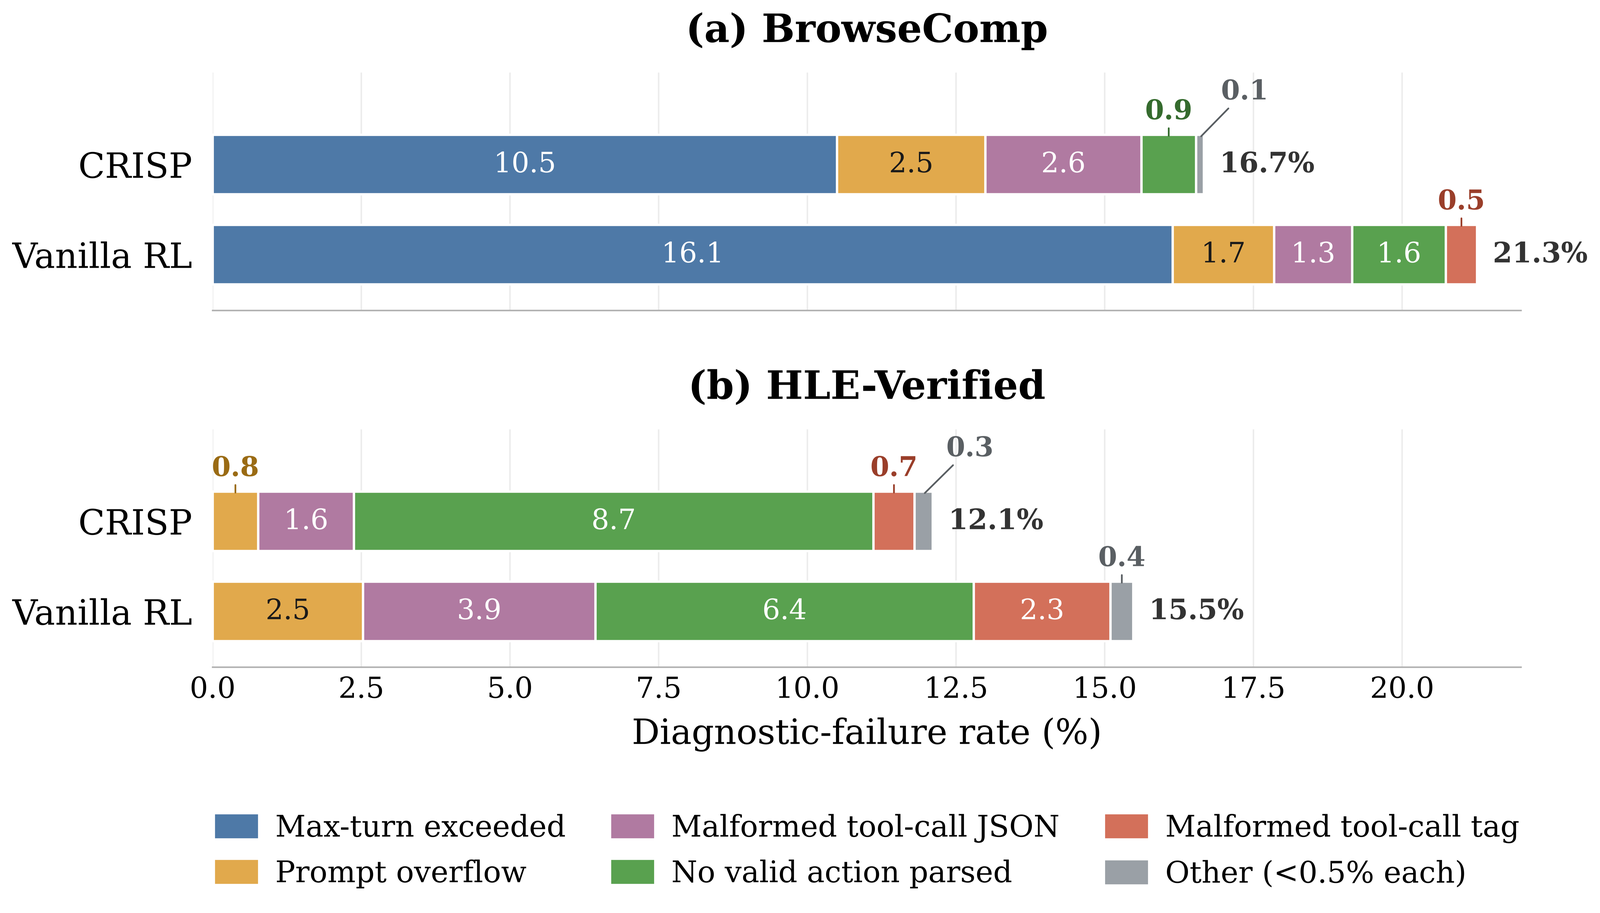
轨迹过长带来的另一个隐性灾难是执行失败率。在现实工程环境中,Agent 的交互步数越多,触发超长上下文溢出、达到最大轮数被强制截断、或者在格式解析上出错的概率就呈指数级上升。
如上图的错误诊断所示,CRISP 在压缩无用交互的同时,带来了端到端系统稳定性的巨大红利:在 BrowseComp 和 HLE-Verified 上的执行失败率分别实现了 21.6% 和 21.8% 的相对降幅。在 BrowseComp 中,因触顶最大步数(Max Turns Exceeded)而导致的失败大幅锐减;在 HLE-Verified 中,上下文溢出(Prompt Overflow)和工具格式解析错误(Tool Format Parsing Error)也显著降低。这表明,剔除冗余步骤不仅节约了 Token,还直接净化了模型的注意力空间,使系统在复杂长程任务中变得更加鲁棒。
结语与前瞻
深度搜索技术正在将大语言模型从传统的静态问答机器,转变为具备信息捕获与验证能力的真正自主体。然而,漫无目的的交互漫游与高昂的试错开销,长久以来横亘在实验室演示与低延迟工业落地之间。
CRISP 的探索给出了一种极具启发性的思路:在训练长程决策智能体时,我们不必在“能力上限”与“交互成本”之间做零和博弈。以往效率优化的症结,在于用宏观的步数惩罚掩盖了微观的证据价值。通过引入反向证据归纳与高效的学生识别器,CRISP 成功让强化学习感知到了轨迹内部的“因果含金量”。
这种基于因果证据密度的过程引导范式,不仅为构建更轻快、更可靠的 Deep Research 类产品铺平了道路,也为未来更广泛的长程具身智能、自主代码工程等长轨迹 Agent 的精细化训练提供了极有价值的借鉴方向。