AGT:不是静态单次压缩,而是让大模型在多步推理中动态“索取”图Token
Agentic Graph Token Reasoning
在处理学术引用、社交网络、电商推荐以及蛋白质分子等关系密集型数据时,文本属性图(Text-Attributed Graphs, TAGs)已成为连接结构化知识与非结构化语义的通用载体。近两年来,借助大语言模型(LLM)强大的通用理解能力来分析图结构,演进出了一条极具前景的技术路线。在这条路线上,最契合图原生特性的一类方法被称为“图 Token”(Graph Token):利用图神经网络(GNN)将目标节点的局部拓扑和属性压缩成一段固定长度的连续向量(Soft Tokens),直接拼接进大模型的 Prompt 中供其阅读。诸如 LLaGA、GOFA、GraphGPT 以及 GraphTranslator 等代表性工作,都是基于这一范式展开的。
ArXiv URL:https://arxiv.org/abs/2608.00542
然而,现存所有的图 Token 方案几乎都存在一个隐秘却根本的瓶颈——它们处理图信息的方式是完全“静态且单次”(Static Single-shot)的。在模型还没看清具体问题、尚未展开任何推导之前,系统就已经通过预设模板决定了要编码哪种视图(例如固定抽取 2-hop 邻域),完成单次编码后便再无修改机会;大模型必须在单次前向传播中同时消化文本与图向量,并直接给出最终答案。这种机制割裂了大模型最擅长的分步推理能力。对于简单节点,预编码整个邻域显得冗余甚至引入噪声;而对于拓扑极其复杂的疑难样本,仅仅依靠预先给定的单一局部视图,模型根本无法获取后续推理所需的关键上下文。
针对这一困境,研究者提出了 AGT(Agentic Graph Token Reasoning,智能体图 Token 推理) 框架。这项工作的突破之处在于:它没有继续在“如何把子图压缩得更紧凑”上打转,而是从底层将图的 Token 化(Tokenization)过程重构为大模型自主推理闭环的一部分。面对一个复杂的图上查询,大模型不再被动接受一段冷冰冰的静态向量,而是化身为能够主动决策的智能体——在每一步推理中根据已掌握的线索,自主判断接下来需要调取哪种粒度、多大范围的图视图;GNN 编码器则按需响应、即时生成对应的图 Token 并动态追加到上下文中,驱动推理轨迹在图 Token 潜空间内步步递进,直至最终得出可靠结论。
在涵盖引用网络、商品共购、社交平台以及生物分子交互等 7 个不同领域的图基准测试中,AGT 在相同底座模型(Qwen2.5-3B 与 7B)下全面超越了已有的静态图 Token 模型和纯文本检索类 Agent,并在未经任何微调的零样本跨域迁移中展现出了极强的泛化鲁棒性。
从“开卷一瞥”到“按需索取”:为什么图分析亟需多步推理?
要理解 AGT 的立意,首先要审视传统图大模型在推理机制上的天然缺陷。
设想一个经典的生物计算任务:预测某个蛋白质在细胞内的生物学功能。对于那些研究充分、已知特征极多的蛋白质,仅仅阅读其自身的注释文本可能就已经足够得出结论;对于特征相对模糊的蛋白质,判断往往依赖于其直接相互作用的邻居伙伴;而对于极少被研究的孤僻蛋白质,孤立的局部连边甚至会造成误导,大模型必须将视线扩展到更大的代谢通路或功能聚类社区(Cluster),才能在全局结构中推断其角色。
这种对信息广度与深度的动态需求,意味着最优的图上下文是高度依赖于具体样本与推理阶段的,绝不可能在推理开始前被静态穷举或预先锁定。
以往的静态图 Token 方法(如图 1a 所示)试图用一种“一刀切”的预处理来解决问题:输入图 $\mathcal{G}$ 与问题 $Q$ 后,固定调用 $f^{\mathrm{GNN}}$ 将预定义的视图 $G^V$ 映射为图向量 $\mathbf{Z}$,随后让大模型 $f^{\mathrm{LLM}}(Q, \mathbf{Z})$ 一次性生成答案 $A$。这种设计把所有的结构表征压力孤注一掷地压在最初选定的视图上:选得太窄,证据缺失;选得太宽,有效信号被稀释;更致命的是,一旦大模型在生成过程中意识到关键证据不足,它没有任何手段去“索取”更多图信息。
与此同时,以 AgentGL 为代表的文本交互型图智能体虽然引入了多步探索机制,但它们探索图的方式严重退化到了自然语言层面——通过向图数据库发出文本查询,读取序列化的节点属性文本。这种“文本口述拓扑”的方式不仅极其消耗上下文窗口,而且文本对高阶图拓扑、连续距离和隐式聚类特征的表达极为笨拙。
AGT 正是切中了这两条技术路线之间的断层:保留连续图 Token 紧凑、原生地编码图拓扑与多模态属性的优势,同时赋予大模型以智能体(Agentic)形式在推理中按需触发图编码的能力。
在 AGT 的运行时交互中,推理轨迹从初始问题 $\tau_0 = Q$ 开始。在第 $t$ 步,语言模型基于当前累积的轨迹 $\tau_{t-1}$ 输出一个离散动作 $a_t$。该动作指定了本次要查询的图视图 $G^{V_t}$ 及其粒度,系统随后调用图编码器即时物化出连续向量块 $\mathbf{Z}^{\mathrm{AGT}}_t = f^{\mathrm{GNN}}(G^{V_t})$,并将其无缝拼接回上下文序列中:
\[\tau_t = (\tau_{t-1}, a_t, \mathbf{Z}^{\mathrm{AGT}}_t)\]模型在此基础上继续思考,决定是发起下一步图查询,还是发出终止动作输出最终答案 $A$。图结构由此不再是静止的背景板,而是随着推导过程不断延展的连续潜空间证据流。
为了支持这种灵活的图空间导航,本文定义了一个兼顾局部与全局的动作空间 $\mathcal{A}$,涵盖了目标节点自身表征(node_token)、不同距离的拓扑邻域(one_hop_token、two_hop_token、three_hop_token)、图结构聚类语义(cluster_token)、全局语义检索相近节点(retrieval_token),以及针对节点对关系预测的语义相似度度量(cosine_similarity)。大模型可以自由组合这些动作,编织出因题而异的探索路径。
驯服多模态图智能体:三阶段训练体系
让一个基于文本预训练的 LLM 能够理解未经词表映射的连续图向量,并学会何时、以何种粒度去调用这些向量,是一个极度不平庸的挑战。更深层的痛点在于:当大模型同时面对自然语言 Prompt 和连续图向量时,由于先验习惯,模型极其容易产生“偷懒”心理——完全依赖节点的自然语言描述来猜测答案,把图 Token 当作可有可无的摆设。一旦遭遇节点文本缺失或存在误导性描述的困难样本,这种脆弱的捷径便会彻底瓦解。
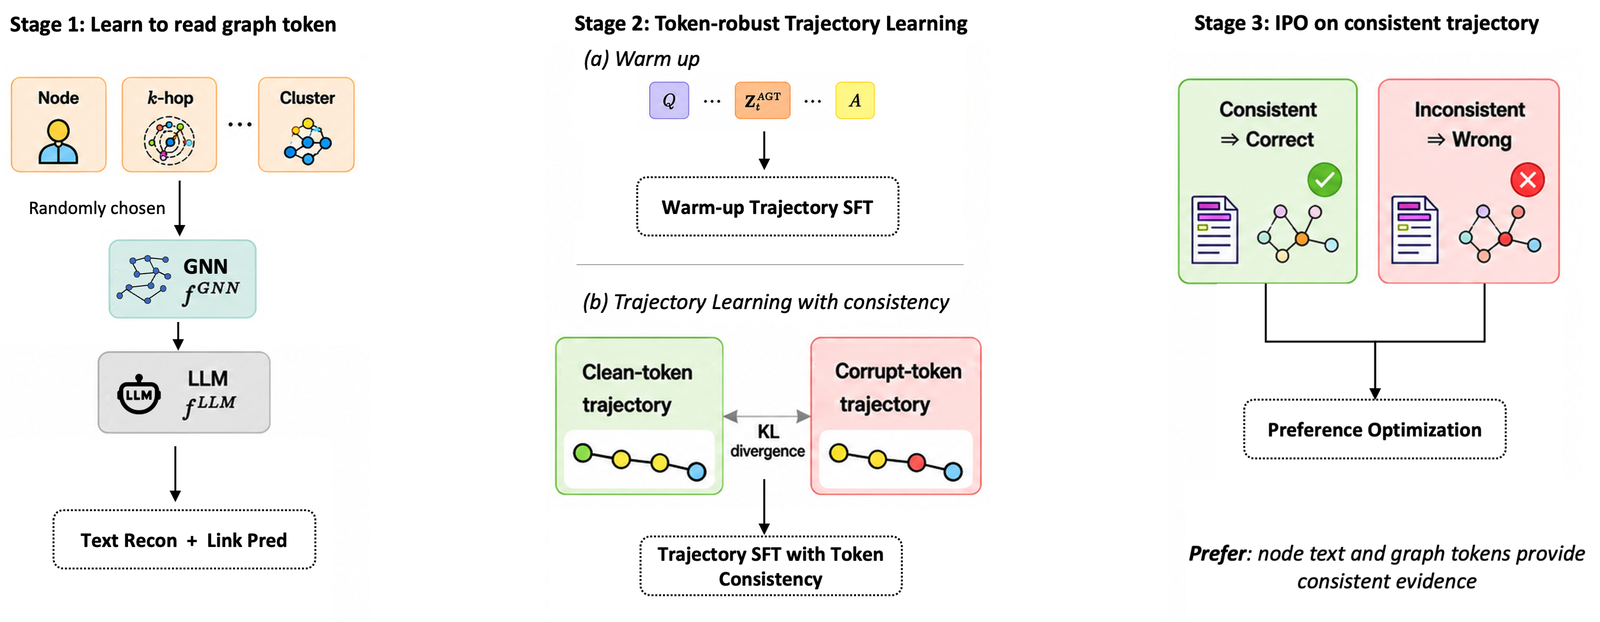
为此,作者构建了一套环环相扣的三阶段训练流水线,自底向上攻克图 Token 的语义接地、动作决策与真实图依赖问题。
第一阶段:自监督预训练,教会模型“读懂”异构图向量
连续图向量 $\mathbf{Z}^{\mathrm{AGT}}$ 在大模型的词表中没有任何对应词素,冷启动直接进行策略微调必然导致梯度崩溃。第一阶段的目标非常纯粹:让语言模型建立起连续图向量与图结构/语义信息之间的底层映射。
作者设计了两个不依赖下游任务标注的通用自监督任务:
-
文本重构(Text Reconstruction):输入某个节点的图 Token 块,要求大模型在语言空间重构该节点的原始标题与正文摘要。这一目标强迫 GNN 编码器在压缩过程中保留完整的属性语义,并迫使 LLM 能够从抽象向量中解码出语义内容。
-
遮掩边预测(Masked Link Prediction):向模型输入节点 $v$ 的图 Token 以及候选节点 $w$ 的表征,要求模型回答 $v$ 与 $w$ 之间是否存在边(预先剔除所有验证集和测试集涉及的边)。这一目标强迫图向量必须显式编码局部的拓扑连接结构。
在第一阶段的交叉熵损失中,图 Token 仅作为条件输入参与前向计算,位置不计入损失。通过这两个基础任务,GNN 编码器与 LLM 投影头实现了联合对齐,使得模型具备了读取不同动作返回的异构图 Token 块的基础能力。
第二阶段:轨迹微调与扰动一致性正则(CRJT)
具备了基础读取能力后,大模型必须学会“如何作为智能体去行动”——即针对给定的图分析任务,产生合理的多步动作调用序列,并整合多块图 Token 推导出正确答案。
在第二阶段,研究者合成了包含变长动作序列的高质量推理轨迹数据,引导模型进行监督微调(SFT)。但在实践中发现,如果仅在干净的图表征上做简单的行为克隆,大模型极易拟合到某些图 Token 块内部的局部表面线索(Surface Cues),其表现极其脆弱。为了迫使大模型真正理解拓扑语义的内涵,作者引入了图 Token 一致性正则项(Consistency Regulariser on Jittered Tokens, CRJT)。
具体而言,模型同时接收干净图视图生成的标准编码,以及经过扰动处理的增强编码(在图结构上施加边随机丢弃 edge-drop,并在向量维度施加随机掩码 token-mask)。随后,利用 KL 散度约束模型在扰动向量输入下的预测分布去逼近干净向量输入下的分布:
\[\mathcal{L}_2 = \mathcal{L}_{\text{CE}}^{\text{clean}} + \lambda_{\text{KL}} \, \mathrm{KL}\Bigl(\mathrm{sg}\bigl[p^{\text{clean}}\bigr] \,\big\|\, p^{\text{aug}}\Bigr)\]其中 $\mathrm{sg}[\cdot]$ 为停止梯度操作,干净分支作为稳定的教师指导扰动分支。由于这些数据增强直接干扰了图信号的浅层模式,强制分布对齐迫使 LLM 的注意力机制必须去挖掘那些在扰动下依然留存的深层拓扑不变特征。
第三阶段:图-文本一致性偏好对齐(IPO),切断纯文本作弊
前两个阶段让图 Token 变得可读且稳健,但依然没有根除大模型“走捷径”的顽疾。在实际图数据集中,节点的自述文本往往包含大量显性标签线索(例如计算机科学论文的标题经常包含“Neural Networks”等词汇)。模型只要通过文本就能拿到高分,就会在推理过程中无视图 Token,导致其在拓扑关键型任务上表现乏力。更关键的是,普通的 SFT 只能看到正确的示范,模型从未经历过“文本与图发生冲突时该信谁”的辨别训练。
第三阶段正是为了打破这种侥幸心理。作者没有采用依赖人工主观打分的大模型偏好对齐,而是精巧地以图文一致性为锚点构建了偏好对比对 $(\tau^+, \tau^-)$:
-
正向轨迹($\tau^+$):保留节点原有的输入文本,模型调用图 Token 并给出正确推导;
-
负向轨迹($\tau^-$):故意对节点的输入文本进行扰动与对抗篡改(使其表面文本偏向错误类别),如果模型缺乏对真实图拓扑的依赖,其推理轨迹就会被错误的文本带偏,产生自相矛盾的推导并得出错误结论。
借助这种成对数据,研究采用恒等偏好优化(Identity Preference Optimization, IPO)来微调策略:
\[\mathcal{L}_3 = \mathbb{E}_{(\tau^+, \tau^-)}\!\left[\Bigl(h(\tau^+) - h(\tau^-) - \frac{1}{2\beta}\Bigr)^2\right]\]其中 $h(\tau)$ 是策略模型相对于第二阶段参考模型的隐式奖励对数比率。相比于容易在小规模分布上出现梯度无界发散的 DPO,IPO 采用二次惩罚项,能够提供更加平滑且有界的优化动态。通过这一阶段的偏好校准,大模型被严厉惩罚了那些轻信节点被篡改文本、背离图证据的推理模式,真正学会了将图 Token 视为不可动摇的决策基石。
领域内与零样本评测:全方位的性能跃升
为了全面检验 AGT 的推理与泛化实力,实验评测在涵盖学术引用网络(ogbn-arxiv, arXiv-2023, PubMed, CiteSeer)、电商共购与评价网络(ogbn-products, Amazon-Computers, Amazon-Photo)、社交网络(Reddit)以及蛋白质相互作用网络(STRING-db)的 10 个代表性数据集上展开,核心任务包括节点分类(Node Classification)与遮掩链接预测(Masked Link Prediction)。所有同底座基线均在完全统一的数据划分和采样协议下重新测试。
在领域内基准测试中,无论是选用 Qwen2.5-3B 还是参数量更大的 Qwen2.5-7B,AGT 都展现出超越现有最强基准的统治力。
当以 Qwen2.5-7B 为骨干网络时,AGT 在规模庞大且结构复杂的 ogbn-arxiv 上取得了 75.6% 的节点分类准确率,在电商图 ogbn-products 上更达到了 80.1%,不仅大幅甩开了传统的 GNN 模型(如 GraphSAGE 的 71.4% 和 78.7%),也全面超越了以静态单次编码著称的图大模型 LLaGA、GOFA,以及先前最先进的文本搜索型智能体 AgentGL-7B。这种性能优势在更难依赖纯文本词汇表面的链接预测任务(Masked Link Prediction)上表现得尤为明显:在多个领域的链路 AUC 评测中,AGT 均创造了相同底座下的最优成绩。
更为严苛的考验在于零样本跨领域迁移(Zero-shot Transfer)。在真实工业场景中,往往没有算力或标注数据去为每一个新出现的图网络从头微调一套模型。研究者直接提取仅在学术引用图 ogbn-arxiv 上训练完成的 AGT 检查点,在完全不进行任何参数更新与目标域微调的前提下,直接迁移到其他 7 个完全未见过的目标图上进行测试。
测试结果揭示了极富启发性的规律:
在包含 3 个宏观医学分类的 PubMed 数据集上,AGT 凭借强大的跨域图语义推断能力,取得了高达 82.0% 的零样本分类准确率;即便面对类别数高达 21 类、生物物理机制极其晦涩复杂的蛋白质相互作用网络 STRING-db,AGT 依然斩获了 37.4% 的准确率。在全部 7 个迁移目标域中,AGT 在其中的 6 个数据集上以显著优势位列榜首,平均表现远超 LLaGA 与基于强化学习的 AgentGL。
这一迁移结果提供了强有力的证据:大模型在 AGT 框架下所习得的,不再是特定图结构上的静态记忆或某些特定文本词频的浅层关联,而是一种通用的“图拓扑探索策略”。模型学会了何时查看近邻、何时需要聚类、何时比对全局语义节点,这种探索范式能够自然地投射到完全陌生的拓扑空间中。
深入消融与机制洞察:是什么在驱动性能增益?
AGT 亮眼的实验表现,究竟归功于训练流水线中的一致性约束,还是得益于多粒度图动作的协同配合?论文的消融实验(基于 Qwen2.5-3B)给出了清晰的归因解答。
1. 扰动一致性正则(CRJT)的决定性价值
在训练流水线的组件消融中,去除第二阶段的 CRJT 正则项给模型性能带来了极其沉重的打击。在各个评估领域的平均指标上,去掉 CRJT 会导致节点分类准确率直接下滑 1.9 个百分点,而在结构依赖度极高的链接预测任务上,平均性能剧烈暴跌了 5.1 个百分点。
实验分析显示,在没有 CRJT 的情况下,语言模型容易将 GNN 编码出的图向量仅仅视为一种“较弱的先验信息”,在解码过程中倾向于草草调用浅层节点特征后便匆忙作答;而在加入 CRJT 约束后,大模型被强制要求关注那些抗扰动的高阶拓扑信息,在贪婪解码推导时调用 cluster_token 和 three_hop_token 等深层宏观动作的频率大幅上升。更深广的拓扑感知被激活,直接转化为了推理精度的全面提升。
2. 动作空间的协同分工
逐一剔除动作空间中特定操作的实验,揭示了大模型在处理不同图分析任务时截然不同的依赖逻辑:
-
节点分类任务对邻域拓扑动作表现出了极强的依赖性。当消融掉邻居相关动作(1-hop / 2-hop / 3-hop tokens)时,分类性能出现了断崖式下跌。这一现象证伪了“节点自身属性决定一切”的假设,确证了高阶拓扑信号才是模型准确完成图节点分类的核心驱动力。相比之下,单节点自身特征、全局检索与社群聚类动作提供了重要但相对平缓的增益补充。
-
链接预测任务则呈现出完全不同的动态。判断两个节点之间是否存在连边,本质是在比对两个实体在图空间中的拓扑亲疏与属性兼容性。消融数据显示,度量节点表征方向一致性的
cosine_similarity动作在此任务中成为了胜负手——在 ogbn-products 上移除该动作直接导致链路预测 AUC 狂跌了 32.6 个百分点;紧随其后的是单个端点的独立表征node_token,在 PubMed 上剥离该动作会造成 13.4 个百分点的 AUC 损失。
这组消融实验有力地证明了 AGT 动作空间设计的精炼性与合理性:不同类型的拓扑问答需要不同维度的结构证据,而一个具备丰富粒度、能够按需触发的图动作集合,是大模型灵活应对复杂异构任务的前提保障。
从静态表征走向图原生智能体
长期以来,利用大语言模型解决图结构问题的研究一直处于两难的权衡之中:一派主张全面拥抱自然语言描述,将图的边和邻居用自然语言硬性展平,虽然保留了多轮推理的灵活性,却让模型在冗长的拓扑描述中迷失,计算代价高昂且表征效率极低;另一派则坚持图原生的向量压缩,用 GNN 将子图打包成连续图 Token,虽然计算紧凑且拓扑表达精准,却把整个推导过程锁死在静态单次的开卷预测中,丢弃了智能体动态反思与自适应采样的特权。
AGT 的提出,打破了这一非此即彼的传统设定。它把图 Token 从静态的前置输入,转变成为了推理过程中由策略模型随需调用的原生计算工具;它证明了大模型不仅能用自然语言进行 Chain-of-Thought(思维链)推导,同样能够在离散动作与连续图向量交织的混合空间内展开稳健的多步探索。
这种将图神经网络视为即时工具库、让大语言模型充当拓扑调度中枢的架构设计,不仅为文本属性图分析设立了新的性能标杆,也为未来融合多模态结构数据的具身智能与大模型智能体系统,提供了一条极具说服力的演进范式。