AnchorKV:不丢弃任何Token实现20倍KV缓存压缩,70B模型保留99%精度
AnchorKV: Anchor-Residual KV Cache Compression
长文本大语言模型在当下的应用场景越来越广泛,从整座代码仓库的重构、几十万字的财报研读,到支持多轮复杂推理的智能体系统,上下文长度动辄攀升至 128K 甚至更长。但在实际部署中,阻碍模型落地的往往不是前向计算的浮点算力,而是显存带宽与容量。在 128K 上下文下,仅单条 Llama-3.1-8B 的 BF16 键值对缓存(KV Cache)就会膨胀至 16 GiB,已经与模型本体权重相当;如果换成 70B 级别的基座模型,多并发部署基本成为天方夜谭。
ArXiv URL:https://arxiv.org/abs/2608.02901
面对 KV 缓存的显存雪崩,业界长期存在两大主流解法,但它们分别走向了两个无法兼顾的极端。一类是缓存淘汰(Eviction),例如 SnapKV、PyramidKV 和 AdaKV 等,通过特定算法给 Token 打分并永久丢弃低分项。这类方法能实现极高的理论压缩比,可它的致命缺陷是决策不可逆——在预填充(Prefill)阶段未被注意到的关键信息一旦被剔除,后续解码生成时若产生新的检索需求,模型将彻底“失忆”。另一类是低比特量化(Quantization),它坚持保留所有 Token,尝试把向量压缩到 2-bit 或 4-bit。然而,当精度压缩到 2-bit 以下时模型表现会出现断崖式下跌,这使得纯量化方法的压缩极限通常被死死卡在 4 到 5 倍左右。
最新提出的 AnchorKV 彻底打破了这种两难困境。它在不丢弃任何一个 Token 位置的前提下,将 KV 缓存体积压缩了整整 20 倍。在 70B 参数规模的模型上,AnchorKV 在 20 倍极致压缩下依然保留了未压缩基准 99.3% 的综合性能;而在多任务检索和长文本大海捞针测试中,它展现出了淘汰类方案无法企及的鲁棒性。
淘汰与量化的死局:为什么长文本压缩需要第三条路?
理解 AnchorKV 的突破,首先要看清现有技术方案到底被什么机制卡住了脖子。
淘汰类方案的核心假设是“注意力具有稀疏性”。在这类方案中,模型利用预填充末尾的观察窗口,计算哪些上下文 Token 获得了较高的注意力权重,然后把权重低的位置直接从显存中物理抹去。保留下来的少量 Token 依然维持原生的 BF16 精度。在一些结构简单的单一文档摘要任务中,这种假设往往有效;但一旦遭遇复杂的多跳推理、分散在多处的干扰项检索,或者长跨度的综合统计任务,这种预先筛选机制就会全面崩溃。原因在于,预填充末尾的 Query 向量根本无法代表后续几十步、上百步自回归解码时可能产生的全部 Query 语义。只要淘汰机制误判并扔掉了某一个关键 Token,该位置就永远退出了 Softmax 的归一化集合。这种“一刀切”的硬性截断,构成了淘汰算法难以逾越的性能下限。
量化类方案则选择了“保全上下文”,但受制于表征维度的信息熵。要把高维向量压入更低比特,工程上通常需要处理数值异常点(Outliers)以及动态范围收缩的问题。即使引入随机旋转等先进投影技巧,将浮点权重直接压制到 2-bit 时,注意力权重分布依然会发生严重畸变。换言之,量化方案保障了“位置的连贯性”,却无法在显存极端受限的场景下维持“数值的准确性”。
这就逼出了一个根本性的技术问题:能不能既不缩减序列长度、不改变 Softmax 的分母集合,又让每个 Token 占用的显存字节数降到趋近于零?
AnchorKV 的回答是重构 KV 向量的几何存储形式——放弃为每一个 Token 独立存储庞大的稠密高维向量,转而采用一种“锚点-残差”(Anchor-Residual)的近似表征。
锚点与残差:如何用几字节表征一个高维向量?
在 Transformer 模型的注意力头中,不同 Token 经过线性变换后生成的 Key 和 Value 向量并不是在整个高维空间中完全各向同性发散的,它们往往聚集在某些特定的语义子空间内。这意味着在几何形态上,许多上下文 Token 之间存在着极强的共线性或方向相似度。
AnchorKV 敏锐地抓住了这一几何冗余。在预填充结束时,算法会为每个注意力的 Key 和 Value 头挑出一小部分最具代表性的 Token 作为锚点(Anchors)。这些锚点被原汁原味地以 BF16 完整精度存入显存。而对于序列中剩下的绝大多数普通 Token,AnchorKV 不再为它们保留独立的稠密向量,而是将它们投影到与其方向最近的单个锚点所在的射线上。
\[a(i) = \arg\max_{a\in\mathcal{A}} \frac{\left\vert{}\langle x_{i}, x_{a}\rangle\right\vert{}}{\lVert x_{i}\rVert \lVert x_{a}\rVert}\] \[\gamma_{i} = \frac{\langle x_{i}, x_{a(i)}\rangle}{\lVert x_{a(i)}\rVert^{2}}, \quad \tilde{x}_{i} = \gamma_{i} x_{a(i)}, \quad r_{i} = x_{i} - \tilde{x}_{i}\]其中 $x_i$ 代表当前 Token 的 Key 或 Value 向量,$x_a$ 为选出的锚点集合。对于任意非锚点 Token,我们只需要记录两个轻量级元数据:最近锚点的索引号以及沿该锚点方向的标量缩放系数 $\gamma_i$。由于这个标量系数已经吸收了模长比例,重构向量 $\tilde{x}_i$ 只需做一次标量与向量的数乘。
这种设计的精妙之处在于显存开销的断崖式下降。一个维度为 $D=128$ 的 BF16 向量原本需要占用 256 字节,而一个锚点索引加上一个浮点系数,只需要区区几字节。更重要的是,因为每个 Token 都保留了独立的缩放系数 $\gamma_i$,序列中的 Token 并没有在投影后坍缩为完全相同的同质向量,Softmax 依然具备区分不同位置的能力。
但纯粹的单方向投影显然会遗失正交方向的分量。如果某一个 Token 碰巧与所有锚点的夹角都比较大,直接用投影代替就会引入显著的残差向量 $r_i$。此时,AnchorKV 引入了第二道防线:选择性残差补偿。
对于整个上下文中那些如果被粗糙近似就会严重干扰注意力最终输出的敏感 Token,AnchorKV 会在显存预算允许的范围内,为它们额外分配一个超低比特的量化残差 $\tilde{r}_i$:
\[\hat{x}_{i} = \tilde{x}_{i} + \mathbf{1}[i\in\mathcal{R}]\,\tilde{r}_{i}\]为了将残差高效压入 2-bit,AnchorKV 引入了一套紧凑的编解码方案。在量化之前,残差向量会先经过一个随机阿达马变换(Randomized Hadamard Transform)。这一变换的数学性质在于将原本可能集中在个别通道上的数值尖峰(Outliers)均匀打散到所有维度上,使其呈现出接近单峰高斯分布的理想统计特性。紧接着,算法利用针对标准高斯分布优化过的 4 电平 Lloyd–Max 码本进行 2-bit 量化,并按每字节 4 个数值进行位打包。每个残差因此仅需 $D/4$ 字节再加上一个逐 Token 的绝对最大值缩放系数,就把近似误差压制到了极低水平。
显存预算分配:从输出误差反推残差归属
显存预算是极其昂贵的硬约束。在给定了压缩目标(例如保留原始缓存的 $5\%$,即 20 倍压缩)之后,模型可以挥霍的字节数已经被死死卡住。AnchorKV 究竟凭什么决定哪些 Token 只能享受“锚点投影”,哪些 Token 配得上获得珍贵的“2-bit 残差”?
以往的方法常常陷入片面的指标误区:要么只看注意力分数(以为关注度高的 Token 一定重要),要么只看残差本身的范数 $\lVert r_i\rVert$(以为逼近误差大的 Token 一定要补救)。AnchorKV 的研究者指出,这两种单维度指标都是片面的。如果一个 Token 虽然与锚点偏差很大,但在解码时根本不会被分配到注意力,那么修复它纯属浪费显存;反之,若一个 Token 虽然被高度关注,但它本身已经被其最近的锚点贴合得天衣无缝,额外加上残差对输出结果的改变微乎其微。
真正决定系统表现的,是近似误差对注意力层最终输出向量引入的一阶扰动量 $\Delta y$。注意力层输出为 $y = \sum_t \alpha_t V_t$,当 Key 和 Value 分别产生微小扰动时,输出误差可以分解为:
\[\Delta y \approx \sum_{t}\alpha_{t}\left(\Delta s_{t}-\overline{\Delta s}\right)\left(V_{t}-y\right) + \sum_{t}\alpha_{t}\Delta V_{t}\]基于这一数学展开,AnchorKV 推导出了衡量每个位置残差效用(Utility)的一阶评估公式:
\[u_{t}^{K} = \frac{1}{m}\sum_{w=1}^{m}\left(\alpha_{t}^{(w)}\right)^{2}\frac{\left(q^{(w)\top}R_{t}r_{t}^{K}\right)^{2}}{D}\left\lVert V_{t}-y^{(w)}\right\rVert^{2}\] \[u_{t}^{V} = \frac{1}{m}\sum_{w=1}^{m}\left(\alpha_{t}^{(w)}\right)^{2}\left\lVert r_{t}^{V}\right\rVert^{2}\]这两个公式极其清晰地体现了物理意义:
-
Key 通道的残差效用,综合考量了该位置的注意力权重平方、残差在 Query 方向上的投影强度,以及该 Token 的 Value 向量偏离当前注意力期望重心的距离。如果这三者都很大,说明 Key 的误差会剧烈扭曲注意力权重的归一化分布,进而导致最终输出严重失真。
-
Value 通道的残差效用,则直接正比于注意力权重平方与 Value 残差模长平方的乘积。
有了这一效用评分体系,AnchorKV 的全局显存编排变得非常清晰。在预填充结束时,系统首先扣除必须保留的硬性开销:最近 $W$ 个 Token 的滑动窗口(不仅用来保留最近上下文,还直接作为锚点并充当观测查询)、少量均匀采样和高注意力采样的锚点向量,以及所有非锚点位置的元数据指针。剩下的全部显存字节,被精确换算为可分配的残差配额 $N$。更重要的是,残差配额并不是机械地在各个头之间平分,而是在整个网络层的所有注意力头之间集中竞价。哪个头由于语义信息丰富、注意力分散而累积了更高的输出误差风险,更多的残差配额就会向哪个头倾斜。
这里还隐藏着一个对旋转位置编码(RoPE)的工程考量。RoPE 赋予了每个绝对位置不同的旋转矩阵,这会人为破坏未加位置编码前向量的方向共线性。AnchorKV 的做法是将 Key 向量在施加 RoPE 之前进行锚点匹配与投影。由于 RoPE 本身是一个正交线性算子,它对线性分解具备分配律($R_t K_t = R_t \tilde{K}_t + R_t r_t^K$)。模型可以在预填充时存储未旋转的紧凑表征,仅在后续解码重构时再动态打上位置旋转,完美规避了位置编码带来的空间畸变。
实验全景:20倍压缩下的断崖式领先
为了检验这种全新机制在真实严苛环境下的表现,研究团队在 Llama-3.1-8B、Mistral-Small-24B 和 Llama-3.1-70B 三种主流尺度模型上,对 AnchorKV 进行了全方位基准压测。对比对象包括未压缩的完整缓存(FullKV)、三大主流淘汰机制(SnapKV、PyramidKV、AdaKV),以及先进的保全上下文量化方法 TurboQuant。所有测试都在绝对严格的“逐层字节数对齐”下进行,杜绝因元数据统计模糊造成的偏差。
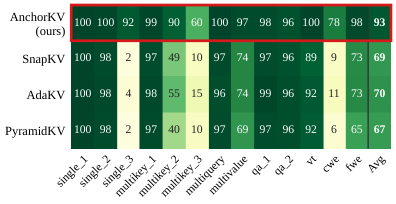
上图展示了在 Llama-3.1-8B 模型上,20 倍极致压缩下 RULER 长文本测试套件的逐任务表现(以未压缩 FullKV 的百分比得分呈现)。从图中可以清晰看到两套范式的性能鸿沟:
传统的淘汰类基线在许多子任务上遭遇了毁灭性溃败。在包含大量干扰项检索(如 cwe、single_3)和需要全上下文聚合信息(如 multikey_3)的任务中,PyramidKV 和 AdaKV 的相对得分直接跌落到了 16% 以下。这种现象正是前文分析的必然结果——淘汰机制在预填充时凭借局部的观察窗口武断地丢弃了关键片段,导致解码端在需要跨段落比对时直接“抓瞎”。
与之形成鲜明对照的是,AnchorKV 在几乎所有任务上都紧咬着未压缩的上限,甚至在最棘手的 cwe 和 single_3 上分别保住了 78% 和 92% 的分数,领先最强淘汰基线达 67 和 88 个百分点。在整个测试套件的全部 13 个任务中,AnchorKV 仅在一项任务上以 1 分之差略低于基线,其余 12 项完全拉平或实现碾压,且全局最低任务表现从未跌破 60%。
更具震撼力的是在大参数模型上的性能保持率。在 70B 模型的 RULER-32K 评测中,当压缩比推到 20 倍时,最优秀的淘汰基线 AdaKV 已经衰减到了 86.8% 的精度,而 AnchorKV 依然取得了惊人的 99.3%(实测得分 94.4 对比未压缩的 95.0)。这表明:模型参数规模越大,表征子空间的语义聚集度越高,AnchorKV 的几何近似优势就越被放大。这一趋势与淘汰类算法在 24B 和 70B 上频繁碰壁的表现形成了鲜明反差。
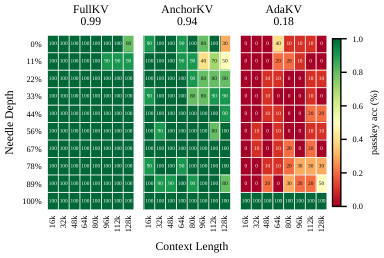
为了把检索压力推向极限,研究团队对 16K 到 128K 长度、0% 到 100% 深度的大海捞针(Needle-in-a-Haystack)评测进行了升级,采用了极难侥幸猜中的 64 位纯数字通行密码(Passkey)。在 5 倍压缩目标下,各模型的检索热图呈现出冰火两重天。
从对比图可以看出,三大淘汰基线除了在序列最末尾(落入直接保留的原生滑动窗口内)能够百分之百捞出答案外,在更早的绝大多数深度区间均呈现出大面积的深暗色(检索失败)。最强淘汰变体 AdaKV 的全网格平均准确率甚至被压制到了区区 0.18。而 AnchorKV 在 16K 到 128K 的全网格范围内几乎维持了全域点亮的高水准,平均准确率高达 0.94,极其逼近未压缩 FullKV 的 0.99。这一结果为“永远不要物理删除任何 Token”的架构哲学提供了最有说服力的实验证据。
消融实验:关键模块如何共同发挥作用?
AnchorKV 能够实现这种大比例无损压缩,是其多项机制精密咬合的结果。研究团队在 Llama-3.1-8B 上进行了一系列严格的控制变量消融分析,揭示了系统内部的取舍逻辑。
其一是残差候选评估准则的重要性。如果放弃输出误差效用公式,转而退回采用余弦相似度、残差绝对范数或纯注意力打分来决定残差配额,在 5 倍压缩这种显存相对宽松的环境下差异尚不明显;但一旦压缩比上升至 10 倍乃至 20 倍,性能差距便迅速被撕裂。纯注意力指标只关心关注度,忽略了锚点本身已有的良好拟合;残差范数指标则只关心误差向量绝对大小,不管该位置解码时根本无人问津。只有紧扣注意力输出一阶扰动的效用评估,才能在显存极其紧张时,把极其稀缺的 2-bit 残差精准投喂到最能挽救输出失真的关键节点上。
其二是核心组件的不可替代性。实验验证了四种极端精简变体:
-
去掉均匀锚点采样,全凭注意力挑选锚点:这种做法在低压缩时无伤大雅,但在高压缩比下性能下滑严重。因为注意力高的 Token 往往扎堆在局部热点语义中,缺乏对全序列向量空间的广泛方向覆盖度,导致非锚点 Token 很难找到方向贴近的基底。
-
取消跨头池化,强行在各头平均分配残差:这直接扼杀了复杂语义注意力和稀疏注意力之间的弹性调配空间。
-
完全不存储残差,将所有显存省出来换取更多锚点:这种“纯字典投影”构想遭遇了惨败。实验证明,盲目扩大锚点数量无法弥补正交方向缺失带来的系统性误差,残差向量对恢复几何完整度具有不可替代的作用。
-
去掉阿达马旋转与 Lloyd–Max 码本,采用朴素 2-bit 量化:这直接导致了所有消融设置中最为剧烈的全局性能暴跌。量化引入的阶梯状粗糙噪声彻底破坏了残差的微调意义。
工程实现与推理落地:显存真的省下来了吗?
在学术界的 KV 缓存压缩方案中,一个常见的陷阱是“论文里算力压缩了,跑起来显存却没省”。如果压缩格式在计算注意力时必须先在 GPU 显存中将原本被压扁的稠密向量完整恢复成 BF16 矩阵,那么系统的实际峰值显存占用(Peak Memory)根本没有下降,推理并发上限依然会被锁死。
AnchorKV 在工程实现上做到了真正的闭环。它没有将解码时的重构做成单独的显存写回流程,而是直接将反投影与残差融合逻辑深度融合(Fused)进了类似 FlashAttention 的分块计算内核中。
在自回归生成的每一个解码步骤里,GPU 的 SRAM 片上缓存按 Tile 分块加载少量的锚点向量、紧凑的元数据标量与 2-bit 残差。当前分块所需的 Key 和 Value 向量仅在极高速的片上寄存器与共享内存中被即时重构,随后立即与 Query 执行点击点积,完成后直接丢弃,在全生命周期内完全不物化(Materialize)稠密的大规模 KV 缓存。
这一硬件级算子设计带来了扎实的系统收益。实测表明,在单张 NVIDIA A100-80GB 显卡上处理 Llama-3.1-8B 时,AnchorKV 实现了与理论高度吻合的 17 到 19 倍单请求显存占用缩减。在 64K 上下文长度下,满载极限显存时,原生未压缩的基线只能维持 3 个并发请求,而 AnchorKV 能稳稳维持 6 个并发,系统吞吐量提升至 1.26 倍。随着上下文长度向 96K 和 128K 继续攀升,原生缓存方案甚至因单请求爆显存(OOM)而无法初始化推理,而 AnchorKV 依然为系统开辟出了支持更高并发的服务空间。
在解码延迟方面,尽管在线重构引入了微小的解包计算,但在长文本场景下(64K 以上),由于需要从 HBM 显存搬运到计算核心的数据量暴跌了 90% 以上,显存带宽压力的缓解直接填平了计算开销,使得 AnchorKV 在 96K–128K 场景下的端到端生成延迟甚至比未压缩缓存还快了 2% 到 3%。
总结与技术启示
AnchorKV 的出现不仅是一个工程技巧的突破,更是对长文本状态表征哲学的一次纠偏。它向业界证明了:处理冗余并不必然意味着丢弃信息。过去数年间,在显存爆炸的逼迫下,业界几乎将注意力稀疏化和硬性 Token 淘汰视为了唯一的救命稻草,却被迫忍受着多跳推理失效、针尖检索崩溃的恶果。
AnchorKV 巧妙地将高维空间投影、误差敏感度评估与现代量化技术熔于一炉,建立了一条优雅的折中路径——用少数精选锚点锚定全局几何基底,用标量系数保全位置可分性,再用基于任务效用的一阶误差分配体系精准补全残差。这种“保留全量位置拓扑,仅在数值精度上按需分级退避”的设计,不仅让大语言模型在 20 倍的显存暴跌下依然能够看清长上下文中的每一个细节,也为未来万亿参数模型走向百万级超长上下文推理提供了一套极其扎实且极富启发性的系统底座。