KV Cache缩减80%且吞吐提升4.2倍:Agent在线压缩关键在延迟
Practical Online KV Cache Compaction for LLM Agents: An Empirical Study
大模型智能体(LLM Agent)在多步推理、深度搜索、代码工程等长程任务中展现出强大的解决复杂问题的能力。然而,这种能力完全建立在对上下文的持续累积之上:系统提示、多轮思考、工具调用参数、环境返回的大段观察结果(Observation)交替追加,导致推理系统的键值缓存(Key-Value Cache,简称 KV Cache)迅速膨胀。随着交互轮数增加,KV Cache 不仅霸占宝贵的显存,还会显著拖慢每一步解码的吞吐效率。
ArXiv URL:https://arxiv.org/abs/2608.00902
面对这一显存瓶颈,KV Cache 压缩(Compaction)是自然的技术路径。以往针对长文档或长提示词的压缩方法,大多预设在“静态环境”中展开:压缩算法在模型回答前就能获取完整上下文,甚至可以花费大量时间离线微调、生成合成数据或优化缓存表征。然而,智能体的交互是动态展开的,新信息必须在未来的使用方式完全未知时进行实时压缩。
最新论文《Practical Online KV Cache Compaction for LLM Agents: An Empirical Study》首次系统化探索了智能体交互中的在线 KV 压缩(Online KV Compaction)设计空间。该研究不仅打破了“压缩必须即时执行”的直觉,还得出一系列对工程落地至关重要的发现:只要将压缩时机推迟一轮、利用后续生成的真实 Query 向量作为指导信号,就能让智能体在丢弃 80% 历史 KV Cache 的前提下,几乎无损保留最终任务精度,并在大型模型上将 Serving 吞吐量最高提升 4.2 倍。此外,研究还揭示了更简单的 Token 剔除方法(Token Eviction)在噪声环境下全面压制复杂的注意力拟合优化,以及智能体在记忆被压缩后会通过向环境发起“重复检索”来进行自我代偿的有趣行为机制。
静态假设失效:智能体在线压缩到底难在哪?
在传统静态长文本问答场景中,KV Cache 压缩的核心思路通常是“查询感知”(Query-Aware)。因为最终要回答的问题是固定的,算法可以利用已知问题的 Query 向量,去计算历史上下文中哪些 Token 的注意力权重最高,进而保留重要的 Key-Value 对,或者利用优化算法拟合出一个紧凑的隐空间缓存。
但在智能体场景下,静态假设彻底失效,形成了两个难以调和的工程痛点。
未来的相关性不可预测。智能体在第 $t$ 轮调用工具并获取搜索结果时,环境返回了上万 Token 的网页内容。在这批内容完成初始推理后,如果不压缩,显存很快就会耗尽;但若立刻压缩,系统根本无法预知三轮或五轮之后,智能体会把注意力转向该网页的哪一段文字。在第 $t$ 轮看似无关紧要的细枝末节,极可能是多轮推理链后续必不可少的关键线索。
压缩开销直接计入交互延迟。在线压缩必须在智能体的循环执行路径中完成。这意味着任何昂贵的离线操作——比如展开额外的 Rollout 探索路径、生成冗长的合成对话进行蒸馏、或者进行多步反向传播优化——都会直接转化为用户的端到端等待时间。在线压缩必须以极低的计算代价,找到能够近似代表“未来需求”的代理查询(Proxy Query)。
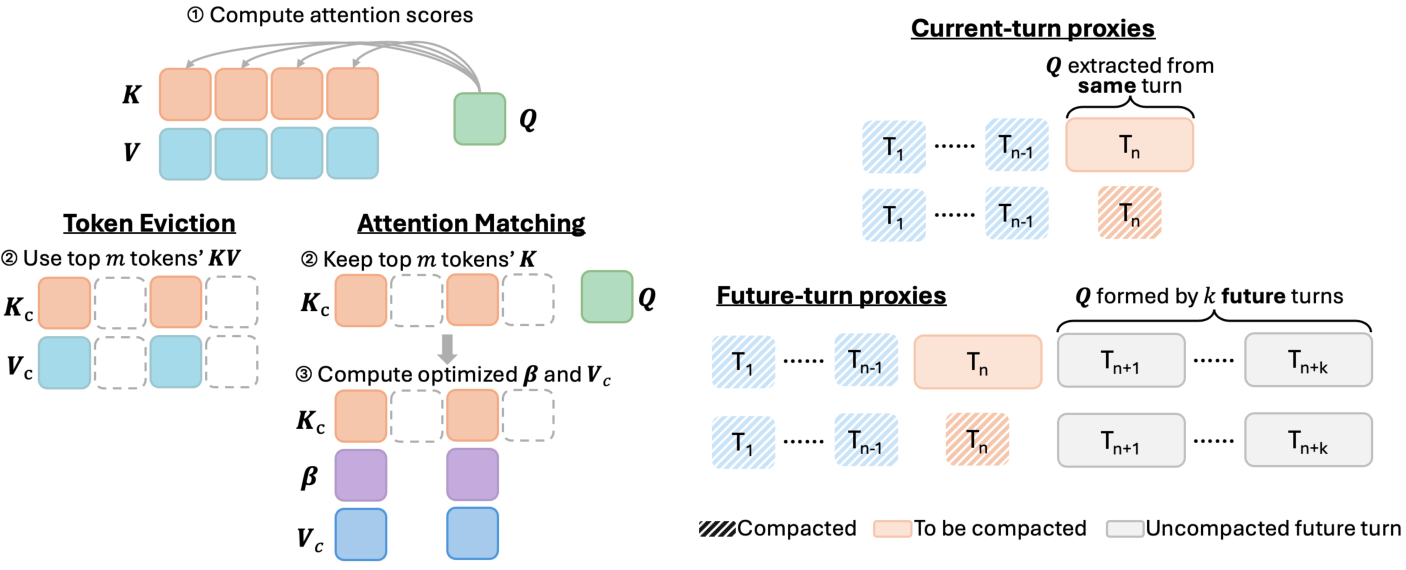
设计空间解构:算法范式与代理查询来源
为了系统化评估在线压缩的可行性,研究团队把现有的序列级压缩方法归纳为两大主流家族,并为它们适配了智能体的多轮交互生命周期。
第一类是 Token 剔除(Token Eviction,简称 TE)。这是一种纯粹的保留与舍弃机制。算法通过一组代理查询向量 $\mathbf{Q} \in \mathbb{R}^{q \times d}$,计算待压缩上下文在各位置上的注意力权重 $\alpha_{ij}$,并计算平均注意力质量评分 $s_j$:
\[s_{j}(\mathbf{Q},\mathbf{K})=\left(\frac{1}{q}\sum_{i=1}^{q}\alpha_{ij}^{2}\right)^{1/2}\]随后选取评分最高的 Top-$m$ 个位置,将其原始的 Key 与 Value 完整保留,其余位置直接丢弃。这种方法不修改任何权重与表征,计算极快。
第二类是 注意力匹配(Attention Matching,简称 AM)。AM 不满足于简单的 Token 过滤,它在通过上述方法选出 Top-$m$ 个 Key 后,进一步通过优化算法求解一个可加的注意力偏置 $\boldsymbol{\beta}$ 以及重构后的紧凑 Value 矩阵 $\mathbf{V}_C$。其目标是让压缩后的注意力输出,在代理查询 $\mathbf{Q}$ 上尽可能逼近未压缩前的完整注意力输出:
\[\min_{\boldsymbol{\beta}}\left\|\exp(\mathbf{Q}\mathbf{K}_{C}^{\top}+\boldsymbol{\beta})\mathbf{1}_{m}-\exp(\mathbf{Q}\mathbf{K}^{\top})\mathbf{1}_{n}\right\|_{2}^{2}\] \[\min_{\mathbf{V}_{C}}\left\|\widehat{\mathbf{A}}(\mathbf{Q};\mathbf{K}_{C},\boldsymbol{\beta},\mathbf{V}_{C})-\mathbf{A}(\mathbf{Q};\mathbf{K},\mathbf{V})\right\|_{F}^{2}\]直觉上,AM 既然在数学上做到了全局逼近,理论表现理应大幅优于简单粗暴的 TE。
然而,这两类方法的效果完全依赖于输入的代理查询 $\mathbf{Q}$ 是否具有代表性。在智能体在线运行期间,低成本获取 $\mathbf{Q}$ 的来源主要有三种路径:
- 当前轮边界查询(Boundary Queries):直接提取当前轮次结束时的结构性标记(例如 Qwen 的
<|im_end|>)对应的 Query 向量。这类向量在推理主干中天然产生,额外开销为零。 -
重复预填充查询(Repeat-prefill Queries):受 KVzip 等工作启发,拼接一段重构提示词,强制模型自回归重读一遍刚刚生成的思考或工具结果,提取重读过程中的 Query 向量。这相当于增加了一次极轻量的 Prefill。
- 延迟未来查询(Delayed Future-turn Queries):改变压缩时机。当第 $t$ 轮结束时,并不急于压缩它,而是将其原始 KV Cache 完整保留 $k$ 个轮次。在生成第 $t+1$ 到 $t+k$ 轮的过程中,模型会自然产生读取该上下文的真实 Query 向量。利用这些真实的未来生成 Query 作为代理,在第 $t+k$ 轮结束时再对第 $t$ 轮执行压缩并冻结。
核心发现一:延迟一轮,即可逆转即时压缩的性能暴跌
研究团队在两套代表性的智能体检索基准上进行了深度评测:针对复杂推理与确定性事实检验的 BrowseComp-Plus,以及要求智能体广域搜索并整理大量细粒度信息的 WideSearch。测试涵盖了 Qwen3.5 与 Gemma-4 两大具备混合注意力架构的模型家族。
当压缩比设定为 0.2(即削减 80% 的 KV Cache 长度)时,实验呈现出极具对比性的趋势:即时压缩往往带来严重的精度损失,而延迟压缩则能几乎完全抹平这一差距。
在即时压缩设定下,利用重复预填充提取 Proxy 的策略表现普遍疲软。但在 BrowseComp-Plus 任务中,利用结束标记 <|im_end|> 的边界查询却取得了意料之外的良好效果。在 Qwen3.5-4B 上,仅用边界 Query 做即时 TE 压缩,准确率就从重复预填充的 32.75% 跃升至 45.25%;在 Gemma-4-E4B 上也从 9.00% 提升至 21.50%。这印证了近期关于推理模型注意力汇点(Attention Sink)的研究发现:句末及结构标记往往汇聚了对整段推理逻辑的高阶语义概括。
然而,更具普适性、更强劲的解法是延迟未来查询。实验表明,哪怕仅仅延迟 1 轮($k=1$),引入后续一轮智能体自身思考与动作生成的真实 Query,几乎在所有模型和基准组合中都显著击败了即时压缩方案。
-
在 WideSearch 这种需要反复对照多项事实的广域搜索任务中,Qwen3.5-4B 使用延迟 1 轮的未来 Query,F1 分数从即时压缩的 0.17 左右大幅提升至 0.28,极为接近无压缩基线的 0.31。
-
进一步增加延迟窗口(例如将 $k$ 设为 3 或 5)能够继续带来边际性能提升,但收益逐渐放缓。考虑到延迟窗口过大会导致未压缩的原始轮次驻留显存过久,延迟 1 轮在工程上展现出了近乎完美的性价比拐点。
一个自然的疑问是:既然边界 Query 和未来 Query 各有优势,把它们拼接在一起作为综合 Proxy,会不会更强?实验结果给出了明确的否定答案。无论是将各来源的评分按比例分配,还是在特征维度进行拼合,组合策略相比于纯粹的未来助手生成 Query,性能波动均在 2 个百分点以内,甚至在部分场景出现反噬。这意味着,在代理查询的设计上,纯粹的高质量未来信号远比拼凑而成的多元信号更加可靠。
核心发现二:复杂的数学拟合,为何输给简单的暴力剔除?
从数学严密性来看,Attention Matching(AM)不仅筛选了 Token,还优化了偏置项 $\boldsymbol{\beta}$ 并重构了值矩阵 $\mathbf{V}_C$,旨在最小化全局注意力误差;而 Token Eviction(TE)只做硬截断,未做任何补偿。许多学者此前推测,AM 在多轮长文本中理应具有压倒性优势。
然而,实验数据打破了这一刻板认知:在绝大多数在线智能体任务中,简单的 TE 无论是绝对性能还是鲁棒性,都大幅领先或持平于复杂的 AM。
这一现象背后的本质原因在于“代理偏差”(Proxy Bias)。在静态压缩任务中,优化的目标函数 Query 与最终部署测试时的 Query 高度同分布,AM 可以充分发挥数值拟合的优势。但在在线智能体场景中,即便使用了延迟 1 轮的未来 Query,这些 Query 依然只是后续漫长交互历史的一个局部切片。
AM 的优化过程高度敏锐地过拟合了这批有限的 Proxy Query:它大幅调整了 Value 矩阵的表征,并给 Key 赋予了激进的注意力偏置。一旦交互进入第 $t+3$ 轮或第 $t+5$ 轮,智能体以全新的视角重新审视这段上下文时,这套高度定制化的偏置和重构 Value 反而引发了严重的注意力失真。相反,TE 完全保留了原始 Key 与 Value 的几何特征,没有对隐空间表征施加任何有偏的人为畸变。对于后续未知的 Query 而言,未篡改的原始 Token 天然具备更好的泛化能力。
加上 AM 在推理主干中需要引入非平庸的最小二乘拟合与优化计算,在系统吞吐量和实现复杂度上面临额外的工程包袱。在在线智能体系统的落地上,简单的 Token Eviction 凭借无额外计算开销与更强健的泛化鲁棒性,成为了极具吸引力的首选方案。
显存暴降与吞吐飞跃:27B/31B 规模的大模型实测
小模型上的算法探索最终需要验证其在大规模模型上的实用价值。研究团队进一步将评估推进到 Qwen3.5-27B 与 Gemma-4-31B 两款主力大模型上,在 BrowseComp-Plus 上执行全量实测。所有压缩配置均采用经过前序实验验证的最优解:延迟 1 轮的未来助手生成 Query,压缩比设为 0.2。
实验结果展现了惊人的系统加速效果:
-
准确率高度保真:在 Qwen3.5-27B 上,无压缩基线的准确率为 67.50%;采用 TE 进行 80% KV 深度压缩后,准确率仍维持在 64.75%,仅仅微降不到 3 个百分点。在 Gemma-4-31B 上,TE 更是取得了 59.25% 的成绩,紧咬无压缩基线的 62.00%。
-
显存占用急剧下降:在多轮深度搜索的交互峰值时刻,Qwen3.5-27B 的单轮 KV 序列长度从基线的 52.8k 骤降至 15.3k,峰值显存足足缩减了 3.5 倍;Gemma-4-31B 也实现了 2.7 倍的显存压缩。
-
系统 Serving 吞吐倍增:得益于单请求显存占用的大幅下降,服务系统可以容纳高得多的并发批处理规模(Serving Batch)。通过吞吐量仿真模拟,在保持同等显存预算下,Qwen3.5-27B 的整体 Serving 吞吐量提升至基线的 4.2 倍,Gemma-4-31B 的吞吐量也提升至 1.7 倍。
这一结果充分证明,在线 KV 压缩绝非仅停留在理论层面的微调技巧,而是一项能够直接将大模型 Agent 推理成本压缩至原有几分之一的硬核工程手段。
意外的“记忆代偿”:智能体会通过多搜几次自我修复
除了显存与算力指标,该论文最耐人寻味的发现,是压缩对智能体自身交互行为的重塑。
在仔细比对多轮交互的轨迹长度时,研究人员观察到一个异常细节:在 Qwen3.5-4B 上,未压缩基线的轨迹中位数仅为 20 轮;然而在启用 KV 压缩后,无论采用何种压缩算法,交互轮次均普遍延长到了 30 至 39 轮。换句话说,智能体似乎在被压缩后变得更“多话”、更倾向于发起更多轮的操作。
为了探寻背后的成因,作者提取了每一条轨迹中智能体生成的所有检索语句(Search Query),计算其与同轨迹内此前生成的搜索语句的余弦相似度。统计结果清晰地揭示了智能体的底层代偿机制:
| 模型与配置 | 平均最近邻检索相似度 (NN Sim.) | 高度重复搜索占比 (Duplicate > 0.9) |
|---|---|---|
| Qwen3.5-4B 基线 (无压缩) | 0.547 | 10.98% |
| Qwen3.5-4B (即时压缩 TE) | 0.638 | 21.08% |
| Qwen3.5-4B (延迟1轮 TE) | 0.655 | 22.88% |
| Qwen3.5-27B 基线 (无压缩) | 0.603 | 16.97% |
| Qwen3.5-27B (延迟1轮 TE) | 0.648 | 21.68% |
无论是 4B 还是 27B 模型,压缩后的智能体在高相似度重复检索(相似度阈值高于 0.9)的比例上均激增了 5 到 10 个百分点。在极端情况下,重复搜索的比例直接翻倍。
这一证据强有力地支撑了一个推论:智能体具备惊人的行为弹性。 当 KV Cache 被大幅压缩、早期检索到的某些细节因表征退化而变得模糊甚至被剔除时,智能体在后续推理中意识到信息的缺失,并未直接摆烂报错,而是选择借助外部环境——重新生成高度相似的搜索语句,把曾经看过的网页再次检索出来。
这种“以交互换记忆”的代偿机制,客观上解释了为什么在 KV Cache 被砍掉 80% 的情况下,智能体的最终端到端准确率依然能够高度坚挺。同时也为未来的智能体系统评估敲响了警钟:评价一个 KV 压缩方案的优劣,绝对不能只紧盯着最终的问答准确率和显存曲线,必须将智能体因遗忘而在环境中额外消耗的 Tool Call 成本、API 调用开销与交互轮数,完整纳入系统开销的总账本中。
总结与落地指南
面对多轮智能体系统日益沉重的显存枷锁,这项实证研究清晰指明了一条行之有效的在线优化路径。对于正在搭建长程 Agent 系统的开发者而言,以下几条来自论文核心结论的建议尤为值得参考:
-
摒弃即时压缩,建立“延迟一轮”的缓冲机制:不要在工具返回结果后立刻急于压缩该轮的 KV。留出 1 轮的生成延迟,利用智能体自身的下一轮决策 Query 作为过滤依据,能以极小的显存代价换取核心记忆的完整找回。
-
警惕过度拟合,优先拥抱简单的 Token 剔除:在高度动态的在线环境下,对 Key 和 Value 的数值重构拟合(如 Attention Matching)极易受局部 Proxy 的误导;保留未被修改的原始关键 Token,反而具备更强的泛化鲁棒性。
-
将环境交互开销纳入系统评估:记忆压缩不仅会改变模型的注意力分数,还会间接重塑智能体的决策行为。在评估压缩收益时,除了显存和解码吞吐,还需要紧密监控 Tool 调用频率与轨迹长度的异常膨胀,在推理计算效率与环境交互成本之间找到真正的工程平衡点。