Realtime-Venus:边聊边调工具的双循环架构,97%防误打断超越GPT-4o
Realtime-Venus: A full-duplex interaction system with asynchronous delegation
在人机语音交互的发展历程中,“全双工”(Full-Duplex)与“工具调用”(Tool Use)长期处于一种难以调和的时间尺度冲突中。全双工要求模型以毫秒级的极低延迟感知环境、倾听声音,并在感知到用户意图变化时立刻打断或调整自身发言;而调用搜索引擎、复杂推理模型或业务 API 等工具,通常需要花费数秒乃至数十秒。如果模型在后台处理复杂任务时必须保持沉默,对话节奏就会被生硬打断;若是模型无法在交互的同时分流计算任务,它就只能退化为仅能闲聊的玩具。
ArXiv URL:https://arxiv.org/abs/2609.13814
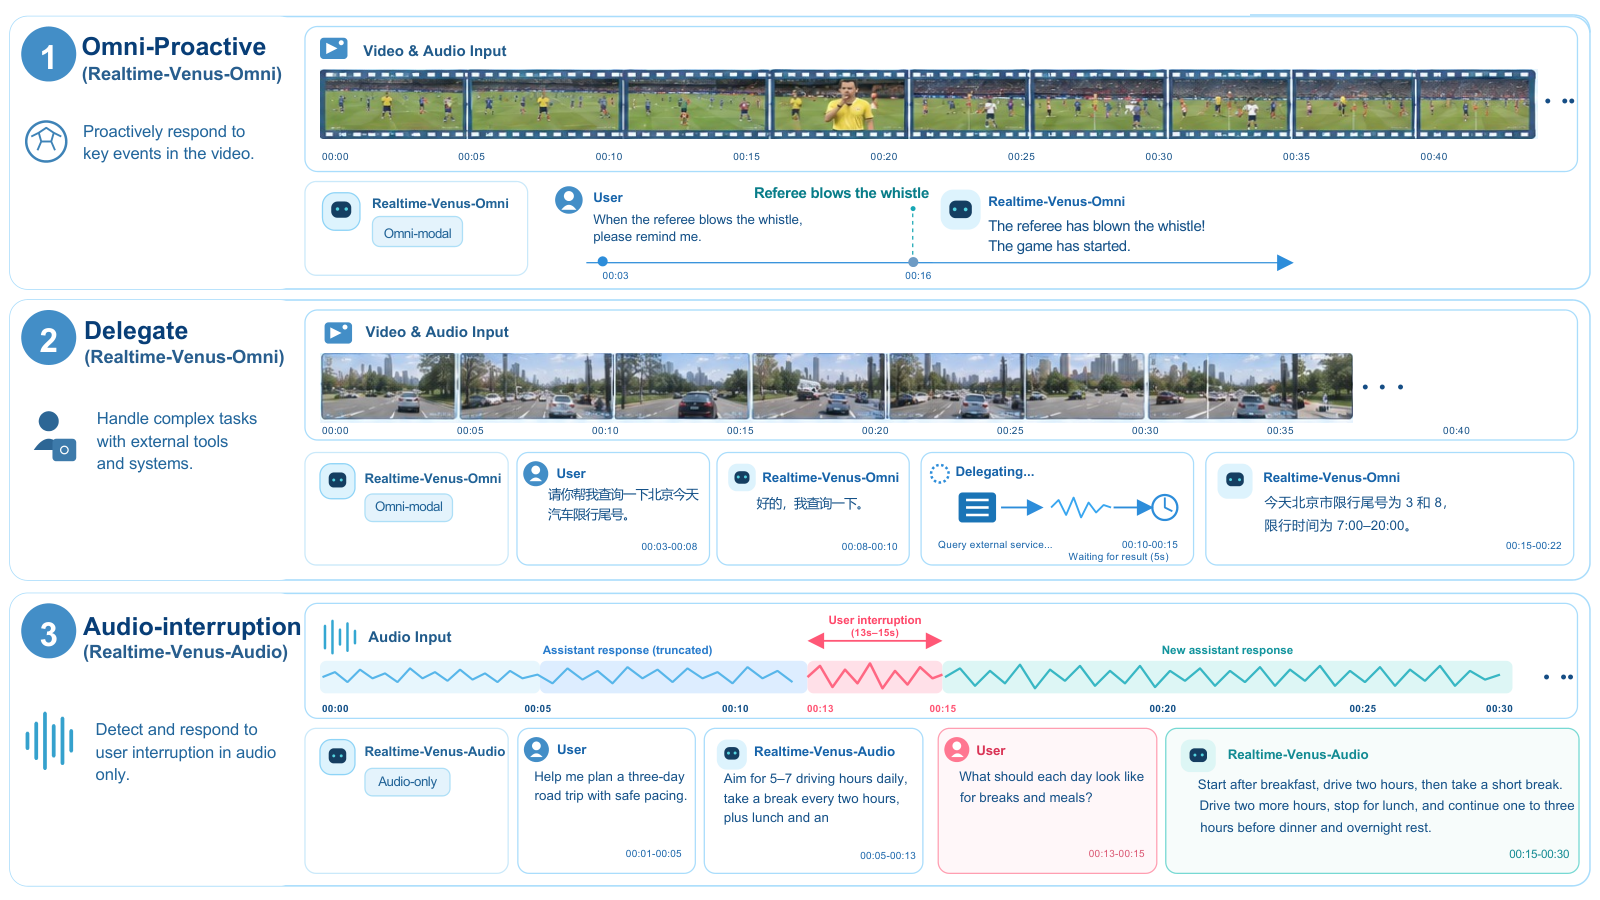
为了攻克这道工程与算法的双重难关,蚂蚁集团(Ant Group)联合清华大学提出了名为 Realtime-Venus 的前沿全双工交互系统。该系统基于 9B 参数规模,分别针对音视频多模态交互和纯语音交互推出了两款核心模型:Realtime-Venus-Omni 与 Realtime-Venus-Audio。系统最具突破性的设计,在于提出了“双循环运行时”(Dual-loop runtime)架构与统一因果时间线:前端 9B 模型负责毫秒级的连续音视频感知、话轮控制与原生流式语音生成;当遇到需要耗时计算的任务时,前端模型在隐藏序列中通过私有标记发起“异步委托”(Asynchronous Delegation),交由后台框架 Realtime-Venus-Harness 异步执行。与此同时,前端模型继续与用户流畅交流,等外部结果准备就绪后,再以极其自然的方式将其重新融入对话。
评测数据显示,在实时在线视频基准测试中,Realtime-Venus-Omni 在 8 项评测中拿下 6 项最高分,包括 StreamingBench 达到 70.2%、OVO-Bench 达到 64.7%、Daily-Omni 达到 81.3%。在语音问答和理解测试中,Realtime-Venus-Audio 在 MMAU(78.0%)、MMAU-Pro(63.2%)等权威基准上全面领先同类模型。在 Full-Duplex-Bench v1.5 的严苛场景下,面对用户仅是随口附和(Backchannel)的情况,其保持正常表达而不被误打断的概率高达 97%,在面对旁人对话和背景杂音时的持续率分别达到 88% 与 86%,全双工对话控制表现全面超越了 Gemini 3.1 Live 与 GPT-4o。
双循环架构:把流式前端与耗时后台彻底解耦
传统对话系统在面对外部工具调用时,通常采用“停顿-等待-返回”的阻塞式逻辑。这在打字聊天场景下尚能接受,但在端到端全双工语音或视频交互中,数秒的停顿就足以让用户感到困惑并误以为系统掉线。此前部分工作虽然尝试引入异步调用,但往往采用外挂 ASR(语音识别)与 TTS(语音合成)模块的拼凑方案,不仅系统链路极长、延迟累积严重,还丧失了端到端模型感知语调、语气和环境上下文的细腻能力。
Realtime-Venus 从底层架构上推行了双循环运行时设计。系统明确划分为两个并行的运转回路:交互循环(Interaction Loop) 与 能力执行循环(Capability Loop)。
交互循环由前端模型(Realtime-Venus-Omni 或 Realtime-Venus-Audio)直接驱动。它是一个对延迟极度敏感的高频循环,以固定 1 秒的时间切片(Chunk)为基本调度单位。在每一秒内,前端模型持续摄入音频或视频帧特征,更新内部会话状态,并在同一个自回归解码步骤中同步做出两类判定:一是离散的话轮控制决策(是继续倾听还是开口说话),二是生成相应的流式文本与对齐的底层语音表征。哪怕后台正在进行耗时巨大的检索或多步骤推理,前端的感知与表达也不会发生任何停滞,甚至可以主动向用户汇报“我正在帮你查,请稍候”,同时继续倾听用户是否有新的补充。
能力执行循环则由名为 Realtime-Venus-Harness 的调度框架管理。当交互循环中的前端模型判断当前问题超出了自身即时回答的能力范畴,它不会在对外的语音通道中把代码或指令念出来,而是在其内部的隐式标记流中生成形如 <delegate> 自然语言任务目标 </delegate> 的私有委托标记。宿主运行时一旦侦测到这个私有闭环,就会将其解析并打包为独立的背景任务工单,分发至后台注册的对应技能执行器中运行。
这种分工带来了极其纯粹的模型交互接口:流式多模态模型无需强行学习纷繁复杂的 API 格式和外部工具参数结构,只需以自然语言表达意图;而 harness 则充当智能中枢,负责意图路由、外部工具调用、重试机制以及对返回结果的润色。
模型微观结构:Thinker-Talker 原生端到端流式生成
Realtime-Venus 继承并拓展了 MiniCPM-o 4.5 的技术路线,其核心架构采用了优雅的“思考者-讲述者”(Thinker-Talker)解耦设计,整套系统的核心骨架由统一的 Qwen3-8B 语言基座承担。
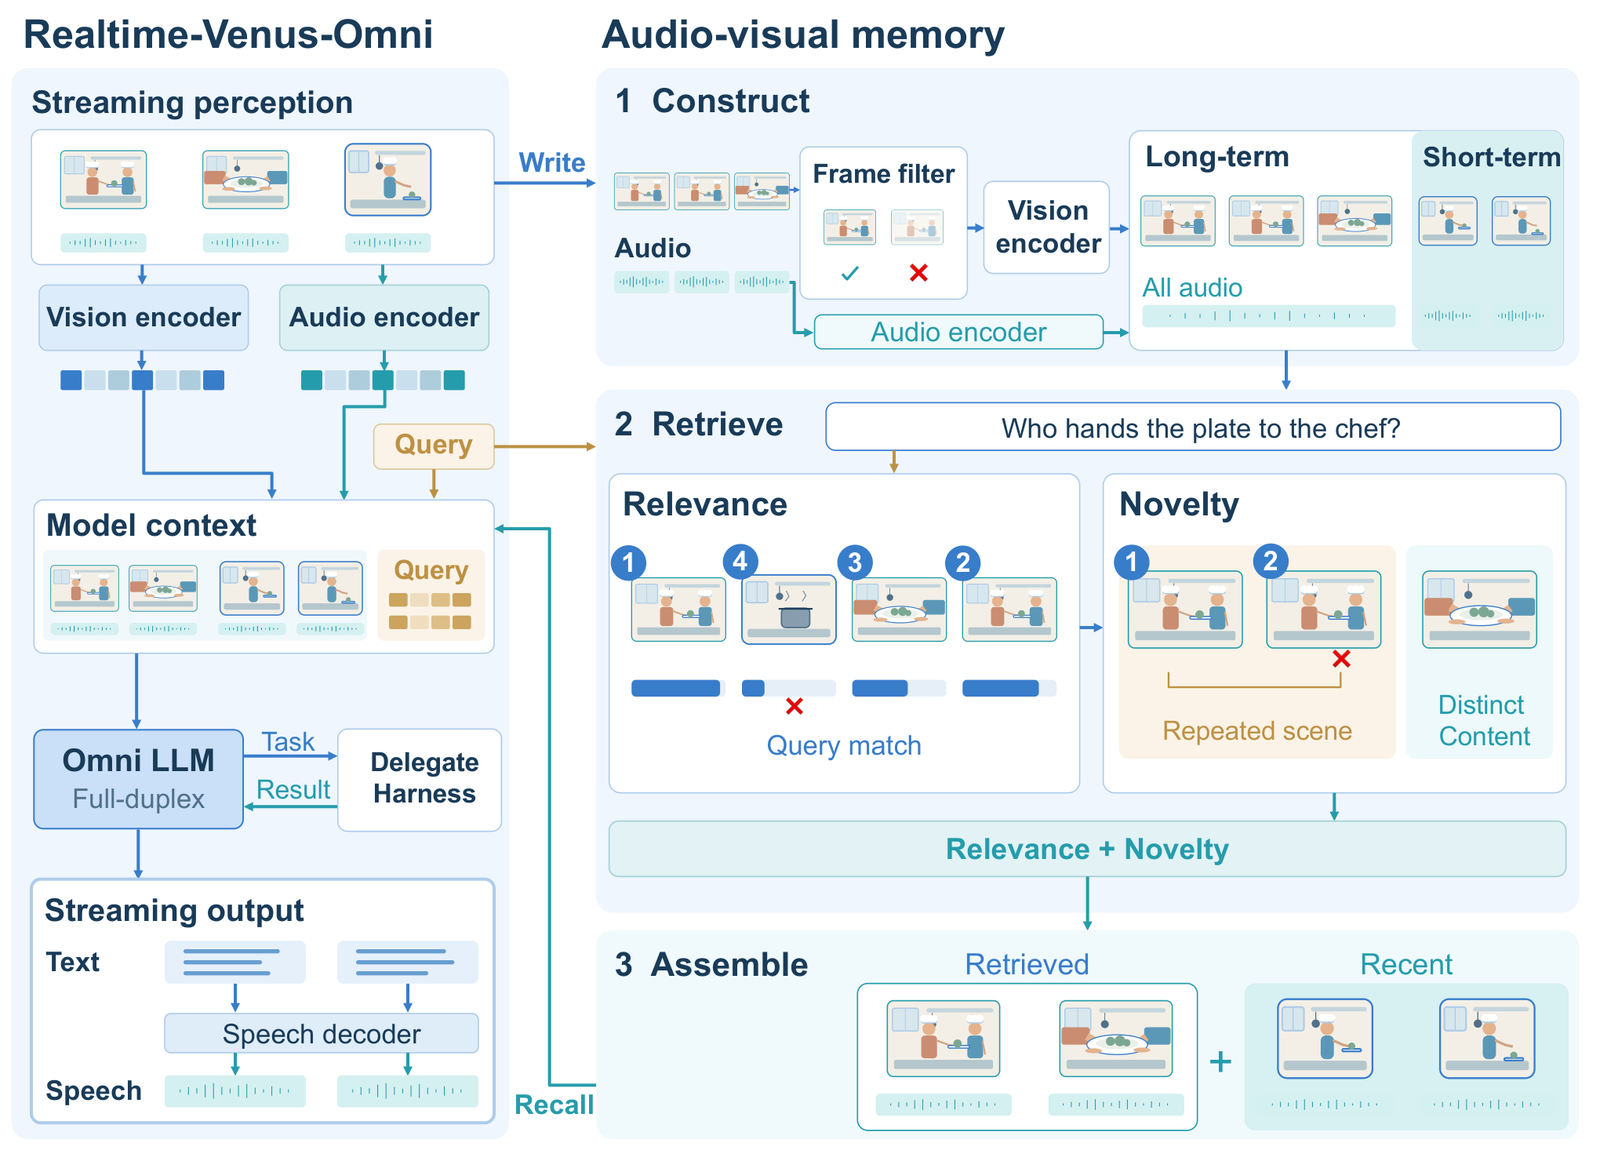
在 Realtime-Venus-Omni 的多模态输入端,视觉信号由 SigLIP2 编码器以流式帧的形式接入,音频信号则经由 Whisper-Medium 编码器转化为高维因果声学特征。两者经过线性投射后,在时间维度上交织对齐,按秒注入语言基座。对于纯语音的 Realtime-Venus-Audio,系统剥离了视觉分支,专注于对流式音频的高效计算,从而在纯语音场景下获得了极高的推理能效比。
Thinker 作为整套系统的大脑,不仅要在每个 1 秒切片做出 <|listen|> 或 <|speak|> 的状态切换判定,还要输出语义文本与委托标记。紧随其后的是轻量化的 Talker 模块,它根据 Thinker 的隐层状态,预测离散的 S3 语音 Token,最终再通过流式 Flow-matching 声码器解码为可听的声音波形。
为了保证文本生成节奏与声音播放进度不产生灾难性的错位,研究团队设计了一套极其精细的统一流式序列化机制。在实际对话中,如果网络抖动或音频播放滞后,模型如果继续高速生成后续文本,一旦用户突然打断,就会产生大量的“幽灵文本”(已经解码但未播放给用户)。为此,系统在每个时间步引入了基于已确认播放进度 $\tau_{k-1}$ 的文本-语音节奏对齐调度器:
\[n_k = \arg\min_n \left\vert{} \tau_{k-1} + \mathcal{D}(Y_{k,1:n}) - t_k \right\vert{}\]这套调度机制会动态测量文本对应的预期语音时长。当声音播放出现延迟时,调度器会压低文本输出速度;当播放通畅时,则释放解码容量。这保证了在任何一秒钟,尚未真正播放出声的后续内容都保留在“可修改”的潜在状态中,为精细的全双工打断修复提供了底层保障。
与此同时,针对超长视频对话中上下文窗口容易爆炸的工业痛点,Realtime-Venus-Omni 还挂载了一个免训练长视频记忆模块(Training-Free Long-Video Memory)。常规流式模型为了控制显存,通常使用有限长度的滑动窗口,这导致半小时前发生的画面会被直接丢弃。Realtime-Venus 的外挂记忆模块能够在后台异步维护长周期的多模态特征,当用户在数十分钟后突然发起对早期细节的追问时,系统能精准检索关键历史帧以及相邻的连续音频段,将其在时间维度上拼合并重新注入当前的上下文窗口中,在不增加基础模型训练开销的前提下,赋予了模型长达数小时的多模态记忆回溯能力。
因果时序保护与精细语义打断机制
将异步任务与实时对话放在一起,最危险的问题是“因果时序紊乱”。假设用户在第 5 秒要求“帮我查一下刚刚提到的那个产品价格”,系统发起了异步检索;但到了第 7 秒,用户突然改变主意说“算了,不用查那个了,帮我查查另一个”。如果系统不加以隔离,第 12 秒返回的旧结果很可能会突兀地插进已经变换了主题的对话中,造成对话逻辑彻底崩塌。
Realtime-Venus-Harness 从协议层上给出了极其严谨的因果任务捕获(Causal Task Capture)方案。系统在提取到 <delegate> q_i </delegate> 标记的瞬间,立即对当前会话的时序环境打下一个绝对隔离的“因果快照”:
这个工单快照固定了时间窗口界限 $T_i$ 之前的观测证据,并且包含了一个前置安全围栏:只有在时间 $T_i$ 之前已经被物理扬声器播放确认过的助手发言,才被允许计入因果证据;而在该时刻之后发生的用户新表述,绝不会污染当前已发出的后台任务。
当外部工具执行完毕、生成标准化结果后,返回阶段由一个专门的文本润色适配器处理。适配器将复杂的结构化数据清洗成自然的对话回答,并包裹在私有的 <backend> 标记中送回会话。请注意,此时消息进入的仅是模型的私有观察上下文,系统并不会粗暴地直接强制发声,而是赋予前端 Thinker 充分的决断权——模型会结合最新的会话状态,挑选最恰当的时机开口播放;如果侦测到用户在等待期间已经切换了话题,模型甚至可以自主决定跳过废弃结果,或者以“对了,关于你刚才问的前一个问题,结果其实是……”的形式极其自然地重回旧话。
在全双工交互控制层面,Realtime-Venus 彻底摆脱了传统语音端点检测(VAD)那种只能根据音量大小粗暴判断说话与否的局限。在统一因果时间线上,模型的自回归目标同时预测话轮行为标记、文本、委托以及语音,从而赋予了系统三种高级语义打断能力:
-
停止/放弃(Stop/Reject):明确确认用户要打断发言并抢占话轮,立即截断 Talker 的当前播放,丢弃未发声的缓冲区;
-
修复/更新(Repair/Update):用户在插话中纠正了信息(如“不是李明,是张明”),模型在不停顿对话的前提下,迅速废弃掉脑海中陈旧的未发生文本,根据新线索重新生成后续内容;
-
分流/重定向(Redirect/Follow-up):将当前阐述挂起,优先切入响应用户的即时新要求。
正是这种融合了语义层面的全双工建模,使得 Realtime-Venus 在面对用户“嗯”、“好的”、“对”等随口附和时,能够准确识别出这并非抢占发言权,从而实现高达 97% 的持续发声率,再也不会像过往语音助手那样,被用户的随口一句搭腔打得手足无措、戛然而止。
耦合全双工与任务委托的数据管线
如此精密的交互控制策略,绝非仅靠基座模型的纯文本预训练就能自然涌现,其核心依赖于高质量的时序监督微调(SFT)数据。为此,研究团队设计了一套复杂的三阶段数据构建流水线,将交互规划、声学渲染与物理时序对齐严密耦合在一起。
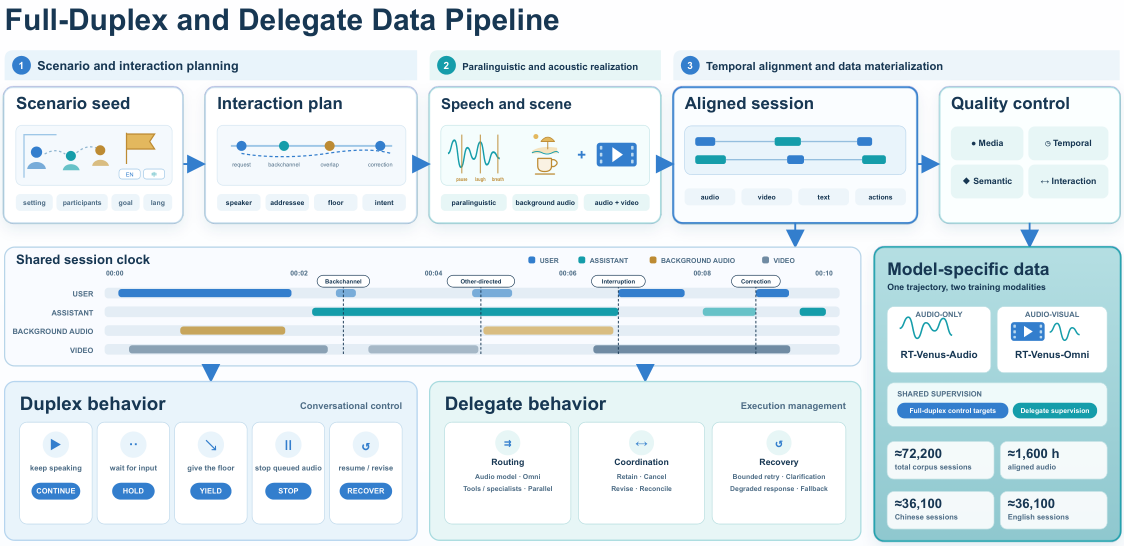
该数据管线首先进行场景与交互规划。生成引擎会系统化地构造三类典型行为的脚本轨迹:第一类是复杂的全双工行为,精细标注出用户说话的声音重叠部分究竟是附和反馈、指向第三方的旁话,还是真正具有攻击性的打断纠错;第二类是主动交互行为,训练模型仅凭画面或听觉中的环境异动,在没有显式提问的情况下自主判断何时开口、何时倾听;第三类则是全流程的委托场景,模拟在助手说话中途插入后台工单申请、后台返回以及后续信息缝合的完整过程。
接下来是副语言与声学校准阶段。通过高拟真 TTS 引擎与多角色声学库,为规划好的脚本合成具有丰富副语言特征的连续音频流,注入背景噪音、室内混响以及具有真实时间重叠的双向交谈声音。
最后一步是时序对齐与物理具象化(Materialization)。整条对话链路上发生的所有物理事件——包括每一帧画面对应的视觉 Token、麦克风因果音频特征、模型逐秒生成的控制标记 <|listen|>/<|speak|>、私有委托标记以及对外的 S3 语音 Token——都被严格映射到同一条单调递增的全局物理会话时钟上。
在最终形成的超过 280 万条后训练数据中,音视频与多模态离线理解数据约占 56%,主动全双工交互数据约占 37%,而复杂的异步委托工作流数据占据了至关重要的 6%。尤为关键的是,模型的损失函数计算采用了稀疏加权模式:整个反向传播的交叉熵损失仅仅计算在模型的回应区间上,用户的多模态输入占位符不参与计算;每个样本的损失都会除以其自身的有效监督权重再进行全局批次平均,彻底杜绝了模型因为生成长句子而对优化方向产生畸形倾斜。
突破人机实时交互的维度局限
Realtime-Venus 展现了一种极具参考价值的大模型实时交互技术范式:它不仅将端到端多模态流式交互推向了成熟应用阶段,更重要的是,它证明了毫秒级的全双工流式前端与长耗时的外部深度思考/工具调用能够无缝共存于同一系统之中。
两款模型的性能表现给行业树立了新的参考标杆。在包括 StreamingBench、OVO-Bench 等多项硬核实时多模态评测中,Realtime-Venus-Omni 刷新了在线开源模型的最佳纪录;而 Realtime-Venus-Audio 凭借近乎人类般的敏锐反应,在打断控制、附和识别及复杂声学问答场景中,交出了媲美甚至超越 GPT-4o 与 Gemini 3.1 Live 等闭源顶级系统的答卷。
长期以来,业内在探索智能体(Agent)落地时,要么将模型做得极重,依赖复杂的思考链(CoT)导致交互严重卡顿;要么追求轻快极致的低延迟,导致模型缺失复杂调用和深层推理的能力。Realtime-Venus 通过优雅的双循环机制、私有因果快照以及高度协同的时序数据管线,成功打破了这层看似不可逾越的鸿沟,为人机交互在智能硬件、实时音视频助理以及具身智能体领域的未来演进,勾勒出了极具实操性的工业级工程图景。