Rehearse:攻克自动科研“置信度悬崖”,小记忆撬动大模型执行前判断
Rehearse: Stepping Back from the Confidence Cliff in Self-Improving Autoresearch
让大模型接管算法迭代与代码优化,正在从概念演示走向真实的研究基准。在典型的自动机器学习研究(Autoresearch)闭环中,智能体通常遵循一套极简的经验主义逻辑:阅读现有代码,提出一项修改方案,提交完整的模型训练任务,若验证集指标提升则保留补丁,反之则回滚代码。这套方案看似简单有效,但在真实算力预算下却存在致命弱点——每一次未见成效的代码改动,都要实打实地烧掉一次昂贵的训练开销。
ArXiv URL:https://arxiv.org/abs/2607.27687
随着迭代步数加深,这种试错式搜索会迅速遭遇算力泥潭。在清华大学等机构开源的 AutoSOTA 真实运行日志中,早期的代码修改往往立竿见影,前两轮迭代中多达 70% 的候选修改都能取得正向增益;然而到了第 6 轮之后,有效修改的比例暴跌至 43%,且平均性能增益从 3.6% 骤降至 0.3%。面对这种边际收益递减的困局,过去的研究多聚焦于如何生成更多样化的新想法,却忽略了另一个更为关键的判别能力:在把代码真正扔进集群训练之前,智能体究竟能不能准确判断这项修改究竟是力挽狂澜还是徒劳无功?
最新的研究工作《Rehearse: Stepping Back from the Confidence Cliff in Self-Improving Autoresearch》直面这一痛点。作者团队深入分析了智能体在长期代码迭代中的“执行前判断”(Pre-execution Judgment),首次揭示了一种被称为置信度悬崖(Confidence Cliff)的失效模式:随着代码累积的成功修改越来越多,模型在没有合适记忆辅助的情况下,对于未运行代码的判断准确率会发生断崖式下跌,同时却依然极度自信地给出错误判断。为了化解这一危机,研究团队提出了名为 Rehearse 的轻量级控制技能,将原本单调的“生成即运行”改造为“生成候选–精准预测–选优执行”闭环,并配合极简的聚焦结果记忆机制,在 4000 次模型训练预算下,显著放大了长程代码自优化的搜索效率。
迭代深处的“置信度悬崖”
在大模型驱动的代码优化任务中,每一次训练运行的开销动辄数十分钟乃至数小时。如果智能体可以在执行前充当审慎的评审员,对生成的若干代码修改进行成对比较或排序,只将胜算最高的一项送入训练管道,就能大幅节约试错成本。
为了探究这种“执行前判断”究竟在多大程度上可靠,研究团队从 39 个基于顶会论文代码构建的 AutoSOTA 任务中抽取真实日志,构建了一个包含真实评测结果的成对基准数据集。该基准的核心由 296 对在同一代码基线上分化出的修改方案组成,每一对修改均包含一个被验证能提升指标的有效改动,以及一个导致指标下降或持平的无效改动。评审模型只能看到修改的动机假设与代码补丁,其真实运行结果被完全隐藏。
为了消除大模型在成对评测中普遍存在的位置偏见(Position Bias),研究团队引入了严格共识(Strict Consensus)机制:每一对代码必须以正反两种先后顺序分别输入给评审模型,唯有模型在两次颠倒顺序的测试中给出完全一致的胜出判断,该结果才算有效判定;若模型随展示顺序摇摆不定,则判定为弃权。这里定义两个核心评估指标:覆盖率(Coverage)代表模型达成严格共识并给出判决的样本比例,而选择性准确率(Selective Accuracy)则代表在模型给出有效判决的样本中,正确识别出更优修改的概率。
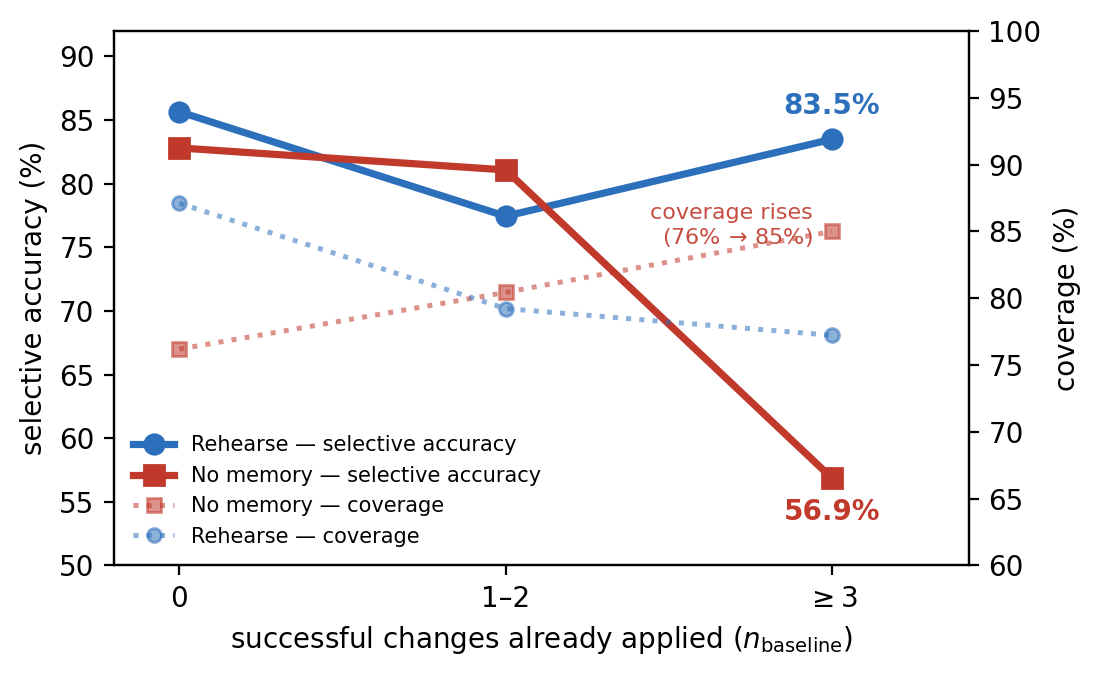
实验揭示的现象令人警醒。在搜索刚开始的冷启动阶段,代码修改尚未累积,没有任何先验历史记忆的评审模型表现出色,其选择性准确率高达 82.8%,证明大模型仅凭代码实现与直觉假设,确实具备分辨优质创新的能力。然而,一旦代码树上成功累积了 3 次或以上的改动(即 $n_{\mathrm{baseline}} \ge 3$),缺乏长效记忆的评审模型准确率出现断崖式暴跌,一路垮塌至 56.9%,几乎与抛硬币无异。
更为危险的是模型的“认知失调”:在准确率暴跌 25.9 个百分点的同时,模型的覆盖率不仅没有降低,反而从 76% 反常地升高到了 85%。换言之,随着搜索树变深、系统依赖关系变复杂,模型越来越分不清改动的好坏,却反而变得更加鲁莽、更热衷于做出武断的决定。这种“判得越来越错,却越来越敢下定论”的病态模式,正是该工作所定义的“置信度悬崖”。
极简的 Rehearse 架构与“少即是多”的记忆哲学
置信度悬崖的出现表明,后期的算力浪费具有双重成因:一方面,能够真正突破强基线的优质算法本身变得极其罕见;另一方面,智能体自身的预判机制在复杂状态下失明,把大量本该规避的平庸方案送上了计算节点。
Rehearse 的核心思想并不复杂,它没有改动底层大模型的微调权重,也没有重构目标仓库的训练代码,而是以一种即插即用的轻量化 Skill 包装在现有的优化循环之上。它将过去“提出一个想法,立即执行训练”的贪婪单步循环,重构为 Propose–Predict–Execute(提出–预测–执行)的三段式工作流。
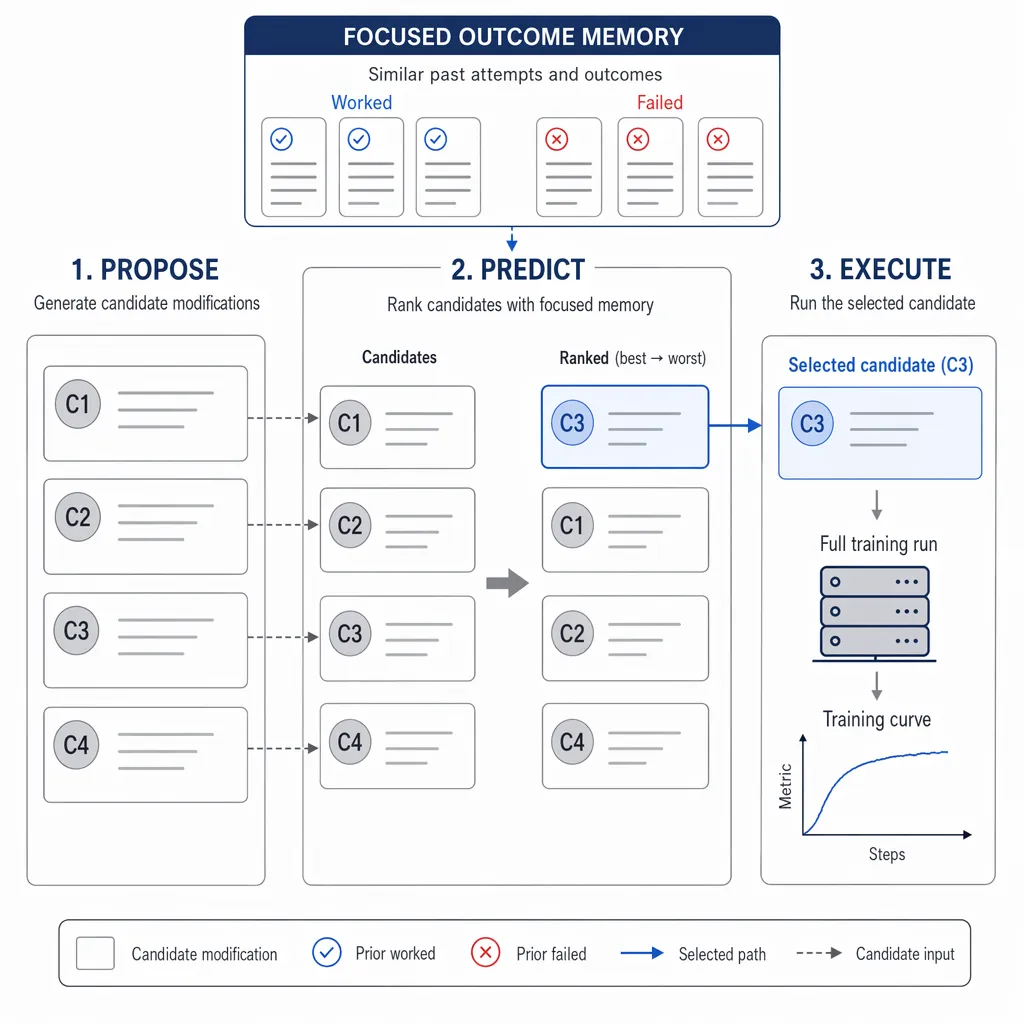
在每一个搜索步长内,Rehearse 首先由提议模块一次性生成多个并行的修改候选方案(例如 $N=5$)。随后,系统并不急于启动训练,而是由预测评审模块介入,通过穷举的两两比对锦标赛,在模型推理层面快速打分淘汰弱者,挑选出最优的一项候选方案($k=1$)付诸实际训练。当训练完成并获取验证集指标后,系统将代码变动与二元成败结果存入专门设计的“聚焦结果记忆库”(Focused Outcome Store)中。
这套逻辑的关键,在于预测评审阶段到底给模型看什么样的历史。以往许多通用智能体倾向于把历史上下文做成完整的对话日志,或者让大模型对过去的失败经验进行漫长的反思、归纳与总结。然而,Rehearse 的消融实验却颠覆了这一固有范式:记忆并不是越丰富越好,过度冗余的总结反而会成为大模型决策时的认知干扰。
在 Rehearse 的设计中,检索机制极其聚焦:当评审模型评估一个新候选修改时,系统仅在当前任务的历史尝试中,检索与该候选修改代码语义余弦相似度大于 0.40 的少数前例。更极端的是,这些检索出的历史记录被高度压缩为极简的单行纯文本——仅仅记录“改动了什么”以及“结果有效还是无效(Binary Outcome)”,彻底剥离了关于“为什么失败”的自然语言分析或冗长代码树摘要。
这种极简设计在单步基准测试中展现出惊人的威力。在基线累积成功改动超过 3 次的悬崖深水区,将全量执行日志硬塞给模型(类似 AIDE 系统的做法)仅能获得 70.8% 的选择性准确率;采用类似 Reflexion 的自我反思总结记忆,准确率也仅有 74.1%,且覆盖率虚高至 90%;即使是调用 LLM 精心提炼的结构化摘要,准确率也止步于 80.9%。而仅提供检索匹配的成败记录的 Rehearse,将深水区的选择性准确率强势拉升至 83.5%,同时将不靠谱的决断压制在更理智的覆盖率水平。
消融分析进一步表明,如果在检索出的历史记录中人为加入过往的失败原因分析,深水区的选择性准确率反而会从 83.5% 跌落至 80.6%,在包含失败解释的样本切片上更是惨跌至 54.8%。大模型极易被此前自己生成的反思文本带偏,陷入错误归因的逻辑陷阱;而冷酷、客观的代码修改事实与其二元运行结果,反倒构成了最坚固的决策先验。
为什么分类比精准排序更关键?
深入分析成对评估任务的内部结构,可以更清楚地看到评审模型在迭代过程中的行为特征。研究基准将成对样本划分为两大类别:
-
Type-1 样本:包含一个成功改动和一个失败改动,模型需要完成的是“有效与无效”的二元定性识别。
-
Type-2 样本:成对出现的两个修改均能提升最终指标,模型需要完成的是“谁的提升幅度更大”的定量优劣排序。
测试显示,在没有历史库辅助时,模型在 Type-1 样本上的选择性准确率为 79.5%,加入 Rehearse 聚焦记忆后提升至 84.2%;而在更为微妙的 Type-2 排序任务中,无记忆模型的准确率仅为 67.4%,Rehearse 也仅能将其提升至 74.1%。
这揭示了一个关于自动科研搜索的本质规律:在大模型驱动的长程优化中,预先执行判断的最大价值不在于精准挑出那个“满分答案”,而在于以极高的置信度把那些“注定失败”的劣质提案拦截在训练大门之外。
在深层迭代中,绝大多数被提议的改动实际上都是无用功。面对一堆大概率无法工作的平庸创意,只要评审机制能够稳准狠地将无效改动排斥出去,就能挽救海量的无效训练时间。在这一点上,分类过滤的作用远比细粒度的增量排序深远得多。
4000 次实机验证:终点指标全面突破
单步离线评估证明了 Rehearse 的预判精度,但它能否真正转化为端到端搜索效率的跃升?面对路径依赖、提议多样性变化以及真实运行中的各种随机扰动,研究团队在三套截然不同的机器学习优化闭环中,开展了总计 4000 次实机训练评估。
主实验采用了 Andrej Karpathy 开源的知名基准 nanochat 预训练循环。该循环要求智能体自主修改 train.py 中的代码,优化语言模型的验证集字符压缩比(val_bpb,越低越好),单次训练时间严格限制在 30 分钟,总预算为 100 次完整训练。为了将策略空间、筛选机制与记忆系统的增益严格剥离,实验设置了四组对照:
-
Vanilla(原始基线):每次只生成一个想法,不加辨别立即执行;
-
Propose-many:每次并行生成多个想法,但机械地仅执行第 1 个方案;
-
Select:并行生成多个想法,通过不带记忆的执行前评审,挑选胜出者执行;
-
Rehearse:在 Select 的基础上,挂载带有聚焦结果记忆库的预判体系。
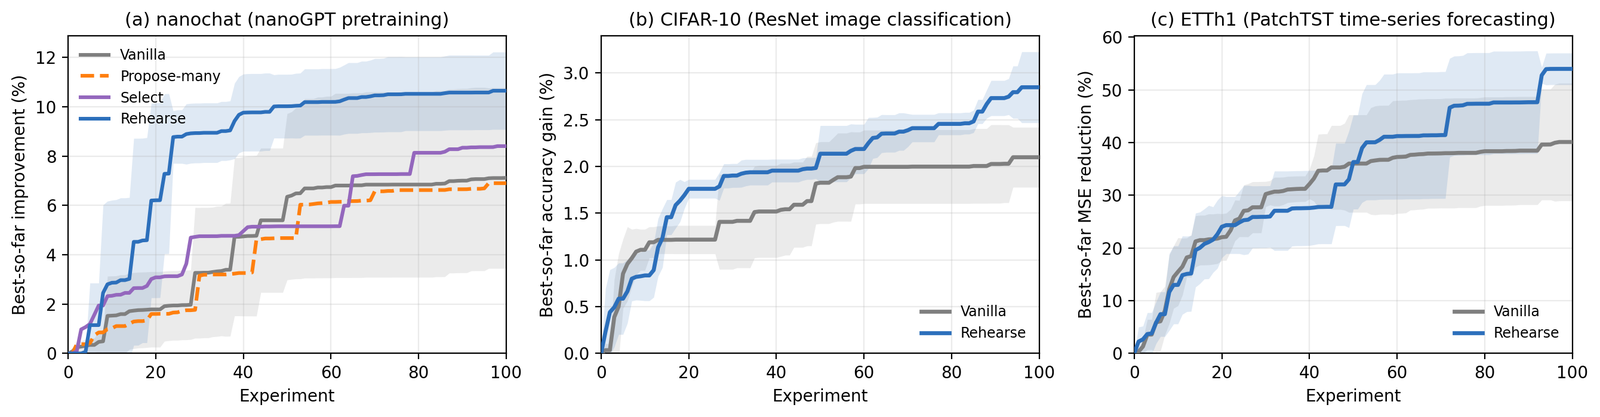
实验结果清晰地展示了各模块在不同搜索阶段的作用边界。首先,单纯扩大单步采样的广度并无实质意义:仅增加候选池但不做智能挑选的 Propose-many,最终平均性能提升(6.9%)与盲目单步推进的 Vanilla(7.1%)几乎没有差异。引入预测筛选的 Select 配置,将最终性能提升推高至 8.4%,它在前 30 次实验中迅速发力,由于候选池变大且有裁判把关,更早地挖掘出了调小 Batch Size 等核心大收益方案。
然而,一旦越过 50 次实验大关,未带记忆的配置纷纷陷入平台期,搜索步履维艰;而配备了聚焦记忆库的 Rehearse 却展现出惊人的后劲,持续稳定地取得边际突破,最终达成了 10.7% 的均值性能改善,相比无记忆的纯筛选方案实现了 2.3 个百分点的绝对增益,且在全部 5 个随机数种子下均稳定领先。
为了证明这一结论并非 nanochat 单一代码库或单一底座模型的特殊产物,团队将完全相同的框架迁移至另外两个应用场景:使用 GLM-5.1 驱动的 CIFAR-10 图像分类模型架构微调,以及使用 DeepSeek 系列模型驱动的 ETTh1 多元时间序列预测任务。在跨越视觉与时序信号、跨越不同大模型基座的跨界测试中,Rehearse 均在相同的 100 次训练预算下稳定超越了传统贪婪搜索方案,在时间序列预测任务上更是显著收敛了多次运行间的随机方差。
条件式复用与探索防线
在分析智能体具体的决策日志时,研究人员发现了一个颇具启发性的现象:聚焦记忆赋予了智能体更敏锐的“条件式复用”能力,而不是简单粗暴的“方向黑名单”。
传统的去重逻辑往往采用方向禁令机制:如果尝试调整权重衰减(Weight Decay)导致了模型崩溃,简单的启发式规则往往会全面封杀针对该参数的后续调整。但在真实的复杂系统优化中,这种黑名单往往会扼杀转机。例如在 nanochat 的一次实机运行中,智能体曾尝试将 Weight Decay 从 0.2 调低至 0.15,结果性能下滑被系统回滚;但在后续迭代中,Rehearse 检索出了这条失败先验,判断出“下调该参数行不通”,转而在后续尝试中持续反向调高该参数(从 0.2 逐步提高至 0.25、0.30、0.35),连续三次被系统采纳并最终贡献了显著增益。
数据统计表明,Rehearse 在长期运行中保留下来的成功改动中,有多达 87% 的参数或模块家族,在先前的历史中曾经产生过被回滚的失败尝试。这有力地反驳了依靠粗粒度规则进行方向级去重的思路。真正的科学优化不是一朝被蛇咬就彻底关死某扇门,而是在获知具体尝试的精确反馈后,在候选方案层面对改动幅度与方向进行更细腻的条件判断。
自动化科学优化的范式思考
长期以来,AI Agent 领域对于长程推理与经验复用的探索,陷入了一种“记忆越做越重、反思越做越长”的技术惯性。许多设计倾向于让模型写出洋洋洒洒的千字哲学总结,试图从中提炼放之四海而皆准的高维策略。
Rehearse 带来的关键启示在于:在面对确定性度量、代码逻辑与客观指标严密交织的硬核科学工程中,冗余的反思和概括往往是信噪比极低的毒药。由于模型自身对复杂状态的感知存在天然盲区,它所提炼出的宏观因果归因很可能漏洞百出,在后续的提示词中反而演变为固执的幻觉偏见。相比之下,将过往的真实客观试错,剥离为不含任何主观臆测的代码补丁片段与成败标签,由检索模块只在极度相似的局部情境下精准投喂,反倒能最纯粹地激活模型的判别潜能。
当算力成为限制大模型自我进化的首要瓶颈,如何在代码执行前建立一道高精度的“认知滤网”,正在成为高阶自治科研系统(Self-Improving Autoresearch)必须解决的前置课题。从盲目蛮干到学会谨慎预判,再到退后一步、避开深水区的置信度悬崖,Rehearse 展示了一种在不升级模型底座的前提下,仅仅依靠搜索机制与极简经验管理重构系统生产力的优雅路径。