OoO-Spec:乱序语义推测破除串行限制,工具调用提速最高达5.34倍
OoO-Spec: Out-of-Order Semantic Speculation for Fast Tool Calling
在大语言模型(LLM)驱动智能体(Agent)执行任务的各类落地场景中,工具调用(Tool Calling / Function Calling)已经成为最高频的核心操作之一。然而,现有的自回归生成机制在处理结构化工具调用时,面临着显著的效率困境:尽管开发者和模型往往能在看完整体输入与工具定义的一瞬间,就推断出应当调用哪个函数以及传入什么参数,底层解码器却依然只能像生成普通散文一样,严格沿着从左到右的文本顺序,一个 Token 接着一个 Token 地吐出 JSON 括号、引号、参数名与参数值。
ArXiv URL:https://arxiv.org/abs/2608.00814
现有的推测解码(Speculative Decoding)方案试图缓解这一串行计算开销。例如,专门面向工具调用的 ToolSpec 框架,通过状态机直接填充 Schema 中固定的语法符号,并结合历史调用缓存复用已有的参数值。但这种做法存在天然的短板:一旦当前请求需要填充一个在上下文或历史记录中从未出现过的全新动态参数值,系统就不得不重新退化为昂贵的逐 Token 串行自回归生成。
针对这一核心痛点,最新研究提出了 OoO-Spec(Out-of-Order Semantic Speculation,乱序语义推测)。这项工作的核心立意在于打破文本输出顺序对语义计算的禁锢:既然函数的选择与各个参数槽位在逻辑上彼此独立,模型就完全没有必要按照文本展示的先后顺序去串行等待。OoO-Spec 引入了一个仅有 0.6B 参数的极轻量语义“边车”(Sidecar)模型,在用户请求到达的瞬间,以无序、并行的方式单次激发出所有候选槽位的语义预测;与此同时,目标大模型毫不停顿地直接推进自身的解码循环。一旦边车的语义提示就绪,便无缝注入后续的候选树中交由目标模型快速核验。
这一设计在推理加速和架构解耦上展现出了极其强劲的性能。实验表明,仅仅在一个离线数据集上对 Qwen3-0.6B 完成一次轻量 LoRA 微调,该边车模型就能在完全不针对具体目标模型重新训练的前提下,直接零样本泛化服务于 Qwen2.5、Qwen3 以及 Llama 等不同架构、不同规模(3B 到 32B)的目标模型。在跨越 7 个主流目标模型与 3 大权威工具评测基准的 21 组对照实验中,OoO-Spec 全部拿下最优速度,端到端加速比达到 $2.46\times$ 至 $5.34\times$(平均 $3.89\times$),大幅超越现有方案,同时严格保持了原始贪婪解码的输出一致性。
从文本串行到语义并行:工具调用的本质瓶颈
理解 OoO-Spec 的突破点,需要先看清工具调用的本质逻辑与自回归解码之间的根本矛盾。一个典型的工具调用输出,本质上是一段具有严密语法约束的序列化文本(如 JSON 或 XML)。在传统的自回归流程下,目标模型必须为每个键名、冒号、逗号、引号以及具体的参数值逐一执行前向传播。
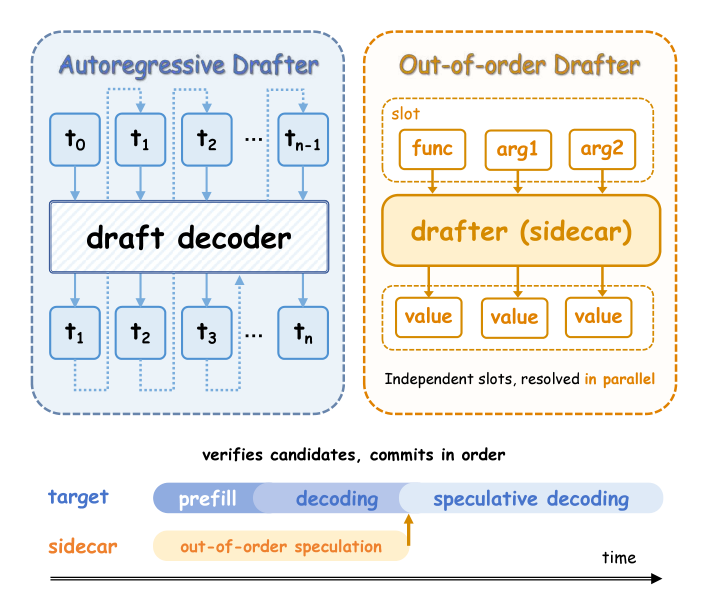
推测解码技术通常利用一个较小的草稿模型预先猜测后续 Token,再由大模型一次前向完成整体验证。近期涌现的 EAGLE-3、PARD-2 和 DFlash 等前沿草稿方法,虽然能够提出质量不错的候选片段,但它们无一例外都深度绑定了目标模型的隐藏层表征或专属词表。这意味着,开发者每引入一款新的目标模型,就必须耗费大量算力重新训练一个专用草稿模型,工程落地代价高昂。
免训练或基于缓存检索的推测机制(如 Prompt Lookup Decoding、Token Recycling 和 ToolSpec)虽然避免了模型训练成本,却被另一堵墙挡住了去路。以当前工具加速领域最具代表性的 ToolSpec 为例,它利用确定性有限状态机(FSM)快速跳过固定的语法脚手架,并通过检索以往成功的调用历史来猜测变量字段。然而,面对真实业务场景中那些与当前用户请求强绑定的新值——例如一段特定的订单号、用户刚刚随口说出的时间、或是动态生成的查询关键词——历史库中根本找不到对应内容。此时,ToolSpec 只能束手就擒,重新把计算任务甩给大模型去慢慢串行推理。
这便引出了解决工具调用加速的三重关键挑战:
-
生成未知新值:系统必须具备推理并生成当前请求专属的全新语义参数的能力,而不能仅仅依赖历史模板检索;
-
完全解耦并行:语义字段的计算必须在时间轴上与目标模型的执行解耦,以并行方式在后台运行,绝不能让草稿模型的推理延迟反过来阻塞目标模型的关键解码路径;
-
随到随用的弹性接入:异步产生的预测结果何时就绪是不可控的,系统必须能够在目标模型解码的任意生命周期中安全接入该提示,而不能强制目标模型原地空等。
边车架构与乱序解耦机制
为了化解上述矛盾,OoO-Spec 设计了如图 1 所示的全新架构模式。它的核心洞察是:在语义层面上,工具调用的内容是结构化且松散耦合的。文本序列上排在后面的参数,完全可以在前面的参数生成之前被提前解出。
系统的离线部分极其克制。研究人员仅使用 Qwen2.5-32B-Instruct 作为离线教师模型,在去重后的 API-Bank 和 ToolAlpaca 数据上生成一批结构化调用轨迹。随后,这些轨迹被清洗并解析为标准的紧凑 JSON 格式,完全剥离了原模型专属的 Token ID、对话模板以及控制字符,仅保留纯粹的语义映射。
基于这些语义数据,训练任务被展开为三类细粒度的槽位(Slots)监督形式:
-
函数索引任务(Function Index):根据当前对话上下文与工具定义,预测应当选择哪个候选函数;
-
参数键值任务(Argument Value or Null):针对候选函数中的每一个形参,独立判断其在当前请求下的具体紧凑 JSON 赋值,若该参数无需调用则输出 null;
-
整调用辅助任务(Direct Call):生成完整的归一化调用内容。
在训练阶段,团队仅为未适配的基础小模型 Qwen3-0.6B 添加了一层 LoRA 适配器,并在完成仅仅一个周期的因果交叉熵训练后便将其永久冻结。由于边车模型在离线阶段学习并输出的仅仅是通用的“语义文本字符串”,而不是针对某个特定模型的隐藏状态或 Logits,这就让同一个边车权重天然具备了跨模型架构、跨不同词表分词器的通用迁移能力。在后续的在线推理服务中,该教师模型完全退出,边车也再无须针对任何新目标模型执行额外的梯度更新。
在线异步双轨流水线
在线推理阶段,OoO-Spec 展现出了极高的工程协同美感。系统将单次推理拆分为目标模型主干路径与边车辅助路径两条完全异步的时序线。
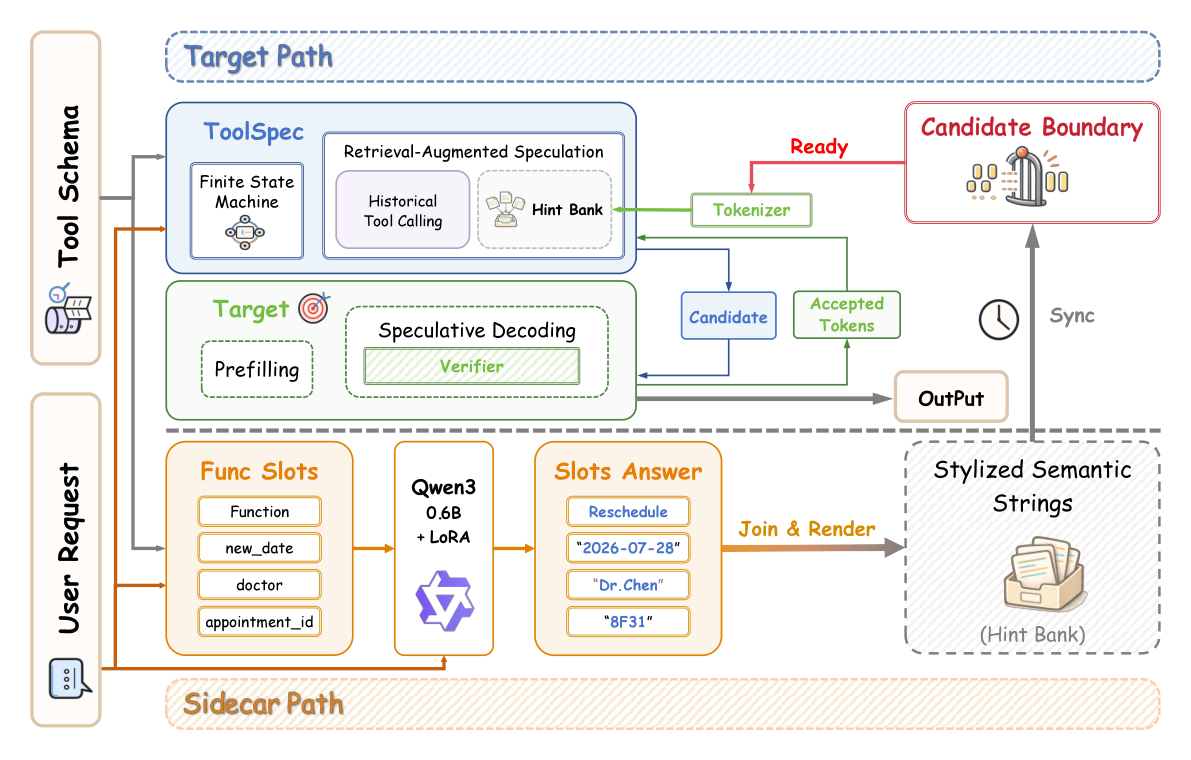
当用户请求到达系统时,运行时模块立刻向后台异步提交整个边车任务,同时毫不迟疑地直接启动目标模型的首字计算(Prefill)与原生的 ToolSpec 解码循环。在典型的双 GPU 物理分离配置下,目标模型与边车进程完全独立驻留在两张卡上,中间仅通过极轻量的回环 HTTP 协议传递解码后的字符文本。
在边车这一侧,系统首先根据工具列表中包含的所有候选函数及其参数集合,一次性构建出所有的槽位查询集合 $\mathcal{S}$。如果等待函数选定后再去查询其名下的参数,势必又会引入额外的串行延迟。因此,OoO-Spec 采取了激进的推测性批处理策略:将函数索引查询与所有参数的键值查询打包成单次 vLLM 请求波次,以贪婪解码并行推测。即使某些函数最终未被采纳,其伴随计算的开销在小模型批处理中也微乎其微。
当槽位预测返回后,后台响应处理链路立刻提取合法的 JSON 字段,过滤掉 null 与格式异常项,将函数名与对应参数拼接并渲染为标准对象。为了适配不同模型习惯的提示格式,运行时会利用冻结的布局策略,将其渲染为纯 JSON、Markdown 或类 XML 等等价文本视图。值得注意的是,这些视图代表的是同一份底层语义预测的不同文本形态,目的是为目标模型的词表提供多视角的匹配可能。
与此同时,目标模型在自身的时序线上平稳推进。ToolSpec 每次构建候选树的节点被称为“候选构建边界(Candidate-Construction Boundary)”。在边车结果尚未就绪之前,目标模型完全按照原有的 FSM 语法结构和历史调用进行常规推测与验证,绝对不会停下来等待边车。
一旦边车任务在后台完成,生成的文本视图会被目标模型自身的分词器重新编码,融合成一个当前请求专用的提示库(Hint Bank)。在接下来的任意一个候选构建边界,运行时通过非阻塞轮询感知到提示库就绪,便会立即执行后缀对齐匹配(Suffix Matching)。系统截取当前已经确认提交的文本前缀的最长后缀(尝试长度从 7 逐步退避至 1),在提示库中寻找精准匹配项,并将匹配点之后的内容作为草稿候选项压入当前的候选树中。
这种设计带来了几个绝妙的工程优势:
-
容忍任意时刻的到达:无论边车是在第 1 轮验证前返回,还是在第 3 轮验证中途返回,由于引入了基于当前已提交前缀的后缀对齐机制,迟到的提示依然能够准确接力后续尚未生成的 Token,而绝不会错误地覆写前面已经确认的字段;
-
极小且稳固的验证权限:目标模型永远保持唯一的“提交权威(Target Authority)”。边车输出的内容无论正确与否,都只是被当作候选分支参与一次树状前向验证。目标模型在第一个出现分歧的 Token 处立即执行截断和常规自回归重算,只有被目标模型通过的路径才会写入正式的 KV 缓存,彻底杜绝了小模型幻觉对最终精度的污染。
全面登顶的实验表现与关键现象
为了检验 OoO-Spec 的真实加速效能,研究团队在配有 H100-80GB GPU 的严谨环境下进行了全面评测。测试涵盖了 Qwen2.5 系列(7B、14B)、Llama 系列(3.2-3B、3.1-8B)以及最新的 Qwen3 系列(4B、8B、14B、32B)等 7 个主流目标尺寸,并在 API-Bank、ToolAlpaca 以及单次调用完全无工具复用性的极难基准 BFCL v4(Java/JavaScript)上展开了端到端对决。
在所有 21 组“目标模型-基准数据集”的严格交叉测试中,OoO-Spec 在每一组单元格中均取得了端到端耗时最短的冠军表现。相比于朴素的自回归解码,其实际加速比分布在 $2.46\times$ 到 $5.34\times$ 之间,非加权平均加速比高达 $3.89\times$。作为对比,此前最强的领域方案 ToolSpec 的平均加速比仅为 $2.95\times$。在 Qwen3 系列的 4B、8B、14B 模型上,OoO-Spec 的整体加速比分别飙升至 $4.46\times$、$4.73\times$ 和 $4.55\times$;与每组测试中表现最好的既有方法相比,OoO-Spec 带来的纯增量性能优势最高达 40.9%,平均领先幅度超过 23.4%。
这项评测揭示出一个在大模型加速领域极易被忽视的关键现象:单次验证接受的 Token 数量(#MAT)并不等同于最终的端到端吞吐速度。在 Llama-3.1-8B 的 ToolAlpaca 和 BFCL 测试中,基于扩散思想的先进草稿方案 PARD-2 的平均单步接受长度分别达到了 5.15 和 5.29 个 Token,明显高于 OoO-Spec 的 3.86 和 3.95。然而,在最终的端到端加速比上,PARD-2 却以 $2.18\times$ 和 $1.78\times$ 惨败给 OoO-Spec 的 $2.59\times$ 和 $2.74\times$。
原因在于系统层面的“草稿暴露开销”。传统的复杂草稿模型即便能猜出更多内容,但其单步计算本身的耗时、特征对齐的开销以及深度的时序依赖,全部赤裸裸地暴露在整体推理的关键路径上;而 OoO-Spec 的边车推测完全在后台乱序并行运行,即便其提供的预测长度较为克制,但这些预测被注入验证体系时几乎是“零额外时间成本”的。系统级隐藏的彻底性,直接决定了端到端墙钟时间(Wall-clock Time)的最终胜负。
更具实用价值的是其惊人的跨架构零样本迁移特性。整篇论文的所有评测数据,使用的都是同一个固定冻结的 0.6B 边车。这个基于 Qwen 谱系训练的极小模型,在完全不需要微调的情况下直接接入 Llama-3.1-8B,在 API-Bank 上轰出了 $4.36\times$ 的惊人加速比。这正是因为两者之间传递的是解码后的“语义字符串”,而非彼此排异的私有隐层张量。
在针对大尺寸模型的扩展性测试中,这种收益随着模型变大展现出了明显的正向放大效应。当目标模型从 Qwen3-4B 扩展到 8B、14B 乃至 32B 时,OoO-Spec 相对 ToolSpec 的加速优势不仅没有被庞大参数稀释,反而从 27.1% 一路扩大到了 37.3% 和 40.9%(平均提升 34.1%)。其背后的物理逻辑非常直观:边车推测的任务量只与工具槽位的语义复杂度有关,本身开销极其恒定;而目标模型越大,其执行单步验证的计算代价就越发昂贵。这意味着,异步边车每成功帮目标大模型节省一次验证前向传播,所折算出的绝对时间红利就越发巨大。
细粒度时延重叠与异构部署红利
为了彻底排除“加速是否仅源于两张 GPU 简单堆砌算力”的质疑,研究深入剖析了系统内部的时延与通信重叠情况。
在总计 4,290 次端到端请求的聚合统计中,目标模型主链路的平均执行耗时为 309.5 毫秒,而后边车模型的完整耗时平均仅为 85.0 毫秒。在双卡并发机制下,两者的时间消耗呈现出极为纯粹的异步遮蔽效应:OoO-Spec 测得的端到端平均总耗时为 311.9 毫秒,相比目标模型单跑仅仅增加了区区 2.4 毫秒。这确凿地证实,整整 85 毫秒的边车预测与格式处理开销,有超过 97% 被严丝合缝地隐藏在了目标模型的初始处理阶段之后。
时序统计还展示了一组击碎疑虑的数据:在所有实际请求中,有高达 65.2% 的语义提示在目标模型的第一次候选树构建之前就已经就绪;在目标模型完成整段解码之前,提示就绪的比例达到了惊人的 98.6%;最终,有 94.6% 的生成提示被目标模型在解码过程中实际采纳并消费。这意味着 OoO-Spec 绝非依赖罕见的极端巧合路径,而是在绝大多数常规请求下都能稳定发挥效能。
在通信负载方面,由于两端交互的仅仅是槽位解析后的文本内容,边车单次请求平均传回的语义有效载荷(Payload)仅为 85 字节。如此微小的传输量,使得它根本不需要昂贵的高带宽 NVLink 或张量并行通道,普通的单机回环接口甚至低成本网络即可承载。
这为现代 AI 基础设施的生产环境部署带来了极为诱人的想象空间:数据中心完全可以将珍贵、稀缺的高显存算力节点(如 H100、A100)全部留给负责最终校验与提交的目标大模型,而将轻巧的 0.6B 语义边车随意部署在边缘卡或成本低廉的通用推理芯片上。甚至,单台边车服务完全可以通过批处理并发服务于多套独立的目标模型实例。
从串行自回归的思维定势,跨越到面向语义槽位的乱序推测,OoO-Spec 不仅为智能体工具调用的超低延迟服务化提供了一套立竿见影的高效方案,更指引了大模型推理系统在“模型瘦身”与“纯工程重叠”之外,如何通过解构语义逻辑的内在并行性,开辟出全新的推测解码设计维度。