WitCert:运行时误差仪表盘,把崩溃的KV量化从22.8拉回79.7
WitCert: Sound Runtime Risk Observability and Gating for KV-Cache Quantization
在大语言模型推理走向超长上下文的今天,KV Cache(键值缓存)已经演变成最昂贵的显存黑洞。当上下文长度拓展到 32k、64k 乃至 128k 时,哪怕是一个 7B 规模的小模型,KV Cache 所消耗的显存也会迅速超越模型权重本身。为了让单张 GPU 承载更长的序列或更高的批处理并发,业内涌现了大量 KV 压缩技术,涵盖标记驱逐(Token Eviction)、通道与频域剪枝、低秩分解以及低比特量化等。
ArXiv URL:https://arxiv.org/abs/2607.28699
然而,现有所有 KV 压缩方案都存在一个致命的系统性盲区:它们全都是“开环系统”(Open-loop)。工程师们在离线评测集上算出几个满意的困惑度或基准跑分,就把固定的量化规则或者驱逐启发式策略部署上线;一旦进入真实的流式服务,底层系统对“当前这次请求是否已经被量化误差彻底破坏”一无所知。在恶劣输入下,原本高精度的模型可能在某次检索中出现毫无预警的静默崩溃——例如 SnapKV 在某些复杂针尖任务上,准确率会从 100 骤降至 1.1 到 65,而推理引擎内部却连一条警告日志都打不出来。
论文《WitCert: Sound Runtime Risk Observability and Gating for KV-Cache Quantization》正是为了打破这种盲目妥协。研究团队构建了一个数学上严格可靠(Sound)的运行时检测仪——WitCert,被誉为大模型 KV 量化领域的“DTrace”。它能在模型生成每个 Token 的瞬间,给出注意力分布全变差(Total Variation)的数学理论上界;并在误差超标时联动门控机制进行精确回退。在困难的 RULER 基准测试中,原本崩溃至 22.8 分的激进 FP8 量化被 WitCert 稳稳拉回至 79.7 分,与完全未压缩基线的差异被压缩在 $[+0.0, +0.8]$ 的极窄置信区间内。更重要的是,这套机制已成功嵌入生产级推理框架 SGLang,为长上下文在线服务的可信运行提供了全新的范式。
为什么在线监控 KV 误差如此困难?
要让 KV 缓存从“盲目压缩的开环”变成“可观测可调控的闭环”,核心前提是必须在解码运行时高效计算出误差上界。先前并非完全没有理论尝试,例如此前针对量化注意力的运行时证明工作给出过基于数据无关的最坏情况界,即通过 $\mathrm{TV} \leq \tanh(\max\vert{}\varepsilon\vert{})$ 来约束注意力全变差。但这类界由于完全脱离实际激活分布,推导过于保守;在工业界容忍的常规误差阈值(例如 $\tau \leq 0.2$)下,它算出来的理论安全压缩率几乎永远是 0,导致任何压缩尝试都会被否决,完全无法用于生产。
要让数学证明真正允许压缩发生,误差界就必须是“数据相关”(Data-dependent)的。但一旦走向数据相关,两个近乎死结的工程与数学阻碍立刻摆在眼前。
第一个障碍是因果倒置。量化误差发生在一个 Token 写入缓存的那一刻,但这个 Token 对注意力机制造成的实际 Logit 扰动,取决于未来的 Query 向量与当前 Key 误差的点积。在写入 Key 的时候,未来的 Query 根本尚未产生;如果等每一个解码步 Query 出现后再遍历庞大的历史缓存去逐个计算真实误差,其开销将彻底抵消量化带来的任何吞吐收益。
第二个障碍则来自于现代大模型的核心组件——旋转位置编码(RoPE)。当代主流大模型为了保证自注意力具备相对位置感知能力,存入 KV Cache 的 Key 向量通常是经过 RoPE 旋转之后的向量。旋转算子紧密耦合了 Token 的序列绝对位置;如果量化后的残差特征随着位置旋转而发生剧烈形变,那么任何提前记录的误差度量都会在后续的位置变换中失效,迫使推理引擎每走一步就必须针对全局缓存重新计算几何投影。
频带酉性与双层证书:WitCert 的破局机制
面对上述困境,WitCert 提出了极为精巧的几何分解方案,其理论核心建立在对 RoPE 结构的频域洞察之上。
研究团队指出,RoPE 在数学本质上是一个关于频率对(Frequency Pairs)的分块对角正交变换。如果将注意力的特征维度划分为若干个局部的连续频带(Bands),RoPE 在每一个频带的子空间内都构成了纯粹的正交旋转。根据论文给出的“RoPE 频带酉性引理”(RoPE band unitarity),对于任意给定的频带 $b$ 以及任意相对旋转步长 $n$,残差向量经过旋转后的频带欧氏范数与旋转前严格恒等,即 $|(R_n x)_b| = |x_b|$。
这个引理直接扫清了 RoPE 带来的动态位置迷雾:在 Token 写入 KV Cache 的瞬间,系统计算出残差向量在各个频带上的欧氏范数 $w_{t,b} = |r_{t,b}|$ 并随缓存保存为“存根”(Witness)。无论后续解码步的相对位置如何变化,该存根在几何尺度上永久保持不变。当某个未知的 Query 向量在第 $t$ 步抵达时,利用柯西-施瓦茨不等式,Logit 的扰动绝对值可以直接被极速绑定:
\[\vert{}\varepsilon_t\vert{} = \frac{\lvert q \cdot r_t \rvert}{\sqrt{d}} \leq \frac{1}{\sqrt{d}} \sum_{b=1}^{B} \|q_b\| \, w_{t,b} =: c_t\]在系统落地中,WitCert 仅需划分 16 个频带,每个 Token 的每个注意力头仅增加 32 字节的紧凑存根,便彻底解决了 Query 滞后与 RoPE 位置旋转的双重挑战。
在此坚实几何结构之上,WitCert 构建了双层运行体系,兼顾了通用黑盒量化与专用受控量化:
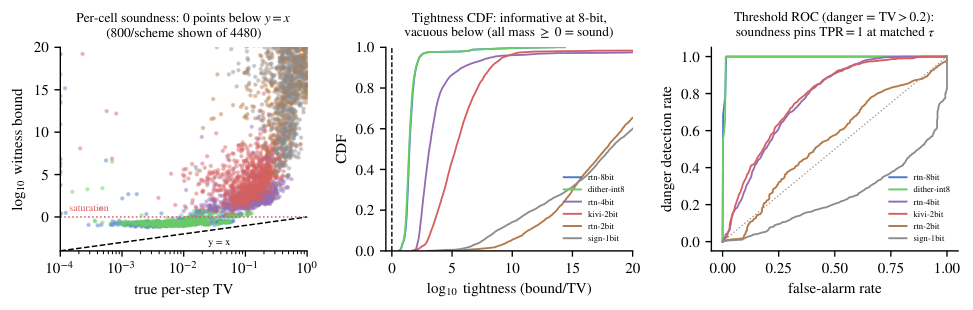
上图揭示了 WitCert 第一层(Tier A)通用确定性测量仪在六种黑盒量化器上的微观表现。从左侧散点图可以清晰看到,所有数据点无一例外地落在对角线 $y=x$ 的上方,这在数学上实证了该上界是绝对可靠(Sound)的,绝不存在低估风险的漏洞。中间的累积分布函数(CDF)表明,8-bit 量化方案的紧致度(Bound/TV)高度集中在 $10^{1.5}$ 附近,展现了极强的可用性;而 1-2 bit 等极端粗暴方案则直接饱和失效。右侧的 ROC 曲线进一步证实,对于常规 8-bit 量化,该仪表盘作为危险预警分类器(定义危险为 $\mathrm{TV} > 0.2$)的 AUC 表现极佳,能以近乎为零的虚警率捕捉全部危险。
为了进一步压榨显存极限,WitCert 还推出了第二层(Tier B)概率凭证机制。针对系统可控的 INT8 量化,作者引入了经典信号处理中的“减法抖动”(Subtractive Dither)技术。在写入时引入均匀伪随机扰动,在读取反量化时借助 Philox 伪随机数发生器以确定的随机数流精确对冲消解。这一操作打破了量化残差与输入数据之间的依赖关系,使残差严格服从均匀分布并展现出优异的亚高斯(Sub-Gaussian)性质。更为惊艳的是,Tier B 方案通过对单个请求分配显式的失效率预算(Failure Budget $\delta_{\text{req}}$),完全不需要存储额外的 Witness 存根,在零显存元数据开销下,仅凭亚高斯浓度不等式即可推导出极其紧凑的置信区间。
在数学推导的严谨性上,作者展现了极其克制的学术自省。论文公开披露了一个曾在团队内部实验中通过了 32,256 次聚合检验的“伪凭证”公式,指出该公式在批次平均意义下看似天衣无缝,但一旦在单 Query 的对抗极端分布下,真实全变差会被低估高达 7.8 倍。作者随后给出了严格正确的替代证明 $\mathrm{TV} \leq \frac{1}{2}(A^2 - 1)$,并将核心定理使用 Lean 4 进行了机器形式化定理验证(Machine-checked),彻底杜绝了理论推导上的潜在漏洞。
激进量化为什么能“苟活”?跨层误差相消的真相
长期以来,工业界常常困惑于一种矛盾的现象:很多极低比特或极其粗暴的 KV 压缩算法,其单步的注意力误差(Per-step error)明明已经大得惊人,但在许多离线评测基准上,模型最终生成的文本似乎依然通顺。
WitCert 的在线探针首次揭开了这一底层谜题:激进量化方案之所以能维持表面上的端到端性能,绝非因为局部的单步注意力精度得到了保留,而是依赖于 Transformer 架构深处的“跨层误差相消”(Cross-layer error cancellation)。
为了验证这一点,研究人员在 28 层模型上设计了详尽的逐层污染扫描实验。实验惊人地发现:在整整 28 次单层注入中,哪怕将其中任意单独一层的 KV Cache 彻底以粗暴量化严重污染,模型的端到端任务损失几乎完全为零(0/28 出现退化)。模型的残差连接和深层网络展现了强大的单层纠错韧性。然而,当多层同时进行未经监控的激进压缩时,误差便会在深层前向传播中不可逆地恶意累积,最终在某一步突发雪崩。
这一机制发现具有极其深远的指导意义。它不仅在微观层面解释了为什么粗糙方案有时能“侥幸过关”,更阐明了为什么局部的逐步单层理论界在直觉上容易偏向保守:因为数学界必须防御每一次可能发生的局部失真,而现实模型则在多层动力学中吸收了部分噪声。但正是因为跨层累积的不可预测性,才更需要 WitCert 这样坚固的运行时下界,时刻防范静默雪崩的发生。
SGLang 生产级落地与闭环门控修复
理论与观测的终极目标是驱动系统的自我修复。WitCert 在知名高吞吐推理系统 SGLang 中完成了深度工程闭环。
在整个系统架构中,监控与修复形成了优雅的自洽循环。当请求涌入预填充阶段时,写入内核在完成量化的同时记录轻量级的频带范数存根;进入自回归解码阶段后,注意力解码算子在一个融合的计算 Pass 中同步吐出注意力输出与当前步的误差全变差上界。
系统并非盲目地对所有出现波动的请求直接回退,而是采取了分级门控机制:在凭证处于信息丰富区间时,严格依据置信凭证触发保护;在仪表盘数值饱和的高风险区,则按照风险得分进行排序截断。一旦某个注意力头或某个 Block 的累积风险越过安全水位线,门控机制就会启动精准的换页回退(Fallback),从全精度的后备存储(Backing Store)中换入无损的分块缓存,随后直接将该修复区域的存根清零,从而以极小的开销把系统拉回安全区。
将这种数学理论搬进生产级系统面临着严酷的工程约束。首先是 CUDA Graph 的兼容性问题。现代高并发推理极度依赖 CUDA Graph 消除主机端的发射延迟,而传统的 Python 运行时探针因为频繁引发 CPU 与 GPU 之间的同步,会直接导致图捕获失败。WitCert 将 Philox 随机数生成器设计为绑定自包含的五元组计数器(请求 ID、层号、KV 头号、Token 序号与通道号),使状态完全独立于批处理调度顺序,实现了 CUDA Graph 录制与重放下的完全比特级重现。
其次是计算吞吐的极致取舍。由于采用了分块(Block)缩放因子,在同一个 Tile 内部方差标量与 Token 相互独立,使得原本复杂的双张量矩阵乘法累加器被直接折叠为单个标量与 Softmax 行和的轻量乘积。在 SGLang 0.5.9 针对高并发极致调优的生产级解码内核中,引入这一完整的可证明闭环监控仅带来了 11.9% 的延迟开销;而在同等硬件显存预算下,依托认证后的 INT8 压缩,系统能够驻留并服务的有效 KV Token 数量飙升了 1.88 倍。
在稳定性与长序列评测上,WitCert 同样经受住了苛刻的实战考验:
在 RULER 难任务长文本基准下,未经防护的原始 FP8 强制转换直接让模型在检索任务中惨烈失分至 22.8,而 WitCert 门控回退机制在保持绝大部分压缩显存红利的同时,将整体精度强力挽救至 79.7,无损保障了业务底线。
在由 DeepSeek-R1 蒸馏模型生成的大量长思维链(Long CoT)高难度推理样本中,面对自回归生成带来的极端尖锐注意力分布,WitCert 的 KV 头凭证覆盖率稳定维持在 0.800 左右,与常规自然文本基线完全一致,未发生任何灾难性凭证失效。而在长上下文扩展测试中,研究人员更进一步厘清了注意力机制的本质:在采用外推方案的 YaRN 模型上,覆盖率会因位置插值带来的统计畸变而有所下降;而在原生支持 131k 超长上下文的 Llama-3.1-8B 上,从 8k、32k 一路测试至 128k 极限长度,WitCert 的联合覆盖率始终平直稳定地锁定在 71% 至 77% 的高位区间,全过程零违规。
从静态调优到运行时自省
回顾大模型工程的发展路径,从模型压缩、推测解码到批处理调度,过去几乎完全仰赖经验主义的静态参数与离线基准评测。然而,随着智能体应用和多轮复杂推理将上下文推向前所未有的长度,线上流量的长尾分布和恶劣对抗场景决定了“离线万全”已是一句空话。
WitCert 的核心价值不仅在于提供了一套能在实际推理引擎中高效跑通的 KV 误差仪表盘,更在理论与工程的交汇处树立了一种极具启发性的思路:大模型系统软件正在从“无感知的开环启发式运行”,迈向“带有数学严格保证的运行时自省与闭环防御”。
在未来,这种轻量、确定、在数学上严密的运行时监控体系,很可能会成为大模型 Serving 基础设施的标准配置。无论是决定动态驱逐哪些不重要的上下文,还是在端云协同中自适应调度量化精度,一个能够时刻感知自身受损程度的大模型系统,才能在复杂多变的生产环境中,真正实现显存收益与生成质量的兼收并蓄。