UniMem:让大模型边用边学,解耦路由机制助力连续任务EM提升4分
UniMem: Complementary Episodic-to-Parametric Memory for Boundary-Agnostic Task Streams
在让大模型扮演自主智能体(LLM Agent)的道路上,如何让模型像人类一样在与环境的持续交互中累积经验,是一个悬而未决的底层难题。当前的通用大模型一旦完成预训练和指令微调,参数便处于冻结状态;当面对不断涌入、类别无边界且动态演进的任务流时,系统往往在“死记硬背”与“灾难性遗忘”之间痛苦摇摆。
ArXiv URL:https://arxiv.org/abs/2607.26017v1
工业界和学界对此主要有两条技术路线。一条是以检索增强生成(RAG)为代表的外部情景记忆,它能零成本、极快地吞下新样本,具备极高的可塑性,却往往难以把高频出现的复杂执行逻辑真正“内化”为稳定的模型直觉,并且在推理时面临沉重的检索与上下文长度开销。另一条路线则是基于参数高效微调(PEFT,如 LoRA、Prompt Tuning)的参数化记忆,虽然能够把特定流程固化在轻量参数中、推理高效且稳固,但绝大多数方案都默认任务存在清晰的边界切片,且参数池容量预先设定,无法在开放流式环境下自主应对未知任务的缓慢膨胀。
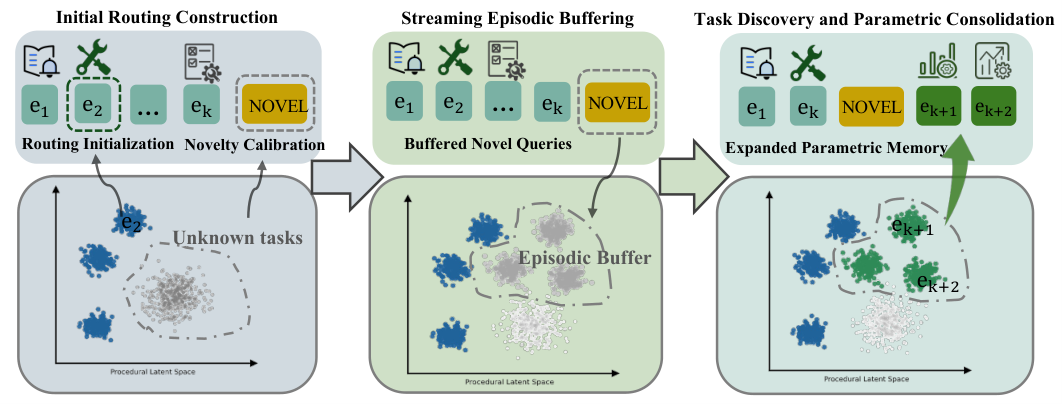
来自中国科学院自动化研究所、北京大学、美团及伦敦大学学院的研究团队,在一项最新研究中提出了名为 UniMem 的自路由记忆框架。该框架受人类大脑互补学习系统(Complementary Learning Systems, CLS)的启发,在无显式任务标签、无清晰任务边界的流式任务场景下,解耦了“任务识别”与“任务执行”。UniMem 通过可学习的路由标记动态仲裁记忆通路:低频或未知任务先暂存于外部情景缓冲区并借助检索辅助执行;而反复出现的高频任务则通过无监督聚类机制,自主固化为全新的模块化参数记忆。在涵盖多个大模型基准的长程流式任务评测中,UniMem 相比现有主流基线取得了平均 4.0 个 EM(Exact Match)点的性能增益。
稳定性与可塑性的拉锯:流式智能体的记忆死结
人类大脑之所以能终身学习,关键在于海马体与大脑皮层之间的分工协作。海马体负责快速记录瞬时、具体的情景经验(Episodic Memory),展现出极高的可塑性;而大脑皮层则在随后的睡眠和静息状态下,将这些经验中重复出现的统计规律与通用结构,缓慢固化(Consolidation)为持久稳定的语义与程序性知识(Parametric Memory)。这种互补机制天然规避了两种极端风险:既不会因为遇到几个偶发个案就全盘打乱已有的长期知识体系,也不会因为固步自封而丧失吸收新事物的能力。
反观现有的大语言模型 Agent 记忆机制,往往缺乏这种跨周期的渐进式固化能力。如果纯粹依赖外置上下文记忆,模型每次遇到相同或相似的任务,都需要在庞大的向量数据库中执行检索,再把过往经历拼接在提示词中重新推理。这不仅耗费昂贵的推理算力与延迟,更关键的是,许多复杂操作逻辑只靠 Context 中的 Few-shot 示例根本无法百分之百稳定复现,执行保真度严重受限于模型的上下文窗口与注意力聚焦能力。
若转向纯参数化方案,连续吸收新任务又不可避免地撞上连续学习的终极拦路虎——灾难性遗忘(Catastrophic Forgetting)。多任务连续微调会导致先前任务的表征空间遭到冲刷侵蚀;哪怕引入了 LoRA 等模块化隔离方案,现存方法也大多依赖先验假设:系统必须在数据流进来时就知道当前属于“任务 A”还是“任务 B”,以便人工指派专用的适配器。但在真实的开放环境部署中,用户下达的指令杂乱无章,既不会附带清晰的任务类型标签,也不会按照批次规整划分,任务流呈现完全的“边界不可知”(Boundary-Agnostic)特征。这就要求智能体必须具备自主识别已知模式、辨析全新未知以及按需拓展参数容器的统合能力。
UniMem 核心架构:解耦任务识别与任务执行
为了破解这一矛盾,UniMem 的核心思路是将“判断当前面对什么任务”与“具体如何执行该任务”彻底拆解为两套协同演化、各司其职的组件。
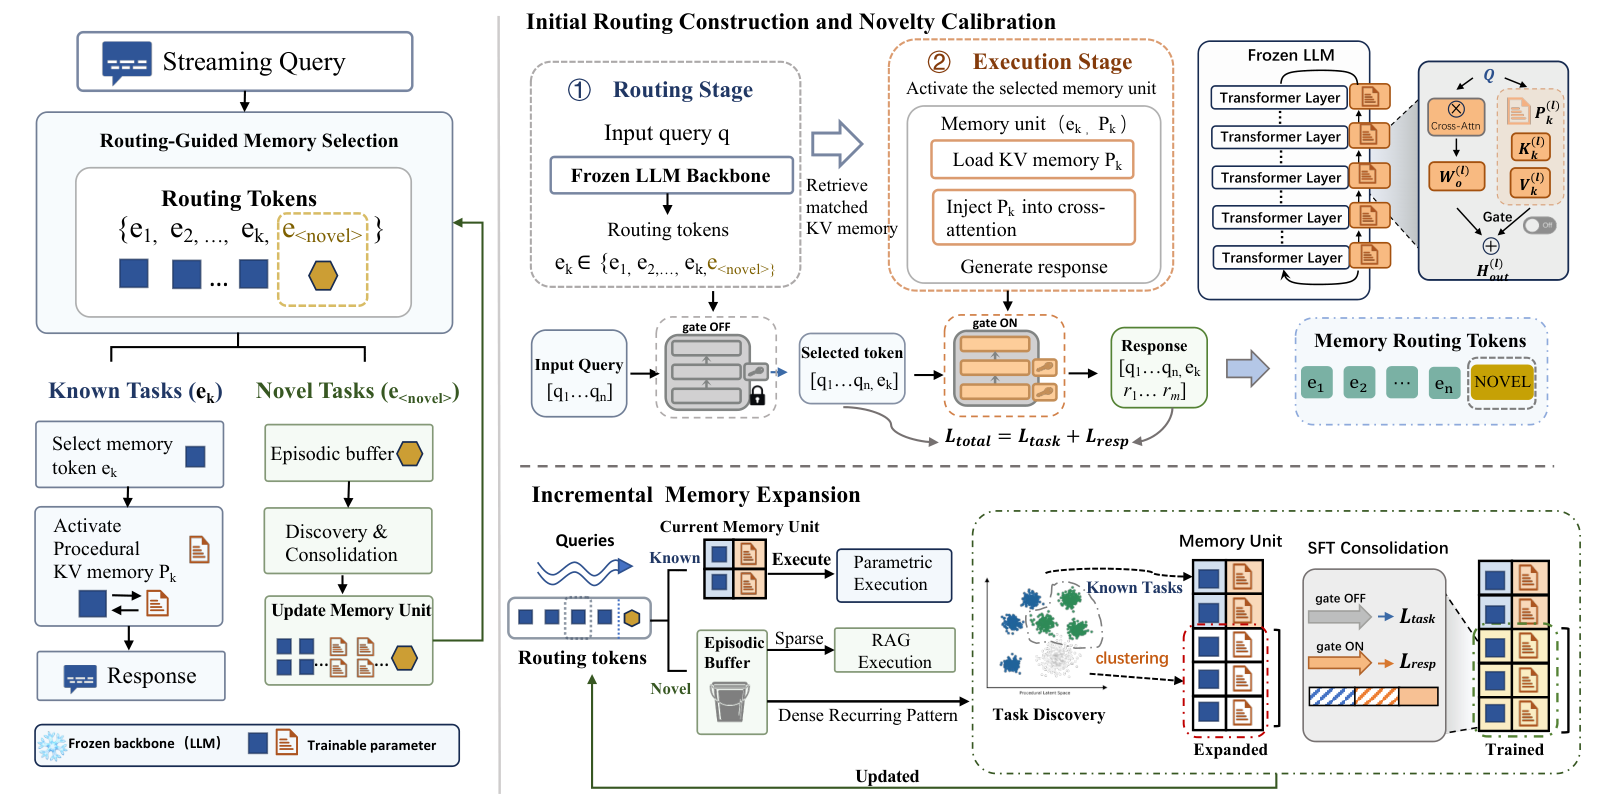
整个系统由三个主要部分构成:轻量级路由标记矩阵、模块化参数记忆单元,以及动态情景缓冲区。
UniMem 维护着一个由向量构成的路由标记矩阵 $\mathbf{E} = [\mathbf{e}1, \dots, \mathbf{e}_K, \mathbf{e}{\texttt{NOVEL}}]$。其中,$\mathbf{e}1$ 到 $\mathbf{e}_K$ 分别代表已固化的 $K$ 个已知任务的路由锚点,而 $\mathbf{e}{\texttt{NOVEL}}$ 则是一个经过校准的“未知哨兵标记”(Novelty Sentinel)。
当输入一个用户查询 $q$ 时,冻结的主干大模型先提取其前缀状态表征 $\mathbf{h}_q$。UniMem 并不直接调用庞大的生成网络,而是利用轻量级点积与 Softmax 操作,在极低的计算开销下计算其在路由空间中的分布概率:
\[P(\mathbf{e}_k \mid q) = \frac{\exp(\mathbf{h}_q^{\top}\mathbf{e}_k)}{\sum_{j} \exp(\mathbf{h}_q^{\top}\mathbf{e}_j)}\]这里的路由策略遵循严格的置信度门控原则:只有当某个已知任务标记 $\mathbf{e}k$ 的激活概率同时超过了未知哨兵 $\mathbf{e}{\texttt{NOVEL}}$ 以及预设的置信度阈值 $\tau_{\mathrm{route}}$ 时,系统才会将其裁定为“已知任务”,并激活对应的参数记忆块 $\mathbf{P}_k$。
对于被判定为已知的任务,UniMem 进入高效的参数化执行阶段。系统选用的参数记忆块 $\mathbf{P}_k$ 在论文中被具体实现为一种层级“程序化键值记忆”(Procedural KV Memory)。它由各 Transformer 层中附加的可学习键值对 $(\mathbf{K}_k^{(l)}, \mathbf{V}_k^{(l)})$ 组成。在模型的各注意力层中,隐藏状态计算通过带有门控机制的交叉注意力进行增量注入:
\[\mathbf{H}_{\text{out}}^{(l)} = \mathbf{H}_{\text{orig}}^{(l)} + g^{(l)} \cdot \text{CrossAttn}\Big(\mathbf{Q}^{(l)}, \mathbf{K}_k^{(l)}, \mathbf{V}_k^{(l)}\Big)\]通过这种方式,主干模型参数始终保持完全冻结,所有针对特定任务的专业执行经验都被完全隔离在独立的 KV 槽位中,从物理结构上斩断了不同已知任务之间的参数冲突与干扰。
更精巧的设计在于 UniMem 的解耦优化目标。在学习已知任务时,路由损失 $\mathcal{L}{\text{route}}$ 与执行损失 $\mathcal{L}{\text{exec}}$ 分开反向传播。路由层仅负责基于查询本身更新路由标记的位置,优化分类边界;而参数记忆块则仅在执行目标指令时被激活并优化。两者参数梯度的互不干扰,确保了任务判断的灵敏性与具体任务生成的精准度各得其所。
从情景到参数:两阶段演化生命周期
静态的路由机制并不能解决流式环境中的动态演化问题。UniMem 的精髓在于其受人脑记忆固化过程启发的两阶段动态生命周期。
第一阶段是路由空间的初始化与未知哨兵校准。在系统初始化接入基石任务集时,UniMem 首先拟合已知任务的路由标记。为了赋予系统“知道自己不知道”的能力,团队并没有简单采用固定的距离阈值,而是从已知任务集中专门留出一组伪未知任务(Pseudo-unseen Tasks)作为校准集。
系统根据已知标记的几何分布平均模长 $\bar{r}$,通过添加受控高斯扰动构造出初始的未知哨兵向量:
\[\mathbf{e}_{\texttt{NOVEL}} = \bar{r} \cdot \frac{\bar{\mathbf{e}} + \boldsymbol{\epsilon}}{\|\bar{\mathbf{e}} + \boldsymbol{\epsilon}\|}, \quad \boldsymbol{\epsilon} \sim \mathcal{N}\big(\mathbf{0}, (0.05\bar{r})^2\mathbf{I}\big)\]随后,路由层在一个包含所有已知类别加上 NOVEL 类的分类目标下进行校准训练。已知任务的样本被引导对齐到各自的专用标记,而留出的伪未知任务样本则全部强制对齐到 $\mathbf{e}_{\texttt{NOVEL}}$。这一训练流程极大地强化了路由层对领域偏移与分布外指令的辨别敏感度,为后续免除人工标签的流式部署打下了地基。
第二阶段是流式部署中的自主任务发现与参数固化。进入连续运行状态后,流式到来的查询如果置信度不足或判定为新模式,就会被直接导流至外部的“情景缓冲区”(Episodic Buffer)。在缓冲区内,这些未被参数化的样本并不会被闲置,而是作为外部检索样本,通过标准的 RAG 方式辅助当前推理。这种策略为偶发性、长尾或零散的新任务提供了低成本的安全托底保障。
当缓冲区积累的数据达到容量上限 $C$ 时,系统自主触发离线聚类与固化判定。为了避免将语义相似但并非同一流程的噪声错误凝结成参数,UniMem 部署了极为谨慎的质量筛选流水线:
-
利用规范化压缩距离(Normalized Compression Distance, NCD)度量序列间底层的结构与模式相似性,规避单纯依靠表面词向量相似度带来的假阳性;
-
采用无需预设簇数量的密度聚类算法 HDBSCAN 自适应捕捉候选簇;
-
设立严苛的质量门控:只有通过了中心距离离群过滤与内聚度检验的高质量密集簇,才会被批准“晋升”为新任务。
对于审核通过的样本簇,UniMem 会立即动态分配一个新的路由标记 $\mathbf{e}{\text{new}}$,并挂载一个全新的 Procedural KV 记忆块 $\mathbf{P}{\text{new}}$。随后,系统利用该簇内的累积样本对这一新配对的记忆单元执行监督微调(SFT),正式将该类工作流从外部情景记忆固化为内生参数。而未能通过质量检验的稀疏离群样本,则继续滞留在情景缓冲区中,等待后续数据流的进一步验证。这种按需扩展机制既抑制了参数的盲目膨胀,又保证了复杂高频任务最终能够摆脱对上下文检索的依赖。
实验评测:长程流式任务下的稳健进化
为了验证 UniMem 在极端无边界流式环境下的实战能力,研究团队构建了兼顾广度与复杂度的评测基准。
在任务广度方面,研究基于 Super-Natural Instructions(SNI)构建了高达 100 个任务的长程流式生成序列。为了拟合现实长尾效应,序列中刻意将部分任务限制为仅有 10 个样本的极稀疏任务,以测试系统是否会盲目分配参数。评测选用了覆盖不同规模的参数底座,包括 LLaMA-3.2-3B、LLaMA-3.1-8B 以及 Qwen3-8B。在复杂推理方面,团队选用了涵盖 BoolQ、CB、RTE、COPA 等六大强逻辑推理任务的 SuperGLUE 混合流,在完全抹除任务切换边界的前提下评估 LLaMA-1B 与 LLaMA-3B 的持续表现。
实验对比了四类具有代表性的技术基线:
-
Base (Zero-Shot):完全不进行任务自适应的主干模型原生输出;
-
Standard RAG:依赖外部向量库检索 Top-k 历史相近示例注入 Prompt 的外部记忆代表;
-
Replay LoRA:在连续学习中最为稳固的参数回放基线,在后续微调时以 10% 的比例回放历史样本;
-
Adapted TOKMEM:代表性的前沿标记级程序记忆方案,在取消人工任务标签后适配到流式场景。
在 SNI 百任务长程流式序列评测中,UniMem 在三款不同的主流大模型底座上全面压制了各类对比方案。以精确匹配率(Exact Match, EM)衡量,UniMem 相比次优基线平均取得了 4.0 个百分点的提升。而在 SuperGLUE 混合流测试中,面对 COPA 等需要细粒度因果推理的任务,常规的 Replay LoRA 极易在跨任务混淆中发生逻辑退化,而 UniMem 凭借独立的参数空间与高保真路由,展现出了更强的执行准确率。
在消融实验与定性追踪中,研究团队深入分析了 UniMem 的工作机制。
针对参数隔离的必要性,团队对比了 UniMem 与“共享参数空间的 Shared KV Memory”。在 LLaMA-3.1-8B 上,当任务规模处于 10 个以内时,参数共享与参数隔离的 EM 差距仅有 1.2%;但当任务流持续推进至 50 个以上时,共享参数模型的内部特征空间剧烈挤压,两者的性能差距迅速拉大到 2.7%。这证明了在面对开放域长程演进时,模块化参数物理隔离是阻断灾难性遗忘的不可或缺的基础设施。
在追踪动态部署中内存增长曲线时,数据进一步揭示了 UniMem 的自适应节制性。在面对穿插了 100 个新任务的 16000 个流式样本中,UniMem 最终仅新增了 76 个参数化记忆单元,而非机械地为每个新任务建一个模块。在这之中,10 个稀疏长尾任务因始终未达聚合阈值,全程平稳驻留在情景缓冲区内由 RAG 驱动;另有多个语义高度重叠的任务则被无监督聚类算法成功归并到了已有相近单元中。这种“低频走检索、高频化参数”的动态博弈,成功抑制了参数量的无序飞涨。
价值与局限
从更大的技术演进视角来看,UniMem 摆脱了传统连续微调对显式任务边界的依赖,也跳出了纯 RAG 方案在长程复杂执行场景下的上下文开销泥潭。它用一套优雅的二元互补机制,初步验证了让大语言模型智能体在开放世界中“自发积累经验、自主分级固化”的可行性。这对于未来需要 7x24 小时长期驻留并在垂直业务流中不断演化适应的 AI Agent,具有非常直接的工程启发意义。
当然,该框架目前仍有其探索边界。一方面,为了防止错误记忆污染参数,UniMem 采取了相当保守的聚类固化准则,这导致某些中等频次但跨度极长的复杂任务在情景缓冲区中滞留过久;如何在流式环境下设计出更加敏捷且兼顾安全性的自适应固化门槛,值得进一步深究。另一方面,当前系统中的参数化执行器选用了 Procedural KV Memory 结构,虽然与冻结的 Transformer 适配极佳,但在更大规模的复杂推理中,针对 MoE 架构或轻量 LoRA 模块的动态挂载,可能还会展现出不同的容量效率与迁移特性。
从被动接受微调灌注,到主动调度内外部记忆自主进化,UniMem 所展示的“情景到参数”平滑过渡,为大模型走向终身自主学习提供了一条清晰且极具可操作性的技术路径。