Solar Open 2:混合注意力支撑1M上下文,1/6参数逼平1.6T模型
Solar Open 2 Technical Report
长程任务处理能力正在将大模型从单轮问答推向能独立解决复杂目标的自主智能体(Agent)。然而,随着任务规划步数拉长、调用工具次数增加,推理上下文动辄突破几十万甚至上百万 Token,全 Softmax 机制下二次方增长的计算复杂度与线性暴增的 KV 缓存(KV Cache),已经成为横亘在端侧与云端推理成本面前的致命瓶颈。
ArXiv URL:https://arxiv.org/abs/2607.20062
刚刚公布技术报告的 Solar Open 2,展现了一条颇具启发性的解决路线。这是一个总参数 250B、单 Token 仅激活 15B(250B-A15B)的混合专家(MoE, Mixture-of-Experts)模型。通过引入交错排列的“1 层 Softmax + 3 层线性注意力”混合注意力架构,Solar Open 2 将上下文窗口扩展至 100 万(1M)Token,同时将推理时的内存与计算开销压缩至传统全 Softmax 架构的四分之一左右。
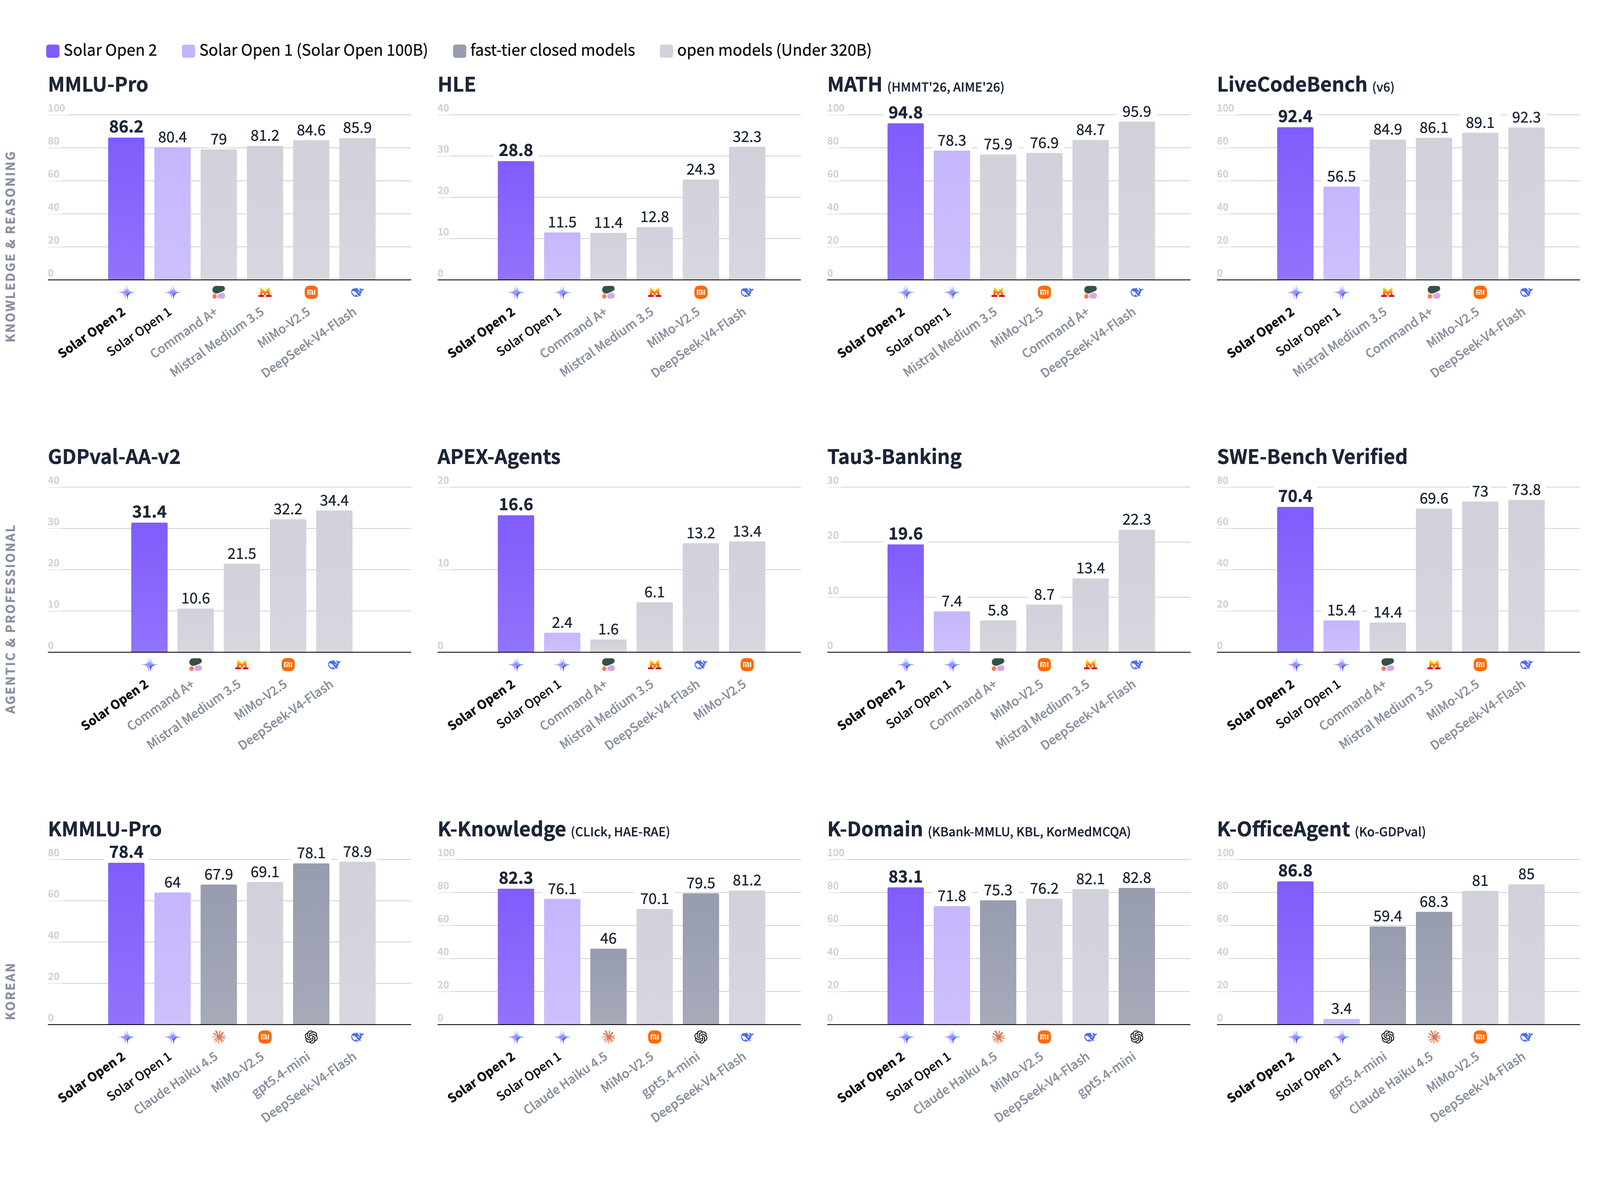
更为亮眼的是其在实际任务中的效能转化:在涵盖大量复杂文档与结构化报表处理的韩语办公 Agent 基准 Ko-GDPval 上,Solar Open 2 凭借创新的数据合成管道与架构优化,以不足六分之一的参数体量逼平了总参数高达 1.6T 的 DeepSeek-V4-Pro;在 MMLU-Pro、LiveCodeBench 以及 APEX-Agents 等英文评测集上,也对同尺寸开源模型形成了明显的领先优势。
混合注意力的深度重构:S-L-L-L 与负特征值
纯线性注意力(Linear Attention)虽然能让推理阶段的计算复杂度降至线性、KV 缓存维持恒定大小,但在需要精准全局回溯的任务中往往存在容量退化;而全 Softmax 架构在 1M 上下文下则会带来灾难性的硬件资源开销。Solar Open 2 采取的折中策略并非简单拼凑,而是对两者的混合比例与底层数学机制进行了彻底改造。
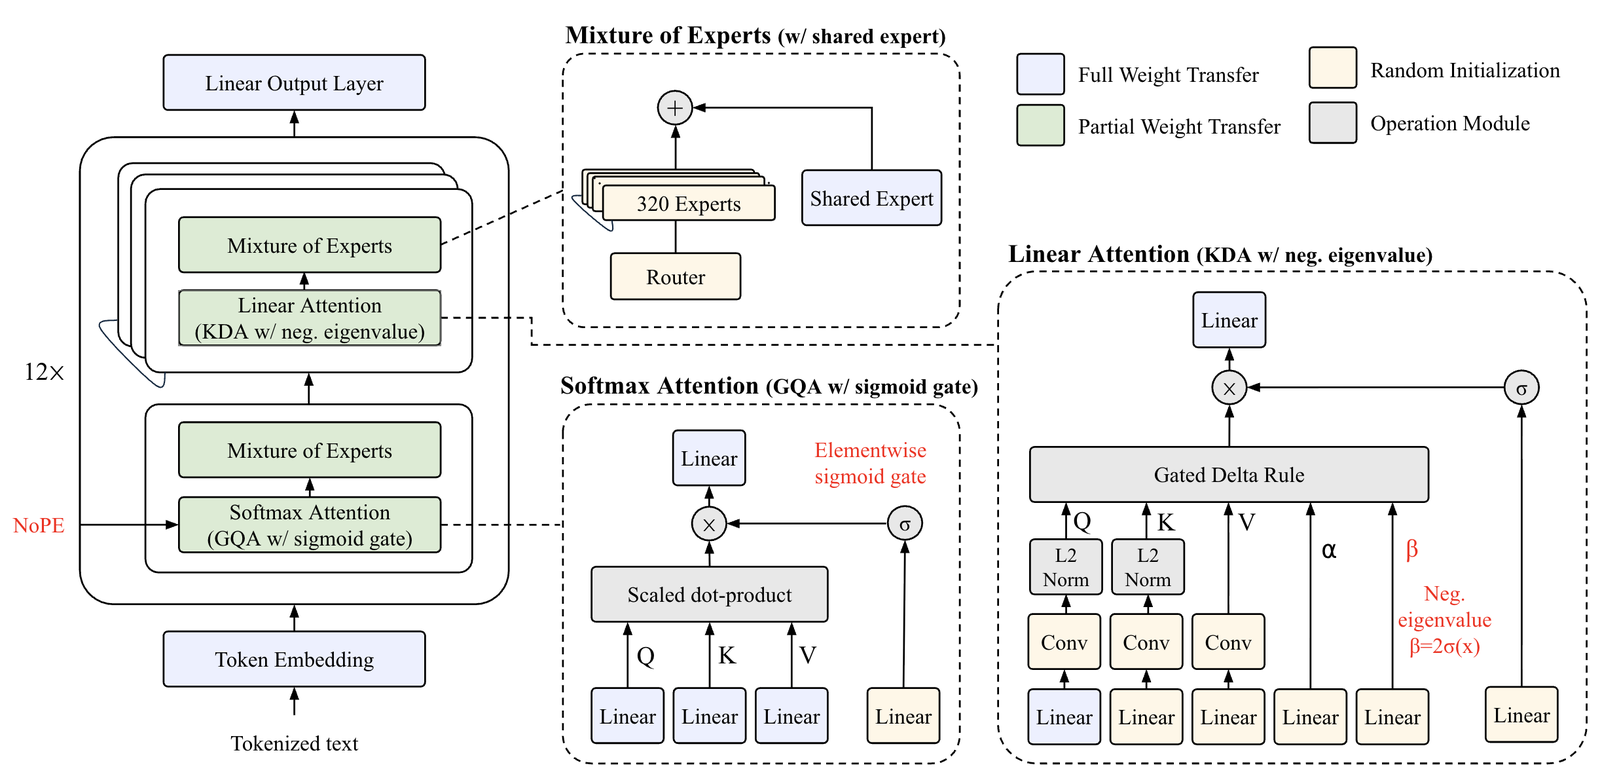
该模型拥有 48 层结构,移除了所有稠密层,每层仅挂载 MoE 模块。在注意力栈的设计上,Solar Open 2 每 4 层为一个周期,按照 1 层 Softmax 紧跟 3 层线性注意力(S-L-L-L)的方式循环排布。整个模型共包含 12 层 Softmax 与 36 层线性注意力层。与目前业界常见的线性优先排布(如 Kimi Linear 或 Qwen3.5 采用的 L-L-L-S)不同,Solar Open 2 显式将 Softmax 置于每个单元的最前端,让精确的局部/全局注意力先行提取全局表征,再交由后续的线性层压缩沉淀到循环状态中。
在这套架构深处,研发团队引入了三项关键修改:
首先是彻底舍弃显式位置编码(NoPE)。传统的 RoPE 等位置编码方式天然受到训练序列长度分布的束缚,长文本外推经常遭遇注意力弥散。Solar Open 2 在 Softmax 层中不引入任何位置信号,序列的相对顺序完全由线性注意力的循环隐状态按时序流动天然继承。这种设计解除了基于位置编码的外推天花板,使模型理论上具备无限长上下文的承载潜力。
其次是引入 Sigmoid 输出门控。模型在 Softmax 注意力的点积输出后增加了一个逐元素的 Sigmoid 门控向量。该门控由 Query 动态计算生成,不仅为低秩的 Softmax 映射补充了关键的非线性能力,还带来了 Query 依赖的输出稀疏性,直接压制了注意力权重无意义集中在最初几个无用 Token 上的“注意力汇聚”(Attention Sink)病态现象,显著提升了 1M 上下文长序列训练时的数值稳定性。
最后是一项极具数学深度的调整——允许负特征值(Negative Eigenvalues)。标准的增量线性注意力(如 Kimi Delta Attention, KDA)为了维持系统稳定性,通常将状态转移矩阵的特征值限制在 $[0, 1]$ 区间内。这意味着隐状态只能随时间衰减或维持,永远无法翻转符号或主动执行“擦除”操作。这种限制在理论上导致模型无法解决奇偶校验或模计数等状态追踪问题;一旦错误信息被写入固定大小的状态中,就会在后续序列中持续累积且无法纠正。Solar Open 2 将写入强度扩展至 $\beta = 2\sigma(\cdot) \in (0, 2)$,同时作用于 Delta 规则的擦除项 $\beta k k^{\top} S$ 与写入项 $\beta k v^{\top}$,从而将特征值范围拓展至 $[-1, 1]$。允许负特征值使得循环状态具备了自我纠错、反转与主动遗忘的能力,这在完全没有显式位置编码、长达百万 Token 的循环传递中,起到了防止误差累积漂移的关键作用。
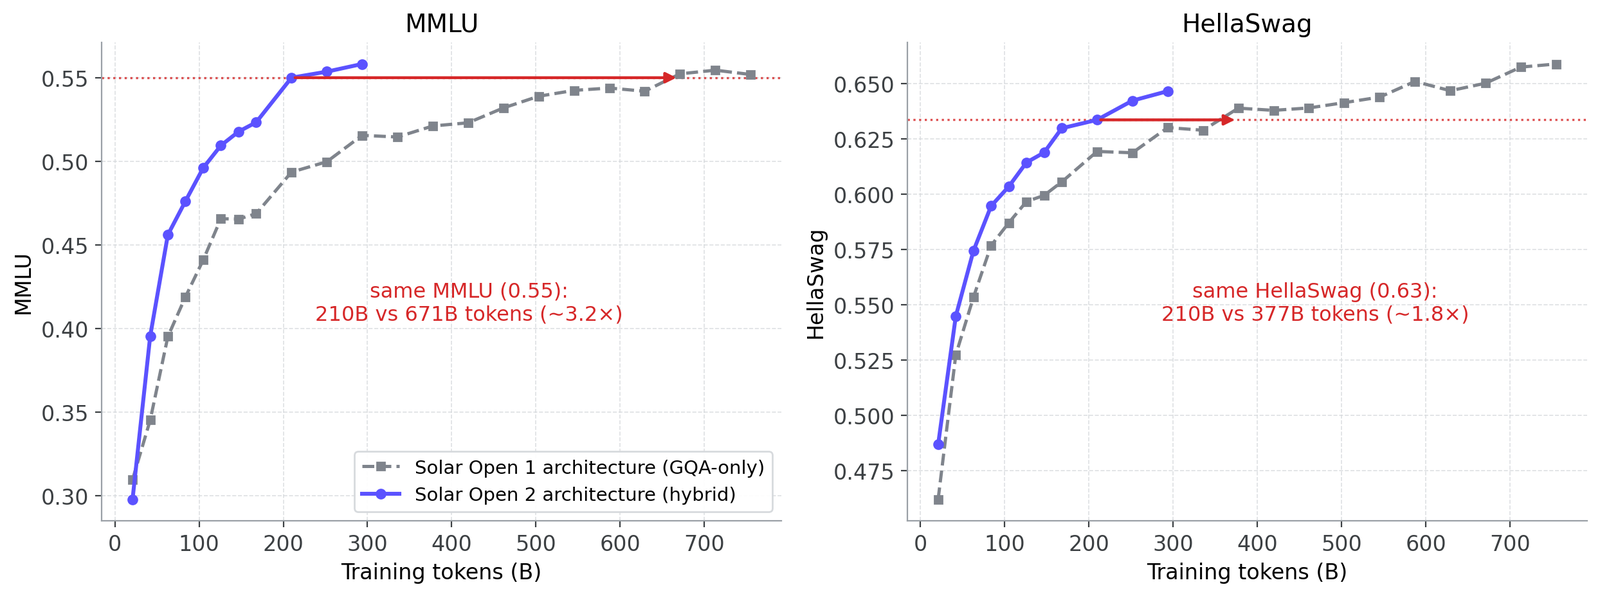
小规模代理模型的消融实验揭示了这些设计的收益:仅将全 Softmax 替换为线性注意力与 NoPE 的组合,就能节省约 17.4% 的训练 Token;Sigmoid 门控、S-L-L-L 排布与负特征值又分别带来了 3%、1.5% 和 1% 的收敛效率提升。这些微弱的 Loss 差值在下游任务中产生了明显的非线性杠杆效应:要达到相同的 MMLU 精度,新架构仅消耗了基线架构不到三分之一的训练预算。
骨架嫁接与数据精炼:有限算力下的冷启动破局
在预训练阶段,从零启动一个 250B 规模的非标准架构模型成本极其高昂。Solar Open 2 提出了一种名为“选择性权重迁移”(Selective Weight Transfer)的热启动策略,打破了传统认知中“架构大幅改变必须从头预训练”的铁律。
模型上一代版本 Solar Open 1 采用纯 Softmax 骨架,路由专家数为 128 个。而 Solar Open 2 不仅注意力机制混合化,专家池更是大幅扩充至 320 个。研发团队没有尝试将注意力机制做蒸馏对齐,也没有做粗暴的网络升采样,而是仅仅抽取出 Solar Open 1 中未受架构变化破坏的核心参数——共享骨架与嵌入层中兼容的 5.69B 参数(仅占总参数量的约 2.3%),将其直接移植为 Solar Open 2 的初始骨架,其余所有线性注意力与新增专家的权重全部随机初始化。
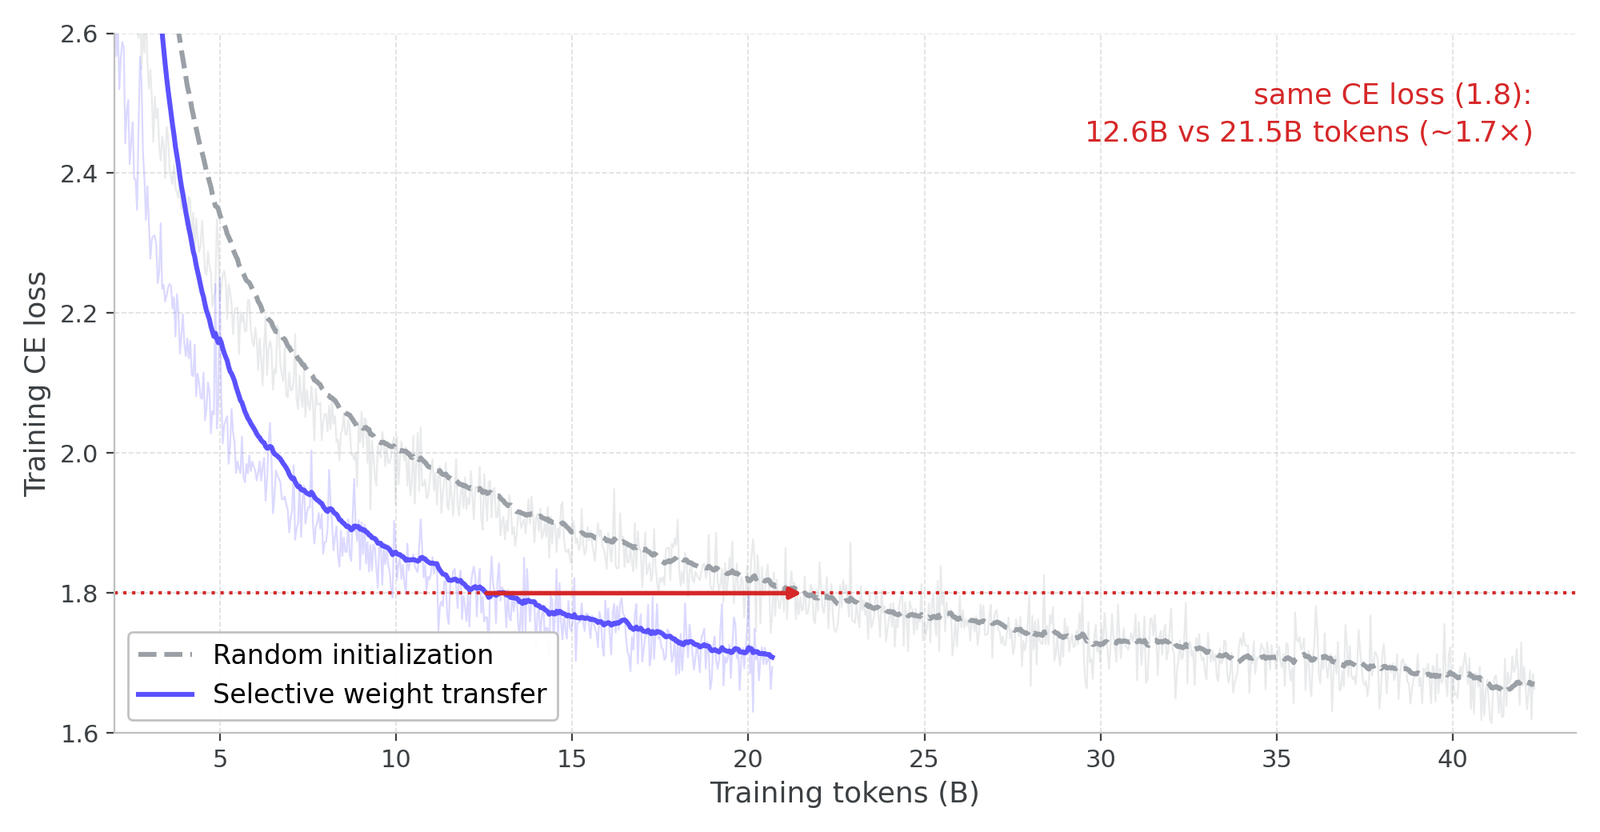
在 200B-A15B 的对比测试中,这区区 2.3% 的“旧骨架”爆发了惊人的引导作用:要达到 1.8 的训练交叉熵损失,从零初始化的模型需要消耗 21.5B Token,而使用了选择性权重迁移的模型仅需 12.6B Token,训练效率直接提升了 1.7 倍。底层知识与表征结构的幸存,为庞大且异构的新架构提供了一个极高价值的初始优化轨迹。
有了高效骨架之后,团队将重心转向单 Token 的学习效率。他们没有盲目扩张低质语料,而是从 20T 的原始语料池中,通过全局去重、稀缺度打分与质量分级,提炼出 10T 的核心混合数据。最终确立的顶层配方极具针对性:真实数据与合成数据比例固定为 4:6;数学与代码占比各自强制不低于 15%;英语语料占比维持在 80% 以上。
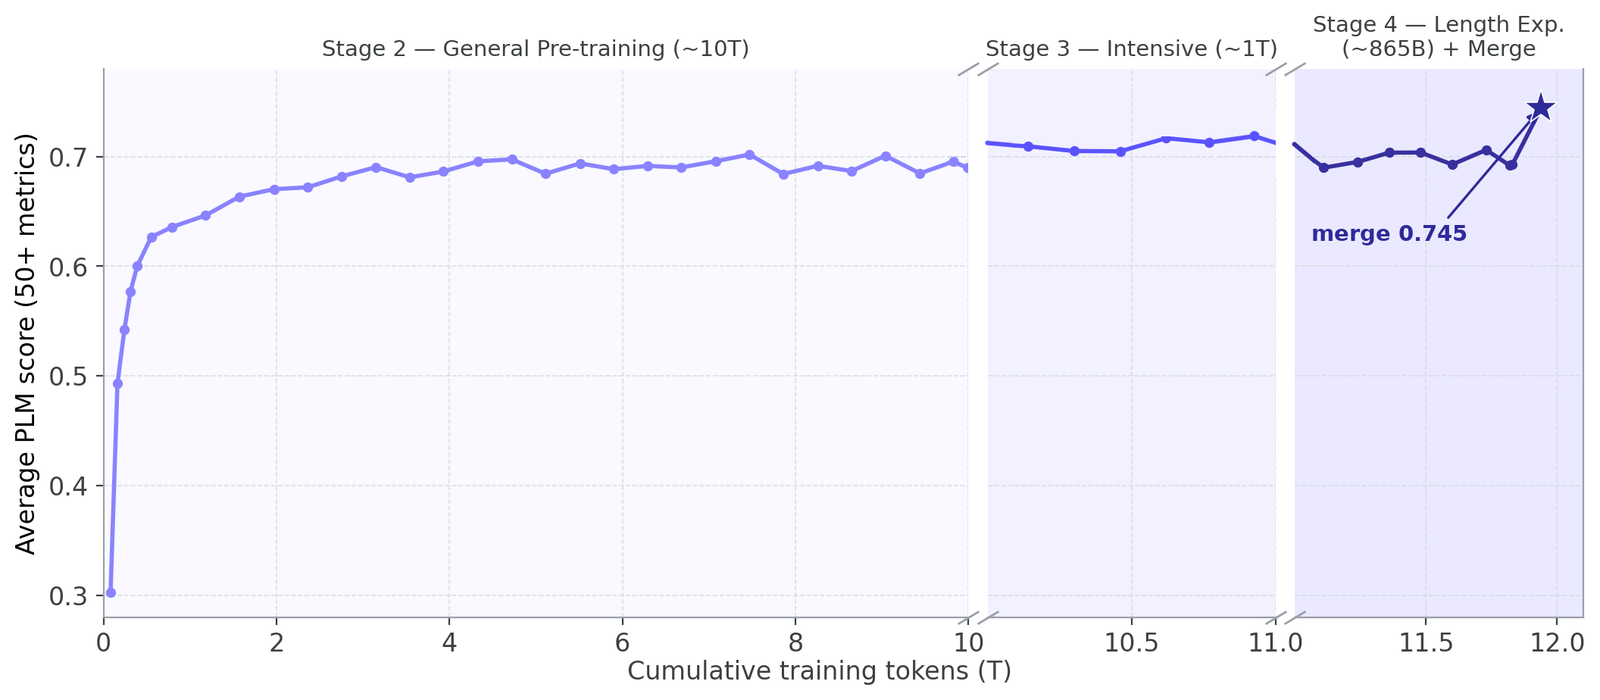
整体预训练被组织为严密的四个阶段:第一阶段完成 2.3% 核心权重的嫁接;第二阶段在 10T 高价值语料上开展通用预训练;第三阶段收紧质量阈值,在最优质的 1T 核心子集上展开高强度精炼(Intensive Pre-training);第四阶段进入 0.9T 的长度扩展期,注入长文档、仓库级代码以及复杂长程推理数据,将上下文拉升至 1M,最终通过对多检查点的权重融合(Checkpoint Merge),获得泛化能力与长文本能力均处于峰值的基座模型。
场景化代理锻造:以验证器为先与全异步强化学习
很多大模型在实验室的单轮跑分中表现优异,但一旦接入真实环境执行十几步操作,就会频繁出现幻觉、死循环或破坏环境。Solar Open 2 的后训练体系彻底放弃了依靠人工通用对话微调或简单抓取网络轨迹的传统做法,全面转向“目的驱动的场景构建”(Purpose-built Scenarios)。
团队将 Agent 能力划分为三大典型场景并建立了严密的验证闭环:
在通用会话智能体方面,核心解决的是工具环境与增删改(CUD, Create/Update/Delete)指令生成的难题。针对具有副作用的破坏性操作,传统方法极难自动评判好坏。Solar Open 2 提出了“验证器先行”(Verifier First)的逆向流程:流水线先在隔离沙盒内对真实数据库或服务执行某种状态变更,记录系统的真实反馈,并自动合成一个基于 pytest 的逆向读取检查脚本;确认无误后,再将原始指令进行多级模糊重写,生成任务描述。这样,智能体在执行任务时不仅无法通过字面规律走捷径,必须自主探索真实环境,而且每一个任务都自带可执行的终态测试用例与严格的进程评分标准。
在代码智能体方面,重点攻克前端与系统级开发。团队建立了一套覆盖网站、游戏、3D、数据可视化等六大门类的前端合成管线。轨迹在生成后需经历严酷的双重过滤机制:首先是通过无头浏览器(Playwright)进行无差错渲染的执行性筛选,随后调用多模态大模型(VLM-as-a-judge)对比全页面截图,核验功能完备度与视觉规范,确保生成的代码具有像素级可用性。
在办公场景智能体方面,研发团队打造了 OfficeVerse 框架。针对真实商业数据不可获取的困境,该框架构建了由 11 个行业领域与 12 种典型工作交付物(覆盖 xlsx、docx、pptx、pdf 等本地办公格式)构成的矩阵体系,结合真实公开的商业金融统计数据,合成了海量高保真任务。尤为关键的是,该体系深度契合本土业务习惯,涵盖专业术语、特有数值计量体系及严格的 CJK 字符排版渲染校验,从底层解决了大模型在处理专业办公报表时格式错乱或缺字的工业级痛点。
支撑这些庞大场景训练的,是一套高度工程化的全异步强化学习(Fully Asynchronous RL)基础设施。由于 Agent 的长程交互链路在耗时上具有严重的“长尾分布”,传统同步 RL 中整个 GPU 集群必须等待最慢的一条轨迹完成才能更新梯度,造成严重的算力闲置。
Solar Open 2 将 Actor(轨迹生成引擎)与 Trainer(梯度更新引擎)在物理显卡上彻底解耦。Trainer 计算出新权重后,无需挂起整个集群,仅以“飞行中更新”(In-flight Updates)机制广播参数,并实时对未完成的轨迹做 KV 缓存重算。为了应对异步带来的策略漂移(Off-policy Drift),系统引入了基于 Token 级新鲜度控制的准入网关:为轨迹中的每个 Token 标记生成时的策略版本差,只有整条轨迹中新鲜 Token 的比例跨过阈值 $\rho$,才允许进入训练阶段;即使进入训练,已经过期的前缀 Token 也会在计算 Loss 时被动态屏蔽。最后,通过在 12 个领域专家上分别执行 SFT 与特定领域 RL,再利用多教师在策略蒸馏(MOPD)将所有专家的能力无损熔炼回单一基座中,使得 Solar Open 2 兼具了深度专业性与通用泛化力。
效能与主权:大模型演进的技术路线再审视
Solar Open 2 的技术报告展现了一种非常清晰且务实的研发思路。面对全球前沿模型在算力与参数规模上的持续加码,非头部巨头或主权 AI 的探索不必拘泥于“从零硬刚万亿稠密模型”的单一路径。
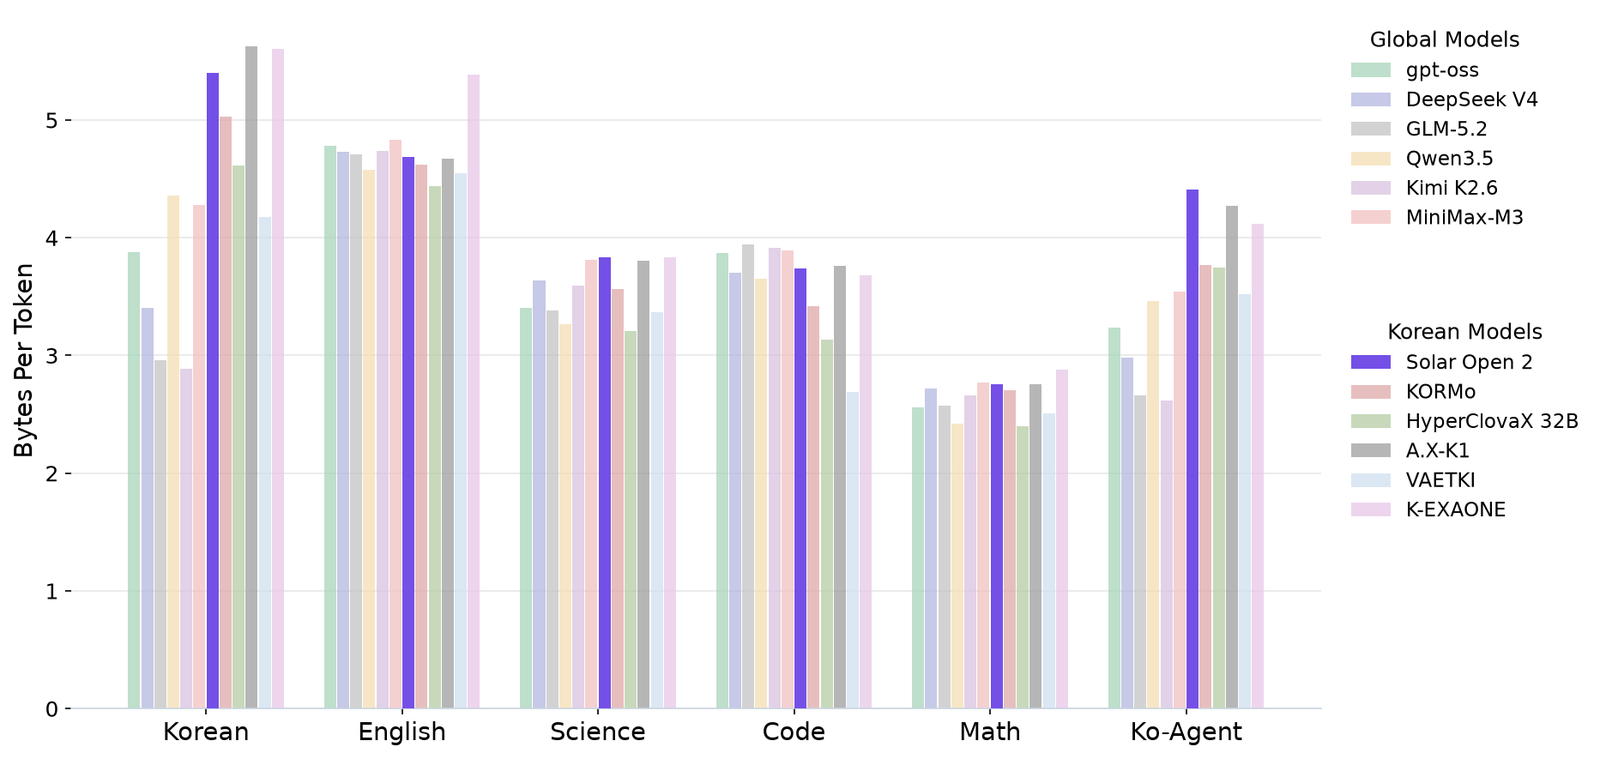
从分词效率来看,继承自前代的分词器在长文本任务中展现出隐蔽却巨大的经济价值:在韩语办公 Agent 场景下,该分词器达到了 4.41 字节/Token 的压缩效率,比主流全球模型分词器节约了近 24% 的 Token 开销。结合线性注意力带来的 Constant KV 缓存,意味着在同等显存限制下,系统不仅可以承载近两倍的实际物理文本长度,还能大幅压低端到端交互的延迟与 API 服务成本。
更具启发意义的,是其对于“混合注意力机制”与“架构间权重转移”的大规模实证。它向行业证明了:线性注意力不必作为纯实验性架构偏安一隅,完全可以通过 S-L-L-L 与负特征值等数学修正,成为 1M 超长上下文场景下的核心支柱;而大模型代际升级时的沉没成本,也能通过微量核心参数的定向转移得到最大限度的盘活。对于正在探索长程自主代理、本地化落地以及超长文本处理的团队而言,Solar Open 2 提供的不仅仅是一个开源模型,更是一套经受住工业级验证的实用工程范式。