Search-G1:用内在表征探针破解搜索智能体的假检索难题
Search-G1: Grounded Search Agents via Representation-Based Intrinsic Rewards
让大语言模型自主调用搜索引擎来回答复杂事实问题,已经成为当前智能体(Agent)研究的核心方向之一。随着类 Search-R1 强化学习管线的普及,研究者们发现,仅凭最终答案的对错作为奖励信号,模型就能自发涌现出拆解问题、调用搜索接口并阅读网页的多轮检索行为。但这种基于结果奖励(Outcome Reward)的强化学习存在一个常被忽视的漏洞:模型展现出的搜索行为,并不等于它真正依赖了搜索到的证据。
ArXiv URL:https://arxiv.org/abs/2608.07531
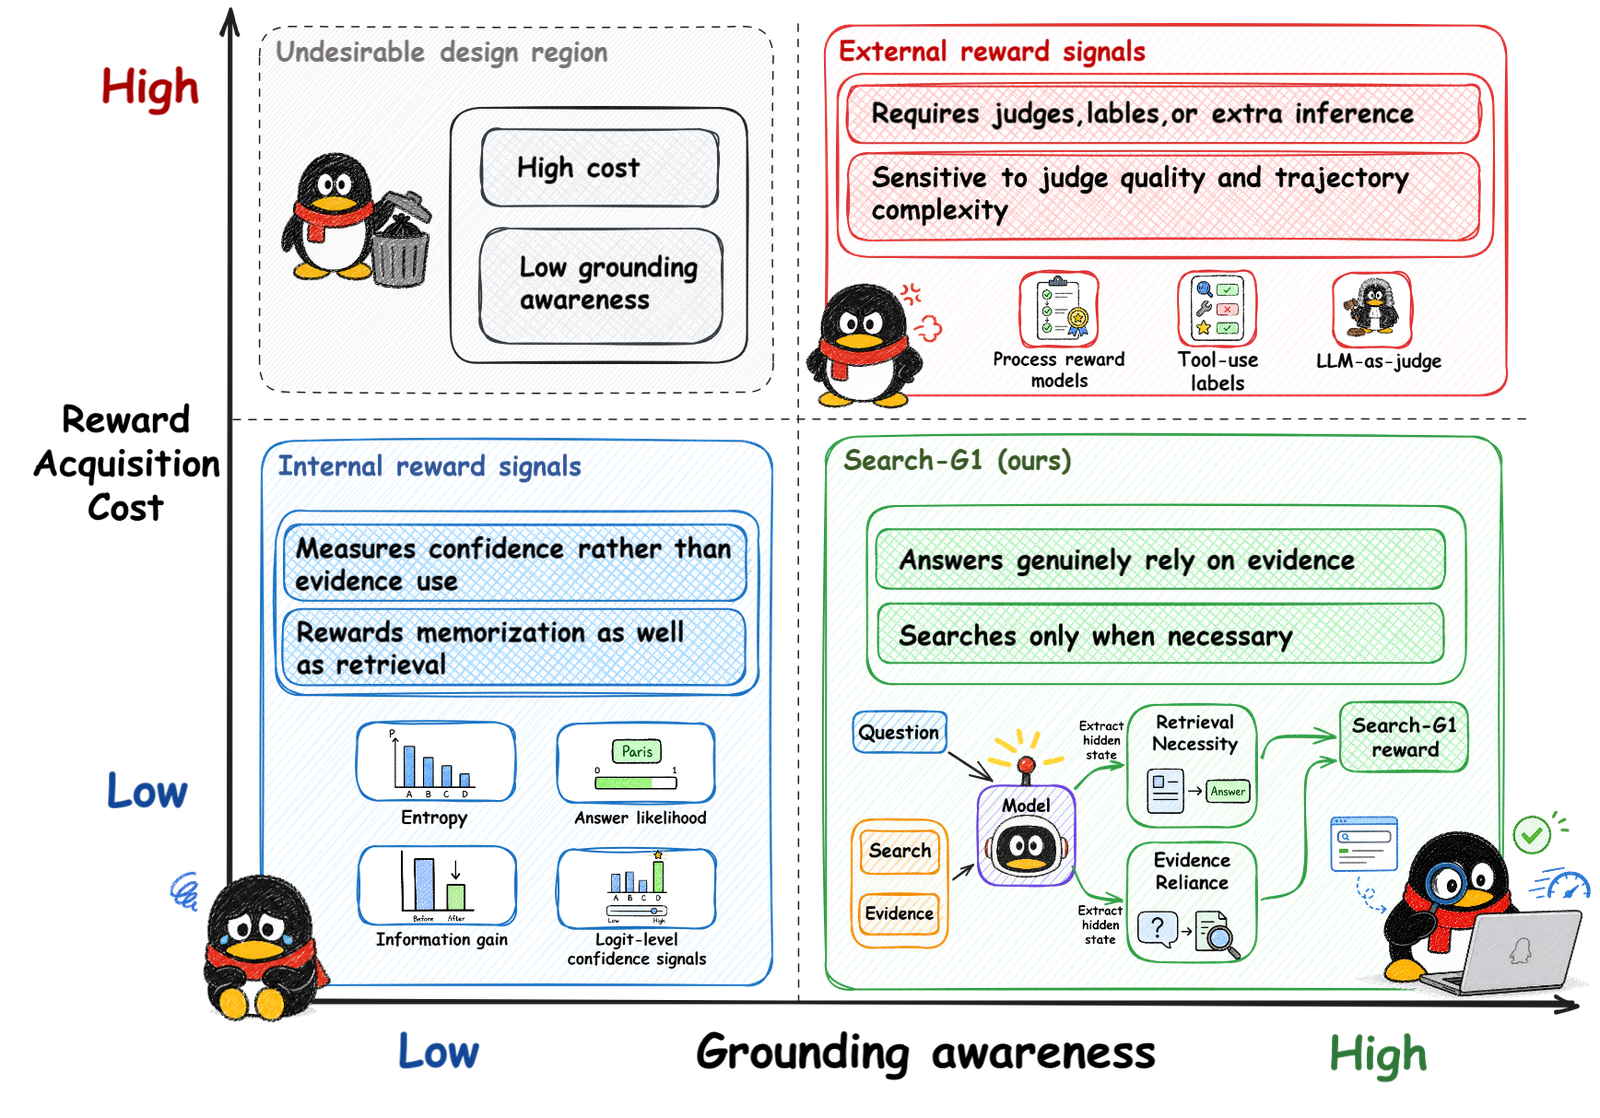
在实际训练中,智能体经常会出现“走过场式搜索”:面对一个它原本通过自身参数记忆就能回答的问题,策略模型依然机械地触发搜索调用,随后直接输出答案;或者在多轮检索中抓取了大量不相关文档,最终给出的正确答案却完全来自原本的记忆幻觉或先验偏置。现有评估体系很难区分一次正确的回答究竟是“依凭检索证据推导而来”,还是“检索之后凭记忆硬猜恰好命中”。纯结果奖励对这两种行为一视同仁,而引入昂贵的过程奖励模型(PRM)或调用顶尖大模型担任外部裁判(LLM-as-judge),又会成倍抬高训练阶段的算力与时间成本。至于基于模型自身输出熵值或对数似然的内在奖励,往往反映的只是模型对答案的“主观自信”,同样无法诊断它是否在实质上锚定了检索上下文。
针对这一瓶颈,腾讯与复旦大学的研究人员在论文《Search-G1: Grounded Search Agents via Representation-Based Intrinsic Rewards》中提出了 Search-G1。这项研究的核心思路在于:不再依赖昂贵的外部评估者,而是直接从智能体自身隐藏状态的几何表征中,提取出两组经过反事实干预校准的轻量级“读出探针”(Readouts)——一个负责在提问初始阶段预判智能体在不检索条件下的“闭卷充分性”(进而得出检索必要性),另一个负责在给出答案瞬间评估智能体对检索证据被剔除的“敏感度”(即实际证据依赖度)。以此为基础构建的内在奖励,既不增加在线调用的推理负担,又能精准奖励那些“在必要时才检索、且答案切实依赖证据”的高质量轨迹。
为什么常规奖励机制测不出真实的证据依赖?
要理清 Search-G1 的创新价值,必须先透视当前搜索智能体在强化学习设计上面临的深层矛盾。目前主流的强化学习范式大致可以归为两类奖励流派:外在奖励(External Rewards)与内在奖励(Internal Rewards)。
外在奖励最常见的是基于规则的精准匹配(Exact Match, EM)或 F1 分数。这类奖励计算成本极低,天然契合大规模强化学习训练。然而,结果奖励是“盲目”的,它完全忽略了推导过程与检索结果之间的因果纽带。举例来说,当模型被问及一个相对常见的事实,模型可能自主检索了三个网页,然后输出正确答案。但如果把这三个网页的内容全部替换成无关的占位符,模型依旧能给出同样正确的答案,这说明该次检索纯属冗余动作。如果强化学习算法持续给予这种轨迹同等的高额奖励,模型就会习得过度搜索、滥发查询的低效策略。
为了约束推导过程,学界尝试过两类补充方案。一类是过程监督模型,对思维链或工具调用的每一步打分;另一类是利用功能更强的大模型(如 GPT-4)对智能体的检索轨迹做忠实度裁判(Grounding Judge)。但这两种方案在多轮交互、长上下文的强化学习环境中代价高昂。每一次策略迭代都要触发外部裁判或庞大的奖励模型,在多步探索和大规模群体采样下,推理开销会呈指数级放大,甚至直接使训练失去可行性。
另一条技术分支是利用策略模型自身的内在信号设计奖励,例如动作熵(Entropy)、生成序列的对数似然或互信息增益。这类内在奖励无需额外标注和额外模型,计算极为轻量。但这些指标在本质上衡量的是模型的不确定性(Uncertainty)与置信度(Confidence),而非证据依赖性。当模型遇到一个自身参数已熟记的问题时,它的输出熵本身就很低、似然度极高;即便利诱它去检索,它的低熵状态依然由内部参数支撑,内在指标无法判断模型到底是因为读了证据才确定,还是本来就了然于胸。这就导致以往的内在奖励难以胜任对“依据外部证据答题”的精细化度量。
Search-G1 的核心架构:双探针与反事实校准
Search-G1 并没有强行构建庞大的外部验证器,而是利用表示学习探测(Probing)的思想,通过在模型不同生命周期的隐层激活值上训练轻量级线性或浅层分类头,直接“读取”智能体自身的认知状态。整个框架由两组经过干预校准的表征读出探针构成。
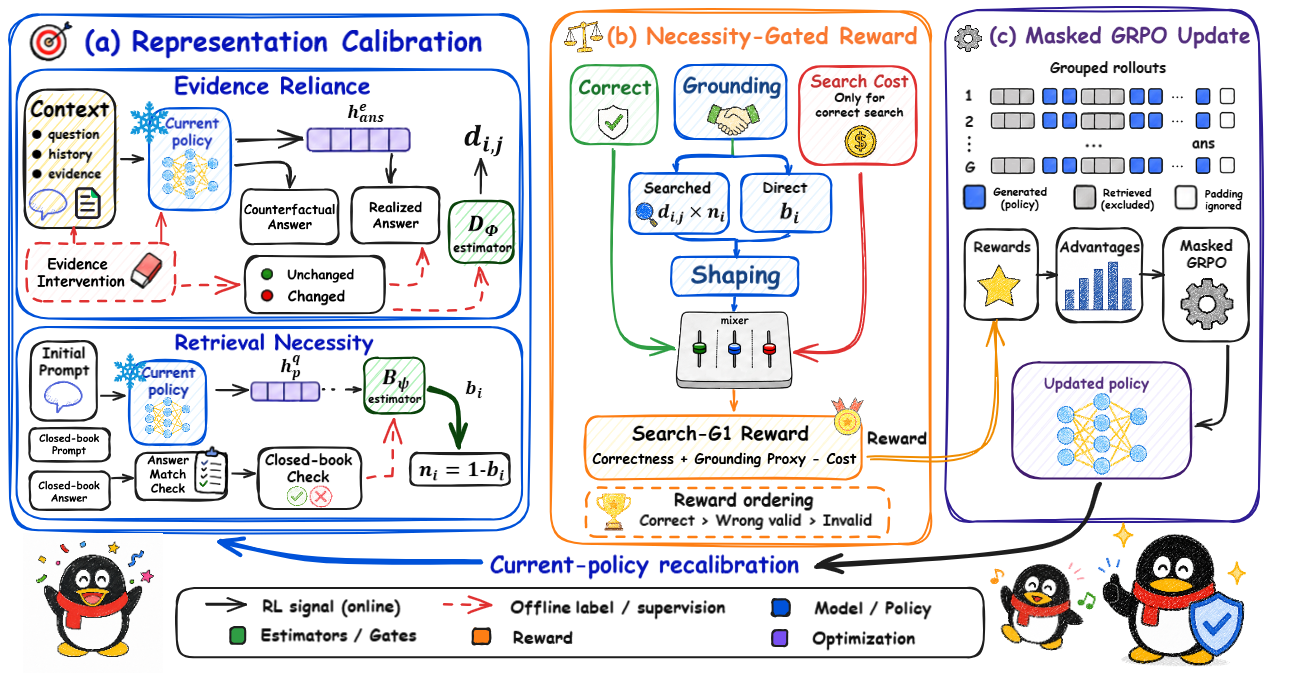
第一组是位于提示词阶段的检索必要性探针。当问题 $q_i$ 与初始系统提示输入给当前策略模型时,探针截取初始提示词末尾位置的隐藏状态向量 $h_{p,i}$。为了校准这个向量究竟蕴含了多少模型对该问题的预存知识,研究者设计了一组离线闭卷干预测试:切断外部检索接口,强制模型仅凭内部参数直接回答该问题。探针 $B_{\psi}(h_{p,i})$ 的目标是预测闭卷回答是否能够命中真实答案,输出一个标量概率值 $b_i \in [0, 1]$,代表该问题的“闭卷充分性”(Closed-book Sufficiency)。相应地,检索必要性(Retrieval Necessity)被自然定义为其补集:
\[n_i = 1 - b_i\]这一设计极为巧妙,因为它界定的“必要性”不是客观任务难度,而是完全相对于当前策略模型自身知识库的动态必要性。如果模型在早期阶段不知道答案,$n_i$ 就会接近 1;而随着模型参数演化或遇到熟知常识,$n_i$ 则会显著降低。
第二组是位于答案承诺阶段的证据依赖度探针。在模型完成多轮检索并生成最终答案标记时,探针提取最后一个答案 Token 处的隐藏状态向量 $h_{\mathrm{ans},i,j}$。为了衡量该答案是否真的来源于检索文档,系统在校准阶段执行一次因果干预 $T(C_{i,j})$:将推理上下文中实际检索回来的观测文档全部抹除,仅保留原始问题、搜索历史指令及模型自身的思维链,随后让模型以确定性贪婪解码重新生成答案。如果抹除证据后模型的答案发生了变化,则说明最终输出高度依赖检索上下文;反之,若答案未变,说明该答案极大概率是模型调用先验记忆“盲猜”出来的。依赖度探针 $D_{\phi}(h_{\mathrm{ans},i,j})$ 学习拟合这个反事实答案改变的二值标签,输出连续的依赖度估计得分 $d_{i,j} \in [0, 1]$。
通过这种反事实干预训练,两个轻量级探针在校准阶段将原本复杂的反事实生成测试,内化为了对隐藏状态空间几何特征的快速前向推断。在后续的强化学习优化环节中,系统只需要对当前轨迹提取对应位置的隐层向量并运行一次极浅的前向计算,即可实时获取该轨迹的检索必要性与实际依赖度,彻底摆脱了在线外部模型调用的计算枷锁。
保证“正确性优先”的门控奖励与组内解耦
获得必要性得分 $n_i$ 和证据依赖度得分 $d_{i,j}$ 后,如何将它们融合进强化学习的目标函数,是影响智能体行为稳定性的关键。如果过分强调证据依赖,模型可能会演变成即便自己会做也要强行为了“刷依赖度得分”而疯狂检索的极端策略;如果惩罚检索过于严厉,模型又可能在遇到困难问题时退化为完全不检索的闭卷摆烂状态。
Search-G1 提出了一套正确性优先的门控奖励结构。该结构明确遵循以下层级:任何正确完成任务的有效轨迹,其奖励必须严格高于回答错误的有效轨迹,而回答错误的轨迹又必须高于输出格式崩溃的无效轨迹。具体来说,当轨迹有效且答案完全正确时,系统分流为两种路径:
如果智能体未调用检索(即检索次数 $N_{i,j} = 0$)直接给出了正确答案,奖励函数给予基于闭卷充分性的正面激励:
\[r_{i,j} = 1 + \alpha_{\mathrm{cb}} b_i\]这意味着,如果探针判断该问题确实属于模型的闭卷知识范畴,模型凭借自身记忆直接作答会得到充分嘉奖。
而如果智能体执行了检索操作($N_{i,j} > 0$),奖励函数则采用“必要性门控”的依赖度奖励,并扣除重复搜索成本:
\[r_{i,j} = 1 + \lambda_g (d_{i,j} \cdot n_i) - \eta \cdot \mathbf{1}[N_{i,j} > 1]\]其中 $g_{i,j} = d_{i,j} \cdot n_i$ 为门控依赖得分。只有当该问题对当前模型而言检索确实有必要($n_i$ 较高),且模型最终答案切实依赖了检索证据($d_{i,j}$ 较高)时,检索行为才能获得可观的额外奖励。更关键的是,如果多次重复检索未能换来显著的证据增量,惩罚项 $-\eta$ 会迅速抵消收益。
这一奖励设计在配合组相对策略优化(GRPO)时展现出了强大的数学优势。在标准的 GRPO 算法中,若一个采样组内生成的所有候选轨迹恰好全部正确,因缺乏结果差异,标准化优势值(Advantage)会退化为零,导致该组样本无法为模型提供任何有效的梯度更新方向。而在 Search-G1 的框架下,即便所有轨迹最终答案均正确,那些“必要且有效利用证据的检索轨迹”或“针对简单问题直接利落作答的轨迹”,依然能够在组内脱颖而出,重新激活有效的优势方差,极大地提升了样本利用效率。
更为本质的是,强化学习不断更新模型权重的过程,必然导致隐藏状态特征空间的几何分布发生漂移(Representation Drift)。一个在训练初始阶段拟合优良的线性探针,在经历几百步策略迭代后,其对当前隐层表征的预测准确率会显著下滑。为了解决这种测量失真,Search-G1 引入了周期性重新拟合机制(Periodic Refitting)。算法每隔固定的优化周期,就冻结当前策略检查点,抽取少量样本重新生成干预标签,快速微调更新两组探针的参数。这种测量工具与被测策略协同演化(Co-evolution)的设计,确保了整个强化学习过程中的评价标尺始终紧贴当前策略的真实认知边界。
实验评测:在压缩检索代价的同时锚定真实证据
为了全面检验 Search-G1 的有效性,研究团队在开源领域广泛使用的 Qwen2.5-3B-Instruct 和 Qwen2.5-7B-Instruct 两种不同体量的基座模型上展开了系统性验证。评估涵盖了单跳事实检索基准 Natural Questions(NQ),以及包含大量复杂多步跳跃推导的多跳问答数据集 HotpotQA、2WikiMultiHopQA 和 MuSiQue。
评测指标不仅覆盖传统的任务最终准确率(Exact Match, EM),还专门设立了衡量证据锚定度与搜索成本的关键指标:
-
反事实信任一致性(Trust Consistency, TC):综合衡量当提供受干扰或反事实文档时,智能体能否正确跟随真实依据;
-
文档不变率(Document Invariance, D-Inv):统计原本回答正确的检索轨迹中,在将检索文档替换为无关干扰项后,答案依然保持不变的比例。D-Inv 指标越低,说明模型对检索文档的虚假依赖越少,真正的因果依赖程度越高;
-
每题搜索标记数(Search/Q):统计模型完成单次问答平均触发的搜索调用次数,直观反映智能体的计算与外部交互开销。
在与常规 Prompt 驱动搜索、标准结果奖励 GRPO 以及带长度惩罚的强化学习基线对比中,Search-G1 展现出了突出的综合表现。在 Qwen2.5-3B 模型上,基线 GRPO 虽然相比提示词搜索提升了任务精度,但往往伴随着搜索次数的大幅膨胀,在很多并不需要检索的问题上盲目发起调用。引入 Search-G1 后,智能体在 NQ 数据集上的平均搜索标记数(Search/Q)从基线显著收敛至更紧凑的区间,相比无约束搜索减少了大量无效调用。
更为亮眼的是证据锚定指标的质变。基线强化学习训练出的模型,其 D-Inv 指标往往居高不下,意味着有相当一部分“正确回答”即使抽空了检索内容也照样能生成,属于典型的伪检索。而 Search-G1 训练下的模型,D-Inv 显著走低,同时反事实信任一致性(TC)在多跳问答场景下取得一致提升。这直接证明了模型不是在盲目应试,而是真正学会了在“不知道”时去搜,并在“搜到了”之后仔细阅读文档提取依据。
在绝对任务精度方面,由于模型摆脱了在无关搜索中抓取噪声文档所带来的上下文干扰,Search-G1 在 HotpotQA 和 2WikiMultiHopQA 等多跳基准上的 EM 表现不仅没有因为检索次数的减少而受损,反而在多个测试集上取得了持平甚至超越基线的结果。消融实验进一步证实,如果移除检索必要性门控(将门控系数强制设为常数 1),智能体在单跳常识题上的冗余检索会大幅抬头;而如果移除周期性探针重拟合机制,随着策略演进,探针对隐状态的预测误差会成倍上升,最终破坏后期训练的稳定性。
总结与展望
Search-G1 的技术探索为检索增强智能体的训练范式提供了一个极具启发性的视角。过去,优化智能体行为的思路往往陷入两极:要么将整个系统视为黑盒,只通过最终答案的奖励信号让模型去粗暴探索;要么不惜代价在外围堆砌庞大的监督链条与裁判模型,试图通过人工或大模型打分去规训每一步动作。
Search-G1 证明了第三条路线的可行性:大模型自身的隐层几何表征,本身就已经编码了其对自身知识边界的感知以及对外部信息的因果依赖。通过轻量级的反事实干预设计,我们可以将这些深埋在激活空间中的认知状态,低成本地解码成高度精准、即时响应的内在奖励。随着大模型智能体越来越深入复杂工具调用、多模态探索与长程规划场景,这种“以表征测认知、以测量促演进”的自适应内生奖励机制,或许正是破解智能体冗余计算与虚假推理的关键拼图。