Iris:跳出以方案为中心的盲目搜索,让自主机器学习夺牌率达到64.9%
Beyond Solution-Centric Search: Adaptive Inquiry and Knowledge Revision for Autonomous ML Engineering
让大语言模型(LLM)扮演算法工程师,去自主打一场 Kaggle 比赛或进行复杂的模型微调,已经成为衡量 Agent 长程任务能力的核心试金石。然而在现有的自动化机器学习(AutoML)或机器学习工程(MLE)智能体系统中,普遍存在一个隐蔽的思维盲区:绝大多数系统都在“以方案为中心”的范式下打转。无论是基于树搜索、图搜索、链式迭代还是定向组件优化,Agent 的所有行为几乎都被绑定在“生成代码、运行试验、对比指标、挑选更优分支”的死循环里。一旦指标没有提升,系统往往只能盲目生成下一个候选方案,或者在过时的局部假设里反复撞墙。
ArXiv URL:https://arxiv.org/abs/2608.02143
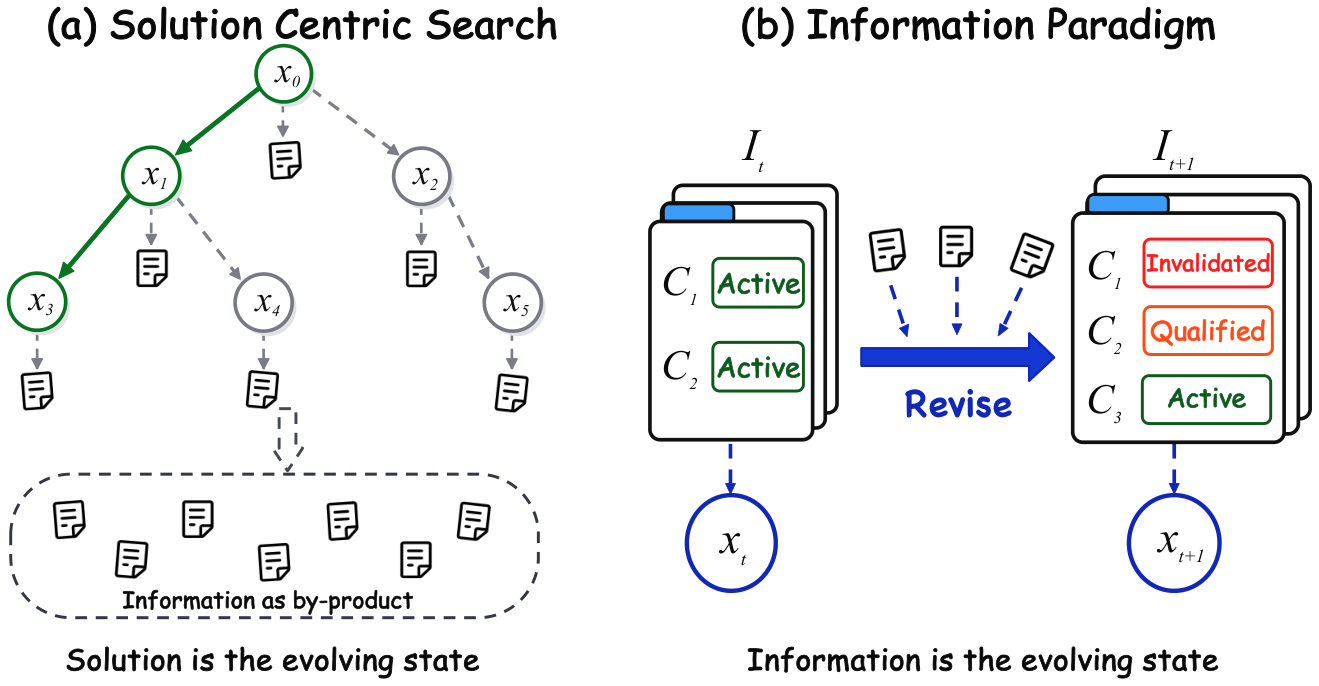
这种“方案中心式搜索”把系统的核心状态定义为候选方案代码本身,而实验过程中产生的宝贵信息、失败归因以及跨轮次的假设推翻,仅仅被当成辅助日志顺带保存。面对算力、时间和显存高度受限的工程现实,这种盲目试错的成本极其高昂。
近期提出的一篇工作打破了这种设计定势,正式提出了从“方案中心式搜索”走向“信息范式”(Information Paradigm)的全新思路,并推出了名为 Iris 的自动化研究系统。Iris 将智能体的核心演化状态从“代码方案”切换为不断修正的“信息状态”,通过“探究-修正”(Inquiry-Revision)双循环机制,既允许智能体执行不改动方案的认知探查动作,又能跨实验动态修正有明确证据链条的知识断言。在严苛的 MLE-Bench 基准 75 项竞赛测试中,Iris 在 12 小时严格预算下斩获了 64.9% 的奖牌率与 39.1% 的金牌率,超越了包括 24 小时预算在内的所有对比系统;同时在 Agent Harness 工程和模型后训练等跨领域长程任务中展现出了强大的通用优化能力。
方案中心之困:为什么盲目调优总在做无用功?
在真实的算法研发工作中,顶尖人类工程师与初级调参工程师的最大区别,往往不是谁写代码的速度更快,而是谁能在陷入瓶颈时精准判断“当前究竟卡在哪”。
当一个模型的 F1 分数在 0.66 停滞不前时,初级工程师可能立刻开始换骨干网络、加高分辨率、盲目调大学习率或者尝试复杂的后处理;而资深工程师会先写几行分析脚本,打印出预测框的截断阈值分布、混淆矩阵、或是排查数据加载管线中是否存在隐式的尺寸下采样。换言之,资深工程师在采取改动方案的“干预动作”之前,会优先执行纯粹为了消除关键未知信息的“认知动作”。
然而,审视现有的 LLM-based MLE Agent(例如 AIDE、AIRA、MLE-STAR 等),它们无一例外都陷入了方案中心式的结构束缚中。系统预先固化了树(Tree)、图(Graph)或线性链的搜索拓扑,每一步探索都必须绑定在一个具体的候选方案上。如果一次实验效果变差,系统唯一的应对手段就是抛弃该分支或在父节点上派生新分支。这种架构带来了两个根本缺陷:
首先是信息获取的僵化。现有 Agent 缺少独立的“诊断通道”,所有动作都被迫承担双重职责——既要尝试修改方案,又要验证改动效果。当 Agent 面对关键决策未知项时,无法在不生成新方案的前提下专门探查系统瓶颈,导致许多试错不仅浪费了宝贵的 GPU 时间,还引入了混杂变量。
其次是信息管理的浅层化。绝大多数现有系统的记忆机制,仅仅是文本层面的执行历史堆叠,或者是简单维护一个成功案例库。当智能体完成了十几次实验后,早期的结论很可能与后期的发现产生冲突。例如前期认为“数据增强无效”,实际上是因为学习率过高掩盖了增强的收益;如果系统不能将这些经验显式建模为“可修正、带适用范围、带正反证据链”的结构化主张,它就无法在后续阶段纠正过去的错误认知,最终在错误的归因下南辕北辙。
信息范式与 Iris 的双循环架构
为了打破这一僵局,Iris 将长程研究过程重新形式化为以信息状态驱动的探索问题。给定长程任务 $q = (\mathcal{D}{q}, J{q}, B)$,其中 $\mathcal{D}{q}$ 包含任务描述和数据,$J{q}$ 为评估指标,$B$ 为总预算,智能体在任意决策步骤 $t$ 的状态并不只是当前的候选方案 $x_{t}$,而是一个三元组 $s_{t} = (x_{t}, \mathcal{I}{t}, b{t})$。这里的核心变量正是信息状态:
\[\mathcal{I}_{t} = (\mathcal{E}_{t}, \mathcal{S}_{t}, \mathcal{K}_{t})\]它由三个层次构成:$\mathcal{E}{t}$ 是底层的原始实验证据(包括日志、诊断输出和运行指标),$\mathcal{S}{t}$ 是单次动作的结构化摘要,而 $\mathcal{K}_{t}$ 则是跨实验提炼出的可修正任务知识库。在这个范式下,所有的方案演进都是信息状态演化的副产物,唯有信息状态的持续逼真,才能引导系统在有限预算内做出高信息增益的动作。
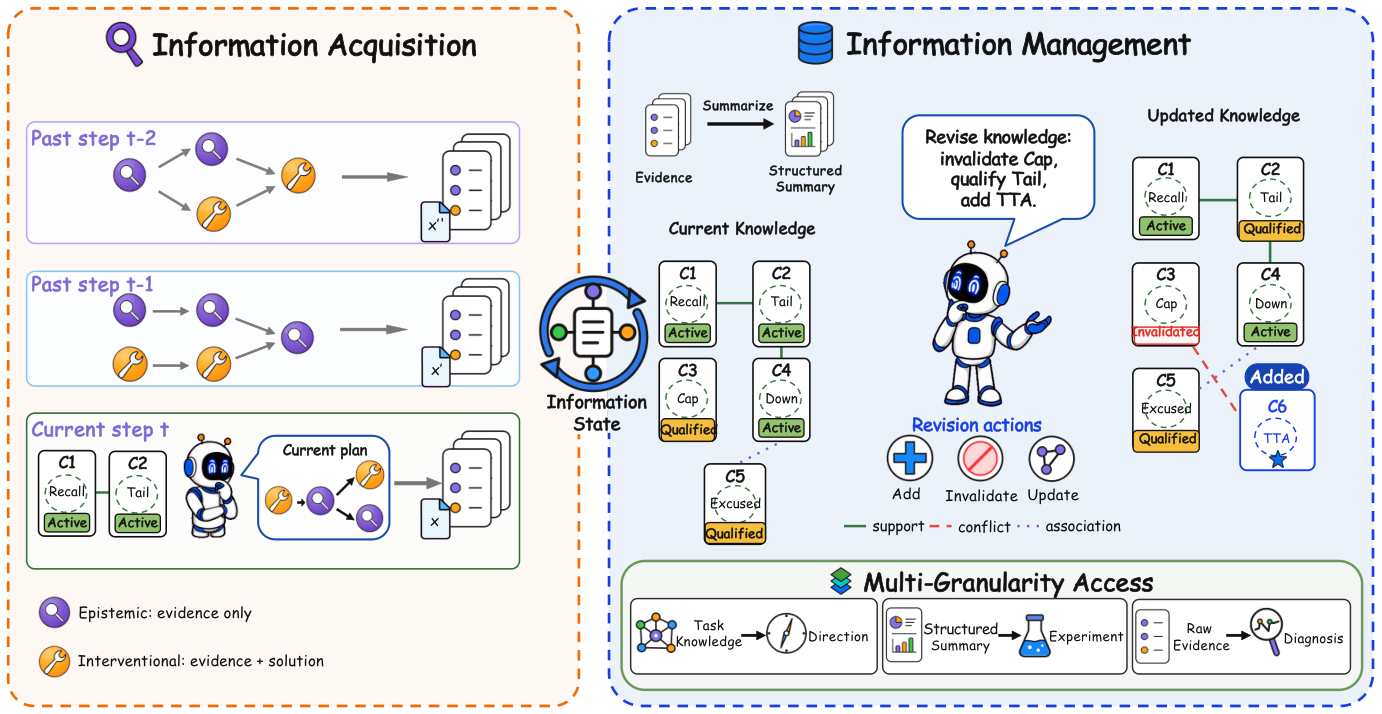
如上图所示,Iris 围绕这一范式构建了严密的“探究-修正”(Inquiry-Revision)双循环。系统由五个独立角色的 LLM 协同运转:规划器(Planner)、执行器(Executor)、分析器(Analyst)、总结器(Summarizer)以及知识管理器(Knowledge Manager)。整个运行流程严谨划分为两大支柱:自适应信息获取与多粒度知识修正。
1. 自适应拓扑与认知动作:先诊断,后干预
在信息获取端,Iris 彻底摒弃了全局预设的搜索树或固定图结构,而是由规划器根据当前任务信息状态 $\mathcal{I}{t}$ 和剩余预算 $b{t}$,动态生成局部的动作计划:
\[\operatorname{Plan}(\mathcal{D}_{q}, s_{t}) = (\mathcal{A}_{t}, \prec_{t})\]局部计划中的动作集合 $\mathcal{A}{t}$ 以及执行依赖关系 $\prec{t}$ 可以是顺序的、并行的或混合的。如果计算资源允许,处于同一拓扑层级的动作可以并发调度,但生成的局部动作总耗时严格约束在剩余预算 $\Delta T_{t} \le b_{t}$ 内。整个长程任务的搜索拓扑,是由这些自适应的局部计划动态涌现出来的。
更为关键的突破在于动作类型的解耦。Iris 将研究动作严格划分为干预动作(Interventional Actions, $\mathcal{A}{t}^{\mathrm{int}}$)与认知动作(Epistemic Actions, $\mathcal{A}{t}^{\mathrm{epi}}$):
\[\operatorname{Execute}(a_{i}; s_{t}, \omega_{i}) = \begin{cases} (e_{i}, \varnothing), & a_{i} \in \mathcal{A}_{t}^{\mathrm{epi}} \\ (e_{i}, \widetilde{x}_{i}), & a_{i} \in \mathcal{A}_{t}^{\mathrm{int}} \end{cases}\]干预动作负责构造、修改并评估候选方案,产出新的候选解 $\widetilde{x}{i}$ 与证据 $e{i}$;而认知动作则完全聚焦于“决策关键未知项”(Decision-Critical Unknowns)。当实验进展停滞、或者几条潜在技术路线因证据不足无法定夺、亦或观察到了反常现象时,规划器不会盲目改代码重训模型,而是派发一个纯粹的诊断动作——例如深入检查预测概率分布、排查评测脚本的截断机制或分析错误样本的共同特征。认知动作产出强判别性的诊断证据,而保留方案 $x_{t}$ 维持不变。这种设计将无谓的训练试错降到了最低。
2. 可修正任务知识与多粒度上下文注入
在信息管理端,认知与干预动作产生的原始输出首先由总结器提炼为单次动作摘要 $\sigma_{i}$,包含尝试目标、观察结果和逻辑推论。然而,单次动作摘要无法看清跨实验的共性规律,更无法自动消除前后矛盾。
知识管理器据此将知识库维护为一系列相互关联的主张记录 $\mathcal{K}{t} = (\mathcal{C}{t}, \mathcal{R}{t})$。每一个主张 $c{i}$ 都具备极高的结构严密性:
\[c_{i} = (\mathrm{claim}_{i}, \mathrm{scope}_{i}, E_{i}^{+}, E_{i}^{-}, \mathrm{status}_{i})\]其中显式标注了该主张的具体论断(claim)、适用范围(scope)、支撑证据指针($E_{i}^{+}$)、反驳证据指针($E_{i}^{-}$)以及当前状态(status)。当新一轮实验产生新证据 $\mathcal{Z}_{t}$ 时,知识管理器通过三种基本算子驱动演化:
-
添加(Add):根据充分证据建立全新的主张;
-
更新(Update):调整现有主张的适用边界、补充双向证据指针、合并互补发现,或将因新证据限制而缩减范围的主张状态从“活跃(Active)”变更为“受限(Qualified)”;
-
废弃(Invalidate):将已被后续证据明确证伪或不再适用的早期过时主张直接注销。
在每次调用特定角色 LLM 时,Iris 并不会把所有历史日志倾倒进上下文,而是实施多粒度上下文注入:为方向决策层提供高度凝练的任务知识库;为实验设计层注入相关的结构化摘要;而为异常诊断层则通过指针反向拉取原始的代码与运行日志。这种层次分明的信息供给,既避免了长上下文带来的模型注意力涣散,又确保了底层诊断能够触达精确事实。
实验评测:不仅刷新基准,更能跨域迁移
为了全面检验信息范式的威力,论文在极具挑战性的机器学习竞赛基准 MLE-Bench 以及更广泛的系统工程任务上展开了严密测试。
1. MLE-Bench 全量评测:压倒性的奖牌率提升
MLE-Bench 汇集了来自 Kaggle 的 75 个真实机器学习竞赛,涵盖表格、视觉、自然语言处理和多模态等多种复杂场景。评测指标包括任意奖牌率(Any-Medal Rate)、金牌率(Gold Rate)、超越人类中位数提交比例(Med+)以及有效提交率(Valid)。
在统一的 12 小时严格预算限制下,以 Claude Opus 4.6 为底座的 Iris 取得了统治级的成绩。全量 75 个任务中,Iris 实现了 100% 的有效提交率,没有任何一次任务因超时或崩溃而交白卷;在 76.0% 的任务上,其方案得分超越了真实 Kaggle 参赛选手的表现中位数。
最引人注目的是其奖牌斩获能力:Iris 的整体奖牌率达到了 64.9%,金牌率高达 39.1%。在低难度和中等难度任务上,Iris 分别取得了 80.3% 和 64.0% 的夺牌率,位居所有对比系统之首;在高难度竞赛中,其夺牌率也达到了 44.4%。
更具说服力的是与 AIBuildAI 的直接对比。AIBuildAI 同样采用 Claude Opus 4.6 底座,但在方案中心式搜索框架下,给予其整整 24 小时预算时,其奖牌率为 63.1%,金牌率为 25.8%。而 Iris 仅用 12 小时(预算减半),就将奖牌率推高至 64.9%,金牌率更从 25.8% 跃升至 39.1%。这一结果充分表明,夺牌能力的质变不是单纯堆叠算力时间的产物,而是源自每一次决策背后的信息保真度。
2. 超越 MLE 的跨领域泛化能力
一个优秀的自主研发框架,绝不应当只是针对 Kaggle 评测特化出来的打榜套件。研究团队进一步在两大截然不同的长程任务族上考察了 Iris 的通用性,包含需要处理策略工具调用的 Agent Harness 工程($\tau^{3}$-Banking 和 BrowseComp),以及模型后训练配方探索任务(基于 Qwen3-1.7B 底座,优化 HumanEval Pass@1 与 GSM8K 准确率)。
在此项对比中,Iris 采用 Qwen3.7-Max 作为优化核心,与行业内极具代表性的通用编码智能体(采用 GPT-5.5 的 Codex 以及采用 Claude Opus 4.8 的 Claude Code)在相同的初始脚手架与 6 小时预算下正面对决。
实验结果展现了极其一致的优越性:
-
在 $\tau^{3}$-Banking 任务中,原始框架的平均奖励仅为 15.8%,Codex 和 Claude Code 优化后分别达到 20.7% 与 26.3%,而 Iris 将平均奖励大幅推升至 30.3%;
-
在多跳搜索合成任务 BrowseComp 上,Iris 将准确率从基线的 38.3% 提升至 67.7%,显著超越了 Claude Code 的 42.8%;
-
在后训练领域,面对代码生成的 HumanEval 目标,Iris 调配的训练配方让模型 Pass@1 达到 47.0%(未微调基线为 9.0%,强大基线最高仅为 41.5%);在数学推理 GSM8K 上,Iris 也取得了 68.4% 的准确率,相较基准模型(8.5%)实现了跳跃式增长。
在完全相同的可编辑文件和环境权限下,通用代码 Agent 倾向于不断重写逻辑代码,常常陷入引入新 Bug、反复撤销修改的震荡之中;而 Iris 的探究-修正机制能准确隔离出 Harness 内部的瓶颈环节(如长文本上下文阶段性截断、Prompt 约束失真等),精准指导下一步修改,体现了跨越代码工程与算法研发的通用方法论价值。
机制透视:一次典型的逆风翻盘全过程
为了直观展现信息范式如何在底层运作,论文深入复盘了 Iris 在日文古籍文字识别任务(kuzushiji-recognition)中的完整研究轨迹。这是一个微平均 F1 极其敏感的高密度目标检测与分类任务。
系统从最初的简单方案出发,初始 F1 仅为 0.629。常规的超参数微调迅速撞上了天花板,F1 停留在 0.661(铜牌水准),同时召回率严重受限,卡在 0.48。如果按照传统方案中心式 Agent 的逻辑,知识库此时会记录“模型容量不足”,随后系统便会盲目尝试引入大尺寸骨干网络或开销极大的测试时数据增强(TTA)。
但 Iris 的规划器在此处安插了一个认知动作(Epistemic Action)。智能体没有重训模型,而是专门编写了一套针对推理端后处理代码的审计脚本。这一纯诊断动作立即暴露了致命真相:目标检测代码中存在一个隐式的默认参数,将单张图片的最大检测输出数量截断在了 100 以内,而测试集中存在大量文字密集的页面,直接导致一半以上的文字连进入分类的机会都没有。
这一发现瞬间引发了一连串优雅的状态演化:
-
知识管理器迅速将早期主张 K1(“模型容量不足,需要 TTA”)标记为废弃(Invalidate);
-
新增主张 K3,断定“输出数量阈值是召回率低下的根因”;
-
系统顺势派发了一个轻量级干预动作——在不重训模型的情况下直接解除 100 的截断限制。
仅仅是这一行改动,方案得分瞬间飞跃至 0.817,跨入银牌门槛。
紧接着,系统并未止步,又派发了第二次认知诊断,旨在探查为何计划中的高分辨率训练并没有带来预期收益。诊断再次发现了底层管线中的隐式下采样缺陷,揭示了先前的训练实际上一直在低分辨率下空转。在修正了该主张后,模型重新启动针对性训练,最终以 0.923 的极高 F1 分数直接冲入金牌区间。
在这场漂亮的进阶过程中,两次关键的跨越都不是靠模型碰运气改代码试出来的,而是由“认知动作获取真相 $\to$ 跨实验知识库纠偏 $\to$ 派发精准干预方案”这一链条驱动的。信息范式将调试机器学习系统过程中的“玄学调参”,真正还原成了严谨的科学探索过程。
启示与未来
长期以来,社区在构建复杂自主任务 Agent 时,往往更关注“推理拓扑长什么样”——究竟是该用 MCTS、多智能体辩论、还是复杂的图状态机。Iris 的成功则给出了一个全新的视角:限制智能体上限的,往往不是外在的搜索拓扑,而是内在信息状态的贫瘠与失真。
当一个 Agent 无法自主发起诊断、无法区分“干预”与“探究”、且无法在遭遇挫折时推翻自己曾经深信不疑的假设,再复杂的搜索算法也只是在巨大的无用假设空间中空耗 Token。Iris 证明了,将信息状态提升为长程任务的第一公民,赋予系统自我提问、精准归因与持续认知迭代的能力,才是通往高阶自主科学研究系统的坚实路径。这一思想不仅对自动化机器学习竞赛意义深远,更将为未来的自动化代码重构、科学假设生成以及通用自主软件工程提供极具价值的设计蓝图。