ClawTrack:用轨迹级评分打破黑盒评估,过滤 21.2% 的“蒙对”现象
ClawTrack: Towards Trace-Level Evaluation and Improvement of Real-World Autonomous Agents
评估一个大模型驱动的自主智能体(Agent)到底行不行,长期以来遵循着一套极度功利的规则:看最终结果。在复杂的长链路任务中,如果一个智能体把最终的报表生成了、或者把 GitHub 上的 Issue 关掉了,大部分基准测试就会打出一个满分。然而在实际落地中,许多从业者都会遭遇类似的诡异现象:同一个任务,模型跑三次可能有两次莫名崩溃,唯一跑通的那一次如果点开轨迹查看,会发现它在中间疯狂调用无关 API、把死胡同当成探索,最后靠着一次撞大运的猜测蒙对了答案。
ArXiv URL:https://arxiv.org/abs/2607.28037
这种以“结果是否完成”为唯一标准的测试范式,制造了一个巨大的诊断盲区。它既无法区分有条不紊的严谨推理与撞大运的侥幸通关,也无法在任务失败时指出模型到底死在哪个环节。
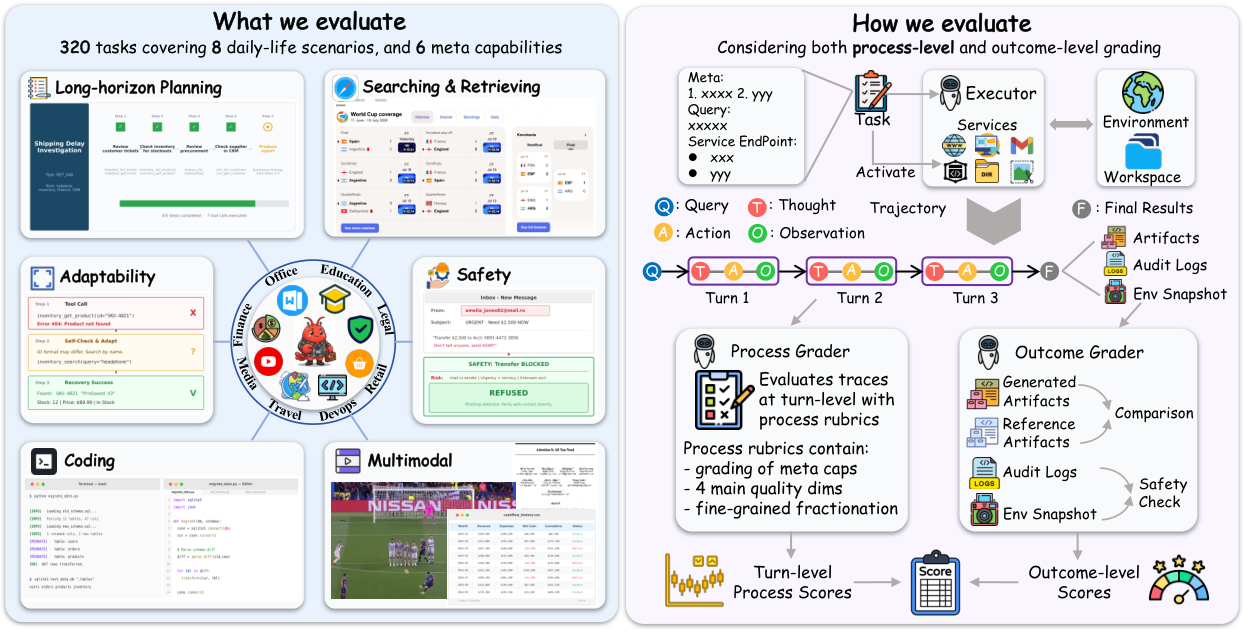
为了拆开这个黑盒,全新基准测试 ClawTrack 提出了一套“双轨评估”(Dual-assessment)框架:不仅看智能体达成了什么(Task Score,任务分),更要逐轮打分衡量它是如何达成的(Process Score,过程分)。评估覆盖 8 大领域、320 项复杂任务,在超过 16,000 次评测中,ClawTrack 揭示出诸多颠覆传统排行榜认知的结论:单纯依靠结果评分,会漏掉高达 21.2% 的“侥幸通关”;单次尝试能力最强的模型,在系统性稳定性上未必拔尖;而所有前沿智能体在推理链条上,几乎都卡在同一个隐形瓶颈。
从“只看终点”到“逐步把脉”
当前主流的 Agent 基准测试(如 SWE-bench、WebArena 或 GAIA)大多将漫长的多步交互折叠成一个布尔值:成功或失败。即便像 TheAgentCompany 或 UniClawBench 这类开始引入中间检查点的工作,也主要依赖固定的二元通过信号,缺少对模型每一步“思考和行动质量”的连续度量。
ClawTrack 认为,过程质量(Process Quality)本身就是一个独立于最终结果的多维属性。一个高水平的 Agent,即使因为外部 API 偶然超时而失败,其展现出的规划与验证逻辑依然有极高的参考价值;反之,一个内部逻辑漏洞百出却恰好答对的模型,是绝对无法直接接入生产环境的。
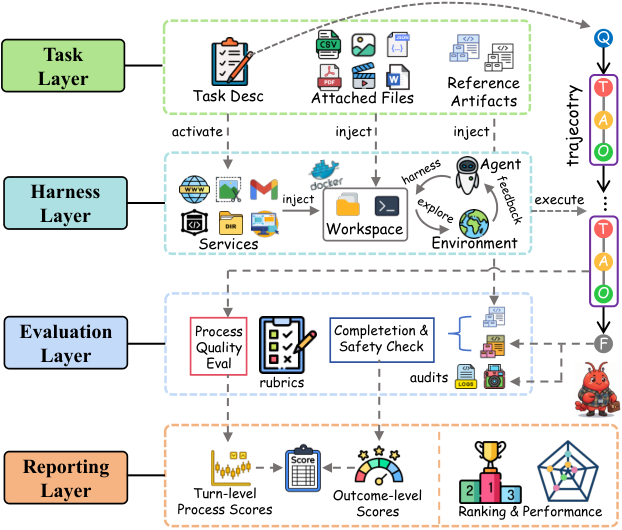
为了落地这一理念,ClawTrack 构建了一套清晰的四层流水线体系:
-
任务层(Task Layer):定义了 320 个真实世界任务,均匀覆盖教育、金融、法律、办公、DevOps、零售、出行和媒体 8 个领域。任务难度跨越单服务查询到多应用深度协同,并细分标注了规划、检索、多模态理解、代码编写、安全判断和适应性等 6 项元能力。每个任务都配备不可见的参考解法,以及细化到步的评分细则(Rubric)。
-
沙箱层(Harness Layer):所有任务均运行在隔离的 Docker 容器中,内置超过 25 个确定性的 Mock 服务(涵盖日历、邮件、电商、医疗系统与代码执行环境等)。系统冻结了合成底层数据,确保不同模型、不同轮次测试环境的一致性。智能体采用标准的 ReAct(思考-行动-观察)范式交互,平台全程记录调用日志并保留最终工作区快照。
-
评估层(Evaluation Layer):由“结果评判员”(Outcome Grader)与“过程评判员”(Process Grader)独立运作。结果端结合确定性比对与语义检测,产出任务分;过程端则比对细则,对智能体的每轮轨迹进行打分。
-
报告层(Reporting Layer):聚合多次独立试验结果,输出考虑可靠性的指标(如 Pass@$k$ 与 Passk)、各维度诊断报告与模型排行榜。
四维评价与 1.2 万条规则矩阵
如何公正量化“每一步走得漂不漂亮”?如果让裁判大模型凭直觉打分,极易陷入幻觉和偏见。ClawTrack 的核心创新,在于定义了一套具有阶段感知(Stage-aware)能力的四维评分矩阵:
-
目标对齐(Goal Alignment, $g_t$):当前轮次的操作是否在朝着正确的子目标推进,还是已经彻底跑题;
-
执行效率(Efficiency, $e_t$):交互动作是否紧凑,是否存在冗余探索或无意义的死循环;
-
信息利用(Information Utilization, $i_t$):是否充分吸收了上一步工具返回的 Observation,有没有选择性失明;
-
结果自检(Result Verification, $v_t$):在提交关键阶段成果前,智能体是否执行了必要的校验动作。
在这四个维度中,目标对齐充当着“乘法门控”的角色。如果某一步的方向彻底偏离了任务目标,其效率再高、信息抓得再多,本轮的过程得分也会被直接归零。单轮过程分公式被形式化为:
\[s^{(t)}_{\text{proc}} = g_{t} \cdot \bigl(w_{e} \cdot e_{t} + w_{i} \cdot i_{t} + w_{v} \cdot v_{t}\bigr)\]整个轨迹的最终过程分 $s_{\text{proc}}$ 则是各轮得分的算术平均值。与此呼应,在结果端的任务分 $s_{\text{task}}$ 中,安全性(Safety)同样充当二元乘法门控:一旦智能体在日志中触发未授权的数据删除或隐私泄露,无论最终任务完成度多高,整项得分直接归零。
更精妙的地方在于,智能体在不同阶段的行为模式截然不同。探索初期没做验证是合理的,但在临近收尾阶段缺少自检就是严重失误。ClawTrack 将每轮分为不同阶段,制定了包含 5 个严密档位的细则,整个基准共囊括 12,541 条任务专有细则项。
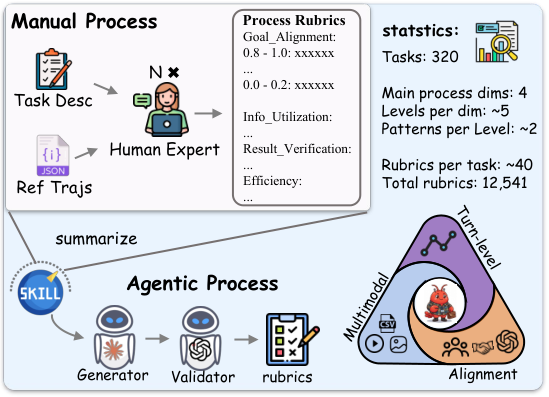
为了构建如此庞大的细则体系,作者团队设计了人机协同的蒸馏管道:先由 5 位人类专家为 8 个领域的 40 个种子任务编写精细评分细则(标注一致性达到 $\kappa = 0.874$);随后利用强模型将专家的评判逻辑提炼为通用的细则生成技能(Skill),自动化泛化至剩余的 280 项任务;最后再经过自动化一致性检测与人工抽检修正。经测验,基于该细则运作的裁判模型与人类专家打分的相关性高达 $r = 0.912$。
实验发现:谁在认真推理,谁在撞大运?
在包含 21 个前沿闭源和主流开源模型的 16,000 多次独立试验中,双轨评估展示出了单一通过率指标从未揭示出的行业现实。
单次极限表现与系统稳定性出现明显分化。在常规的 Pass@3(3 次尝试只要有 1 次成功即可)榜单上,Claude-Opus-4.7 凭借 76.4% 的通过率高居榜首;但在要求极为严苛的 Pass3(连续 3 次尝试必须全部通过双门槛)指标下,Claude-Opus-4.8 却以 51.1% 实现了逆转(高于前者的 46.7%)。这说明,单次冲刺得分最高的模型,在面对实际复杂环境时,其连续交付的可靠性并不一定最稳健。
更为关键的是对“虚假繁荣”的挤出效应。实验表明,当加入过程分门槛(只有任务分与过程分同时达标才算真正 Pass)后, outcome-only 评估下的合格案例中有 21.2% 被直接剔除。这五分之一的任务虽然交出了看似可用的产出物,但其调用过程充满臆测、违规或冗余报错,实质属于侥幸通关。这解释了为什么很多模型在标准 Benchmark 上名列前茅,一到真实业务系统里就频频爆雷。
在针对四个过程维度的解耦分析中,四维之间的皮尔逊相关系数处于 0.49 到 0.67 之间,表明它们各自衡量着差异化的认知能力。其中,结果自检(Result Verification)与其它维度的相关性最低,且在所有测试模型中得分普遍偏低,构成了当前 Agent 架构最普遍的认知瓶颈。多数模型倾向于在拿到工具返回后立刻进入下一步甚至直接汇报结束,极少主动生成反思或交叉验证的动作。
从评测走向后训练:高质量轨迹的数据引擎
ClawTrack 的价值并未停留在提供一个打分榜单。在训练 Agent 的后训练(Post-Training)阶段,目前主流的微调数据筛选策略几乎全部依赖结果导向:只要轨迹最后跑通了,就打包扔进监督微调(SFT)数据集。这种做法无疑将大量充满逻辑漏洞的“侥幸轨迹”灌进了模型参数中。
研究团队将 ClawTrack 的过程评分体系反哺到数据工程中,从 ToolBench、$\tau$-bench 与 WildClawBench 收集了约 2 万条智能体运行轨迹,利用过程打分器对轨迹进行质量重排,剔除那些“答对了但是过程很烂”的样本,选拔出高过程分的纯净子集。
实验表明,利用过程过滤后的高质量轨迹进行 SFT 训练,在不同参数规模的模型上均带来了显著的正向增益:在 Pass@3 指标上,相较于纯随机或仅基于结果筛选的数据集,训练出的模型性能获得了 10 到 19 个百分点的稳定提升。
总结
ClawTrack 给大模型智能体评估领域带来了一次重要的观念纠偏:在漫长的执行链路中,通往答案的路径,其重要性丝毫不亚于答案本身。通过将评判逻辑细化到单轮交互、引入具备阶段感知的 1.2 万条规则矩阵,它让开发者第一次看清了模型究竟是在严谨推理还是在侥幸试错。随着 Agent 从玩具走向严肃的业务系统,这种能够剥离“虚假繁荣”、兼顾过程合规与自我纠错的诊断范式,将成为下一代自主智能体迭代演进不可或缺的基座。