CLIFT:不碰权重做闭环,人形机器人两轮成功率逼近100%
CLIFT: Turning Gemini Robotics On-Device into Humanoid Specialists via Non-Invasive Closed-Loop Iterative Fine-Tuning
在大模型技术重构具身智能(Embodied AI)的浪潮中,视觉-语言-动作(Vision-Language-Action, VLA)模型正迅速演进为人形机器人操纵的核心大脑。然而,具身智能领域正面临一个与大语言模型如出一辙却更为棘手的结构性困局:性能最强悍的基础 VLA 模型,往往是由科技巨头使用海量私有数据训练的闭源系统;由于模型权重、梯度计算和内部损失函数完全不对外开放,下游开发者与研究人员只能通过类似托管式监督微调(Managed SFT)的黑盒 API 接入。
ArXiv URL:https://arxiv.org/abs/2607.29172
这种“只能上传数据、拿回微调策略”的托管微调模式,在处理轮式机械臂或固定台面抓取时或许差强人意,但一旦转移到高动态、富接触的人形机器人全身操纵任务上,就会迅速撞上性能天花板。纯粹的模仿学习(SFT)依赖人类遥操作示范,无法解决实际部署时全身控制器(WBC)的动力学延迟、顺应性偏差以及状态累积漂移;而传统能够修复此类问题的闭环强化学习(RL),又必须依赖策略的对数似然(Log-Likelihood)和反向传播梯度。
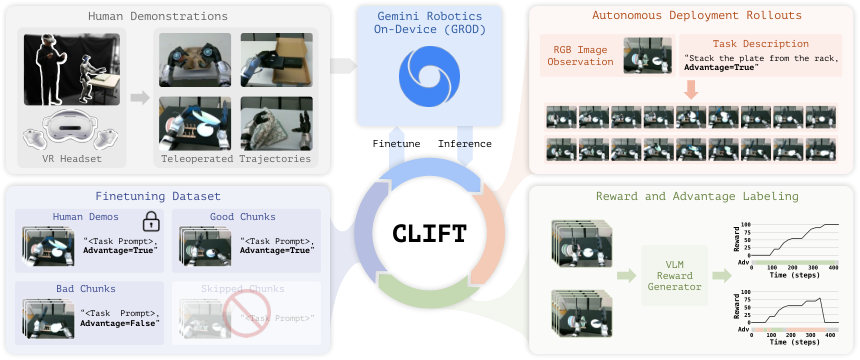
面对这一两难困境,来自具身智能前沿的研究团队提出了一套创新的非侵入式闭环迭代微调框架——CLIFT(Closed-Loop Iterative Fine-Tuning)。该研究以 Google 的闭源具身基础模型 Gemini Robotics On-Device(GROD)为核心底座,在国产宇树 Unitree G1 双臂人形机器人上展开了迄今为止最深入的托管式 API 适配实验。CLIFT 的核心突破在于:它完全不触及底模权重、梯度与损失函数,仅凭将真机闭环采集轨迹转化为带有优势条件标记(Advantage Token)的监督微调样本,就在两轮微调飞轮之后,将人形机器人在多项复杂接触任务上的成功率推向了近乎 100% 的满分水平。
黑盒 API 与人形机器人的天然排异
当前具身智能领域最顶尖的基座模型(如 Gemini Robotics 或 Physical Intelligence 的私有系统)正在树立极高的性能上限,但使用权的分发模式却高度受限。下游用户面对的是一个抽象的算子 $\mathcal{F}_{\mathrm{SFT}}: \mathcal{D} \mapsto \pi$。开发者只能打包上传由观测、语言指令和动作块构成的微调数据集 $\mathcal{D} = {(o_t, \ell, \mathbf{a}_t)}$,云端完成训练后返回一个可执行的策略 $\pi$。在整个流程中,模型的参数权重、输出动作的概率分布、中间层特征全部处于封锁状态。
如果目标是训练机械臂在平整桌面上推叠积木,单靠数小时高质量人类遥操作示范的 SFT 尚能勉强胜任。但当载体变为双足双臂的人形机器人时,纯模仿微调的致命缺陷便暴露无遗。人形机器人的上层 VLA 模型与底层的全身平衡及关节追踪控制器之间存在强烈的物理耦合:即使上层策略输出完全相同的一段动作轨迹(Action Chunk),在物理部署时由于电机的响应延迟、机械臂与物体的瞬态接触反力、以及双足重心的动态微调,底盘和末端实际执行的轨迹也会产生显著偏离。人类遥操作数据分布是一个静态且近乎完美的过程,根本不包含机器人自身控制器引发的特定误差。一旦真机执行中出现轻微碰擦或抓偏,策略就会跌入训练集从未覆盖的分布外状态(OOD),最终导致任务全盘崩溃。
在标准强化学习体系中,解决这类分布漂移的经典范式是构建闭环目标:
\[\pi^* = \arg\max_\pi \mathbb{E}_{o_{1:T}\sim p_\pi(\cdot\mid\ell)}\Big[\sum_{t=0}^T R_\theta(o_t; \ell)\Big] - \beta\,\mathbb{E}_{o\sim p_\pi}\big[\mathrm{KL}\big(\pi(\cdot\mid o, \ell)\,\|\,\pi_0(\cdot\mid o, \ell)\big)\big]\]该目标要求机器人不断在自己的状态分布 $p_\pi$ 下收集真实交互数据,并利用优势函数指导策略更新。但无论是依赖策略梯度的 PPO,还是通过重要性采样做加权的优势加权回归(AWR),都需要直接获取模型对动作的采样概率或直接反向传播损失梯度。在托管 API 的“黑盒”围墙面前,所有传统的端到端强化学习方案全部失效。CLIFT 的诞生,正是为了破解这个看似不可调和的矛盾:如何在不打开模型黑盒的前提下,单凭监督微调 API 跑通强化学习的自提升飞轮?
核心机制:将强化反馈编码进监督样本
CLIFT 的设计哲学是:将闭环强化学习所需的标量奖励与优势估算,彻底解耦并编码进监督微调数据的条件标记(Conditioning Tokens)中。整套系统不修改模型结构、不追加额外的 Critic 神经网络,也不依赖策略的内在参数,而是完全通过数据层面的闭环流转完成自进化。整个飞轮的运转被精确解构为三个阶段。
1. 偏好校准的密集奖励模型:筛选并蒸馏
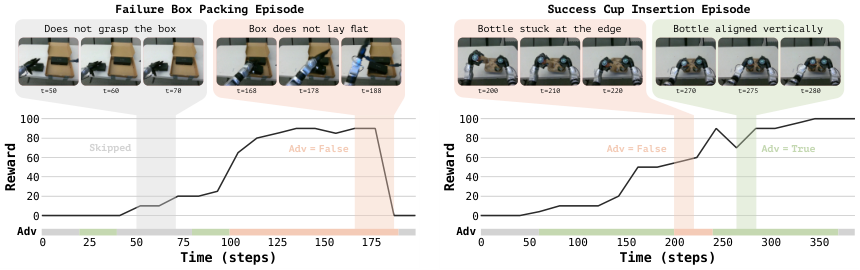
要在人形机器人复杂操作中实施闭环引导,第一道难关是如何量化评价每一次硬件 Rollout 的好坏。如果仅仅使用二元的成功/失败标签,模型将丧失对精细动作质量的辨别力;若直接使用通用的多模态大模型(VLM)零样本打分,又极易被视觉表象欺骗,忽略动作的剧烈抖动、不安全碰撞等动力学瑕疵。
CLIFT 采用了一种“先筛选、后蒸馏”(Select-then-Distill)的双阶段策略。研究人员首先混合人类遥操作轨迹与初始策略的真机轨迹,构建包含 100 对样本的对比池,由人类操作员标定成对偏好。接着,针对每条轨迹利用温度采样促使基础 VLM 输出多条候选逐步奖励序列,并仅筛选出那些累计评分排名与人类物理偏好吻合度最高的候选序列。最后,利用这批经过物理校准的高质量步级标签,微调出一个轻量级生成式奖励模型 $R_\theta$。该模型在后续所有自提升循环中保持冻结,为机器人的连续观测 $o_{1:T}$ 提供兼顾任务进度、平滑度与接触安全性的稠密质量评分。
2. 基于检索的状态感知优势标签注入
获得步级稠密奖励后,最关键的一步是如何将其转化为 API 可以理解的训练信号。直接把奖励拼在输入端并不合理,因为相同大小的奖励在不同难度状态下的含义截然不同:在平稳接近物体的简单状态下取得中等回报属于平庸表现,但在险些脱手的极限姿态下成功稳住物体并获得同样的回报,则是极具价值的超常挽救动作。
为了实现状态感知的价值信用分配(State-Aware Credit Assignment),CLIFT 引入了一种完全非参数化的检索对比机制。对于每一个时长为 1.6 秒的动作块 $\tau_i$(起始于状态 $o_{t_i}$),算法在历史所有的轨迹数据库中,依据图像视觉特征检索出一组起始状态高度相似的动作块作为对比基准集。随后,计算该动作块在未来 $H$ 步内的折扣累计回报:
\[G(\tau_i) = \sum_{t=t_i}^{t_i+H} \gamma^{t-t_i} R_\theta(o_t; \ell)\]只有当 $G(\tau_i)$ 位列该局部相似状态集合的前 30% 时,该动作块才被赋予正向优势标记 $I = \text{positive}$,否则被标记为负向优势 $I = \text{negative}$。这种基于邻域检索的分位数阈值设计,自动抵消了环境状态天然的难度方差。更关键的是,它突破了传统的整条轨迹打分局限:即便是最终失败的 Rollout,其中优秀的局部调整动作依然能被打上正向标签;而即使任务侥幸成功的轨迹,若存在磕碰或严重失误,对应的动作块也会被打上负向标签。
3. 无需承接权重的纯数据迭代飞轮
完成标签注入后,每个用于训练的监督元组被扩展为 $(o_t, \ell, I, \mathbf{a}_t)$。人类遥操作专家数据天然被标记为 $I = \text{positive}$,并与历次真机闭环采集并打标的数据池汇流合并为 $\mathcal{D}_k$。
在这个循环中,CLIFT 展现出了与常规参数微调截然不同的优雅特性。由于托管 API 每次接收数据集都会基于最初的通用预训练底座从头(Scratch)进行微调,新策略 $\pi_{k+1}$ 并非在上一代可能已经产生微弱过拟合的策略 $\pi_k$ 上继续调优,而是始终站在最强大的基础模型肩膀上吸收全量沉淀数据。这不仅彻底规避了连续多轮微调带来的灾难性遗忘与分布崩溃风险,还充分榨取了百亿级参数多模态底座的泛化表征能力。在实际部署推理时,只需将提示词强制锁定为正向标记 $I = \text{positive}$,就能在推理端将模型行为牢牢锚定在高质量动作的流形上。
真机极限检验:Unitree G1 人形任务矩阵
为了检验 CLIFT 的真实威力,实验平台选用了一台配备灵巧手、双臂及头部双目摄像头的 Unitree G1 双足人形机器人。在底层控制上,系统采用分层全身控制架构:高层 VLA 策略以 1.6 秒为时间跨度预测动作块,包含双臂与灵巧手目标关节角度,以及下半身的平面线速度和转向角偏置;底层由预先训练的高频强化学习全身控制器(RL-WBC)实时追踪轨迹,解算全机关节力矩。
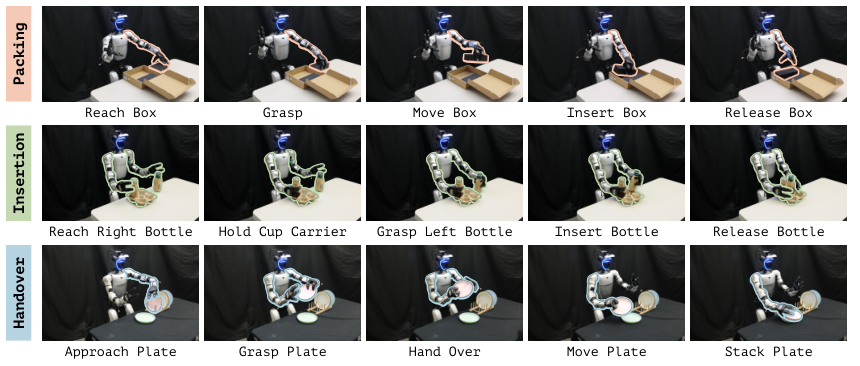
测试基准涵盖了三项接触极其丰富、对敏捷性与抗扰动能力要求严苛的双臂操纵任务:
-
纸盒装箱(Box Packing):单手抓取表面光滑、尺寸偏大的纸盒并紧凑放入容器,极其考验指尖接触力矩的控制与腕部多自由度姿态微调。
-
精密插杯(Cup Insertion):典型的窄公差轴孔装配任务,毫米级的微小偏角就会导致杯体边缘卡死,对视觉定位精度与接触后的顺应性有极高要求。
-
双臂托盘交接(Bimanual Plate Handover):涉及双臂大范围协同,要求左右手在高度非线性的动态接触中完成无缝交接,极其容易出现左右臂互相干涉或失手滑落。
在初始化阶段,基座模型仅在每个任务约 2 小时的人类遥操作示范数据上进行微调,得到初代基线策略 $\pi_0$。随后,系统执行两轮 CLIFT 闭环自演进,每一轮在真机上自动铺设 100 次 Rollout。真机的实测成功率既是评估指标,也是经过检索重标定后反哺下一轮训练的数据资产。
飞轮运转:从粗糙模仿到近乎完美的性能飞跃
实验结果展示了令人信服的性能跃升曲线。在接入 CLIFT 之前,直接通过托管 API 对 Gemini Robotics On-Device 进行 SFT 微调所得到的 $\pi_0$,其实际操纵表现虽然已经显著超越了在相同人类示范上微调的顶级开源模型 $\pi_{0.5}$,但在高难度接触任务上依然频频受阻。由于动作块与全身控制器之间的交互延迟,初版策略在精密插杯时经常在杯口反复试探碰撞,在托盘交接时也屡次因两手开合时机偏差而砸落托盘。
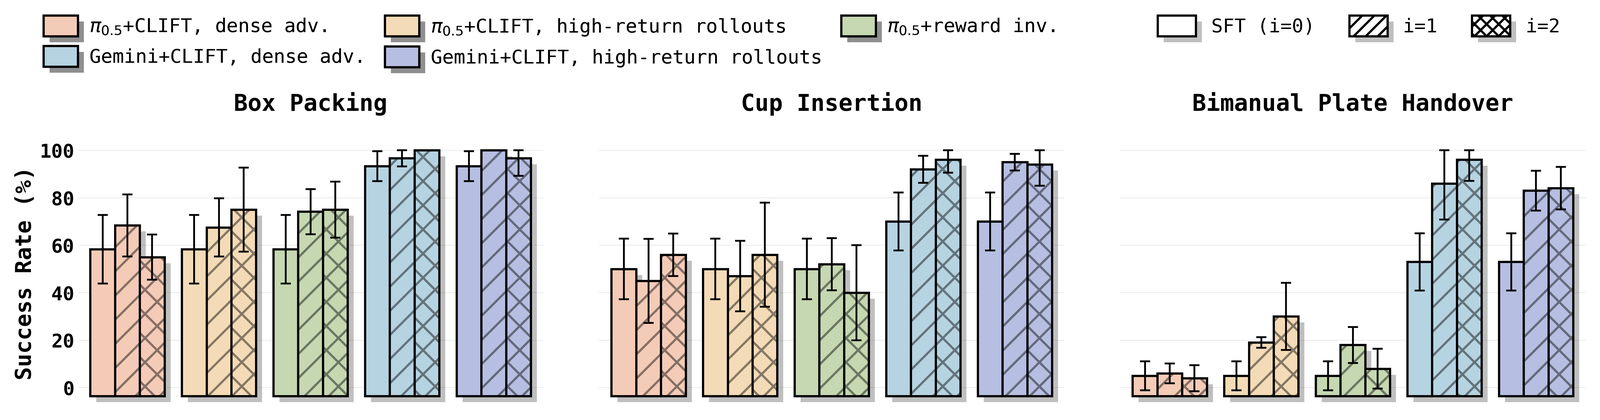
然而,闭环飞轮的启动彻底逆转了局势。如实验评估图所示,随着 CLIFT 迭代两轮,GROD 的任务成功率在所有任务中均呈现出指数级的强化突破:在纸盒装箱与精密插杯任务中,策略成功率从最初不足 40% 快速攀升,并在第二轮飞轮结束后全面逼近 100% 的满分表现;在最为复杂的双臂托盘交接任务中,策略同样展现出极强的鲁棒性,消除了绝大多数接触失稳引发的灾难性掉落。
更为深刻的发现来自于与开源模型基准的横向对照。研究团队在拥有完全权重控制权的开源模型 $\pi_{0.5}$ 上同步部署了 CLIFT 数据飞轮。即便在完全公平的数据闭环条件下,$\pi_{0.5}$ 的性能提升曲线也早早遭遇瓶颈,绝对成功率被封死在较低水准。更具说服力的是,研究人员针对开源模型实现了一种“侵入式”的改进方案——通过修改模型网络架构,利用 FiLM 机制强行把环境偏好特征注入内部特征层。然而,这种侵入式的魔改版本依然未能缩小与 GROD 之间的巨大鸿沟。这一消融实验强有力地证实:在具身智能的工业化落地中,基座模型本身的先验容量与多模态表征能力占据着决定性的主导地位;而 CLIFT 提供了一种极具实用价值的非侵入通道,让被黑盒 API 阻隔的顶尖底模得以充分释放其闭环自优化的全部潜力。
自适应纠错与自发涌现的专家行为
不仅是数字上的跳升,观察真机执行的微观行为,会发现 CLIFT 赋予了策略一种人类示范数据中从未出现过的“自适应韧性”。
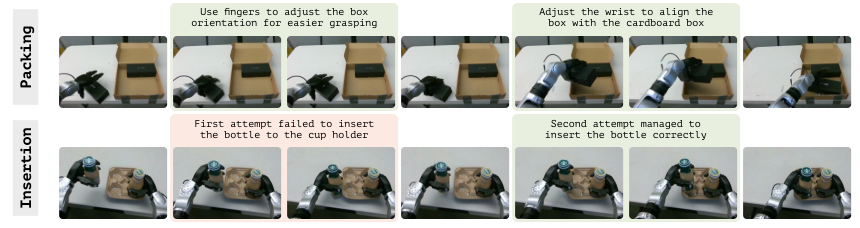
如图所示,在两轮闭环进化完成后,GROD 展现出了显著的自发涌现能力。在纸盒装箱任务中,当机械爪接近纸盒但发现初始朝向难以单手合围时,新策略并没有像初始模仿模型那样机械地强行闭合指节导致抓空,而是主动利用手指与腕部轻轻推顶并旋转纸盒角度,待调整出最适宜抓握的边缘方位后,再从容下爪起吊。而在最为致命的精密插杯任务中,策略在第一下对准产生微小偏移、杯口发生硬接触磕碰时,自发演化出了二次调整机制:机械臂迅速感知到阻抗异常,主动向上抬起数毫米重新校准位姿,随后完成第二波精准插入。
这些高级的容错、试错与姿态重整行为,在人类遥操作专家的顺畅录制样本中是完全缺失的——人类在示范时往往直奔最优路径,几乎不展示从轻度失败中重新恢复的子策略。CLIFT 的优势在于,真机闭环采集天然包含了大量在失败边缘挣扎或最终挽救成功的真实动态。通过检索机制对局部有益动作的正向提炼,模型学会了如何对抗不确定性,真正从一个机械的动作复印机,蜕变为了具备环境自愈能力的“人形操纵专家”。
范式启示:大模型时代的具身智能进化路径
CLIFT 的成功不仅是一次算法层面的技术革新,更是对未来具身智能产业协同范式的一次深刻预演。长期以来,学术界与开源社区普遍对专有、闭源的商业具身底座抱有戒心,核心担忧正在于封闭的权重接口将策略探索死死限定在低效的模仿学习空间。而 CLIFT 用实打实的真机数据推翻了这一固有偏见:利用监督微调的黑盒 API 作为物理载体,同样能够达成等效甚至超越端到端强化学习的自提升飞轮。
当然,该方案在现阶段依然存在硬件现实层面的约束。当前飞轮运转依然完全依赖真实的人形机器人硬件下地 Rollout,每一轮上百次的真机交互不仅意味着巨大的时间与维护成本,在剧烈富接触或失去平衡的临界状态下,更伴随着不可忽视的关节磨损与安全风险。研究团队也明确指出,未来的延伸方向将是引入感知控制联合的世界模型(World Model),在数字孪生或神经渲染空间中先行推演筛选动作块,大幅削减真机采样的危险探索轮次。
但无论如何,CLIFT 已经证明了一条极为平坦的演进通路。它向整个行业宣告:面对规模庞大、技术壁垒高筑的闭源大模型底座,下游研究者无需在“受限于简陋模仿”与“高成本重训开源底模”之间艰难二选一。不触碰内部参数,不打开模型的黑盒,仅仅依托优雅的非侵入式闭环飞轮设计,同样足以将通用具身基座锤炼为人行操纵领域的顶尖专家。