中科院提出SciDSK:科学数据打包成Agent技能,24项评估命中23项
Scientific Data Skills: Enabling Agent-Ready Scientific Data Services at Scale
在 AI for Science 的浪潮中,各类大语言模型驱动的智能体(AI Agent)已经开始涉足文献调研、假说提出乃至自动化实验设计。然而,一旦智能体试图踏入真实科研的核心腹地——调用科学数据集进行计算与验证时,往往会遭遇当头一棒:现有的海量科研数据,对智能体来说实在太不友好了。
ArXiv URL:https://arxiv.org/abs/2608.19625v1
尽管科学界推行了多年的 FAIR(可发现、可访问、可互操作、可重用)原则,并诞生了 Croissant、RO-Crate 等数据描述规范,但这些成果本质上依然是“面向人类科学家”或“面向专用脚本管线”设计的陈述性说明书。智能体面对成百上千个分散的仓储系统、模糊的文件命名、缺失的字段约束以及断层的预处理脚本,经常陷入“搜不到、看不懂、不敢调、调就错”的死循环。
针对这一瓶颈,中国科学院与中国科学院大学的研究团队提出了 SciDSK(Scientific Data Skill,科学数据技能) 框架。这项工作的核心构想十分巧妙:不再试图去重构现有的底层数据仓储,也不把数据集当作笨拙的外部检索对象,而是将特定数据集的科学背景、文件层级语义、前置校验规则与端到端操作步骤,打包成一种即插即用的模块化“智能体技能”。智能体只需加载对应的 SciDSK,就能以渐进披露的方式掌握调用该数据集的全部专业知识。在涵盖 6 个学科维度的严格基准测试中,基于 SciDSK 的智能体在 24 项细粒度数据集解释与操作评估中精准命中了 23 项。
科学数据调用的“三座大山”
让自主智能体直接对接科学数据,为什么会如此困难?论文团队在引言中剖析了智能体在科学数据生态中面临的三重结构性错配。
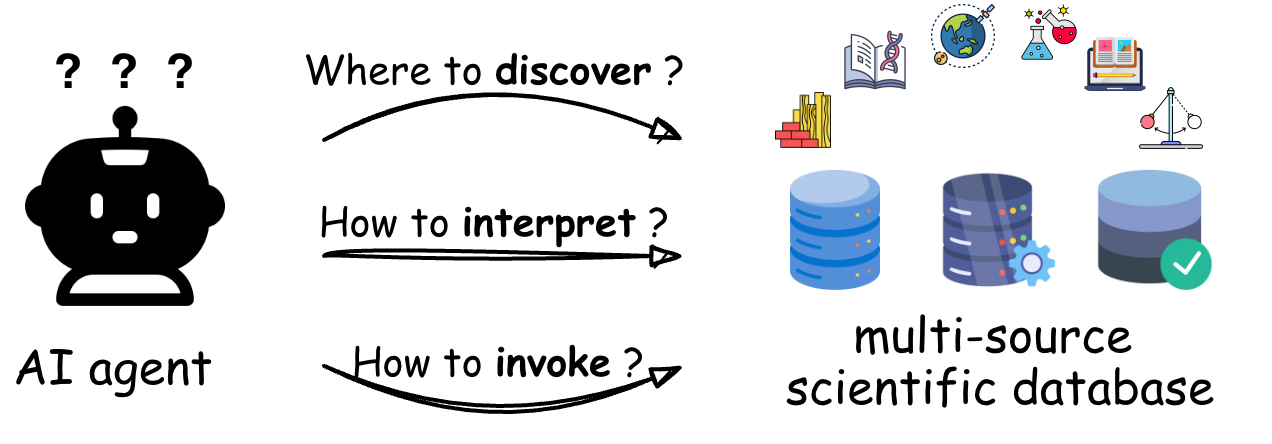
首当其冲的是仓储的极度碎片化与异构性。当前的科学数据分布在各个学科专门数据库、机构知识库、论文补充材料以及独立第三方服务中。每个平台都有独立的元数据 Schema、检索 API 和鉴权规则。智能体要想跨库检索一个合适的地球物理观测数据集或生物分子序列,必须针对每一个平台单独适配检索策略,这种分散性从源头上阻断了系统性的跨库发现。
更致命的障碍发生理解阶段。传统数据集的元数据通常只在宏观层面描述科学背景、项目来源和总览摘要,却极少深入文件内部的组织逻辑。科研人员经常把几十个不同处理阶段的 TIFF 图像、HDF5 矩阵或 CSV 附表打包成压缩包上传。不同测量批次、不同参数配置的文件格式可能完全相同,后缀名根本无法传达其背后的物理量与实验语义。智能体仅凭简略的描述和文件树,极容易选错子文件,误把中间清洗过程的临时文件当作最终观测产物,甚至将错误的物理量代入下游分析。
最后一道鸿沟则是从“理解信息”到“可执行操作”的断层。科研数据的使用往往伴随着严苛的前置假设:特定单位的转换、离群值的剔除、依赖配置文件的配对读取,以及数据完整性与损坏状态的校验。现有的数据卡片(Dataset Cards)大多只负责声明“有什么”,却不会交代“怎么跑”。通用智能体在缺乏具体操作规程的情况下,只能凭借模型自身的常识去“脑补”数据清洗与转换逻辑。一旦推断出现幻觉,下游的科学实验结论将彻底丧失可复现性与学术可靠性。
从静态卡片到可复用技能:SciDSK 的设计哲学
面对这三重阻碍,中科院团队提出了关键视角转变:将智能体工程中行之有效的“Agent Skill”范式引入科学数据服务。
在现代智能体架构中,技能(Skill)本质上是一种封装了任务特异性知识与执行指导的模块化机制。它天生支持“渐进披露”(Progressive Disclosure):在常驻环境中,技能只向智能体暴露极其精炼的功能描述;只有当智能体在规划阶段判断该技能与当前任务高度匹配时,才会动态加载详细的指令正文、环境约束与辅助脚本。这样既保护了有限的上下文窗口,又赋予了智能体调用专业知识的能力。
本文定义的 SciDSK 正是这一机制与科学数据特异性知识的结合体。它没有要求全球数据中心推翻既有的存储体系,而是充当底层数据与上层智能体之间的语义桥梁。
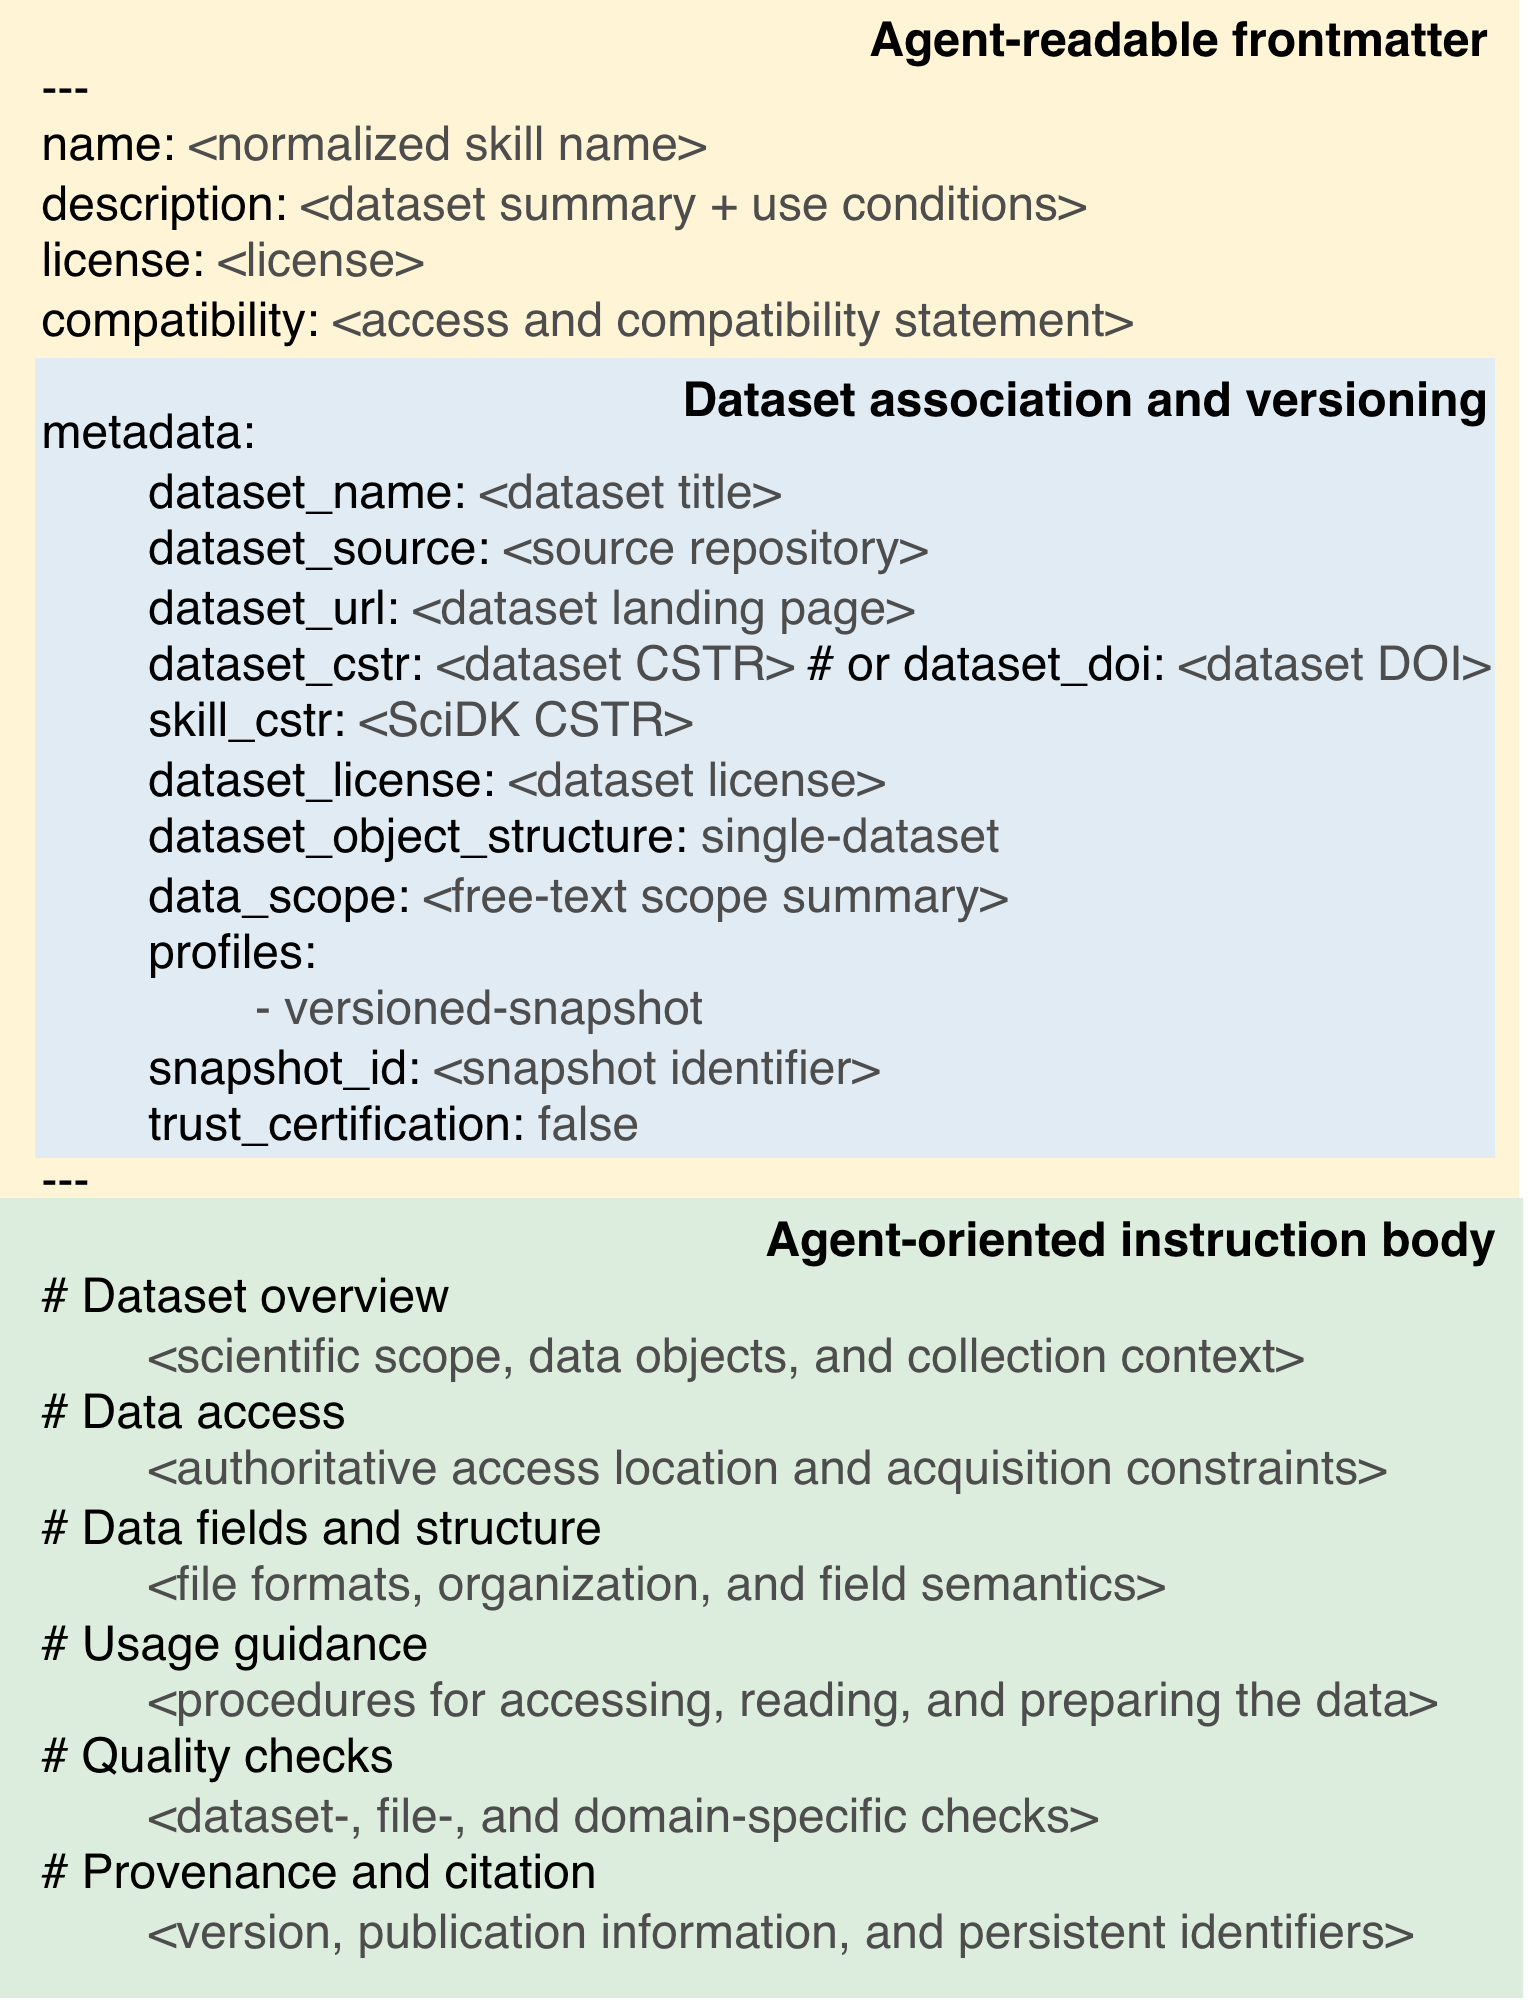
从结构上看,一个标准的 SciDSK 包含规范化的 YAML 元数据头和 Markdown 指令主体。前端元数据明确登记了数据技能的全球唯一标识符(CSTR)、源数据集持久化标识符(如 DOI 或 CSTR)、所属学科分类、版本快照以及极短的功能检索描述。这一层信息专供智能体在海量库中进行初筛,完全无需预先发起耗费算力的深层文档请求。
当智能体选定某个 SciDSK 后,加载出的指令正文则提供了极其细致的语义骨架。其中包含四个不可或缺的模块:
-
科学上下文与范围:阐明该数据集测量了什么、适用于哪些科研任务、存在哪些已知的边界和科学局限。
-
文件层级语义与关联映射:不再只提供冷冰冰的文件树,而是明确标识关键文件(如元数据字典、主观测数据、坐标参考文件)在科学计算中的角色,厘清跨文件之间的主外键或时空关联。
-
前置质量检查:明确列出读取前必须执行的完整性校验,例如关键文件是否存在、序列切片编号是否连续、校验和是否一致。
-
端到端操作规程与可重用代码:给出精准的读取、预处理和标准化转换指南,明确标出依赖的专业环境工具。
相比于传统的通用工具(如仅暴露一个 REST API 的 MCP 接口),SciDSK 并不是一个黑盒函数,而是为智能体补全了“何时该调该工具、如何把这批科学文件以何种参数塞入计算工具”的先验认知。
规范构建与 Skill Bank 平台落地
为了将这一理念工程化落地,作者团队制定了一套严密的构建流程(Construction Pipeline),并在中国科学院科学数据总中心的支持下,建立了首个面向六大学科的 Scientific Data Skill Bank(科学数据技能银行) 在线服务平台。
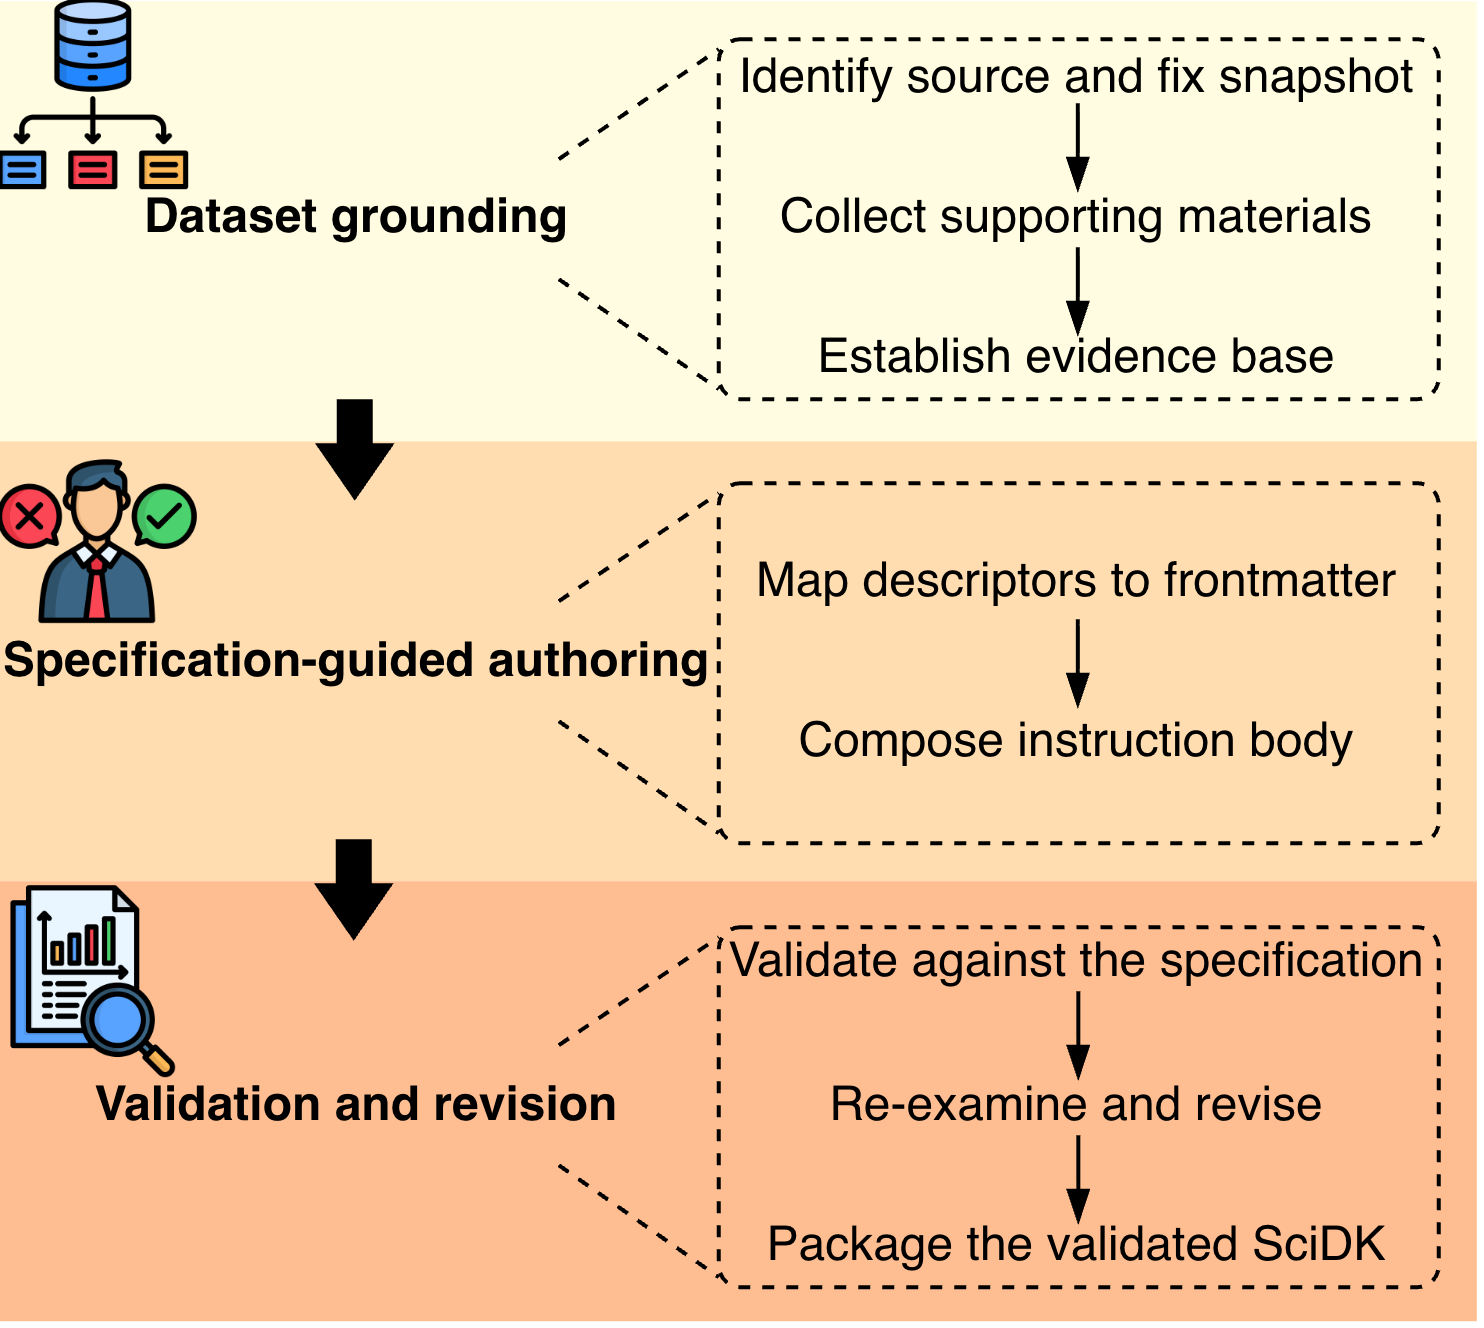
高质量的 Agent 技能不能靠大模型天马行空地自由生成,科学数据的严谨性容不得半点虚构。本文提出的构建流水线包含三个严格接续的环节:
首先是多源证据抽取。管线不仅抓取科学数据仓储的官方落地页、元数据字段和真实文件树,还会系统性挖掘随附的论文正文、技术补充文档、代码仓库示例以及数据制作团队的用户手册,形成一个证据闭环。
其次是结构化生成与语义约束。依据预定义的 SciDSK Specification,将抽取出的零散知识按照身份、科学角色、文件映射、操作指引与质量检查逐层格式化。
最后是形式化校验与多轮修订。作者设计了严格的校验规则,包括 YAML 语法的合规性、文档内部引用的自洽性(例如指令中提到的文件名必须严格存在于文件树中),以及最关键的“源端一致性检查”。只有通过全部自动化合规测试的技能包,才会进入后续的人工复审。
在 Skill Bank 平台的审核流程中,研究团队设立了四项硬性准则:源端真实性(Source Authenticity)、表示保真度(Representation Fidelity)、技能安全性(Skill Safety,确保指令中不包含破坏宿主系统的恶意代码)以及智能体兼容性(Agent Compatibility)。
为了保证科学成果的学术严肃性与长期可用性,入库的每个 SciDSK 都被赋予了独立的科技资源标识符(CSTR),同时严格锁定了其所对应的底层数据集特定版本快照(Snapshot Identifier)。这意味着技能与原始数据具备独立引用、双向追溯的能力,科研人员既可以引用原始数据本身,也可以单独引用指导该数据调用的 SciDSK。
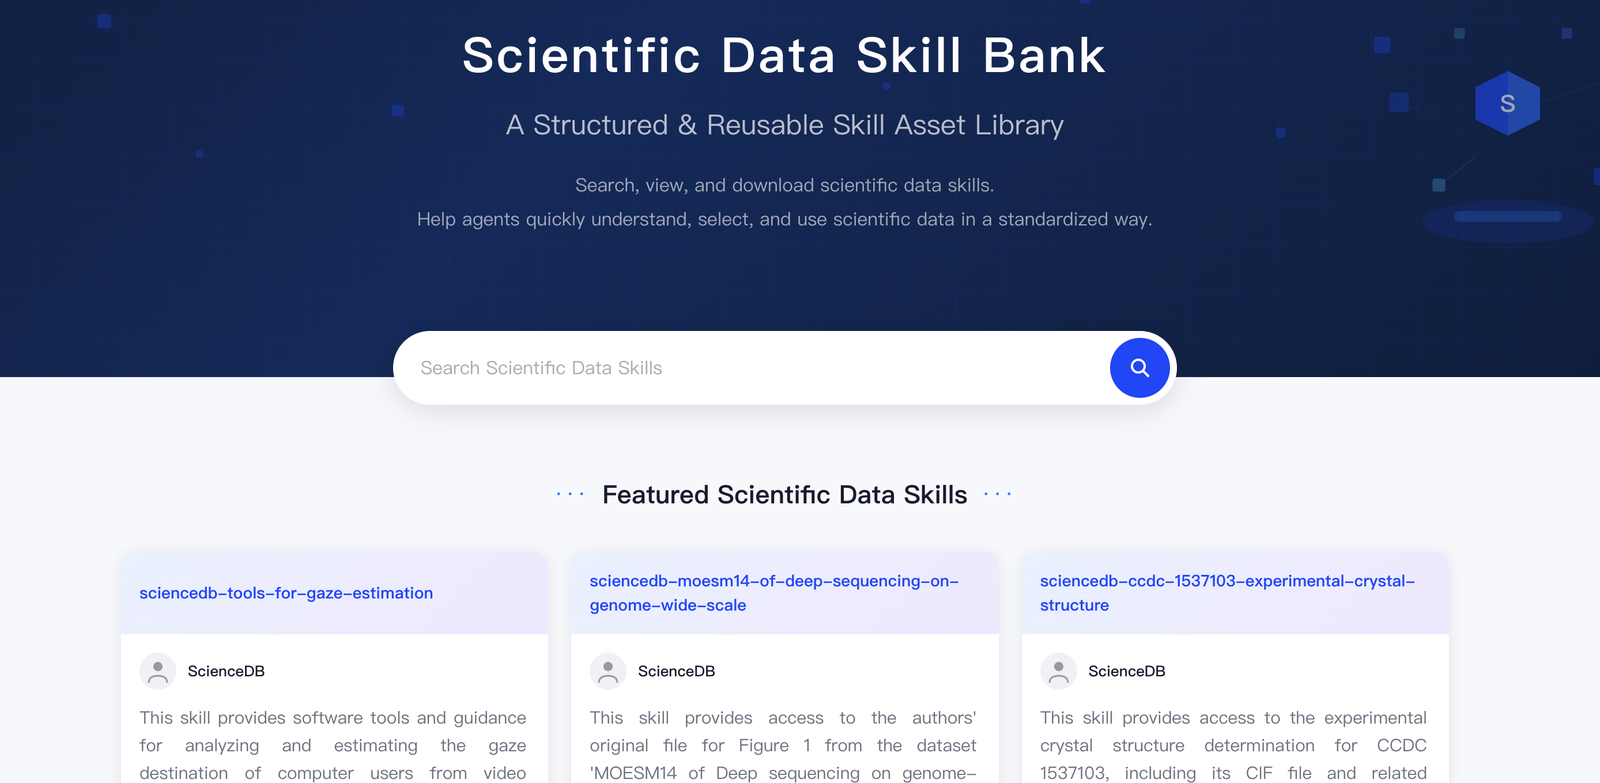
目前,平台已经开放了包括物理学、化学、地球科学、生物学、材料科学以及计算机科学在内的六大学科公共技能库,并提供了清晰的检索、详情查阅与技能包下载入口。
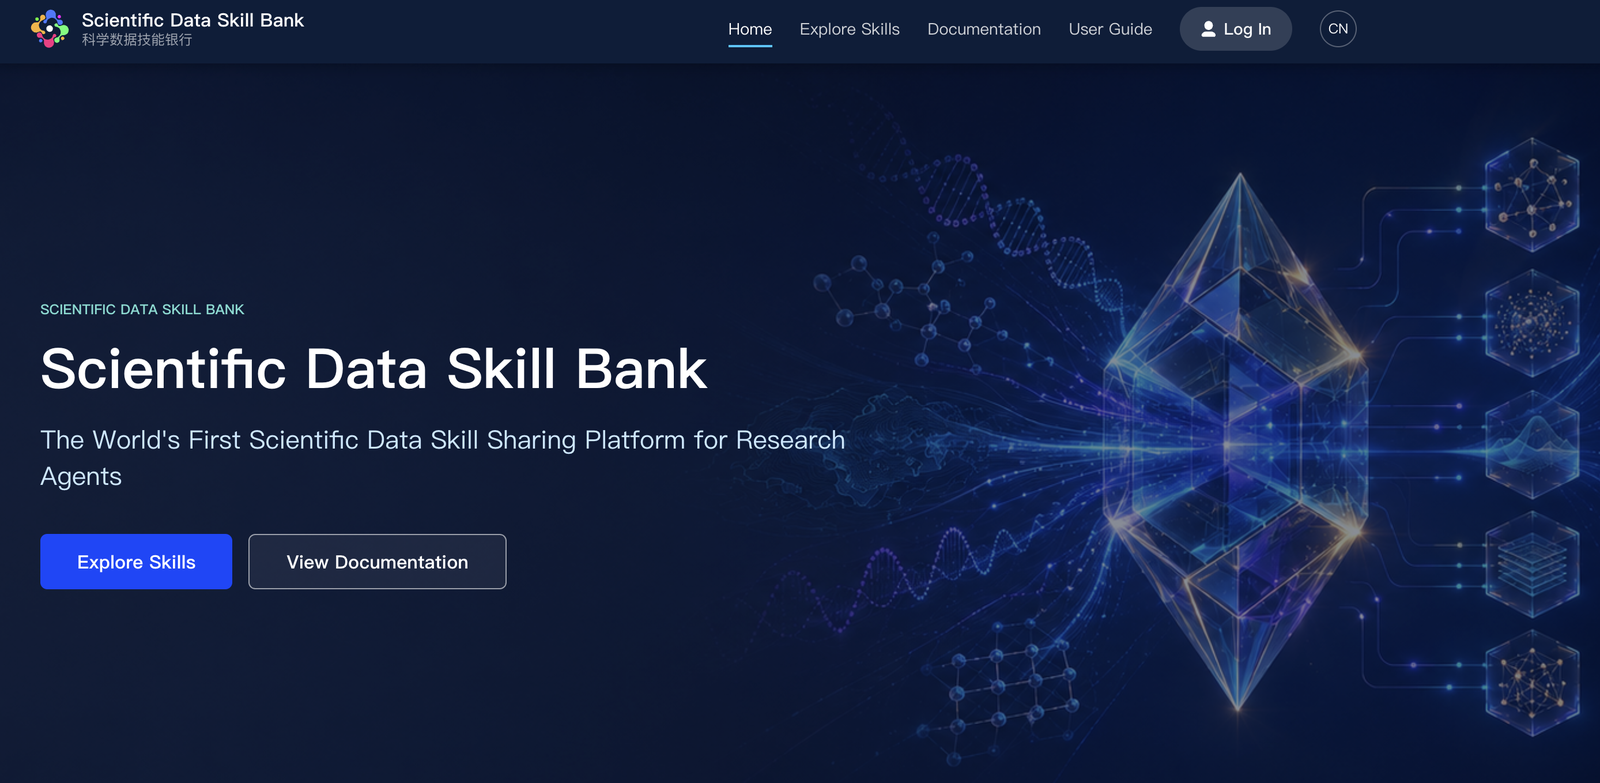
用户与智能体不仅可以通过网页检索浏览,还能直接获取适配智能体框架的标准规范压缩包。
实验评测:智能体不仅要“搜得到”,更要“读得懂”
为了验证 SciDSK 体系的实际效能,本文构建了一套严格的受控评测基准,重点考察两个核心任务:数据集发现(Dataset Discovery) 与 数据集解释(Dataset Interpretation)。
1. 数据集检索与发现:分层路由的威力
现有的科学数据检索往往极度依赖关键词匹配,但科研人员向智能体提问时,通常表述的是高层研究意图(例如“我想寻找用于评估低剂量 CT 降噪算法的连续切片体素数据”),极少直接报出冷门的专有数据集名称。
团队为此在 6 个学科的 72 个真实数据集中,构建了 104 个经过严格人工去偏、消除了实体泄露的高难度科研意图查询。检索候选库则包含了常规元数据和完整的 SciDSK 资源。
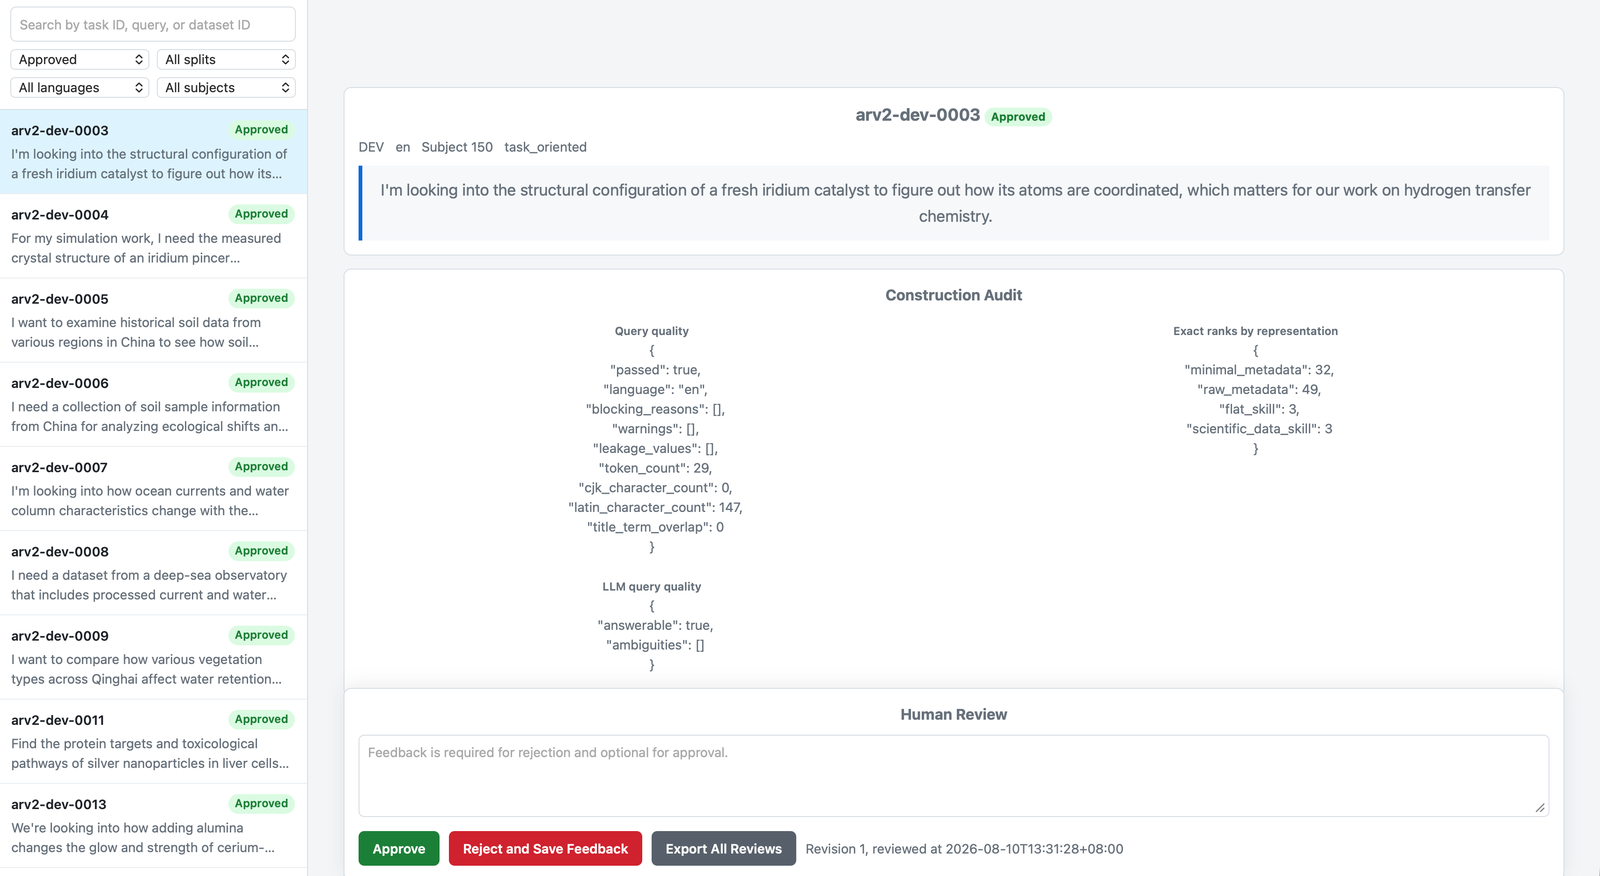
实验在基于 Qwen-3.6-Plus 的真实智能体测试框架(Agent Harness)下进行,通过 MCP 协议限定了安全工具空间。评测对比了传统词法检索(BM25-Raw、BM25-SciDSK)、将 SciDSK 纯文本化作为检索库的智能体多轮检索(Agent-SciDSK-Text),以及严格遵循 SciDSK 技能机制的端到端路由检索(Agent-SciDSK)。
评测结果揭示了两个极具启发性的现象:
第一,如果只是简单地把 SciDSK 写成的丰富文档作为普通长文本扔给智能体或 BM25 进行检索(Agent-SciDSK-Text),其效果与检索普通的粗粒度元数据相比提升非常有限。长文本带来的冗余噪音甚至会稀释关键匹配项。
第二,当引入 SciDSK 的规范化技能机制后——即智能体先依据学科顶层描述进行学科路由定位,再在已注册的精简 Skill 描述空间内进行两阶段检索(Agent-SciDSK),Hit@1、Recall@5 和 nDCG@5 等指标均取得了显著的最高分。这证明了将知识组织为“轻量摘要检索 + 渐进展开详情”的模块化架构,在长文本意图理解中的巨大工程优势。
2. 数据集解释与操作指引:细微之处见真章
如果说检索只是第一步,那么面对科学文件时的精确理解与前置判断,则是决定后续实验能否成功的生命线。
团队选取了四个极易引起误解的代表性场景进行端到端解释对比:三维 CT 连续重建切片、包含伴随文件(Sidecar)的 GIS 遥感栅格影像、基于图像的学术表格解析,以及微博谣言事件与文本跨文件外键关联。针对每个案例,专家团队制定了 6 项不可妥协的原子评估准则(涵盖文件角色区分、连续性校验、参数文件配对、未提及事实的幻觉防御等),全套测试共计 24 项刚性指标。
评测对比了三种智能体获取信息的条件:
-
Agent-Page:智能体直接阅读传统的 ScienceDB 数据集官方 Landing Page 完整镜像。
-
Agent-Raw:智能体直接读取传统元数据 JSON 与真实文件目录树。
-
Agent-SciDSK:智能体通过标准 Agent 技能机制加载 SciDSK。
结果展现出压倒性的准确度差异:在总共 24 项严苛指标中,Agent-SciDSK 成功达标 23 项,而直接阅读官方网页的 Agent-Page 仅命中 22 项,且在多项关键科学细节上被证实产生了严重的幻觉或误导。
在三维 CT 重建案例中,数据集中包含 1500 多张散乱图像,但真正属于特定器官连续断层扫描的核心序列只有 196 张连续切片。直接阅读网页的智能体被人类写在摘要里的一句模糊描述(“包含 200 余张切片”)误导,坚称该序列多于 200 张,忽略了文件树的真实编码;而加载了 SciDSK 的智能体不仅毫厘不差地给出了 196 张的真实有效切片范围,还主动规划出了“检查序号是否断号、验证伴随参数矩阵是否对齐、校验文件读取头完整性”的前置安全检查链条。
在微博谣言跨文件关联案例中,面对多个以哈希值和事件 ID 错综交织的 CSV 文件,未加载技能的智能体无法确定哪一张表是主键映射表,盲目推断了错误的关联逻辑;SciDSK 则明确为智能体标定了主控字段与合并方式,直接规避了灾难性的多表拼接错位。
为什么说 SciDSK 是 AI for Science 的关键基础设施?
纵观整篇工作,SciDSK 带来的启发远不止于一个数据技能格式或一个评测榜单。它实际上解答了一个更深层的问题:在面向自主智能体的时代,科学知识服务究竟应该长成什么样?
长期以来,科学界在解决数据可利用性时,往往沿着两条路线推进:一条是“以模型为中心”,期望大模型通过预训练见识过世界上所有的文件格式与数据结构,靠 Scaling Law 自动拥有读懂一切冷门专有数据的能力;另一条是“以接口为中心”,试图把每一个科学数据库都改造成可以调用的 API。
然而,真实的科学研究场景极其分散,长尾学科的数据规范千差万别,要求所有科研团队统一底层数据库既不现实,要求大模型在千亿参数中记住某个小众传感器的畸变校正参数更是缘木求鱼。
SciDSK 走出了一条兼具学术严谨与工程可行的折中路径:以数据为中心的知识显式化包装。它把原本需要人类领域科学家反复查阅文档、踩坑排错后才能写出来的“数据准备常识”,沉淀成了与代码模型无关的标准技能单元。模型负责遵循通用逻辑去推理,SciDSK 负责在具体遇到某份数据时为其注入精准的上下文与操作防线。
随着 Scientific Data Skill Bank 等平台的建设与扩充,未来的科研智能体或许不再需要在杂乱无章的互联网和文件系统中盲目摸索。把数据包装成智能体的技能,让数据自带“操作说明书”和“安全护栏”,正是科学智能体迈向规模化、自主化科研发现不可或缺的关键拼图。