东大提出VLAff:从20万人类视频统一抓取与轨迹,零样本落地真机操作
VLAff: Vision-Language-Affordance Model for Unified Actionable Affordances
机器人学习领域长期面临一个尴尬的困境:互联网上存在海量的人类第一人称操作视频,但因为人和机器人的物理形态差异极其悬殊,模型很难把人类的动作指令直接映射到机械臂上。直接套用机器人特定的控制动作(Action Labels)去训练大模型,又受限于真实机器人数据昂贵的采集成本,难以做到通用大模型的规模化涌现。
ArXiv URL:https://arxiv.org/abs/2608.05215v1
针对这一核心痛点,东京大学的研究团队给出了一个清晰的解题思路:跨越具身形态差异的最佳中介,不是去硬猜机器人的关节电机指令,而是学习以物体为中心的“可操作引导表征”(Actionable Affordances)。团队构建了一个拥有 20.4 万条视频片段、千万级标注的大规模第一人称数据集 EgoAffordance,并在此基础上提出了统一的多模态视觉-语言-操作引导模型 VLAff(Vision-Language-Affordance Model)。
该研究跳出了过去将“接触点定位”、“手部抓握姿态”与“末端轨迹规划”割裂成独立模块的局限,在一个基于视觉语言大模型(VLM)的统一框架下,同时预测“去哪交互”(Where to interact)、“怎么抓握”(How to grasp)以及“如何运动”(How to move)。更重要的是,这套表征在没有额外微调的情况下,不仅刷新了视觉交互区域定位的指标,还能直接转换为 3D 轨迹,完成真机环境下的零样本操作,并在强化学习中充当极为高效的引导先验。
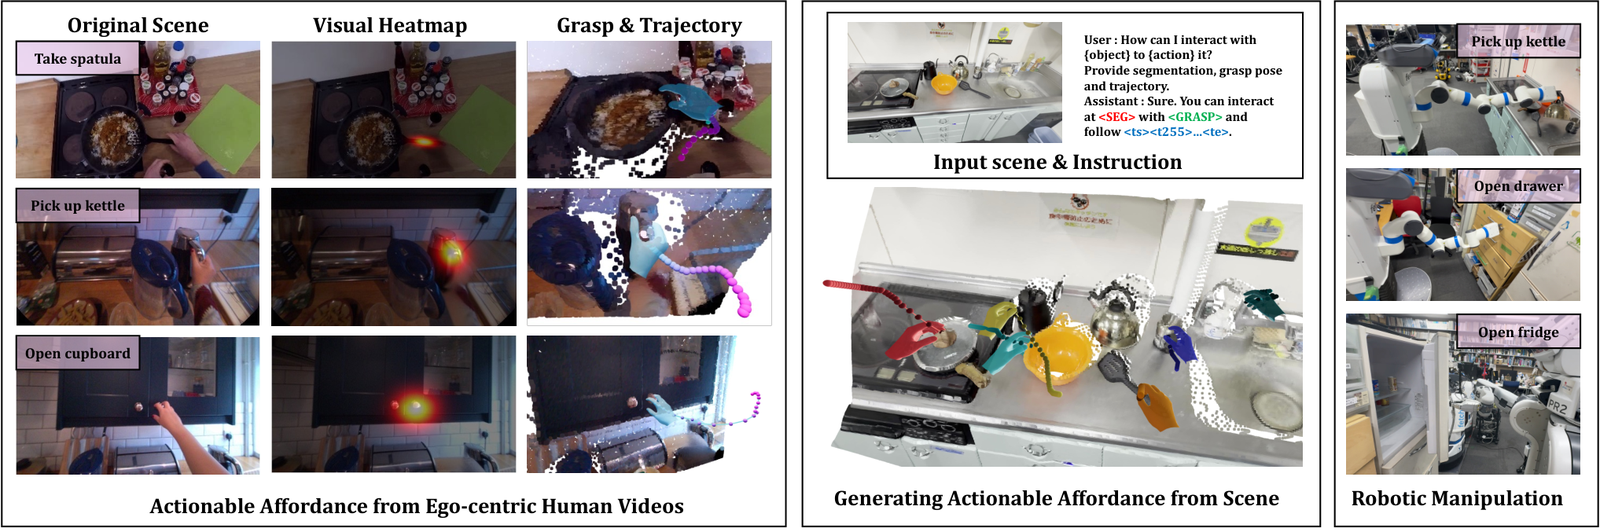
为什么具身智能需要跨越形态的“中介表征”?
过去几年,以 RT 系列或 Open X-Embodiment 为代表的 Vision-Language-Action(VLA)模型取得了显著进展。但这类模型高度依赖真实机器人平台录制的数据,无论是遥操作还是专家示范,数据的获取难度和扩展成本都极其沉重。反观互联网,以 Ego4D 为代表的第一人称人类视频虽然规模庞大、场景丰富,却因为人类手掌与二指夹爪或灵巧手在动力学、运动学上的巨大鸿沟,让传统的行为克隆算法难以直接落地。
此前学术界尝试过提取局部信息来过渡。例如只预测物体表面的接触热力图(Contact Heatmaps),告诉机器人手应该碰哪里;或者单独预测手部的 3D 姿态(Hand Pose)与末端运动轨迹。然而,单独知道接触点并不意味着知道物体该如何被推拉旋转;单独拥有轨迹点,又缺少物体局部几何与抓握朝向的约束。这种碎片化的建模方式,割裂了物理操作过程中各动作要素之间的内在协同。
东大团队的核心洞察在于,一次成功的物理操控必须在几何空间中闭环:模型首先需要凭借语义定位目标交互区域,进而结合局部的法向量与握持结构确定抓握位姿,再以此为锚点延伸出在时间序列上的连续位移轨迹。将这三者统一在同一个以物体为中心的坐标系下,不仅天然抹平了人机形态差异,还能让大语言模型的语义常识与底层的 3D 空间结构深度交融。
EgoAffordance:从非结构化视频中榨取三维操作真值
为了让神经网络学会这种统一的表征,首先需要海量且结构齐整的多模态操作数据。然而,现存的第一人称视频大多只有时间戳标注和粗略的动作文本,根本没有现成的 3D 轨迹与精准抓握参数。为此,作者设计了一套自动化数据处理流水线。
整个流程始于对第一人称视频关键帧的时空挖掘。研究者先利用前沿的大型视觉语言模型(VLM)对抽样帧进行语义理解,定位出发生手物接触的核心关键帧、动作类别以及操作涉及的具体手部。随后,利用手物检测器结合图像分割模型提取物体掩码和手部 2D 关键点,计算二者的像素交集,锁定精确的初始接触区域并进行时序追踪。
真正的工程硬核之处在于三维信息的几何复原与视角去偏。为了消除人类手臂和手掌对背景物体几何外形的视觉干扰,团队对图像中的人体手臂进行前景分割,并借助图像修复(Inpainting)算法将其抹除,生成不依赖操作者形态的干净场景图像。紧接着,流水线运用单目深度估计与相机内参优化算法,构建第一人称运动恢复结构(Structure-from-Motion, SfM)。在此过程中,所有动态的物体与手部区域均被掩码剔除,确保仅通过静态背景计算出鲁棒的相机轨迹。
最后,结合参数化的 MANO 手部网格模型与估算出的连续相机位姿,流水线成功将手部在接触前后的运动轨迹提升至带有 3D 旋转与平移的 6D 空间。最终建成的 EgoAffordance 数据集规模极其可观:涵盖 204,025 个交互片段,产出了 578 万张视觉交互热力图以及超过 1160 万个高精度的抓握姿态与 3D 轨迹序列,成为当前机器人操作领域最为完备的可操作表征库。
统一架构设计:让 VLM 自主串联视觉、姿态与轨迹
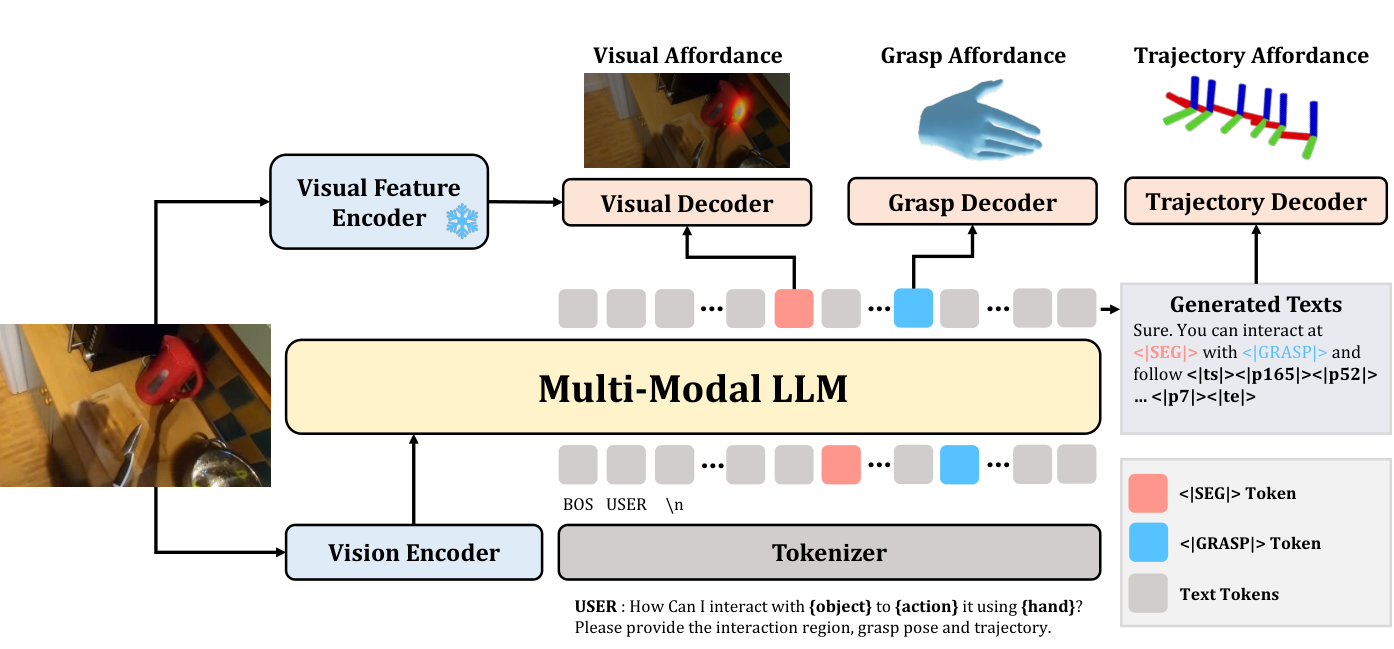
在模型架构层面,VLAff 巧妙地规避了为不同模态设计分离模型的臃肿方案,而是基于开源表现优异的 Qwen2.5-VL 构建端到端的统一大模型,如图 2 所示。
尽管多模态大语言模型具备极强的语义关联和常识推理能力,但在纯粹的密集像素级定位(Dense Visual Grounding)上往往欠缺底层空间高频细节。为了弥补这一短板,研究人员引入了 DINOv2 作为辅助的密集视觉特征提取器。主干网络 Qwen2.5-VL 负责消化图像全局语义与自然语言操作指令,而 DINOv2 则输出富含部件级语义的高分辨率空间特征。
为了在离散的自回归生成框架下优雅地输出不同模态的连续物理量,VLAff 引入了一套特殊的标记符号(Special Tokens):
-
交互区域预测:在输入序列中嵌入
<SEG>标记,语言模型输出的对应隐藏层向量与 DINOv2 的细粒度特征图进行多尺度融合,经由上采样解码器生成连续的二维交互热力图 $\mathbf{A}_{v} \in \mathbb{R}^{H \times W}$。训练时采用软 Dice 损失函数(Soft Dice Loss),以应对接触点在整张图像中极度稀疏的问题。 -
三维抓握预测:通过
<GRASP>标记提取隐藏状态,输入抓握解码器,直接回归 96 维的 MANO 手部参数 $\mathbf{A}_{g}$(涵盖手腕全局旋转与 15 个手指关节的 6D 旋转表示),使用 Smooth L1 损失监督。 -
连续运动轨迹预测:轨迹预测被转化为自回归生成任务。连续的 6D 轨迹位姿被离散化映射为特定的轨迹标记序列 $\texttt{<p*>}$,模型基于当前的视觉观察、任务指令以及先前生成的路径步长,自回归地预测下一个轨迹点,损失函数直接对齐大语言模型的交叉熵目标。
在坐标转换机制上,VLAff 展现出极为扎实的机器人学考量:模型从预测的二维热力图峰值中提取接触点,结合场景深度图反投影得到真实的三维接触锚点(3D Anchor Point)。随后,预测出的抓握手势与后续轨迹被刚体变换直接对齐到以该锚点为中心的原点坐标系中。这种以物体接触点为中心(Object-centric)的建模,切断了环境绝对坐标的干扰,让轨迹特征具备了真正的可迁移性。
引导与剪枝:如何防止大模型在 3D 空间“胡乱划线”?
仅从单张 2D 图像和文字去推导三维连续轨迹,天然面临严重的深度歧义性与碰撞风险。为了保证生成的轨迹在物理空间中真实可行,作者在推理阶段引入了两套轻量却行之有效的采样策略。
其一是上下文轨迹常识引导(In-Context Trajectory Guidance)。很多任务的高层物理意图是高度清晰的,例如“拉开抽屉”必然伴随着朝相机方向拉出的分量,而“推门”则一定是向前推移。研究利用高性能 VLM 作为高层规划器,解析任务指令后输出一个标准的三维方向意向向量 $[d_x, d_y, d_z] \in {-1, 0, 1}^3$。这个先验向量仅用于调制轨迹的第一个预测点(Waypoint),通过将其作为高斯采样的均值偏置,约束轨迹起步时的探索方向,避免动作一开始就背离任务常理。
其二是基于物理碰撞的核采样筛选(Sampling-Based Trajectory Selection)。在具体生成轨迹时,模型利用核采样(Nucleus Sampling)并行生成 $K$ 条候选轨迹。系统利用深度图将当前观察场景实时体素化(Voxelization),将生成的轨迹与体素障碍物进行碰撞检测计算。随后,综合轨迹的无碰撞得分与高层运动方向一致性指标,自动选出最优且物理可行的一条轨迹直接输出给机器人控制器。
实验评测:不仅刷新基准,更能直接驱动真机
对 VLAff 的评估分为了三个层层递进的维度:基础表征预测精度、真实物理环境中的零样本闭环迁移、以及作为强化学习先验的学习效率。
在视觉交互区域预测评测中,VLAff 与当前主流的具身基准模型 VRB、UAD、3DOI 以及通用大模型分割方案 LISA 展开了系统对比。如表 2 所示,VLAff 在交并比(IoU)、归一化扫描路径显著性(NSS)、分布相似度(SIM)以及 KL 散度等全套指标上均取得了大幅领先。
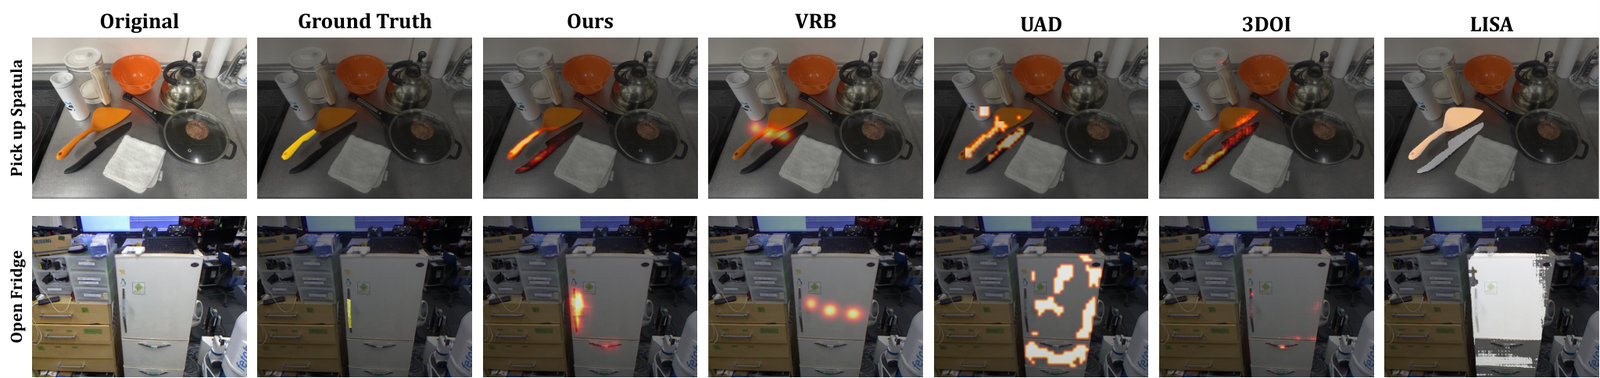
定性可视化的差异更加直观(图 3)。通用大模型 LISA 倾向于框选整个物体的语义主体,例如在“开微波炉”任务中它会分割出整扇门,却无法指明哪里是拉手;VRB 则往往给出离散模糊的点状响应;而 VLAff 能够精准勾勒出抽屉拉手、水龙头把手、锅盖顶钮等细粒度可交互边缘。作者将这一质的飞跃归功于两点:DINOv2 对物体物理边缘的感知补充,以及三模态联合训练过程中轨迹与抓握目标对视觉区域反向施加的几何约束。
在零样本操控实验中,研究团队将预测出的 3D 接触点与轨迹直接转换为笛卡尔阻抗控制指令,部署在 Fetch 和 PR2 两款形态完全不同的真实移动操作机器人上,测试涵盖拉开抽屉、提起水桶、掀开锅盖、拿取平底锅、拿起水壶等 5 类真实厨房任务(图 4)。
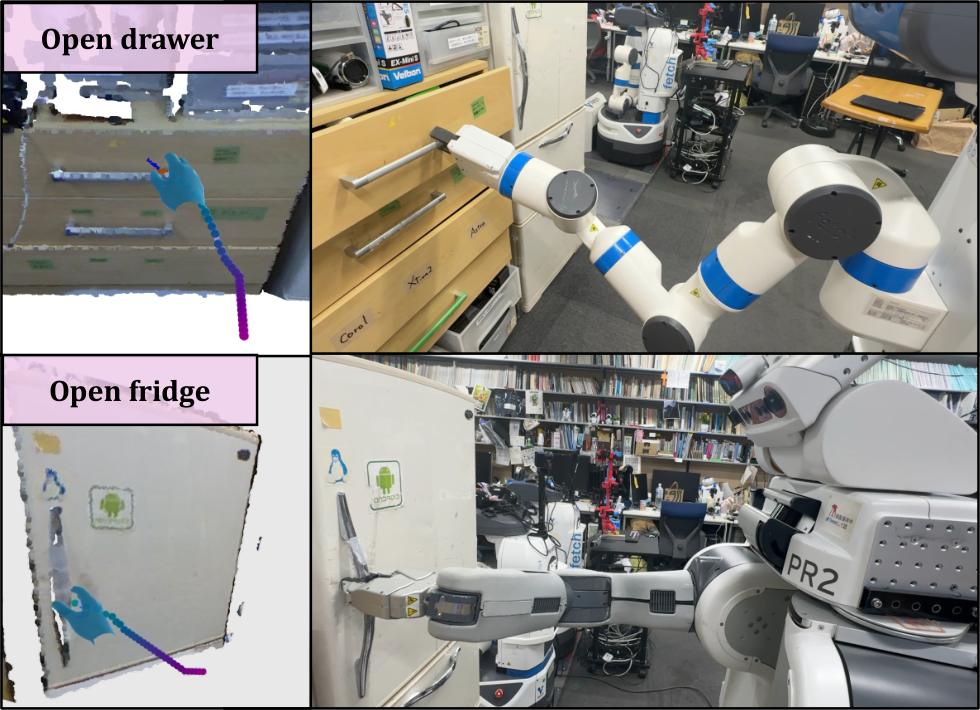
实验结果表明,在没有任何针对特定机械臂逆运动学或强化微调的前提下,VLAff 生成的操作姿态与轨迹可以直接驱动物理机械臂完成复杂的铰接物体(Articulated Objects)操作,其成功率明显优于单纯依靠检索策略的 RAM 或纯 2D 轨迹映射方案。
剥离研究的残酷启示:什么对机器人真正致命?
在真实物理环境中部署模型,不可避免地会遇到环境扰动与未建模误差。为了检验模型能否作为更高级策略学习的骨架,研究人员进一步在真实世界进行了基于强化学习的微调实验(Affordance-Guided Manipulation Learning),并在真实的“开冰箱门”任务上设计了一组极具启发性的消融实验。
强化学习的奖励函数由两部分构成:高层由 VLM 判定任务是否最终达成的稀疏奖励,底层则由 VLAff 预测的接触点与 3D 轨迹构成稠密的引导奖励。研究人员对比了完整模态引导与逐一剔除某一模态后的策略收敛曲线。
实验得出了两个至关重要的判断:
-
视觉交互热力图是绝对的生命线。当从奖励中剥离视觉交互热力图(Visual Heatmap)时,机器人在成百上千次的交互尝试中彻底陷入停滞,任务成功率直接归零。这证明了在开放环境操控中,“找到物理交互的切入点”是最根本的前提,一旦初始落点偏离,后续的轨迹与姿态全部沦为空谈。
-
人类抓握姿态的直接指导价值极其有限。消融实验中令人意外地发现,移除 MANO 手部抓握姿态后,强化学习的收敛速度和最终成功率几乎没有受到显著影响。作者对此给出了非常客观的技术洞察:人类灵巧手的高自由度多指协同,与工业机械臂常用的两指平口夹爪存在本质的形态割裂。人类视频中精巧的指尖捏合、掌心包裹动作,很难甚至不应该强行映射到二指夹爪上。
这一发现非常明确地厘清了未来从人类视频学习机器人技能的研究边界:从视频中提取“接触锚点”与“末端时空轨迹”具有高度的几何通识性,是极具价值的通用中介;而过分沉迷于将人手各关节的角度生搬硬套给机械爪,往往是在解决一个并不成立的伪命题。
局限性与具身大模型的演进路径
VLAff 成功验证了一条从低成本人类视频通往高泛化机器人操作的可行路径。将操作引导特征拆解为“何处、何姿、何迹”,不仅让大语言模型得以发挥其常识规划的长处,更借由 3D 空间变换跨越了人机具身隔阂。
当然,该框架仍存在不可忽视的物理局限:由于轨迹生成依然高度依赖 2D 图像特征的单目投影,在极端光照或严重遮挡场景下,偶发性生成的 3D 轨迹仍可能出现穿透物体或违背刚体运动学的瑕疵。作者在文末坦言,未来真正的突破口在于让模型主干网络直接演进为原生具备 3D 空间感知的几何大模型,使预测的轨迹不仅能够顺应语言语义,更能自主在三维点云构筑的物理场中避障与贴合。无论如何,VLAff 展示出的跨模态对齐思路,无疑为填补人类互联网视频数据与通用物理操作之间的鸿沟,提供了一块极其厚实的基石。