VulAgentRL:以代码图为验证器,7B模型跨过程漏洞检测超越Opus
Graph Is the Verifier: Agentic Reinforcement Learning for Interprocedural Vulnerability Detection
在软件安全领域,利用大语言模型(LLM)进行代码漏洞挖掘正面临一个尴尬的现实瓶颈:绝大多数学术基准和检测模型都将任务简化为“单函数分类”,即把一段独立的代码片段塞给模型,让其判断是否存在漏洞。然而,真实世界中的代码缺陷往往并非孤立存在。最新统计表明,在真实 CVE 样本中,高达 71.7% 的易受攻击函数必须结合函数外部的上下文(如调用方、被调用方或跨过程的数据流)才能做出准确判断。当漏洞的触发条件、校验逻辑和危险操作散落在不同文件和过程之间时,孤立的函数检测注定漏洞百出。
ArXiv URL:https://arxiv.org/abs/2607.26656v1
为了打破这一僵局,来自新加坡政府技术局(GovTech)、哈尔滨工业大学与新加坡管理大学的研究团队提出了 VulAgentRL。该框架没有盲目依赖更长的上下文窗口去粗暴内联调用图,而是将漏洞挖掘形式化为一个具备主动工具探索能力的智能体强化学习任务。VulAgentRL 的核心突破在于巧妙利用了代码属性图(Code Property Graph, CPG):CPG 在推理阶段充当智能体按需查询调用关系与数据流的工具,在训练阶段则充当校验智能体取证逻辑的“确定性验证器”。
在防止代码泄漏的严格仓库级数据集划分下,基于 7B 开源模型构建的 VulAgentRL 在最严苛的成对判定指标(Pair-wise Correct)上达到了 0.378,不仅大幅领先已有的漏洞挖掘智能体 JitVul 高达 32.7 个百分点,还击败了 Claude Opus 4.7 等闭源前沿巨型模型,同时将平均工具调用轮数从 7.6 次压缩至 4.3 次。这项工作揭示了一个重要趋势:在大模型代码推理任务中,将底层静态分析构建的确定性符号图谱作为强化学习的验证裁判,是防止智能体在长链路探索中产生幻觉与偷懒退化的有效路径。
单函数检测的局限与强化学习的退化陷阱
传统的静态分析工具(如 CodeQL 或 Joern)依靠专家手工编写跨过程污点追踪规则,尽管逻辑严密,但在面对复杂多变的现实代码库时规则覆盖率低下、维护代价极高。近年来兴起的深度学习与大模型检测器虽然泛化能力更强,却大多画地为牢,将注意力局限在单函数内部。
研究团队通过前沿模型对真实漏洞样本进行系统性人工与模型联合审计,发现 71.7% 的易受攻击函数必须依赖外部证据才能定性。在这些跨过程案例中,决定漏洞是否能够被触发的证据分布相当分散:60% 潜藏在被调用函数(Callee)的具体实现中,19% 存在于调用方(Caller)的输入校验与分支逻辑中,8% 涉及跨过程的数据流前驱,还有 13% 依赖外部宏定义、结构体定义或全局常量。例如,在 PJSIP 开源库的 CVE-2022-21723 越界读取漏洞中,目标函数在表面上看仅仅是极其常规的字符读取操作,但在跨过程链路上,调用方在解析异常的多段请求时越过了缓冲区边界,而缓冲区的实际长度定义在外部结构体内部。单看该函数本身,神仙也无法推断出存在安全隐患。
如果简单地把整个代码库的调用图和外部代码一股脑塞进上下文窗口,不仅会迅速击穿模型的注意力机制,还会带来严重的噪声干扰。一个自然的替代方案是将大模型武装成能够主动调工具查代码的智能体(Agent),让其自主游走代码库,并使用强化学习(RL)进行端到端优化。
然而,在漏洞检测场景下训练智能体存在严重的“奖励机制退化”难题。传统的强化学习往往依赖最终结果(Outcome-only)作为奖励信号,即只要最终猜对了“安全”或“有漏洞”,模型就能获得正向反馈。这种粗糙的反馈在二分类安全任务中极度危险:模型很快就会学会“投机取巧”,在没有任何取证操作的情况下直接利用类别先验进行无脑预测,甚至在脆弱版本和修复版本上通通盲猜“有漏洞”,从而骗取整体召回率。研究表明,仅依靠最终判定正确与否训练的策略,在成对测试样本中会将 31.7% 的修复后安全代码依然标注为脆弱代码。如果换用 LLM-as-a-judge 作为过程裁判,又会因裁判自身能力不足而引入巨大噪声;使用纯文本匹配来检查证据链,则会因为变量重命名、代码格式差异而频繁误判。缺乏一个能够客观、精确核验“证据是否充分”的裁判,是此前智能体强化学习无法在漏洞挖掘领域落地的关键症结。
CPG 的双重角色:既是探索工具,又是确定性裁判
VulAgentRL 的破局思路,是利用一次性生成的代码属性图(CPG)统摄推理与训练两端。代码属性图将抽象语法树(AST)、控制流图(CFG)和程序依赖图(PDG)融为一体,为整个工程的代码结构建立了带有明确语义的拓扑网络。在 VulAgentRL 的架构中,同一个 CPG 扮演了两个截然不同但互相闭环的角色。
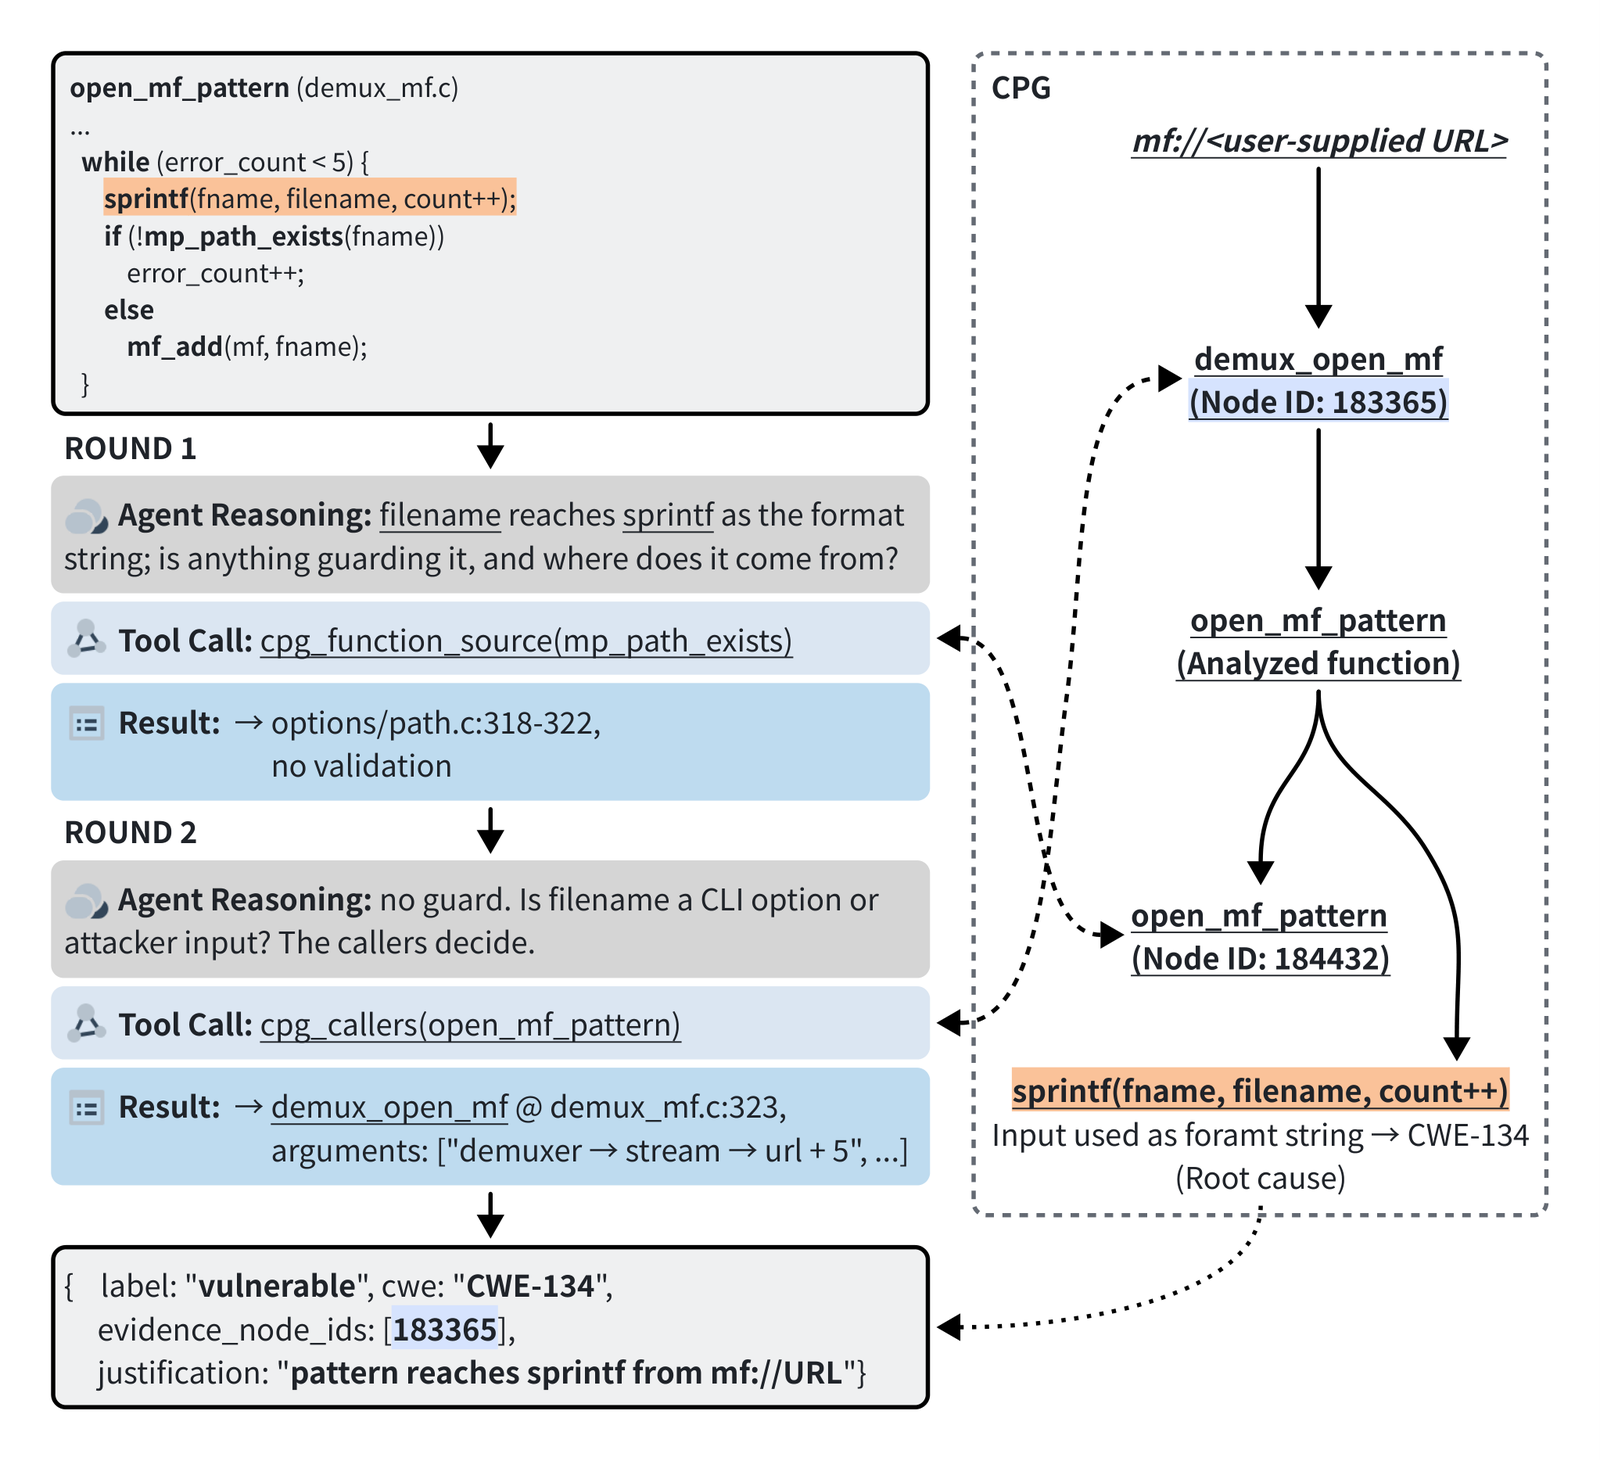
在推理阶段,CPG 是智能体探索外部世界的交互式工具。智能体面对初始函数时,不需要被动接收海量上下文,而是通过调用预设的类型化查询接口,按需向 CPG 发送查询请求。智能体可以沿着调用图向上探查所有调用当前函数的代码(Callers),向下查看被当前函数调用的具体实现(Callees),或者沿着程序依赖图追溯特定污点参数的完整数据流动路径。CPG 每次返回给模型的不是庞杂的代码文件,而是经过裁剪的结构化子图与精简节点代码。这使得模型能够像资深安全研究员一样,先观察危险汇聚点(Sink),再有针对性地逆向追踪输入源(Source)与过滤逻辑(Sanitizer)。
在训练阶段,CPG 摇身一变,成为无法被作弊的硬核验证器。在图生成阶段,Joern 会为代码属性图中的每一个程序实体(语句、变量、表达式等)赋予一个全局唯一且持久的整型节点标识符(Node ID)。当模型完成多轮调查输出检测报告时,除了必须给出最终的判定标签和 CWE 类型编号外,还必须显式引用支撑其结论的 CPG 节点 ID 集合。
由于节点 ID 具备确定性的物理意义,环境在核验模型引用的证据时,不再需要使用模糊且脆弱的大模型自然语言裁判,也不需要进行容错率极低的字符串正则匹配,而是直接在底层 CPG 图结构中进行精确的数学集合比对。这种将“语义理解”降维到“节点集合重合度计算”的设计,让强化学习算法获得了高信噪比的监督信号,彻底切断了模型不调工具凭空瞎猜的退化路径。
两阶段流水线:从线索引导蒸馏到强化学习飞跃
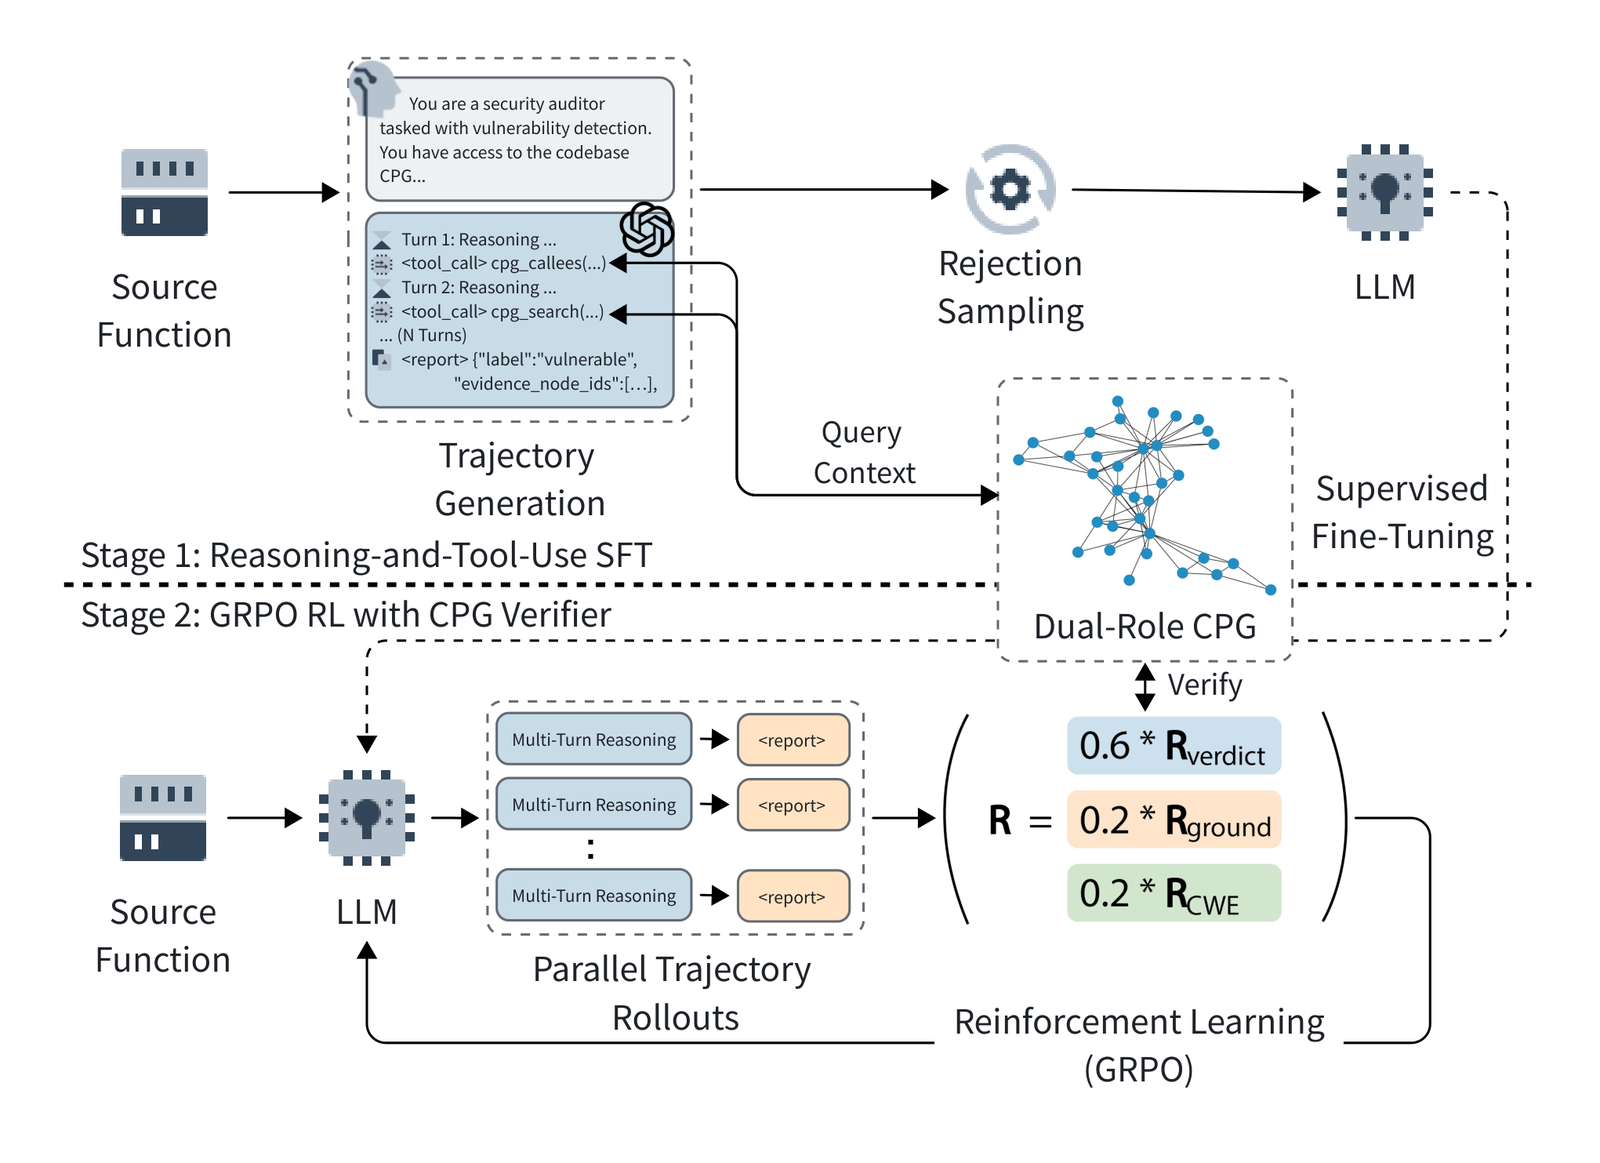
直接从零初始化一个智能体并对其进行交互式强化学习是不可行的。如果基础模型从来没有成功调用过图查询工具并收集到有效路径,强化学习算法在庞大的探索空间中就根本无法采样到高奖励轨迹,整个训练过程会在冷启动阶段直接崩溃。为此,VulAgentRL 采取了严格的两阶段流水线策略:第一阶段实施带线索引导的教师轨迹蒸馏(SFT),第二阶段使用 CPG 验证器运行基于组相对策略优化(GRPO)的强化学习微调。
在第一阶段,研究人员引入了能力强大的前沿模型(Claude Opus 4.7)作为教师,在相同的 CPG 工具环境下生成多轮交互轨迹。为了保证轨迹的探索质量,团队制定了严格契合人类安全审计流程的协议:先检查危险 API,提出潜在威胁假设,通过 CPG 工具检索上下游证据,主动发起反证查询以证伪假设,最后输出结构化报告。
在此过程中,如果给教师展示完整的 CVE 说明,教师往往会偷懒并写出“事后诸葛亮”式的虚假推理轨迹;如果完全不给教师任何信息,教师在有限轮次内又极难命中深层漏洞。为此,VulAgentRL 提出了“线索引导探索”(Hint-Guided Exploration):仅在易受攻击的样本上向教师提供 CWE 类型标识(例如 CWE-22 路径穿越),不提供具体位置、修复代码或任何描述信息;而在安全样本上完全不给任何线索。教师必须自行在 CPG 中找出可利用路径。更重要的是,在将教师轨迹用于学生模型训练之前,研究团队会重构训练 Prompt,彻底抹除这行 CWE 提示,使得学生模型在微调与评测时面对完全相同的零线索输入,从机制上根除了标签泄漏的可能。
此外,教师的输出同样充斥着失误。研究团队设立了双层拒绝采样(Rejection Sampling)机制对轨迹进行严格清洗:
-
格式与判定过滤:剔除任何格式不符合规范、JSON 无法解析或最终漏洞判定与真实标签不符的轨迹。
-
证据节点有效性过滤:对模型声称的证据进行图拓扑核查,必须保证轨迹中引用的每一个节点 ID 都在当前 CPG 中真实存在,且必须位于修复函数周围的两度跳跃(Two-hop)邻域内。
任何虽然误打误撞猜对了漏洞标签、但引用的证据节点存在幻觉或毫不相干的轨迹,都会被无情丢弃。经过清洗的高质量轨迹被用于对开源基座模型 Qwen2.5-Coder-7B-Instruct 进行有监督微调,使其彻底掌握规范的“先查询后报告”范式,形成能够稳定与 CPG 交互的热启动策略。
规则驱动的复合奖励与策略优化
在第二阶段,策略模型脱离教师的直接模仿,进入强化学习自主演化。仅仅依靠 SFT 只能让模型模仿教师的调查习惯,无法促使模型精简无效查询,更无法纠正教师固有的偏见。VulAgentRL 采用 GRPO(Group Relative Policy Optimization)算法,在不需要单独训练判别器(Critic)网络的前提下,通过组内样本相对优势来更新策略。
针对漏洞挖掘的特殊性,奖励函数被设计为完全格式门控且纯粹基于规则计算的复合奖励体系。设模型生成的预测报告为 $Y=\langle \ell, c, \mathcal{E} \rangle$,对应真实标签为 $\langle \ell^, c^, \mathcal{E}^* \rangle$。奖励由三个互补的部分加权求和构成:
\[R = 0.6\,R_{\text{verdict}} + 0.2\,R_{\text{ground}} + 0.2\,R_{\text{cwe}}\]各项具体定义体现了极其明确的工程考量:
第一项是判定准确性 $R_{\text{verdict}}$。这是一个二值指示变量,仅当模型给出的漏洞/安全判定 $\ell$ 与真实情况 $\ell^*$ 一致时为 1,否则为 0。在复合公式中,判定占据了 0.6 的统治性权重。这意味着,哪怕一个模型引用的证据节点全部命中、CWE 预测完全匹配,但如果把有漏洞错判为安全,其最高得分也只有 0.4,依然低于仅猜对判定但缺乏证据的 0.6。该设计确保了梯度优化的主推力永远锚定在最终判定的正确性上。
第二项是证据锚定奖励 $R_{\text{ground}}$。这是模型引用的证据节点集合 $S_{\text{pred}} = \mathcal{E}$ 与教师标注的标准节点集合 $S_{\text{gt}} = \mathcal{E}^*$ 之间的 $F_1$ 重合度:
\[P = \frac{\lvert S_{\text{pred}} \cap S_{\text{gt}} \rvert}{\lvert S_{\text{pred}} \rvert},\quad R_{\text{recall}} = \frac{\lvert S_{\text{pred}} \cap S_{\text{gt}} \rvert}{\lvert S_{\text{gt}} \rvert},\quad R_{\text{ground}} = \frac{2 P R_{\text{recall}}}{P + R_{\text{recall}}}\]引入精确率 $P$ 进行约束至关重要,它能防止模型通过在最终报告中疯狂罗列成百上千个无关节点 ID 来刷取高召回率。模型必须克制且精确地定位核心代码节点,才能获得满额奖励。
第三项是 CWE 匹配奖励 $R_{\text{cwe}}$。该项仅在真实样本和预测样本均标记为“有漏洞”时激活。若模型精准命中了 CWE 编号,给予 1.0 的满分;若模型预测的类别处于 CWE-1000 层次分类体系中真实标签的直接父节点或子节点(例如将父类 CWE-119 内存越界与子类 CWE-787 越界写入互认),则给予 0.5 的部分学分;距离更远的亲戚分类则给 0 分。这为智能体在复杂安全漏洞分类的层级模糊带提供了细粒度的平滑指引。
通过将这套无需神经网络判别的硬性规则嵌入 GRPO,每一次组内采样都会在代码属性图上完成一次节点校验,使得模型在持续的试错过程中,逐步学会为了拿到证据分而必须发起有效的 CPG 工具调用,同时为了避免在成对样本中踩坑而主动发起证伪查询。
实验评测与多维泛化验证
为了彻底杜绝在深度学习评测中屡见不鲜的数据穿越问题,研究团队在 PrimeVul 基准数据集上严格执行了“仓库级(Repository-level)”划分,训练集、验证集和测试集之间的代码仓库互不交叉。更进一步,研究人员还对补丁提交进行了去重:当一次安全修复提交同时涉及多个函数时,仅保留其中一个,避免兄弟函数共享相同的上下文、CWE 分类和根因逻辑所带来的隐形泄漏。测试基准采用严苛的成对判定正确率(Pair-wise-Correct, P-C)作为主要衡量指标,即模型必须对同一个函数的脆弱版本和修复版本均作出完全正确的判定,才计为成功。这一指标从根本上消灭了通过狂猜“有漏洞”来虚增单点性能的作弊手段。
实验结果表明,VulAgentRL 展现出了惊人的判别水准。在主测试集上,VulAgentRL 的 P-C 指标达到了 0.378,综合准确率达到了 0.633。相比之下,参数量庞大的闭源前沿模型 Claude Opus 4.7 的 P-C 仅为 0.273,GPT-5.5 同样处于劣势。在面对同类智能体基准时,VulAgentRL 的优势更为明显:即使是同样具备调用/被调用图检索工具的最先进智能体 JitVul,其 P-C 得分也落后 VulAgentRL 整整 32.7 个百分点。JitVul 虽有工具但缺乏经过确定性节点图谱强化的证据链检验机制,导致其在强化学习或推理探索过程中容易被非核心信息带偏,这一对比清晰地确立了“CPG 不仅是工具,更是强力验证器”的技术价值。
更为可贵的是智能体探索效率的质变。相较于仅完成第一阶段蒸馏的 SFT 基线模型,经历了 GRPO 强化学习后的 VulAgentRL 不仅在 P-C 指标上大幅跃升了 11.4 个百分点,其单次决策平均发起的 CPG 工具调用次数反而从 7.6 次骤降到了 4.3 次。这证明强化学习并没有让模型陷入盲目扩大搜索范围的蛮力穷举,而是学会了更加敏锐、聚焦且致命的取证路径,剔除了大量与安全属性无关的无效分支探索。
在现实工业场景中,代码库往往充斥着海量的正常代码,安全漏洞通常处于极其严重的类别不平衡状态(严重偏向良性)。研究人员通过人工调整脆弱与良性样本的比例,在 1:2 到 1:16 的多档极端分布下对模型进行了压力测试。在 1:8 的极度倾斜环境下,常规模型的精确率和 F1 得分均出现大幅跳水,而 VulAgentRL 依然保持了 0.275 的 F1 表现,明显高于 SFT 模型的 0.197。此外,为了测试模型在面对陌生代码体系时的泛化能力,团队还构建了完全脱离训练生态的全新分布外(OOD)测试集 TitanVulOOD(涵盖 217 个从未在训练阶段出现过的全新 C/C++ 仓库)。在该集合上,VulAgentRL 同样保持了显著的领先态势,证明其学到的是真正的程序依赖审计逻辑,而非对特定仓库编码风格的机械记忆。
总结与技术启示
VulAgentRL 的成功为大模型时代下的软件工程与安全分析提供了一个兼具学术美感与实用价值的范式参考。长期以来,学术界一直在“纯符号化的静态分析”与“黑盒统计学的大模型分类”之间来回摆动,前者精准但僵硬脆弱,后者灵活但幻觉丛生且缺乏证据链。
这项工作给出的破局公式是:让静态分析退居幕后,将其沉淀下来的图数据结构(CPG)同时转化为大模型的双手(交互工具)和缰绳(强化学习验证器)。借助节点 ID 的底层拓扑一致性,不仅避开了大模型自然语言裁判的虚幻不确定性,更逼迫智能体在多轮探索中建立起严密的证据意识。从工程实施角度看,基于 7B 级别的小型开源代码模型,辅以结构化图谱的双重闭环驱动,完全有潜力在特定专业垂直领域击败千亿参数级的前沿通用闭源大模型,并以更低廉的推理调用成本在实际 DevSecOps 流水线中实现真正可用、可信的跨过程深度漏洞挖掘。