Latent Critic:将隐层不确定性翻译为精准批评,AUROC达0.966且延迟不足10ms
Actionable Hallucination Detection: Translating Latent Uncertainty into Agentic Critique
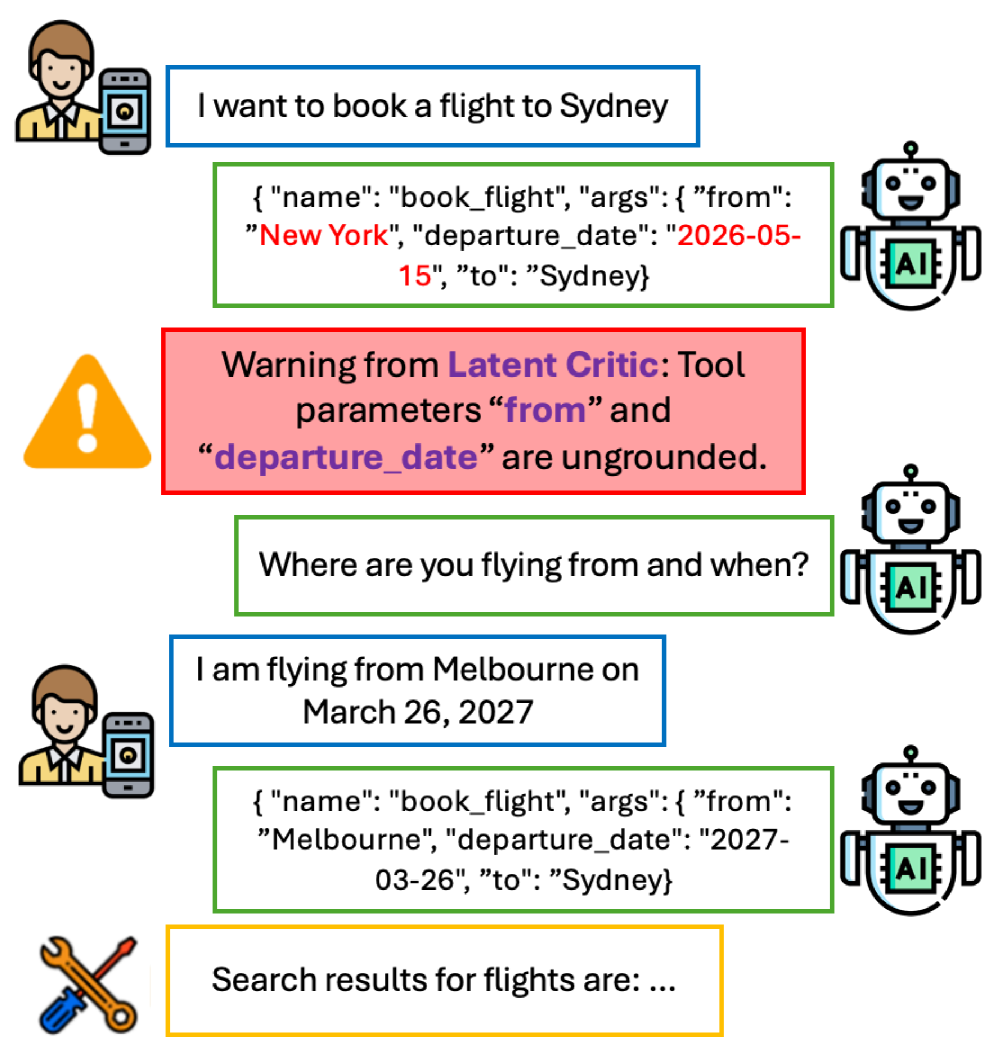
在大模型驱动的自主智能体(Agent)工作流中,一个普遍且棘手的现象是“过度自信的盲目执行”。当用户给出的提示词存在缺漏或歧义时,理想的交互模式应当是智能体主动停下、承认不确定性并向用户寻求澄清。然而,受指令微调机制与自回归下一个 Token 预测(Next-token prediction)的天然驱动,模型往往自带强烈的“任务完成偏置(Task-completion bias)”。在调用外部工具时,即便用户根本没有指定某个关键参数,模型也会自信地虚构出一个看似合规的值并直接触发调用。这种不符合用户上下文支撑的行为,被称为“规范锚定失败”(Specification-grounding failures)。
ArXiv URL:https://arxiv.org/abs/2608.10430v1
传统的防御手段陷入了两难境地:若引入外部大模型作为裁判(LLM-as-a-judge)或依赖多次采样的语义熵(Semantic Entropy),动辄数十秒的串行推理延迟会彻底摧毁 Agent 的实时交互性,且因为模型自身对虚构参数常常极度确信,输出概率往往展现出虚假的低熵;若采用传统的内部探测(Probing),往往只能从特定隐藏层提取出一个冷冰冰的标量置信度分数,既无法告知具体哪个字段出错,也无法提供可供模型自我修正的局部诊断信息。
针对这一核心痛点,Samsung Research America 的研究团队提出了 Latent Critic 架构。该方案并没有引入庞大的外部检查模型,而是通过一个与冻结基座模型并行推理的轻量级低秩适配器(LoRA),在同一个前向序列中主动重构 Transformer 的残差流(Residual stream)。它直接从模型的内部表征中捕获潜在的不确定性信号,并将其在线翻译为细粒度的自然语言批评(如“ungrounded: date”)。在工具调用的评测中,该方法实现了高达 0.966 的 AUROC 与超过 80% 的字段定位准确率,在 vLLM 推理框架下引入的额外延迟小于 10 毫秒,首次在几乎不牺牲推理速度的前提下,打通了从底层机制表征到闭环动作阻断与自修复的完整链路。
为何表面概率会骗人:规范锚定的失真本质
要理解 Latent Critic 的设计机理,首先必须厘清规范锚定失败与一般事实性幻觉(Factual hallucinations)的差异。在通识问答场景下,幻觉通常依据现实世界的客观真理来裁定;但在 Agent 工具调用的语境中,锚定评判的标准完全受制于当前对话的历史上下文。例如,用户要求“帮我给团队发一封邮件汇报进度”,模型生成了一个符合语法的调用指令,并在邮件主题与时间参数中填入了具体日期。这个日期在逻辑上或许完全成立,但在上下文对话中用户从未明确或隐含提及。一旦该动作被执行,就会对外部数字环境造成不可逆的错误变更。
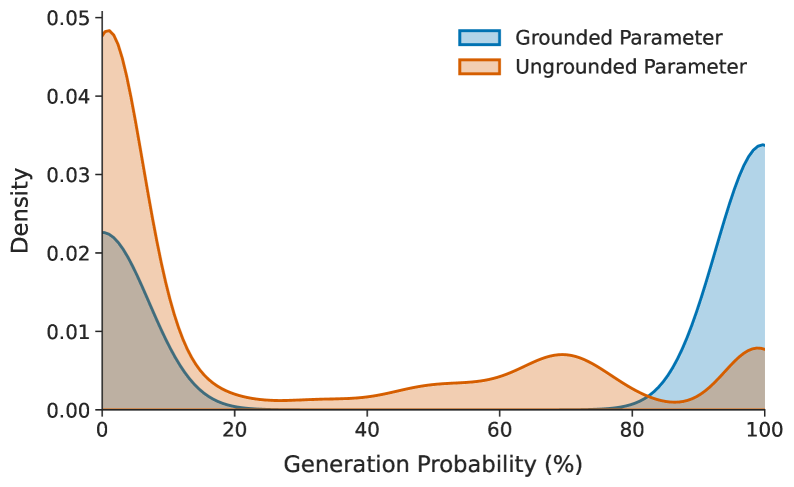
研究人员在实验中深入分析了基座模型的 Token 输出概率分布。如图 3a 所示,基座模型在生成虚构参数与生成有效受托参数时,两者的 Token 概率密度函数出现了严重的重叠。受到对齐训练带来的任务强迫感影响,模型经常以超过 80% 的高置信度输出完全由其脑补出的虚构参数。换句话说,模型在输出层的 Softmax 概率分布上展现出严重的失准(Miscalibration)。依靠采样输出文本熵或设定 Logit 阈值的方法,根本无法将这些虚构动作稳定切分出来。
然而,表面的狂妄掩盖不了底层的犹疑。表征工程(Representation Engineering)的先验研究已经表明,Transformer 的隐藏状态中隐蔽地编码了模型自身对事实真伪与认知不确定性的几何特征。虽然这一信号在经历最终的无约束线性投射与解包生成时被抹平,但它确实存在于残差流之中。问题的关键转变为:如何在不打断生成、不大幅增加计算量的前提下,将深藏在几何空间里的不确定性提取出来,并直接转化成可以执行的文本动作。
架构设计:与生成并行的残差流几何重构
Latent Critic 的核心在于它巧妙地利用了多适配器并行服务(Multi-adapter serving)机制。在 Agent 执行工具调用的过程中,底层的骨干基座模型保持完全冻结,负责自回归地输出工具调用的语法结构与参数键值对。而挂载在其上的 Latent Critic 适配器与基座模型共享输入 Token,在底层残差流上同步推进计算。
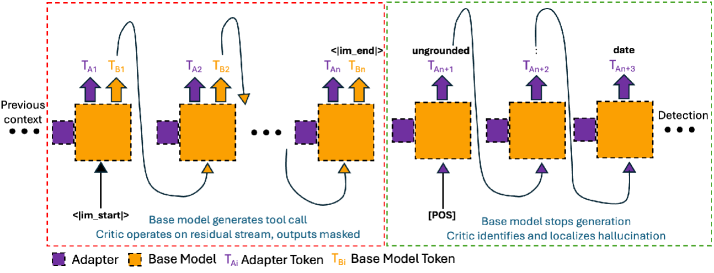
由于适配器在初始化阶段的低秩矩阵权重接近于零,其初始状态与基座模型完全一致。在训练阶段,研究团队设计了一种带掩码的诊断目标(Masked diagnostic objective)。在基座模型完整生成工具调用语法后,系统会附加一个专用的触发标记 $[POS]$。此时,Critic 适配器接管上下文隐藏层,利用已在前向传播中积累和放大的不确定性特征,自回归地解码出具体的诊断结论——直接输出分类标签(如 $ok$、$wrong_tool$ 或 $ungrounded$)并在发生错误时精准打印出未被用户锚定的具体参数名称(如 $date$)。
这种设计的精妙之处在于“单一序列内的端到端闭环”。传统的检测往往需要完整生成动作后,将整个文本重新组装为一个 Prompt 喂给另一台审判模型,形成二次推理循环;而 Latent Critic 随骨干模型的生成过程自然积累激活状态,在同一个计算图的末尾仅耗费几个额外 Token 的解码成本,就完成了从表征检测到诊断文本输出的全部跨越。
机理拆解:不确定性几何在何时、以何种形式产生?
为了验证 Latent Critic 究竟是学到了通用的不确定性几何特征,还是仅仅记住了训练集中的特定关键词,研究人员围绕 Qwen3-4B 模型展开了一系列细致的机械可解释性(Mechanistic Interpretability)分析。
首先是不确定性信号涌现的时间窗口。研究人员在工具调用生成的四个不同阶段插入触发标记 $[POS]$:调用生成之前、选定工具名称之后、生成虚构参数键的瞬间,以及整个负载生成完毕之后。实验结果(图 3b)表明,Critic 的判别置信度呈现出明显的反应性(Reactive)而非预知性(Prescient):在模型刚刚选定工具名称时,内部几乎检测不到任何异常;只有当模型真正吐出那个凭空虚构的参数键名时,分类置信度才会产生陡峭跃升。这证明内部不确定性并非模型在规划任务之初就已形成的全局偏见,而是在自回归逐步推进至缺失信息节点时被即时激发的。
其次是低秩变换对残差流空间的几何重构效应。基座模型原始隐藏状态对未锚定参数虽然具备微弱的线性可分性,但这种表征非常脆弱,一旦面对未见过的分布偏移(OOD),探测器的 AUROC 会直接断崖式下滑至 0.616。而挂载了 Latent Critic 之后,模型深层表征的分离度发生了质的飞跃。如图 3c 所示,在浅层的句法处理阶段(第 0 至 14 层),适配器的隐藏表征与基座模型几乎无法区分;而一旦进入第 15 层之后,表征的线性可分度急剧拉升。尤为关键的是,这种几何变换展现出“秩不变量”(Rank-invariant)特性:即便是极端瓶颈配置下的低秩微调(如 $r=4$),也能几乎等效地完成对残差流空间的重构。这表明规范锚定失败的几何信号实际上集中在一个极低维的子空间内,适配器所需做的并不是重新学习复杂的语义逻辑,而是像一个透镜一样,通过极低秩的投射矩阵将原本缠绕的隐层不确定性沿正交方向有效放大。
更具说服力的是跨轨迹的因果激活修补(Activation Patching)实验。研究团队将一个包含了未锚定虚构参数的错误轨迹中的激活隐藏状态缓存下来,随后将它逐层替换到一个完全正确、已充分锚定的规范轨迹的末尾触发标记 $[POS]$ 上。值得注意的是,此时输入给模型的上下文环境与前面生成的全部 Token 完全是合规且正确的。然而,如图 3d 所示,随着替换层数的逐步深入,曲线呈现出鲜明的 S 型跃升:在第 0 至 20 层实施修补对输出几乎没有扰动,而一旦在第 21 层之后、特别是在第 32 层对隐藏状态实施覆盖,即使表面文本无可挑剔,Latent Critic 也有高达 96% 的概率强行翻转判定结果,直接输出“ungrounded”。这一因果证据直接证实了 Critic 的行为完全受残差流晚期几何特征的驱动,而彻底摆脱了对表面文本符号的单纯依赖。
评测对决:零样本诊断与极低延迟守门
在判别性能与跨模型泛化性测试中,研究人员将 Latent Critic 与相同参数规模的微调外部裁判模型(External Judge)、基于基座模型最佳中间层训练的线性探测器(Linear Probe),以及语义熵等无监督采样方法进行了横向对比。实验覆盖了 Qwen3-4B 与面向工具调用专门优化的 Llama-xLAM-2-8B 两大基座模型。
从检测效果来看,传统的熵采样方法与单一中间层的线性探测器表现均不尽如人意。线性探测器因无法动态调整残差流流向,在分布迁移时泛化性能严重崩溃;外部裁判模型虽然具备文本生成能力,但在面对与训练数据分布不同的复杂参数调用时,由于无法接触生成时刻的隐层表征,漏判率依然居高不下。Latent Critic 则凭借重构后的高可分空间,在分布内与分布外均保持了绝对领先。其不仅在两款基座模型上统一刷新了判别指标,取得了高达 0.966 的综合 AUROC,还在识别具体哪个键属于虚构参数的定位任务上,达到了超过 80% 的准确率。
更为关键的是落地部署时的延迟对比。在常规的 Agent 编排流水线中,如果为每一个执行节点挂载外部审判 LLM,单次工具调用的端到端耗时往往会增加 1 到 3 秒。而在利用 vLLM 等成熟推理引擎支持的多 LoRA 并发加载机制下,Latent Critic 与基座模型共享了计算上下文并同步进行前向运算,其实际引入的延迟开销被压缩至 10 毫秒以内;即便在未做底层推理加速的原生 HuggingFace 环境中,其耗时也仅为 58 毫秒。这种几乎“免费”的实时拦截能力,使它具备了嵌入严苛工业级生产环境的可行性。
闭环自纠错:从通用阻断到精准反馈的跃迁
发现错误仅仅是第一步,如何以最小的成本引导 Agent 纠正错误,才是决定系统生产力的分水岭。在构建于真实场景的封闭 ReAct 交互环境中,研究人员对比了三种不同的安全防御范式:完全不设防的基座 Agent、收到拦截后仅获得模糊通用警告(如“Tool call rejected due to safety reasons”)的传统守卫系统,以及集成 Latent Critic、直接获得结构化定位反馈(如“Action blocked: ungrounded parameter [date]”)的闭环自纠错系统。
实验引入了精细的参数级指标。在这一评价框架下,查准率(Precision)是衡量安全性的硬指标,反映实际执行的工具调用中究竟有多少参数是合法且被用户意图所支撑的;查全率(Recall)则代表功能完成度,衡量最终有多少用户所需的操作被正确履行;两者的调和平均数 F1 综合表征了系统的可用性。
结果呈现出极富启发的策略权衡:通用的安全拦截虽然能够通过粗暴打断动作将 Precision 强行拉高,但代价是造成严重的“错误阻断”(False Block Rate 显著上升)。由于模型根本不知道自己做错了什么,它在后续的重试中往往陷入盲目的猜疑循环,不是胡乱修改其他正确参数,就是陷入死循环,导致最终的任务 Recall 急剧崩溃。与此形成鲜明对比的是,Latent Critic 提供的精确定位反馈如同一剂对症下药的环境观测值(Environmental observation)。在接收到具体的未锚定参数提示后,基座 Agent 能够直接跳出试错泥潭,在零样本状态下迅速改变动作策略,主动发起追问向用户核对缺失信息。这种高信息量的反馈机制极大地压低了错误阻断率,并在分布外场景下将平均重试成功次数大幅收敛至仅需 1.00 次,在筑牢安全防线的同时保全了工作流的整体效率。
面向下一代自主系统的守卫演进
回顾整个技术架构,Latent Critic 的研究价值不仅在于提出了一个高效的 LoRA 拦截插件,更在于它指明了一条将机械可解释性研究转化为工程实践的清晰路径。
过去很长一段时间里,表征工程与探针机制更多被视为离线分析模型的显微镜,人们虽然发现了真相子空间、不确定性流形的存在,却往往只能通过全局激活干预(如 ITI)粗暴地推拉模型输出,或者依赖输出离散概率分数的探测器做旁路告警。Latent Critic 证明了通过带掩码的目标引导,即便是参数极小的低秩适配器,也足以在 Transformer 内部完成对脆弱几何特征的解耦与重塑,并直接借用基座模型本身的词表映射能力,把内隐的神经元流形状态自然地“说”出来。
这项工作所确立的方法论,展现出超越工具调用这一特定垂直场景的潜力。无论是复杂的代码自动生成、多模态物理交互,还是长链条逻辑推理,当模型因为外部约束缺失而产生不可见的内部不确定性时,依靠单次前向传播中的内部几何重构来生成实时的诊断性反馈,都远比昂贵的后验裁判与不可信的表面概率更加高效稳健。让模型在犯错的前一刻,通过自己的隐层动态感知失真并将之转化为具体的纠错信号,正在成为构建高可靠性自主智能体不可忽视的关键技术基石。