$A^2E$:正确率仅差0.11?上海AI Lab揭秘9大智能体框架隐形鸿沟
$A^2E$ : An End-to-End Agent Auditing Engine
当开发者评估一个大模型智能体(Agent)系统的性能时,视线往往第一时间聚焦在底层的基础大模型上:是调用 GPT-4o、Claude 3.5 Sonnet,还是 DeepSeek-V3?然而在现实工程落地中,包裹在模型外层的框架与执行支架——即 Agent Harness,正在悄然主导整个系统的成败。从系统提示词的组织、上下文裁剪,到工具接口的调度、多轮循环控制以及错误重试机制,Harness 扮演着智能体中枢神经与执行躯干的角色。
ArXiv URL:https://arxiv.org/abs/2608.07346v2
长期以来,业内面临着一个严峻的评测盲区:传统的 Benchmark 往往只盯住最终的“端到端准确率”(Correctness),只要最终答案对了就打上满分。这种结果导向的评测掩盖了过程中的巨大代价——某些框架可能在暗中调用了数倍的高昂 Token,在无效的工具重试死循环中挣扎,或者在脆弱的规划路径上侥幸过关。更棘手的是,现有的评测工程极其臃肿,将 $M$ 个主流 Benchmark 适配到 $N$ 个开源框架上,往往需要编写维护成百上千套相互耦合的胶水代码。
针对这一系列痛点,上海人工智能实验室(Shanghai AI Laboratory)团队推出了面向智能体执行支架的端到端审计引擎——$A^2E$(Agent Auditing Engine)。该工作通过定义通用的智能体任务协议(Agent Task Protocol, ATP),将基准与框架彻底解耦,并结合非侵入式的全生命周期跟踪监控,首次对主流的 9 大智能体框架展开了深入的“多维体检”。实验得出了一个极具颠覆性的结论:当底层模型完全锁定时,各框架的最终平均正确率看似波澜不惊(仅在 0.57 到 0.68 之间窄幅震荡),但深入到过程指标,它们在工具调用效率、规划能力和计算资源消耗上的差距却犹如天堑。甚至在特定任务上,不同 Harness 带来的成功率极值落差高达 0.66。 这意味着,智能体系统的性能瓶颈早已不再仅仅取决于模型自身,框架选型的适配度同样具有一票否决权。
逃离 $M \times N$ 的适配深渊:任务协议与监控架构
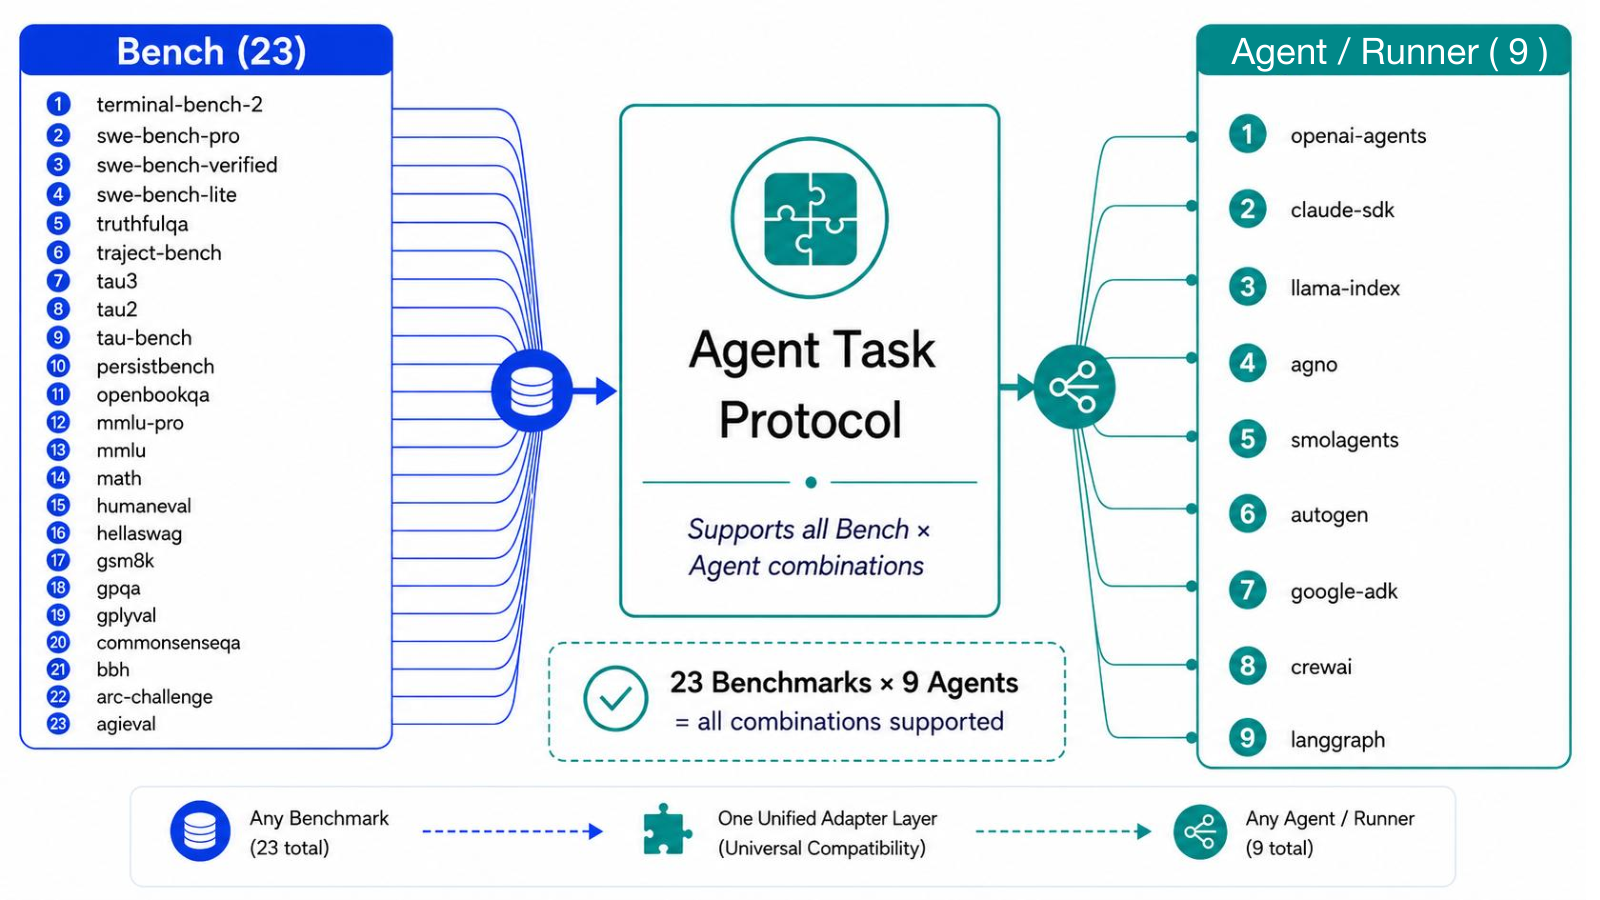
要对不同的 Harness 展开横向评测,工程上的首要难题是异构环境的碎片化。LangGraph、CrewAI、AutoGen、Agno、LlamaIndex 等框架各自拥有一套专属的模型客户端封装、提示词组装逻辑和状态转移循环;而学术界和工业界的各类 Benchmark,从常规的多项选择、代码沙箱,到复杂的外部环境交互,其输入输出规范也完全不兼容。以往的研究若想将 23 个基准与 9 个框架相互连接,往往需要编写数百个繁复的适配层,且极易在适配过程中侵入框架的原生调用逻辑,造成评测失真。
$A^2E$ 破局的关键,在于提出了类似网络协议分层思想的 Agent Task Protocol(ATP)。在 Task Layer 中,ATP 抽象出了四类核心标准对象:TaskInput、AgentBinding、AgentRunner 以及 TaskTrace。数据源适配器仅需将题目指令、状态机定义、工具签名以及沙箱镜像打包进 TaskInput,而框架适配器则专注于实现工具执行代理与提示词翻译。通过解耦,任何新增的 Benchmark 或 Harness 只需要实现与 ATP 的单向对齐,就能借助绑定引擎瞬间组合出 $M \times N$ 种可执行实例,一举抹平了组合爆炸的技术债。
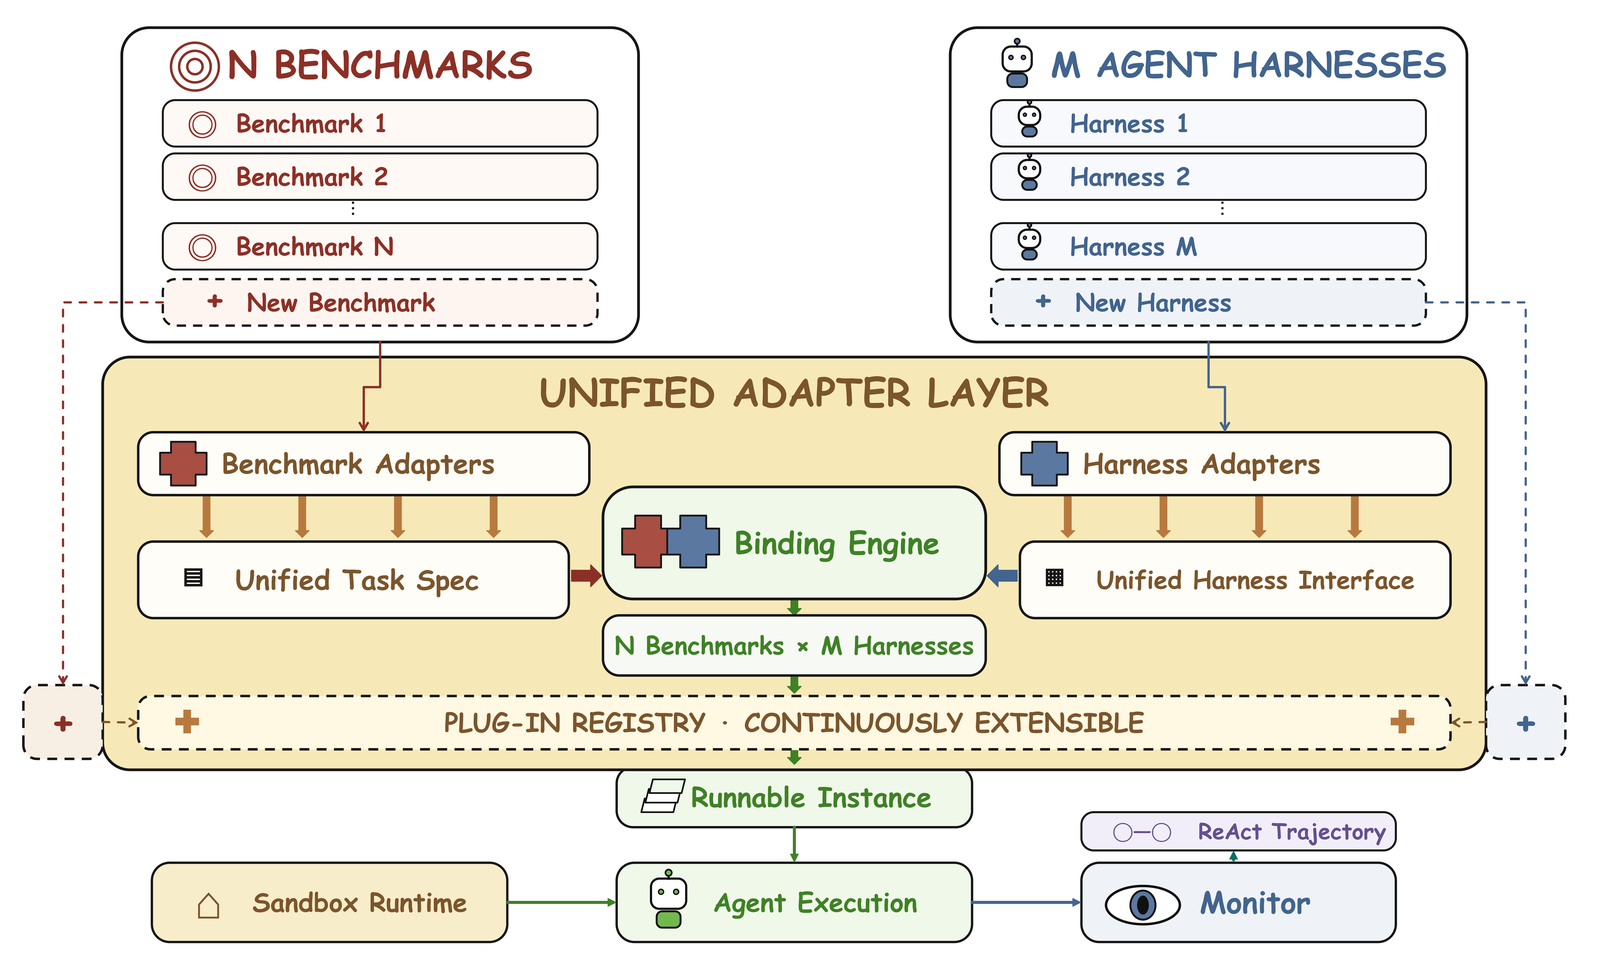
在执行与观测层面,$A^2E$ 并未要求各个框架强行嵌入特定的日志输出代码,而是设计了无侵入的 Monitor Layer。该层基于 OpenInference 与 OpenTelemetry 标准,以 Span 为最小追踪单元,将智能体的每一次模型交互、提示词注入、思维链展开、工具调用及环境反馈串联成具备显式父子依赖关系的调用树。这种设计完整保留了智能体原生调用的真实时序、上下文变迁与延迟状态,不仅能够精确追踪每个环节的 Token 消耗,更让执行过程中的隐蔽异常无所遁形。
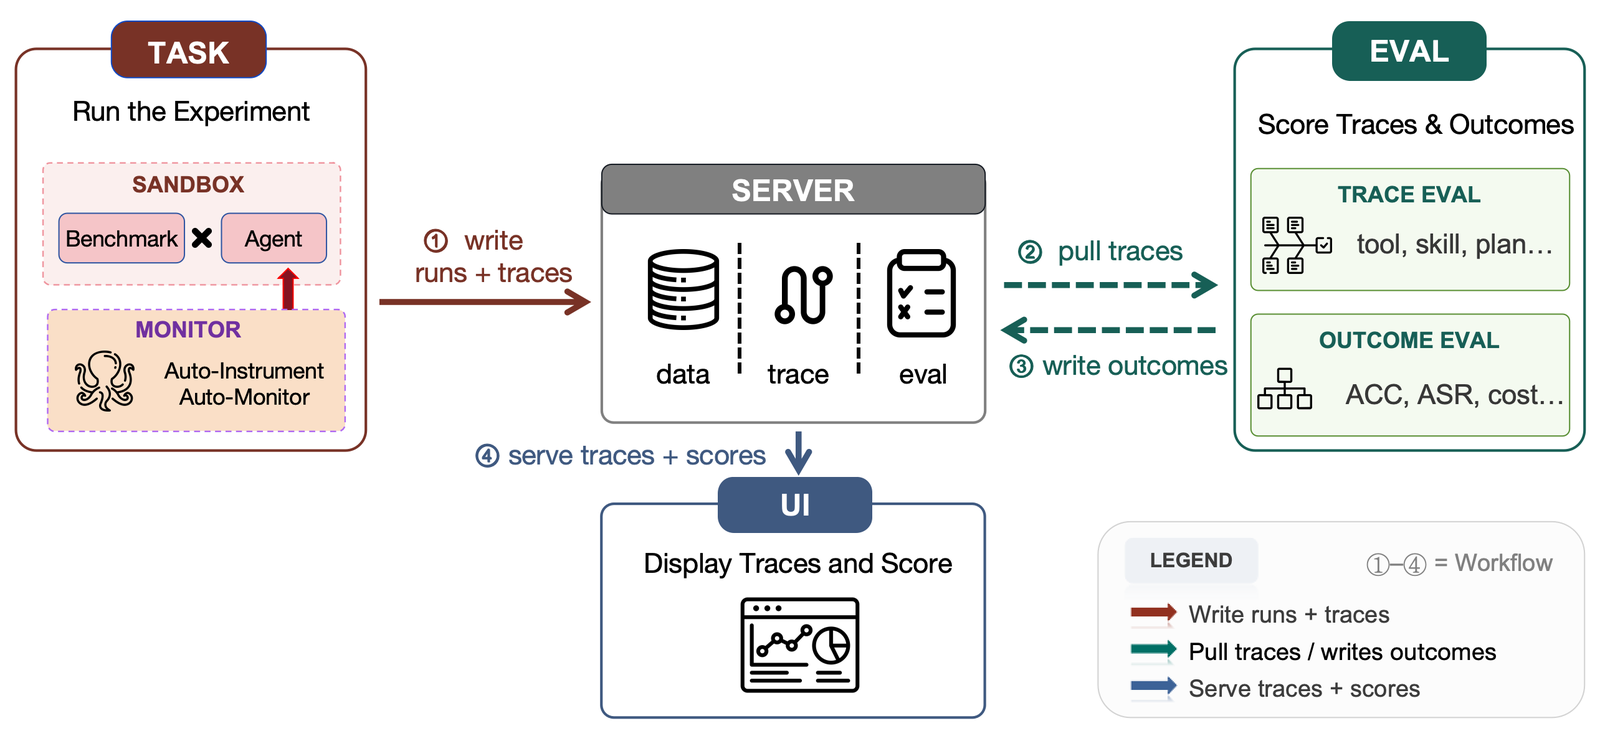
所有采集到的标准化执行轨迹,连同评测任务的元数据,都会直接流式写入中心化数据库,而非散落在本地零散的日志或 JSON 文件中。这一数据库驱动的架构,为后续的大规模横向检索、增量复评和全生命周期审计提供了坚实的底层支持。
生命周期的多维审计:撕开单一正确率的假象
有了标准化的轨迹数据,评测的核心便转向了评估维度的定义。在以往的测试体系中,人们习惯于通过一个二元标量来判定胜负。然而在复杂的真实场景中,一个任务的失败可能源于推理层面的逻辑幻觉、规划层面的死循环、工具调用时的格式崩溃,亦或是运行时触碰了安全策略。单纯记录成功与否,完全无法为框架调优提供归因支持。
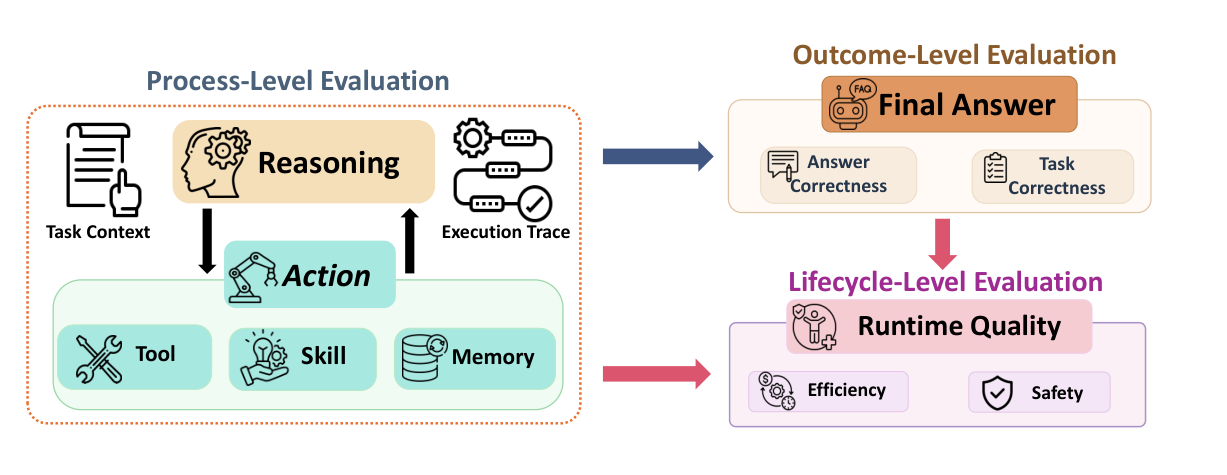
$A^2E$ 在 Evaluation Layer 中引入了“生命周期对齐评估”(Lifecycle-Aligned Evaluation)范式。该范式将智能体运行解构为三个互补的观察层次:
-
过程层评估(Process-level):紧扣智能体的迭代推理与动作阶段,细粒度度量其推理一致性、规划合理度、工具参数准确率以及幻觉率。
-
结果层评估(Outcome-level):考量最终任务交付物的精确性、目标达成率以及多轮交互后的回答完整度。
-
生命周期层评估(Lifecycle-level):从全流程运维和生产可用性的视角,审计整条轨迹的输入输出 Token 规模、耗时延迟、API 成本消耗,以及面对提示词注入和越狱攻击时的鲁棒性。
这种分层设计使得评测引擎具备了极强的诊断穿透力。正如引言中的花瓣图所示,当所有 9 个框架运行在统一的 DeepSeek-V4-Pro 底座上、面对 23 个基准测试时,代表最终结果正确率(Correctness)的花瓣跨度极为狭窄,各框架的宏观均值仅在 $0.57$ 到 $0.68$ 之间徘徊,给人一种“框架间差异不大”的错觉。
但只要将视线移向规划(Planning)、动作(Action)以及运行时效率(Runtime Quality)的花瓣,各框架的能力边界立刻呈现出剧烈的离散分化。有些框架虽然最终勉强答对了题目,但在过程中发起了数十次冗余甚至错误的工具调用;有些框架则表现出极度低效的上下文保留机制,为了维持记忆不断将海量历史堆积进 Prompt,导致运行成本呈指数级膨胀。
实验发现:没有万能框架,只有适配权衡
为了严密验证 Harness 对系统表现的独立影响,$A^2E$ 在消融实验中进行了极其严苛的环境控制。研究团队锁定了统一的模型底座(DeepSeek-V4-Pro FP4 或统一调用 GLM-5.2 API)、相同的推理超参数、一致的工具定义、最大执行步数限制与超时时间。在 23 个基准测试中,每个框架都在相同的随机种子下抽取完全一致的任务 ID 序列,消除了样本随机性带来的干扰,累计沉淀了上千次评测轨迹与近两万条细粒度评测记录。
数据分析揭示出的第一个重要现实是:业内不存在全局碾压其他竞品的“万能框架”,框架的表现展现出强烈的任务相关性与模型依赖性。
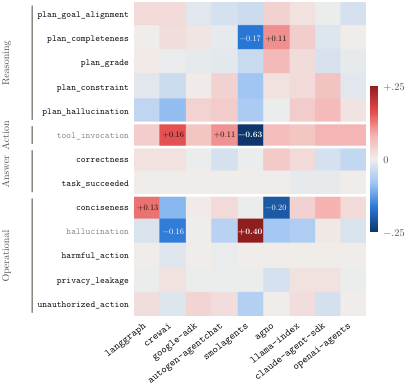
从上图的热力图中可以清晰观察到各框架的鲜明个性。例如,在代码生成和复杂的软件工程沙箱任务(如 SWE-bench 变体)中,Agno 展现出了更优的状态控制力与端到端解题能力;而在常规的问答推理基准(如 MMLU-Pro、MATH)中,OpenAI Agents SDK 与 LangGraph 则表现出更稳定的规划收敛性。而在 Token 成本与正确率的二维坐标系中,各框架的落点更是极其分散,某些框架为了追求略高几个百分点的正确率,平均上下文消耗高出了两到三倍。
在进一步考察多任务效率前沿面(Pareto Frontier)的实验中,研究人员引入了综合权衡指标 $Q_h$,该指标在归一化的 Token 消耗 $\hat{T}_h$ 与任务成功率 $\hat{S}_h$ 之间计算到理想极值点的距离:
\[Q_{h}=1-\frac{\sqrt{\hat{T}_{h}^{2}+(1-\hat{S}_{h})^{2}}}{\sqrt{2}}\]通过在 GDPVal、MMLU-Pro 和 $\tau^3$-bench 三个典型测试集上固定使用 GLM-5.2 API 进行评测,实验清晰刻画出了帕累托最优解的动态漂移。
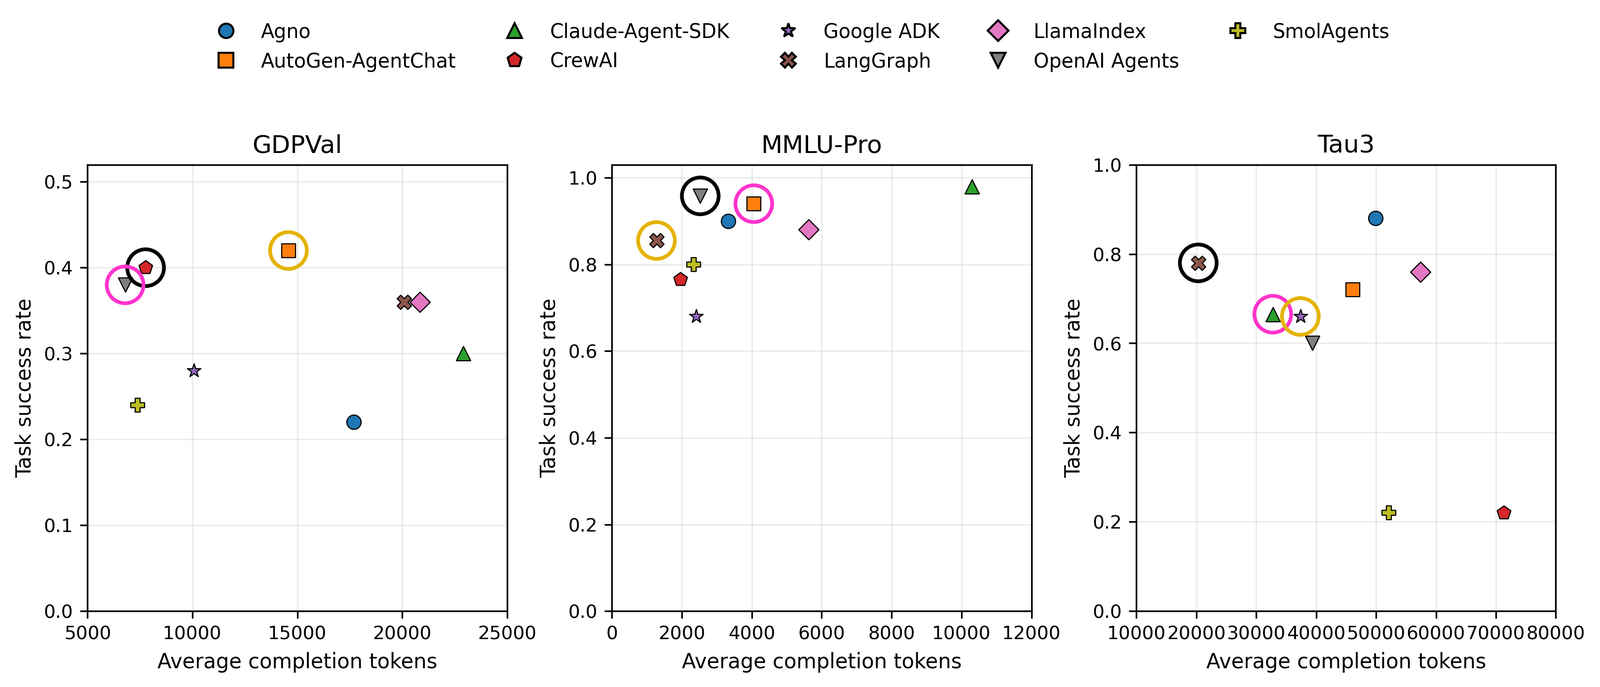
在偏向实际商业价值与经济分析的 GDPVal 基准中,CrewAI、OpenAI Agents 和 AutoGen-AgentChat 稳居前三,展现了优秀的任务推进能力;然而在强调高难度多学科综合推理的 MMLU-Pro 上,最优梯队迅速洗牌为 OpenAI Agents、AutoGen-AgentChat 和 LangGraph;更令人震惊的变化出现在模拟真实复杂工具交互的 $\tau^3$-bench 上,此前的领跑者纷纷落马,LangGraph、Claude Agent SDK 和 Google ADK 登顶效率前沿,各框架间的任务成功率跨度甚至被不可思议地拉大到了 0.66。
这种剧烈动荡证实了一个技术事实:不同的 Harness 在设计之初,就内嵌了各自特定的控制循环假设与提示词哲学。为高自由度协同设计的框架,在遇到强确定性约束的环境时,往往会因为过度发散的交互轮次而迅速耗尽算力配额;而专为确定性状态转移打造的图结构框架,在面对需要多角色头脑风暴的任务时,又可能受制于死板的流转路径。
典型案例:从微观轨迹看框架如何拖垮模型
为了让这一结论更具具象感知,论文深入剖析了一组真实案例。在面对同一个需要进行多步设备与账户诊断的交互任务时,底层模型配置与初始沙箱状态完全一致,但不同框架的微观轨迹却走向了截然不同的结局。
某一多智能体协同框架在接收到底层报错后,其内部的状态控制循环陷入了低效的局部策略。该框架连续发起了 9 次代价高昂的大模型调用,在上下文重构中未能有效剪枝,导致累计 Prompt Token 激增至 94,615 个。更致命的是,智能体在微观工具选择上不断重复尝试无意义的设备级恢复指令,彻底偏离了任务核心诉求,最终在耗尽预算后崩溃失败。
反观采用严密状态流转逻辑的 LangGraph,在面对相同的初始故障时,能够迅速识别出有效排查链路,直接切入核心的账户级诊断工具,仅用极短的上下文交互便达成目标并主动终止。两者的差距不在于底层大模型的智能水平,而纯粹在于框架本身的提示词组织方式、记忆继承策略、工具容错重试机制与终止判据。
这一案例鲜明印证了 $A^2E$ 引擎的审计价值:在复杂系统的黑盒中,如果不记录结构化 Trace,工程师往往只会得出“模型能力不足以完成诊断”的草率结论;而通过全生命周期的细粒度归因,真相才能显现——拖垮整体表现的并非模型智商,而是执行支架在工程控制上的失位。
走向模型与 Harness 的协同进化
$A^2E$ 的开源不仅为智能体领域提供了一套轻量、解耦、即插即用的评测基建,更重塑了人们看待 Agent 系统架构的视角。
随着前沿大语言模型的单体推理能力逐渐趋于高位平衡,将模型转化为可靠生产力的战场正在快速向应用支架迁移。单纯依靠端到端正确率的粗放评测时代正在终结。未来的智能体工程实践,必须依赖类似 $A^2E$ 所倡导的透明审计:在架构选型之初,通过多维指标权衡准确率与 Token 成本的帕累托前沿;在运行维护之中,依靠生命周期对齐的 Span 追踪精准定位异常断点;在系统迭代阶段,依据诊断反馈实现 Harness 调度策略与底层模型特性的深度共生。
唯有将大模型的“智力核心”置于精密量化、高效协同的“执行支架”之中,自主智能体才能真正跨越演示 Demo 的实验温室,稳健步入严肃的工业化生产环境。