BrainWAM:动作空间解耦打破跨模态干扰,NAVSIM双榜达89.6分
BrainWAM: Action-Space Coordination of Semantic Priors and Predictive Dynamics for Autonomous Driving
在端到端自动驾驶(End-to-End Autonomous Driving)的演进路线中,学术界与工业界正逐渐分裂为两大技术阵营。一派是以视觉语言动作模型(VLA, Vision-Language-Action)为代表的“语义推理派”,主张利用大语言模型(LLM/VLM)丰富的常识储备来理解复杂的交通规则、导航指令以及长尾场景中的意图;另一派则是以世界动作模型(WAM, World Action Model)为核心的“动力学预测派”,强调通过生成式视频世界模型来推演未来时空演化与物理可行性。
ArXiv URL:https://arxiv.org/abs/2608.12854v1
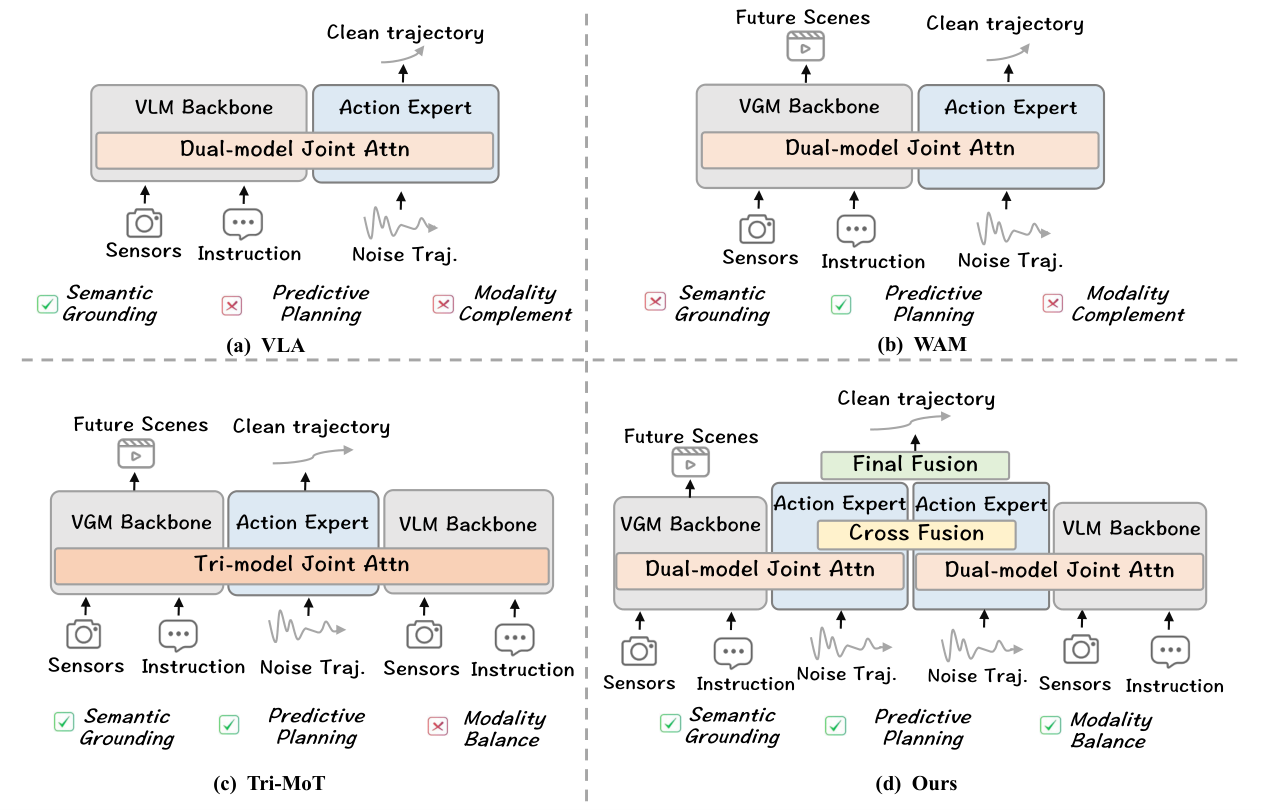
这两者的互补性显而易见:VLA 擅长看懂高层规则与指令,却缺乏对物理世界动态交互的显式建模;WAM 能精准推演物体运动趋势,但在规则遵守与语义意图对齐上往往力不从心。顺理成章的思路是将二者结合。然而,来自中国科学院与理想汽车的研究团队在尝试将 VLM、视频生成模型(VGM)和轨迹动作 Token 直接塞进同一个 Transformer 统一注意力机制时,遇到了一个反直觉的现象:这种“大一统”融合模型的规划性能,竟然比只用世界模型的单一分支还要差。
为了解决这一由于多模态注意力竞争导致的性能倒退,研究团队提出了 BrainWAM。该框架受人类大脑左右半球分工与小脑协调机制的启发,放弃了在底层原始 Token 空间的暴力混合,转而在高维紧凑的“动作空间”中对语义先验与预测动力学进行结构化对齐。BrainWAM 在权威自动驾驶基准 NAVSIM v1 与 v2 上分别取得了 89.5 PDMS 与 89.6 EPDMS 的领先成绩,为大模型与世界模型在智驾规划中的深度结合提供了一条极具说服力的架构路径。
为什么朴素的多模态拼接反而拖累了规划?
在探索语义大模型与世界模型的结合时,业内最直观的做法往往是构建三模态联合注意力(Tri-modal Joint Attention, Tri-MoT)。即将 VLM 的语义 Token、视频生成模型的像素潜空间 Token 以及轨迹的动作 Token 放置在共享的自注意力池中进行跨模态交互,试图让动作 Token 同时汲取语义和物理演化的养分。
然而,实验结果却令人大跌眼镜:在 NAVSIM v1 基准上,仅依靠世界模型的 WAM-only 基线取得了 88.1 的 PDMS 分数,而盲目融合了 VLM 语义的 Tri-MoT 得分仅为 87.8。
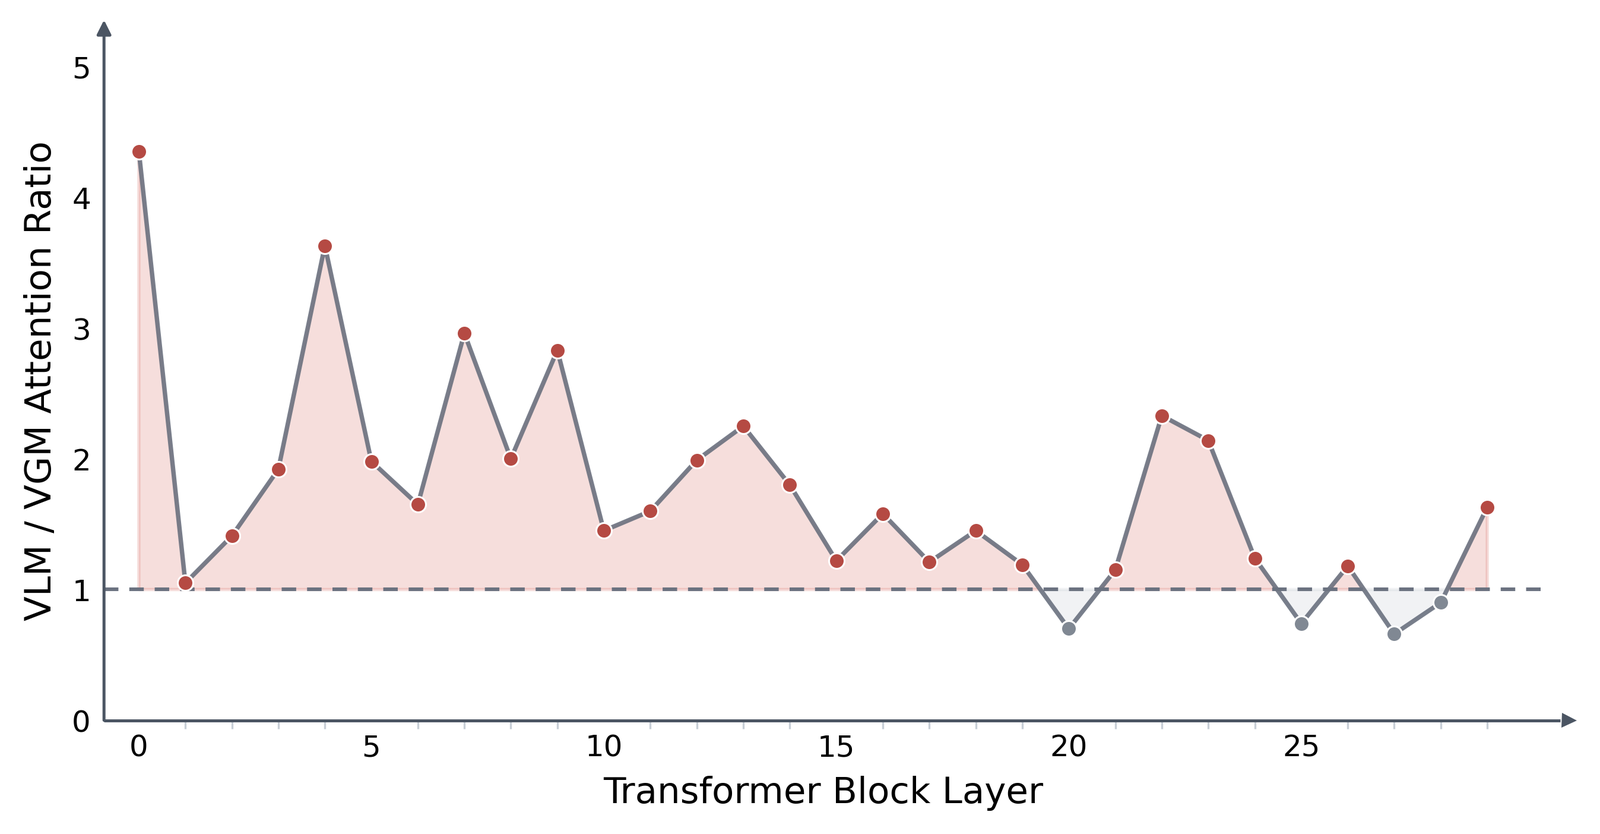
深入网络内部的注意力权重分析揭示了问题的根源:注意力分配失衡(Attention-Allocation Mismatch)。如图 2 所示,在绝大多数网络层(尤其是浅层网络)中,动作 Token 对 VLM 语义 Token 的注意力分配比例,压倒性地高于对 VGM 视频动力学 Token 的注意力。
这种不对称性在多模态联合训练中被称为“模态竞争”(Modality Competition)。VLM 输出的特征高度凝练、语义明确,损失函数极易在语义特征上快速下降;相比之下,视频扩散去噪过程中的像素潜空间 Token 维度极高且包含大量低层高频信号,需要漫长而复杂的特征提取过程。优化算法本能地选择了走“语义捷径”(Semantic Shortcut),导致高层语义主导了整个注意力池,严重抑制了原本对轨迹规划至关重要的物理动力学与运动趋势特征。
仿生学架构:从大脑分工到动作空间协同
面对模态竞争导致的表征污染,研究团队转向了神经科学的成熟机制:复杂的智能行为并非诞生于混沌未分的单一表征空间,而是源于功能特化系统之间的高效协同。
人脑的左半球擅长符号、语言和序列逻辑处理,右半球擅长视觉空间感知与整体环境推演,两者通过胼胝体(Corpus Callosum)进行密集的信息交互;与此同时,运动意图的最终执行与平滑微调则由小脑(Cerebellum)统筹完成。
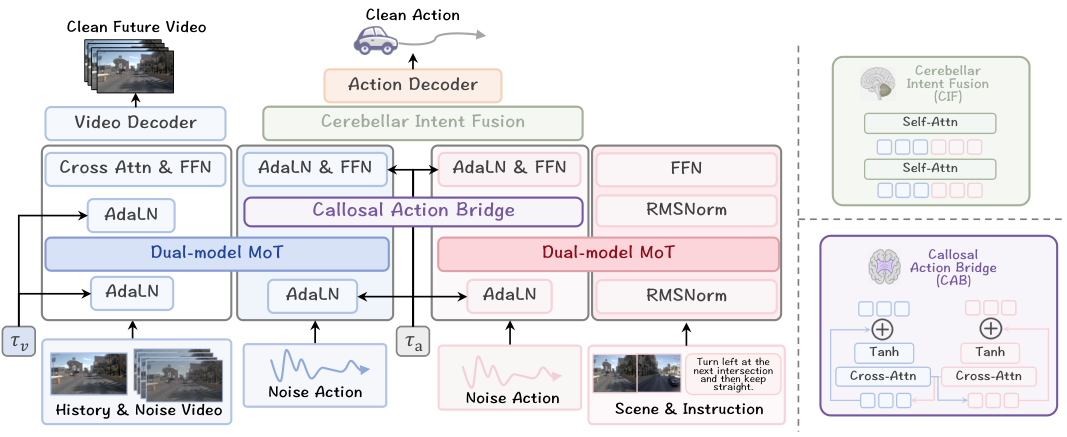
BrainWAM 完美映射了这一生理构造,构建了双路特化并在动作空间对齐的全新架构:
-
左脑通路(VLA 语义分支):以视觉语言模型为底座,负责提炼导航指令、道路限速、路权规则以及驾驶员的高层意图,并通过专用动作专家输出“语义锚定”的动作表征 $A_{\mathrm{sem}}$。
-
右脑通路(WAM 动力学分支):以开源视频生成大模型 Wan2.2-TI2V-5B 为骨干,对未来的潜在时空演化进行建模,预测物体交互与时空演化,生成“动力学锚定”的动作表征 $A_{\mathrm{pred}}$。
-
胼胝体动作桥(Callosal Action Bridge, CAB):彻底隔离 VLM 与 VGM 的原始巨量 Token,只允许紧凑的动作 Token 进行双向交互。在网络每一层,两个分支的动作专家通过跨注意力交换信息,并通过可学习门控机制更新:
\[\tilde{A}_{\mathrm{pred}}^{l} = A_{\mathrm{pred}}^{l} + \alpha_{\mathrm{pred}}^{l} M_{\mathrm{pred} \leftarrow \mathrm{sem}}^{l}\] \[\tilde{A}_{\mathrm{sem}}^{l} = A_{\mathrm{sem}}^{l} + \alpha_{\mathrm{sem}}^{l} M_{\mathrm{sem} \leftarrow \mathrm{pred}}^{l}\]门控权重初始置零,保证了分支在初期的独立特化,随后逐步平滑注入跨模态认知。
-
小脑意图融合(Cerebellar Intent Fusion, CIF):在动作专家顶层,将经过深度交互的动作表征拼接并通过轻量 Transformer 整合,解码出平滑且符合物理规律的连续轨迹向量。
三阶段解耦训练与异步扩散推理
为了保证两个复杂分支互不干扰、各自发挥极限性能,BrainWAM 采取了分而治之的三阶段训练流程。
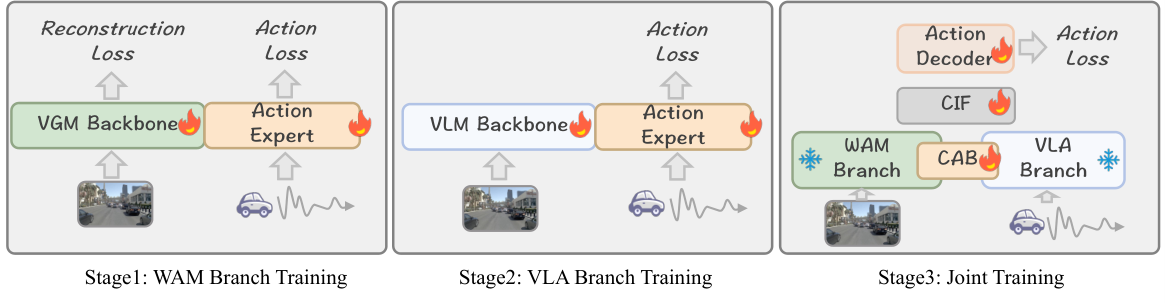
在第一阶段与第二阶段,WAM 分支与 VLA 分支分别在 Flow Matching 与 Rectified Flow 框架下独立预训练。视频和动作各自沿着从高斯噪声到真实分布的线性插值路径学习速度场:
\[x_{t} = (1-t)x_{0} + t\epsilon, \quad \epsilon \sim \mathcal{N}(0, I)\]到了第三阶段,两个预训练的庞大骨干网络被完全冻结。训练焦点完全集中在轻量级的胼胝体动作桥(CAB)、小脑意图融合(CIF)以及最终的轨迹解码器上。这不仅大幅降低了端到端联合微调的显存与计算开销,更从根本上避免了两大骨干网络的表征漂移。
在实车部署最关心的推理延迟方面,BrainWAM 引入了异步整流流(Asynchronous Rectified-Flow)推理策略。研究人员发现,虽然动作去噪需要依赖未来的视频特征,但系统并不需要视频生成模型一步步完全去噪生成出清晰的“高清画质视频”。
视频分支可以在经过极少量的去噪步数(甚至仅需 1 步)构建出粗粒度的时空交互上下文后立即提前截断,并将潜空间特征缓存起来;随后,轻量级的动作分支以多步迭代的形式,独立完成高精度的轨迹采样。
实验评测:双榜登顶与消融实证
研究团队在主流端到端自动驾驶模拟评估基准 NAVSIM v1 与 NAVSIM v2 上对 BrainWAM 进行了全面验证。NAVSIM 不仅考查传统的位移误差,更在非反应式仿真环境中严苛评估碰撞率(NC)、可行驶区域合规性(DAC)、自我进展(EP)以及驾乘舒适度(C)等核心指标。
在 NAVSIM v1 上,BrainWAM 斩获了 89.5 PDMS 的高分,在可行驶区域合规性(DAC 提升显著)和行车进度(EP)上展现出极大优势;在评估维度更细致、加入更多交通规则与舒适度约束的 NAVSIM v2 上,BrainWAM 同样以 89.6 EPDMS 稳居榜首。
消融实验进一步证实了架构设计的精妙:
-
分支互补性:纯 VLA 模型(81.2 PDMS)在复杂动态交互中缺乏物理直觉;纯 WAM 模型虽有 88.1 PDMS,但在长尾规则上偶有失误。BrainWAM 将二者提升至 89.5,体现了真正的“1+1 > 2”。
-
协同模块的有效性:若仅保留 CAB 进行层间动作交互,PDMS 为 88.7;若仅在末端用 CIF 简单融合,PDMS 为 88.5。只有两者协同——CAB 负责渐进式动作对齐,CIF 负责最终意图整合——才能发挥出架构的最大效能。
-
推理效率权衡:在视频推理步数的消融中,完全不进行视频去噪会导致 PDMS 暴跌至 79.3,证明未来动力学确实不可或缺;而仅引入 1 步 视频预测去噪,模型性能就瞬间跃升至 89.3 PDMS,端到端延迟仅增加少量开销(475 ms 级),完美化解了视频世界模型过于沉重、难以实车落地的历史难题。
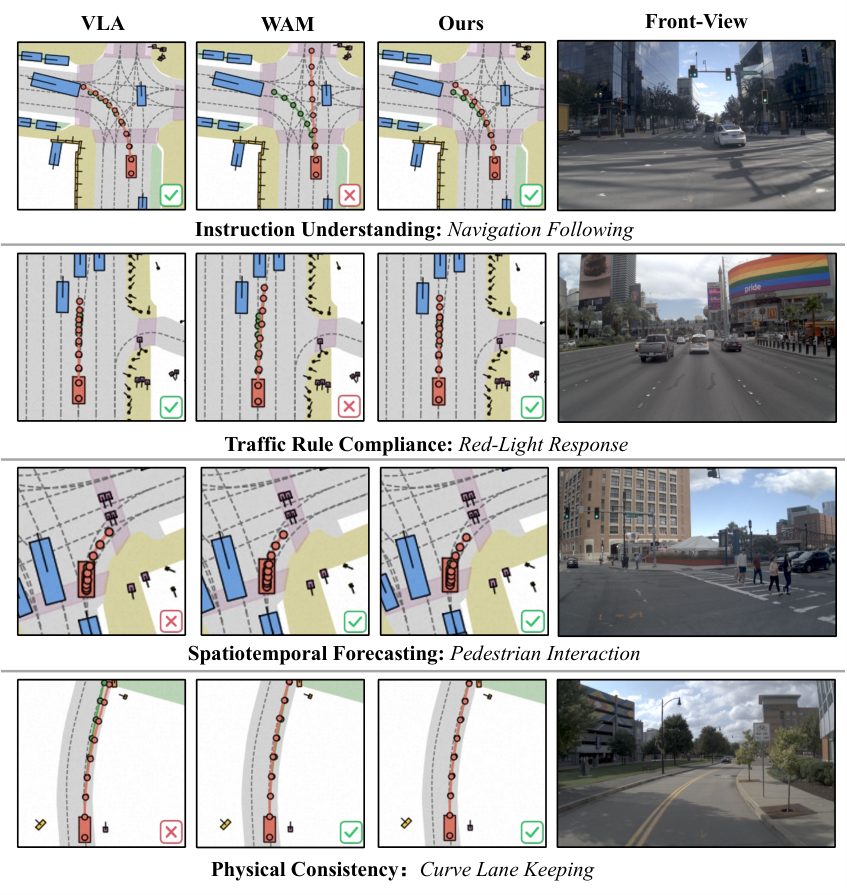
从定性可视化的案例(图 5)中可以更直观地看清这种协同的力量:在面对前车刹车灯亮起或错综复杂的路口意图判断时,单一的 WAM 往往由于缺乏语义指引而犹豫不决,甚至规划出违背路权的轨迹;而纯 VLA 模型在密集的动态变道交互中,容易给出违反物理动态学的骤变路线。BrainWAM 既准确识别了刹车语义与道路指令,又结合未来动态推演出了平顺、无冲突的通行轨迹。
从原始特征大杂烩到紧凑功能协同
BrainWAM 给当前火热的“大模型+自动驾驶”提供了一个非常清醒的技术洞察:多模态融合绝不是将所有模态的 Token 一股脑扔给通用大模型自注意力就万事大吉。 跨模态特征在维度、信息密度和学习难度上的天然差异,极易在共享注意力机制中产生有害的“挤出效应”。
通过借鉴神经科学中功能高度特化、依靠紧凑动作中介进行交互的架构范式,BrainWAM 证明了让 VLA 专注语义、让 WAM 专注时空动态,最终在动作空间完成轻量级对齐,不仅在工程上大幅降低了联合优化的不稳定性和计算成本,更在规划性能上突破了此前各自为战的上限。对于致力于将视频生成世界模型与具身语义大模型推向实车量产的工程师而言,这种在动作空间解耦再协同的思路,无疑指明了一条兼顾安全性、计算效率与可解释性的实用路径。