阿里与上交提出 C$^2$KV:可组合缓存流形,长文本推理加速达 17 倍
C$^2$KV: Compressed and Composable KV Cache Reuse for Efficient LLM Inference
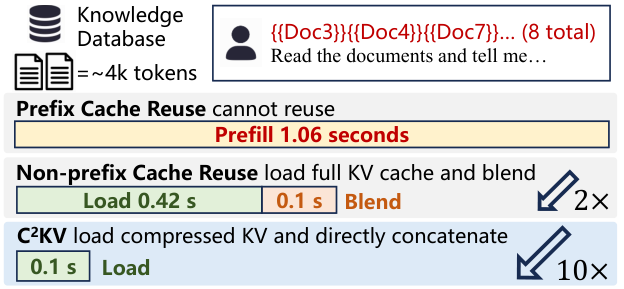
在检索增强生成(RAG)、多文档多跳推理以及长上下文智能体(Agent)的实际落地中,服务系统的显存与时延开销正在以极快的速度攀升。为了避免每次请求都对海量参考文档重复进行耗时的 Prefill(预填充)计算,业界普遍转向了 KV Cache(键值缓存)复用技术。然而,现有的复用探索大多集中在如何省去浮点计算,却在无形中撞上了另一堵更硬的墙:超长上下文下海量 KV Cache 的存储空间与显存带宽瓶颈。
ArXiv URL:https://arxiv.org/abs/2607.17715v1
当单次请求需要挂载数十篇长文档时,KV Cache 的体积动辄达到数十甚至上百吉字节(GB)。如果直接套用现有的 KV 压缩算法来减轻存储负担,模型的生成准确率往往会出现断崖式下跌。来自阿里巴巴与上海交通大学的研究团队提出了全新框架 $\text{C}^{2}\text{KV}$(Compressed and Composable KV),通过解耦基座模型与缓存抽取过程,构建出一种既高倍压缩又具备“即插即用”拼装能力的 KV 缓存流形。在保持基座大模型权重完全冻结的前提下,该框架不仅实现了文档级 KV 缓存的无损拼接,还将首字生成延迟(TTFT)缩减至纯加载耗时,在长上下文推理场景下最高斩获了 17 倍的推理加速。
从“省算力”到“省带宽”:长上下文推理的瓶颈转移
要理解 $\text{C}^{2}\text{KV}$ 的突破点,需要先看清工业级大模型服务系统的物理瓶颈是如何迁移的。标准自注意力机制的计算复杂度为 $O(L^2)$,在序列长度 $L$ 达到数万至数十万时,Prefill 阶段的计算量确实极其恐怖。为此,以 vLLM 的 PagedAttention 和 SGLang 的 RadixAttention 为代表的前缀缓存(Prefix Caching)技术迅速普及。前缀缓存要求输入的文本序列严格拥有相同的开头前缀,这在单轮多轮对话中效果拔群,但在多文档 RAG 和模块化工具调用中却极易失效——在实际场景中,不同文档的检索组合、排列顺序乃至中间穿插的用户指令往往是动态变化的,严格的物理前缀极少重合。
为了突破前缀匹配的限制,研究界此前探索了非前缀缓存(Non-Prefix Caching)方案。一类是免训练的混合方法(如 CacheBlend),试图通过部分重算(Recompute)来缝合独立计算出的 KV Cache 片段;另一类是基于训练的方法(如 Block-Attention),直接微调模型架构以支持跨文档的独立注意力。然而,免训练方法存在天然的“KV 偏差差距”(KV Deviation Gap),一旦减少重算比例,注意力偏差就会单调上升,导致精度显著下滑;而基于微调的方案则代价高昂,不仅难以跟进开源基础模型的快速迭代,还会破坏基座模型的通用语言泛化能力。
更为致命的盲区在于硬件传输开销。如上图所示,当上下文扩展到数十万 Token 时,首字延迟(TTFT)的主要开销早已不再单纯是 GPU 核心的张量运算,而是从主机内存(Host Memory)或外部存储向显存加载海量 KV Cache 的 I/O 传输时间。将未压缩的原始 KV Cache 缓存在外存中,每次请求触发时再搬运进显存,庞大的数据吞吐量直接堵死了总线带宽。
直觉上的解法是引入 KV Cache 压缩技术(如剪枝、稀疏化或低秩量化)。但实验表明,若将现有的压缩算法直接套用在非前缀缓存复用中,模型的效果会迅速崩溃。现存的压缩方案通常高度依赖输入序列的全局上下文,提取出的 Token 往往和它所处的特定句意、绝对位置紧密绑定,失去了“可组合性”(Non-composability)。一旦将这些被压缩过的孤立片段重新拼接并送入解码阶段,注意力机制就会因为严重的语义错位和上下文失真而失去生成能力。
核心架构:轻量级旁路抽取器与位置无关流形
$\text{C}^{2}\text{KV}$ 破局的核心思路,在于不再强行对原始、具有上下文强依赖的 KV 张量做近似裁剪,而是从底层重构一套“生来即可组合、可压缩”的 KV 缓存流形。整个系统划分为离线抽取和在线组装两个阶段。
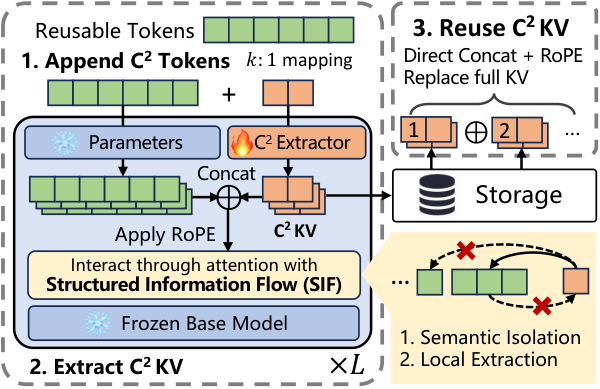
如上图流水线所示,当文档库入库时,离线系统调用专门的抽取器对文档进行特征蒸馏,生成压缩率通常为 $4\times$ 到 $8\times$ 的紧凑 KV 缓存,并存入轻量存储池;在线推理阶段,系统面对不同请求时,只需根据检索结果直接从存储池中捞取对应的压缩 KV 块,根据当前提示词中的顺序赋予新的相对位置编码并线性拼接,无需任何中间重算即可无缝输入冻结的基座模型进行自回归生成。
为了在不破坏基座大模型原生能力的前提下实现上述构想,作者设计了附着在冻结基座模型上的轻量级外挂模块——$\text{C}^{2}\text{Extractor}$。
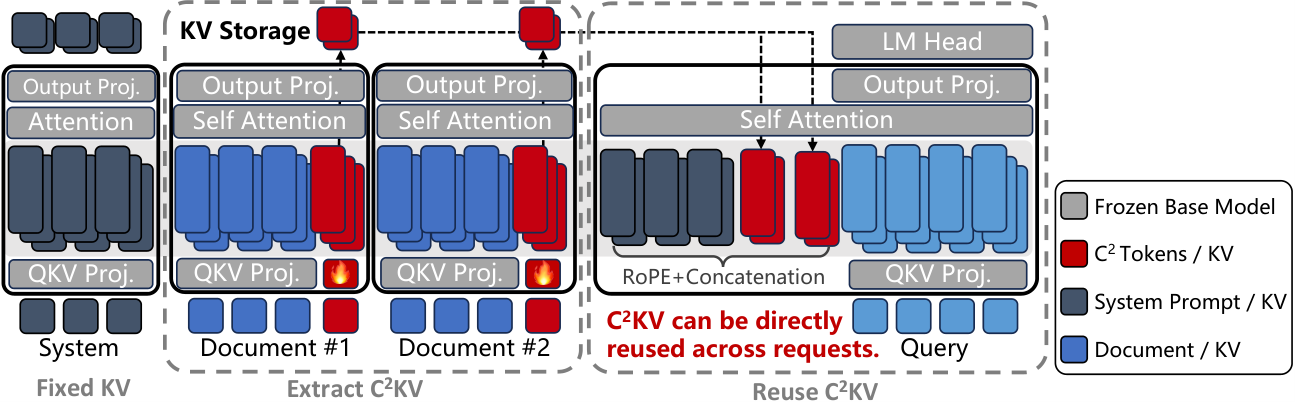
$\text{C}^{2}\text{Extractor}$ 的参数规模极小,在 Qwen3-4B 和 Llama-3.1-8B 上仅占基座模型约 10% 的额外参数量。其机制可以拆解为以下关键设计:
-
虚拟压缩槽位($\text{C}^{2}\text{Tokens}$):系统根据设定的压缩比 $k$(例如 $k=4$),在长度为 $n$ 的文档序列中,每隔 $k$ 个原始 Token 插入一个专门的辅助可学习向量 $\text{C}^{2}\text{Token}$。这些 Token 不代表任何自然语言词汇,其物理意义是可学习的“信息存储槽位”。
-
专属独立投影头:在 Transformer 的每一层,原始文档 Token 依然通过基座模型完全冻结的权重矩阵映射为 Query、Key、Value;而 $\text{C}^{2}\text{Tokens}$ 则被路由到独立的、可训练的投影头矩阵 $W^{(\ell)}{\text{C}^{2},Q}$、$W^{(\ell)}{\text{C}^{2},K}$ 和 $W^{(\ell)}_{\text{C}^{2},V}$ 中。在完成注意力运算后,只有由 $\text{C}^{2}\text{Tokens}$ 产出的 KV 张量会被持久化保留,原始 Token 的 KV 全被抛弃。
-
残差均值池化变体($\text{C}^{2}\text{KV-Residual}$):为了进一步稳固极端压缩下的语义保真度,研究团队还引入了一个轻量残差通路。在模型的第一层,直接将当前块内 $k$ 个原始文档 Token 隐藏状态的均值,按残差连接加权到对应的 $\text{C}^{2}\text{Token}$ 状态上,为抽象槽位提供了显式的局部底层语义支撑。
-
即插即用的相对位置对齐:在离线提取时,KV 状态是以无绝对位置偏置的方式存储的。进入在线复用时,系统再根据拼接后的整体顺序统一计算并赋予新的 RoPE(旋转位置编码)偏移量,使得各个文档段可以在上下文中随意置换次序,真正做到位置无关(Position-agnostic)。
结构化注意力流:斩断跨文档污染的单向信道
在传统的压缩机制中(如 Anchor-Token 方案),辅助 Token 往往作为序列的信息瓶颈,其他普通 Token 在注意力层中既会写向它,也会从中读出信息。但在非前缀多文档场景下,如果允许原始 Token 感知到压缩槽位的存在,抽取出的内部表征就会混入当前文档全局的封闭式上下文纠缠,一旦外部拼装发生变化,整个注意力分布就会塌缩。
$\text{C}^{2}\text{KV}$ 提出了结构化信息流(Structured Information Flow, SIF),从注意力掩码层面强制执行不对称约束。
具体而言,注意力掩码矩阵严格实施两条硬性准则:
-
原始 Token 视线屏蔽:任意原始文档 Token 绝不能在注意力中“看到”任何 $\text{C}^{2}\text{Token}$。其注意力掩码对应位置全部设为 $-\infty$。这确保了原始文档在抽取器内部的隐层演化完全符合标准自回归模型在因果注意力下的分布,杜绝了参数空间的异化。
-
分块局部单向可见:每一个 $\text{C}^{2}\text{Token}$ 仅允许聚合其所属的 $k$ 个局部文档 Token,以及序列开头的极少数“注意力汇”(Sink Tokens),不得跨块越界偷窥。
这种单向流动的精妙之处在于,$\text{C}^{2}\text{Tokens}$ 被严格定位为“纯信息吸收器与承载体”,而不是传统的多跳推理中继器。每个压缩槽位忠实且高度解耦地吸纳对应局部的句意流形,从而在数学上赋予了提取结果模块化和正交性,从物理源头上消除了不同文档在拼装时的语义串扰(Semantic Cross-talk)。
联合优化训练:以“生成目标”反逼抽取器就范
光有结构设计还不够,如何让独立的抽取器在面对“未来未知文档的随意拼接”时,依然能准确表达语义?研究团队提出了一种“压缩-拼接联合训练”(Compression-Concatenation Co-training)策略。
这个策略的独特之处在于其极简的目标设计:系统并不引入任何显式的重构损失函数(Reconstruction Loss)去强迫压缩后的 KV 去拟合原始未压缩的 KV 张量,也不引入对比学习或跨层对齐损失。整个系统唯一的优化目标,就是下游生成任务的自回归交叉熵损失:
\[\mathcal{L}_{\text{SFT}}=-\sum_{t=1}^{T}\log p\bigl(y_{t}\mid y_{<t},q_{1:m},\mathbf{K}_{\text{cat}},\mathbf{V}_{\text{cat}}\bigr)\]在训练过程中,训练集样本由多个文档随机打乱组合而成。每个文档独立经过 $\text{C}^{2}\text{Extractor}$ 进行 $4\times$ 压缩,生成的压缩 KV 张量被拼接在一起,随后与用户的 Query 拼接并传入下游解码。反向传播过程中,基座语言模型的所有参数全部锁定,梯度只回传至 $\text{C}^{2}\text{Extractor}$ 的投影头和 Token 嵌入层。
这种端到端设计的深意在于:监督信号是在拼接发生之后才施加的。抽取器被迫学会在没有全局跨文档交互的情况下,自发调整其投影流形,让压缩出来的向量天然具备“拼接就绪”(Merge-ready)的属性。如果某个文档压缩过于激进或者由于缺乏全局信息而在拼接后导致回答错误,生成损失就会急剧增大并惩罚抽取器。最终收敛的抽取器,自然找到了信息局部压缩与下游全局拼接之间的稳健平衡点。
实验评测:首字延迟斩获 17 倍加速,解码曲线全面平坦化
研究团队在 Qwen3-4B、Llama-3.1-8B 以及 Qwen2.5-7B 等主流模型上进行了多维度评测,覆盖 HotpotQA、2WikiMultiHopQA、LongMagpie 等具有挑战性的多文档推理和长文本任务。
在服务吞吐的核心指标——首字生成延迟(TTFT)与任务精度的权衡对比中,$\text{C}^{2}\text{KV}$ 展现出压倒性的优势。免训练方案如 CacheBlend 必须在重算比例和精度之间痛苦取舍,重算比例高则延迟逼近从头计算,重算比例低则回答准确率暴跌;而 $\text{C}^{2}\text{KV}$ 将在线阶段的准备工作简化成了“纯加载 + 快速重算相对位置”,彻底跳过了计算密集的混合与重算逻辑。配合 $4\times$ 的体积精简,显存 I/O 耗时大幅缩减,端到端 TTFT 实现了最高 17 倍的加速,牢牢占据了 Pareto 边界的最优左上角。
不仅是首字阶段,自回归解码(Decode)阶段的内存带宽收益同样显著。在传统长文本场景下,由于每一步生成都需要扫描全部 KV Cache,随着上下文从 16k 线性增加到 128k,每 Token 解码耗时(Time-Between-Tokens, TBT)会呈直线上升。而经过 $\text{C}^{2}\text{KV}$ 压缩后,解码阶段的注意力显存占用缩减为原来的四分之一,这使得上下文长度即使膨胀至 128k,解码耗时曲线依然极其平缓,彻底打破了长上下文服务中的显存带宽墙。
为了检验长文本检索与定位能力,论文在极具说服力的长文本基准 RULER 上进行了严格测试。
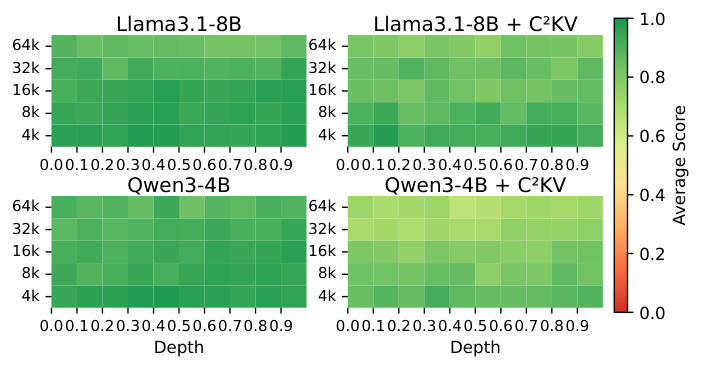
如上图所示,在 4 倍压缩的严苛条件下,$\text{C}^{2}\text{KV}$ 在各种检索深度(Depth 无论处于文档前部、中部还是尾部)下,依然保持了与未压缩全尺寸模型(Full-Context)高度一致的表现,没有出现长文本模型常见的“迷失在中间”(Lost in the Middle)或尾部漂移现象。
消融实验进一步验证了该设计的必要性。如果像业界常规做法一样,直接将当前主流的压缩算法(如 SnapKV)与非前缀复用结合,模型的准确率会发生灾难性暴跌——在部分多跳问答任务上 F1 分数直接折半。这是因为破坏了结构化注意力流后,压缩特征与拼接上下文发生了灾难性的非线性干涉。只有在“结构化抽取 + 端到端拼接训练”的双重保障下,解耦的高性能复用才成为可能。
走向模块化 LLM 推理的基础设施演进
$\text{C}^{2}\text{KV}$ 的价值不仅仅在于给出了一组优异的吞吐和时延数字,更在于对未来大模型系统的存储与计算架构提供了一个极具参考意义的范式转移。
在过去很长一段时间里,工业界普遍认为 KV Cache 是一种临时的、不可跨越上下文的瞬时计算副产物。而这篇论文的实践表明:只要施加合理的注意力掩码约束与端到端下游对齐,KV 空间完全可以被驯化成一种“模块化、结构化且标准化”的外部知识表征媒介。用户不需要一次又一次将数以万计的原始文本 Token 送进基座网络进行前向传播,更不需要维护笨重的全参数微调模型;只需运行极其轻量(10% 参数)的边车模块,就能将非结构化的长篇文档静态固化为体积轻巧、支持随时任意次序重排组装的张量块。
这种将“语义提取”与“核心生成”在物理及参数层面彻底解耦的架构,为解决 RAG 系统的显存爆炸、超长智能体记忆检索以及多租户知识隔离等核心工程难题,铺就了一条高吞吐、低成本的实用落地路径。