Dion3:全栈重构Muon正交更新,单步开销缩减至AdamW的4倍
Dion3: Full-Stack Orthogonal Updates
在追求大语言模型预训练效率的前沿阵地上,优化器层面的竞争正在经历一场深刻范式转移。传统的 AdamW 尽管稳健,却需要消耗海量迭代步数才能将损失压到理想水平。近来在 Kimi K2 与 GLM-5 等前沿模型中大放异彩的 Muon 优化器,凭借其基于谱范数的“最速下降”性质,能够在显著更少的训练步数下达到相同收敛损失。然而,这种算法收益在工程落地时面临着高昂的代价:Muon 内部依赖的三次复杂度 Newton-Schulz 正交化算法极其消耗算力,而在分布式切分权重(如 FSDP)时,频繁的张量重组通信更是让整体吞吐大打折扣。在许多高并发训练场景下,Muon 节省下来的步数优势几乎全被膨胀的单步执行时间吞噬殆尽。
ArXiv URL:https://arxiv.org/abs/2608.11612v1
由微软研究院、英伟达、纽约大学、普林斯顿大学与耶鲁大学等机构联合提出的 Dion3,正是针对这一系列系统与算法痛点交出的全栈答案。Dion3 从底层硬件算子、数学算法重构、优化器更新机制到分布式通信策略进行了彻底改造,将 Muon 正交化步骤的耗时全面压低。在 4 块 GH200 上训练 7B 参数模型的基准测试中,Muon 相较于 AdamW 高达 26 倍的优化器单步时间,被 Dion3 压缩至仅 4 倍,单步耗时最大降幅达 6 倍。
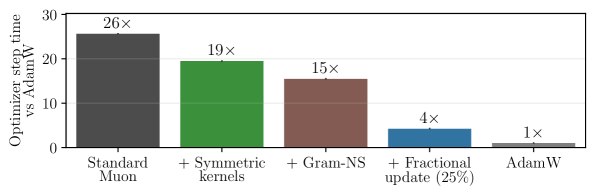
上图清晰地展示了各项技术改进如何层层堆叠并释放红利:从数学层面的 Gram 改写、硬件底层的对称 GEMM 算子,到算法层面的子采样规则与系统层的通信聚合,每一个组件都在削减开销,最终使基于正交化的二阶特性优化器真正具备了工业级生产力。
长宽比魔咒:为什么标准 Muon 在大模型中越来越慢?
要理解 Dion3 的改造,首先需要明确 Muon 为何会成为计算吞吐的泥潭。Muon 的本质是在梯度更新时,通过极分解(Polar Decomposition)寻找当前动量矩阵在谱范数意义下的正交投影:
\[{\mathbf{W}} \leftarrow {\mathbf{W}} - \eta \operatorname{polar}({\mathbf{M}})\]其中 $\operatorname{polar}({\mathbf{M}}) = {\mathbf{U}}{\mathbf{V}}^\top$,对应矩阵奇异值分解(SVD)中被抹平奇异值后的方向。在工程实现中,精确 SVD 计算开销不可接受,Muon 采用五次多项式迭代的 Newton-Schulz 算法进行逼近:
\[{\mathbf{X}}_{t+1} = a_t {\mathbf{X}}_t + b_t {\mathbf{X}}_t {\mathbf{X}}_t^\top {\mathbf{X}}_t + c_t \left({\mathbf{X}}_t {\mathbf{X}}_t^\top\right)^2 {\mathbf{X}}_t\]每一次迭代展开后,都包含长宽尺寸为 $n \times m$ 的矩阵相乘。对于一个典型的 5 轮迭代过程,总共需要执行 15 次大型通用矩阵乘法(GEMM)。如果设矩阵的宽高比为 $\alpha = m/n$(假设 $m \ge n$),标准 Newton-Schulz 的浮点运算量高达 $(20\alpha + 10)n^3$ FLOPs。
这一公式揭示了一个长期被学术界忽视的硬件系统痛点:浮点开销对长宽比 $\alpha$ 具有强烈的线性依赖。不幸的是,现代 Transformer 架构内部天然充满了极端长宽比的矩阵。MLP 的门控与升维投影、多头潜变量注意力(MLA)以及成倍瘦身的多专家架构(MoE),都在不断推高隐层维度与中间维度的比例 $\alpha$。当成百上千个高偏斜度矩形矩阵在每一训练步都要经历 15 次大型 GEMM 时,优化器步骤的开销就会迅速盖过前向与反向传播。
雪上加霜的是分布式张量切分。在 FSDP(Fully Sharded Data Parallel)体系下,动量矩阵分布在不同 GPU 上,Newton-Schulz 无法直接在分片上独立执行,必须先通过 All-to-All 通信收集完整矩阵,正交化完成后再通过 All-to-All 散回。频繁的小张量跨卡搬运在网络延迟与带宽上形成了不可忽视的二次瓶颈。
Gram Newton-Schulz:在小对称矩阵上迭代的数学戏法
Dion3 砍向计算开销的第一刀是彻底改写迭代算法本身。传统 Newton-Schulz 算法在整个 5 轮迭代中,始终在原始形状 $n \times m$ 的大矩阵 ${\mathbf{X}}_t$ 上运算。作者团队证明了一个关键的代数定理:只要多项式具有 $p_t(x) = x h_t(x^2)$ 的奇函数形式,就可以通过一个仅涉及 $n \times n$ 对称矩阵的紧凑序列完成等价计算,而完全无需在中间步骤显式构造那些庞大的矩形张量。
形式上,Dion3 维护小尺寸的 Gram 矩阵 ${\mathbf{R}}_t \in \mathbb{R}^{n \times n}$(初始化为 ${\mathbf{X}}_0 {\mathbf{X}}_0^\top$)以及累积投影矩阵 ${\mathbf{Q}}_t \in \mathbb{R}^{n \times n}$:
\[{\mathbf{Z}}_t = h_t({\mathbf{R}}_{t-1}), \quad {\mathbf{R}}_t = {\mathbf{Z}}_t {\mathbf{R}}_{t-1} {\mathbf{Z}}_t, \quad {\mathbf{Q}}_t = {\mathbf{Q}}_{t-1} {\mathbf{Z}}_t\]整个迭代过程完全在极小的 $n \times n$ 空间内演进,直到最后第 5 步结束时,再用收敛后的累积变换矩阵去乘以原始输入矩阵:${\mathbf{X}}_T = {\mathbf{Q}}_5 {\mathbf{X}}_0$。
在数学上,Gram Newton-Schulz 的输出与原始算法完全恒等,但在计算图谱上却发生了质的飞跃。算法仅在最开始计算一次 ${\mathbf{X}}{\mathbf{X}}^\top$、并在最终输出时计算一次 ${\mathbf{Q}}_5 {\mathbf{X}}$,其余所有中间乘法都被限制在尺寸小得多的对称方阵内部。总浮点开销由原本的 $(20\alpha + 10)n^3$ 骤降至 $(4T + 3\alpha - 3)n^3$。在长宽比 $\alpha$ 较大的大模型核心层中,这一项改动直接消减了将近三分之二的矩阵乘法负载。
然而,在低精度浮点(BF16/FP16)训练环境下,朴素的 Gram Newton-Schulz 面临着严峻的数值灾难。理论上,Gram 矩阵 ${\mathbf{X}}{\mathbf{X}}^\top$ 必然是半正定的,其所有特征值均应非负;但在半精度的剧烈舍入误差下,极小的零特征值极易被污染为细微的负数。而 Gram Newton-Schulz 本质上是在迭代逼近函数 $x^{-1/2}$,一旦输入域跌入负数区间,多项式迭代就会在几步之内迅速发散,导致优化器梯度彻底爆炸。为了驯服这一隐患,Dion3 在算法中引入了轻量级数值正则化手段,在迭代流中动态过滤与截断虚假负谱,不仅确保了与标准 Newton-Schulz 严密的等价性,更保证了在低精度大规模集群上的数值稳定性。
硬件算力协同:基于 CuteDSL 的对称 GEMM 算子
算法结构改造后,计算负载从矩形乘法转移到了小尺寸方阵相乘上,且大量矩阵具备天然的对称性(如 ${\mathbf{A}}{\mathbf{B}}$ 和目标矩阵同构)。在传统的 cuBLAS 库中,并没有针对通用半精度对称更新(SYMM)的深度优化原语,强行调用标准 GEMM 意味着有一半的上/下三角计算是完全重复的。
为了把理论算力折让转化为真实的纳秒级加速,研究团队使用英伟达最新的 CuteDSL 为 Hopper 与 Blackwell 架构定制了专用的对称 GEMM 算子内核。
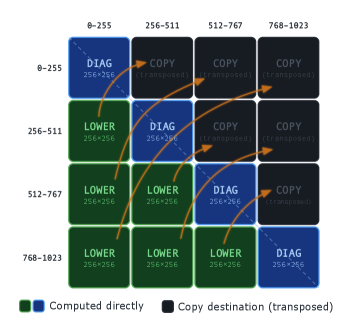
如上图左侧所示,该算子的核心机理在于两处底层改造:
-
三角瓦片调度器(Triangular Scheduler):传统调度器会将输出矩阵网格化铺满所有线程块集群(Thread Block Clusters)。而新调度器在分配工作瓦片(Tiles)时,完全忽略严格上三角区域,仅为下三角及主对角线区域派发计算任务,直接将硬件浮点计算量砍掉接近 $50\%$,并避免跨 SM 的算力空转。
-
转置写回 Epilogue(Transposed Tile Write):当下三角分块在共享内存(Shared Memory)与寄存器中完成计算后,内核在向全局显存(HBM)写回数据的 Epilogue 阶段,会同步向其转置坐标的上三角位置执行对偶写入。这一过程仅增加少量的显存寻址逻辑,却省去了一整轮矩阵转置通信或重复乘法。
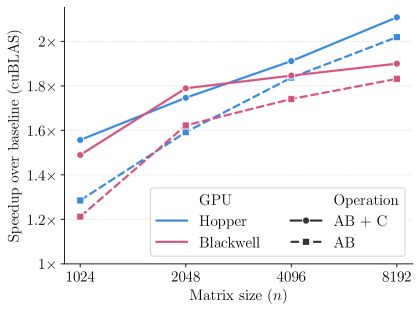
性能测试(上图右侧)显示,该算子在 Hopper(GH200)和 Blackwell 平台上,针对各种常见矩阵尺寸,吞吐量相较于工业界标杆 cuBLAS GEMM 均实现了大幅跃升。硬件级对称算子的引入,与 Gram Newton-Schulz 形成了强烈的协同效应:Gram 算法将运算集中于对称形态,而硬件算子恰好能将这种对称性压榨至硬件物理极限。
行子采样与误差反馈:更新更少,反而学得更好?
如果说前两项改进是在算子与线性代数层面上“节流”,Dion3 提出的更新规则(Update Rule)则在优化理论层面做出了一次大胆突破:每一次迭代更新,真的有必要对完整的动量矩阵做全量正交化吗?
Dion3 引入了一个关键超参数——采样率 $f \in (0, 1]$(推荐设定为 $1/4$ 或 $1/8$)。在每一个优化器步中,算法依据各行的 $\ell_1$ 范数,仅挑选出动量矩阵中数值最大的前 $k = \lceil fn \rceil$ 行组成子矩阵进行正交化处理;其余行在当前步完全不参与正交化与权重更新。
这一操作对性能的释放是毁灭性的。正交化阶段的有效维度从 $n \times m$ 骤降至 $fn \times m$。由于 GEMM 运算复杂度关于选定维度呈二次方敏感,这使得正交化的浮点计算量呈 $1/f^2$ 倍率萎缩(当 $f=1/4$ 时,理论算力压缩达 16 倍)。更为巧妙的是,行采样直接将矩阵有效宽高比拉大了 $1/f$ 倍,而这恰恰精准命中了 Gram Newton-Schulz 最擅长的高偏斜度场景,形成了计算加速的双重共振。
但挑选局部行的做法必然会引入信息截断,未被选中的行难道不会导致模型收敛滞后甚至梯度漂移?
Dion3 能够维持甚至超越 Muon 收敛精度的关键,在于引入了源自压缩通信理论的误差反馈(Error Feedback)机制。在标准的动量衰减策略中,整个动量矩阵每步都会衰减:${\mathbf{M}} \leftarrow \mu {\mathbf{M}}$。而在 Dion3 中,衰减被严格限制在被选中的行上,未选中的行在当前步不施加 $\mu$ 衰减:
\[{\mathbf{M}}[\mathcal{S}, :] \leftarrow \mu {\mathbf{M}}[\mathcal{S}, :], \quad {\mathbf{M}}[\mathcal{S}^c, :] \leftarrow {\mathbf{M}}[\mathcal{S}^c, :]\]从数学本质上看,这一规则等价于在全局动量更新中显式补偿了一个残差项 $(1-\mu)({\mathbf{M}} - \widehat})$。这意味着,即使某一行所对应的参数更新幅度微弱、单步未能入选前 $f$ 比例,其历史梯度也不会被动量衰减白白磨灭,而是像雪球一样在残差池中持续蓄力,直至在后续某一步跨入阈值并被调度执行。
此外,研究人员在工程实测中抓到了一个极为隐蔽的数值陷阱:通常 PyTorch 编译器在执行常规权重更新时会自动进行内核融合,将 BF16 转换为 FP32 计算再转回。但行子采样的引入破坏了编译器的自动融合路径,引发了多次不必要的低精度截断,使得模型收敛受损。团队通过手写 Triton 算子,重构了行选择与参数更新融合流水线,并在 FP32 精度下锁死 NorMuon 归一化计算,彻底抹平了低精度漂移。令人惊讶的是,在完整的预训练消融实验中,带有误差反馈的 Dion3 最终收敛曲线不仅完美对齐了标准 Muon,在部分高饱和度场景下的更新质量甚至出现了微弱反超。
Megabatching:常数级分布式通信
当单卡上的计算被压缩殆尽后,分布式环境下的网络墙便显露出来。在标准的 FSDP 机制下,随着网络深度增加,Transformer 内部层层叠叠的张量被分段处理,导致卡与卡之间在每一轮优化器步内都需要发起成百上千次细碎的 All-to-All 握手。
Dion3 的分布式通信方案极其简洁而有效:大批次聚合通信(Megabatching)。
Transformer 结构尽管参数庞大,但在几何形状上却高度规整,全模型通常只由少数几种固定的矩阵形状构成(如注意力投影与 FFN 内部层)。Megabatching 会扫描整个计算图,将全网所有具有相同几何形状的分片张量打包装入同一个连续内存桶(Bucket)内。每个形状组在整个优化器步中仅仅触发一次全局 All-to-All 组装,在单卡显存内一次性完成成批批处理正交化,随后再通过单次反向 All-to-All 分发回各 Rank。
这种处理将分布式通信轮数从与模型层数深度绑定的 $O(L)$ 复杂度,直接打回到仅取决于形状种类的常数复杂度 $O(1)$。配合行子采样技术,跨卡通信的实际数据体积被进一步缩减至原本的 $f$ 倍。实测基准表明,在对通信延迟极其敏感的 1B 模型多卡切分场景下,仅 Megabatching 一项改动,就令优化器步的端到端耗时纯减了 $35\%$。
总结:迈向全栈自适应的大模型训练底座
Dion3 的贡献不仅在于打磨出了一个极速的优化器实现,更在于它向工业界展示了现代 AI 训练系统演进的核心脉络:高阶优化算法的收益绝不能只停留在纸面上的“步数减少”,而必须穿透算法、精度、数学重构、底层算子直到分布式拓扑的全栈架构。
从算法演化角度来看,Dion3 扫清了 Muon 全面替代 AdamW 的最大阻碍。以往由于 Newton-Schulz 正交化的恐怖开销,研究人员在面对长宽比悬殊的超大 MoE 架构或高通信比集群时往往对二阶方法望而却步;而 Dion3 证明了,通过在小 Gram 矩阵上重组计算图、利用对称性剪裁冗余内核算力,再辅以带有误差反馈的子采样机制,正交更新的计算代价完全可以被驯服至传统一阶优化器的同等量级。目前该方案已以 dion 与 gram-newton-schulz 两个即插即用 Python 库的形式完全开源,大模型训练基础设施向全正交更新演进的阻碍,已被推平了大半。