DeepMind与哈佛揭示大模型交互盲区:欠指定程度越高,越爱盲目提前作答
Do LLMs Know What to Ask and When? Evaluating Multi-Turn Information Seeking
在很多涉及多轮对话的真实场景中,用户抛出的初始任务往往是“信息欠指定”(Underspecified)的。比如去医院就诊时,患者只说“肚子疼”,医生绝不可能立即给出确诊方案,而必须通过层层追问排查病因;编写复杂代码或分析业务逻辑时,缺失前置参数的模型也理应主动澄清,直到约束条件足以锁定唯一答案。
ArXiv URL:https://arxiv.org/abs/2608.14808v1
然而,来自 Google DeepMind 与哈佛大学(Harvard University)的联合研究团队在一篇最新论文中指出,当前最前沿的大语言模型在多轮交互中普遍存在致命的“认知盲区”:它们能够隐约意识到信息不够,却极度低估到底缺了多少信息;在需要多步排查的任务中,模型不仅找不齐关键变量,还常常在信息尚未闭环时就盲目提前终止提问、仓促给出猜测答案。 更耐人寻味的是,传统以“最终回答正确率”为主的评测体系严重掩盖了这一缺陷,因为模型完全可以凭借强大的先验知识或概率蒙混过关。
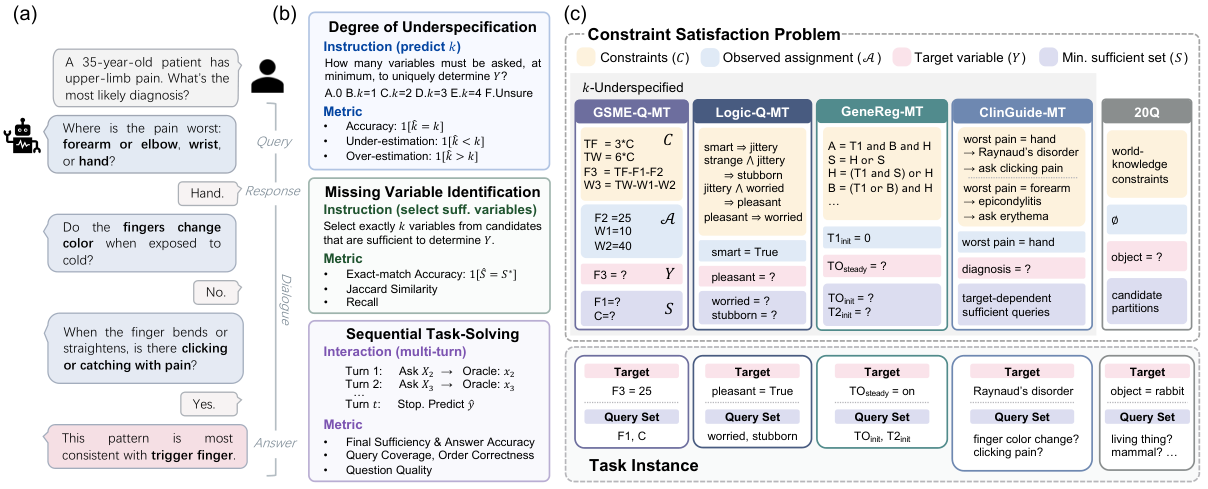
为了从根本上解耦“提问寻源能力”与“生成答案能力”,研究团队将多轮信息搜寻(Multi-Turn Information Seeking)严格形式化为求解 $k$-欠指定约束满足问题($k$-underspecified CSP),并推出了涵盖数学、逻辑、生物、医学与开放常识的全新基准套件 MT-InfoSeek。评测结果表明,在逻辑推理任务中,当缺失变量数 $k=2$ 时,模型低估缺失信息量的频率竟是高估频率的近 4 倍;而在有依赖顺序的临床诊断任务中,即便模型最终凑齐了所有线索,错误的追问顺序依然会导致推理准确率断崖式下跌。
为什么说传统的交互评测“测了个寂寞”?
在现有的对话评测或多轮问答基准中,研究者通常只看最终的准确率(Final Accuracy)或让大模型裁判给对话质量打分。但这种设置存在一个巨大的混淆变量:生成答案的能力并不等同于搜寻信息的能力。
举个极端但常见的例子:在很多医疗问答测试集(如 MediQ)中,一个参数量约 30B 的模型仅仅依赖最初给出的残缺病历,就能直接猜对 60% 至 70% 的诊断。如果仅凭最终答案判定,研究人员会误以为模型具备敏锐的问诊能力;但实际上,模型根本没有收集到足以排除其他罕见病的决定性证据,它只是顺着统计先验输出了最常见的高频疾病。
单轮澄清提问同样无法揭示真实交互中的决策动态。此前类似 QuestBench 等工作虽然引入了约束满足问题,但大多局限在 $k=1$ 的特例,即“只缺一个变量,问一次即可答”。在现实决策中,关键变量之间往往存在联合制约甚至顺序依赖关系。系统每询问一个变量,候选解空间就折叠一次;模型不仅要决定在当前轮次问什么,更必须判断当前的条件是否已经严格满足了唯一解的触发阈值。
为了解决这一难题,该研究将问题定义为元组 $P=\langle\mathcal{X},\mathcal{D},\mathcal{C},\mathcal{A},Y\rangle$,其中 $\mathcal{X}$ 为变量集,$\mathcal{C}$ 为逻辑约束,$\mathcal{A}$ 为当前已知的局部赋值,而 $Y$ 是目标变量。模型的目标是通过多轮交互向神谕(Oracle)查询未知变量,逐步缩减可行空间 $\Omega(P)$。这里最关键的概念是 最小充分集(Minimal Sufficient Set, MSS) 与其大小 $k$——即至少需要同时获得 $k$ 个变量的赋值,目标变量 $Y$ 的可行解才能被唯一确定。
研究的核心评估指标随之确立:最终充分性(Final Sufficiency)。该指标与模型最后生成的答案文本完全解耦,仅用符号逻辑严谨检测模型在多轮对话中实际搜集到的变量集合是否构成了 MSS。如果收集到的线索根本不能逻辑锁死唯一解,无论模型猜得多么漂亮,在“信息搜寻”这一维度上都被判定为失败。
MT-InfoSeek:横跨五大领域的受控评测基准
MT-InfoSeek 包含了 5,251 个核心问题和 9,006 个任务实例,构建了四个结构化领域与一个开放域交互环境,全面覆盖不同推理深度与变量依赖模式:
-
逻辑推理(Logic-Q-MT):基于一阶逻辑和规则库构建的多轮逻辑推理,严格递归生成 $k$-MSS,模型必须顺着命题规则链条找出所有缺失事实。
-
符号数学(GSME-Q-MT & GSME-Q-MT-Ext):基于小学数学方程组进行变量遮蔽。研究团队发现普通方程遮蔽已被现有大模型攻破,因此进一步设计了具备深度依赖网络和严格校验的扩展版 GSME-Q-MT-Ext。
-
基因调控网络(GeneReg-MT):将生物学中的布尔网络调控规则作为约束,变量是基因表达状态,目标是在存在循环依赖的网络中通过询问初始状态来预测稳态或标志基因。
-
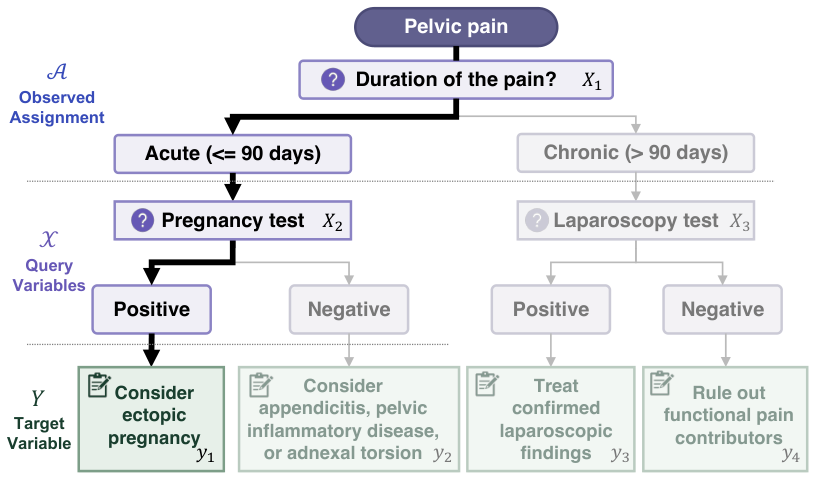
临床诊断路径(ClinGuide-MT):直接取自权威临床指南与医学教材的决策树(如下图所示)。内部节点为症状、病史与检查项,叶子节点为最终诊断或处置方案。由于前序检查结果直接决定后续该做什么检查,该数据集天然蕴含严格的“追问顺序依赖”。
-
开放域二十个问题(20Q):在无预设变量集合的开放式自然语言交互下,模型通过自主生成 Yes/No 疑问句来二分候选搜索空间,测试非受限环境下的不确定性消除能力。
为了防止模型依赖记忆走捷径,每个问题 $P$ 都衍生出一个完整的任务家族(Task Family)。它们共享完全相同的初始已知条件 $\mathcal{A}$,但在隐藏的目标值 $y$ 上各自不同。这意味着模型哪怕记住了一万道题,如果不老老实实通过交互提问把解空间压榨到唯一状态,就绝不可能在整个任务家族上取得稳定成功。
核心发现一:能感知缺失,但严重缺乏“信息自知之明”
在对 GPT-5、Gemini-3-Flash、Qwen3 系列等顶尖模型进行全方位评测后,研究团队首先观察到了一个跨领域普遍存在的现象:随着信息欠指定程度 $k$ 的增加,所有模型的表现均呈单调下降趋势。
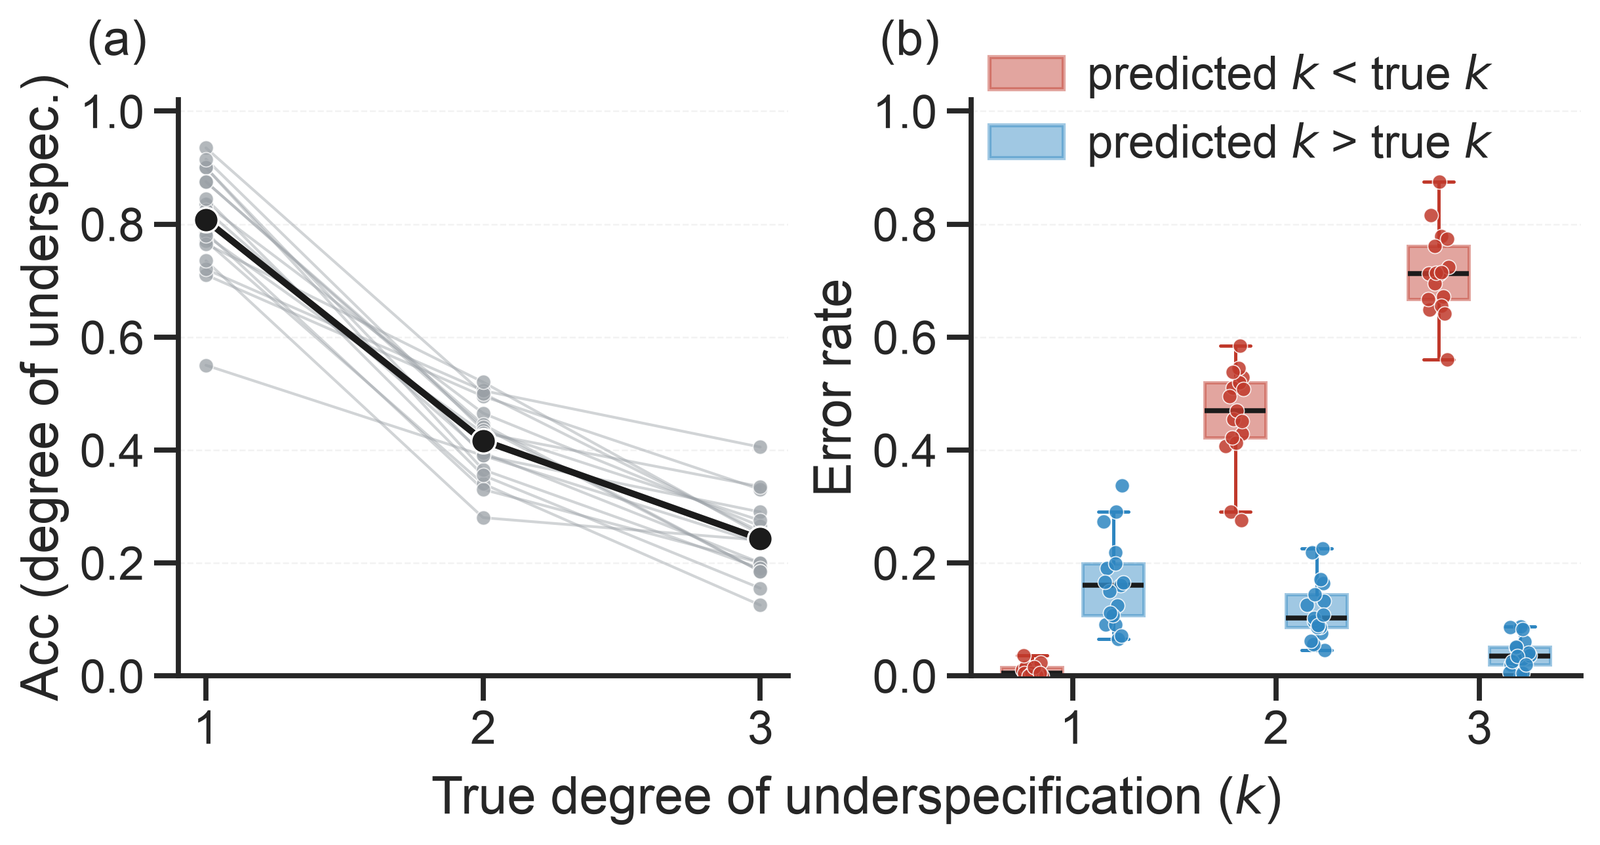
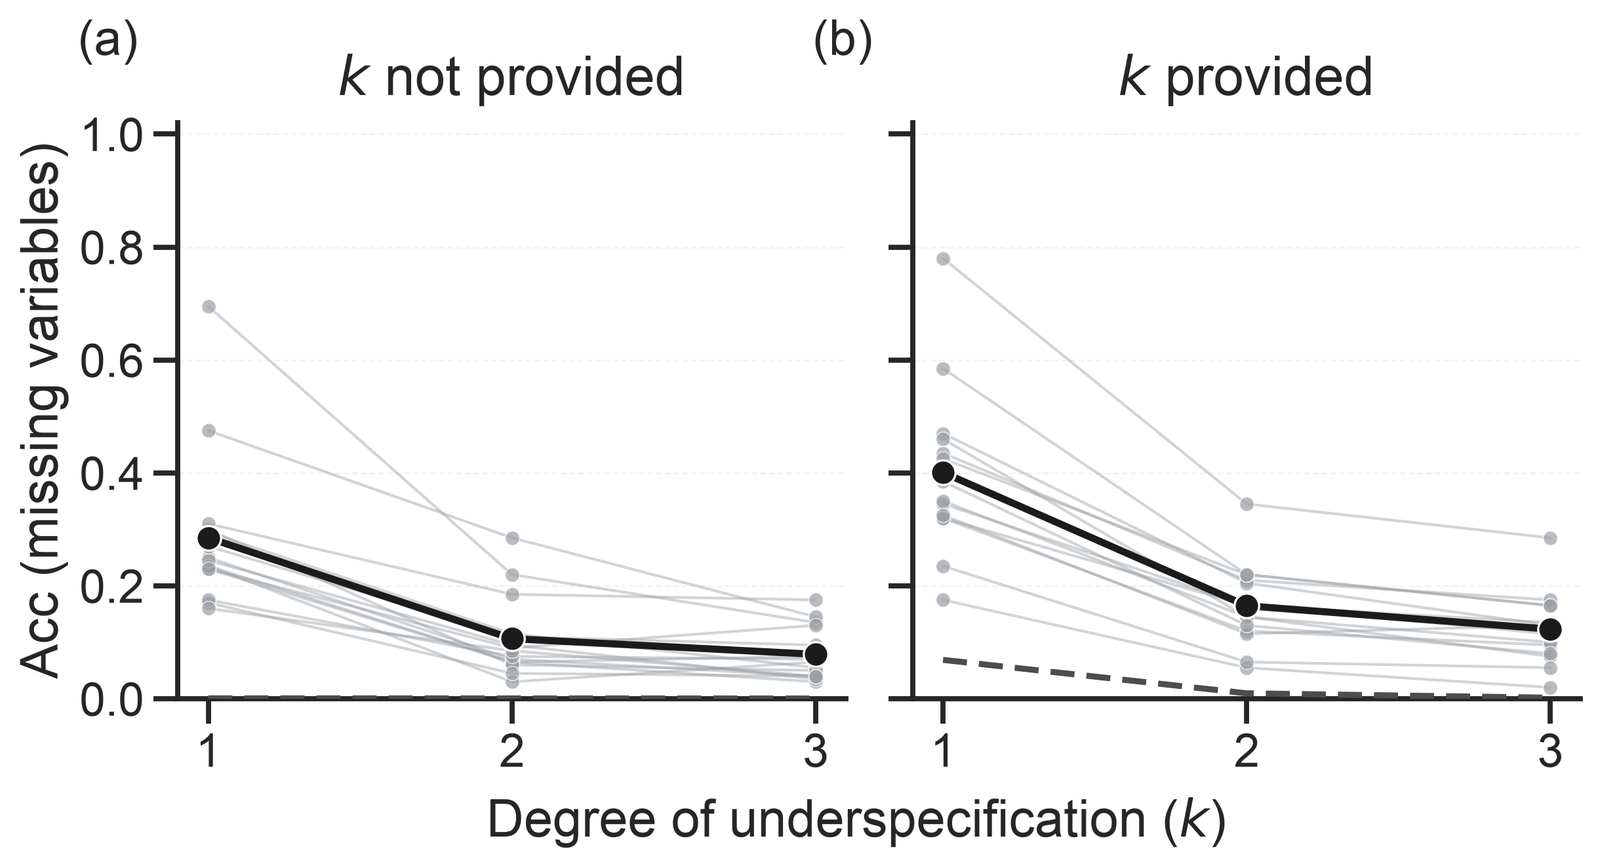
更为致命的缺陷在于模型对“自己不知道什么”的定量感知极差。在 $k$-预测评估中,模型虽然大多能够判断出“当前问题信息不全”(即能够识别 $k \ge 1$),但对到底缺少多少个变量存在系统性的盲目乐观。在 Logic-Q-MT 任务且真实 $k=2$ 时,模型低估缺失变量数(预测 $\hat{k} < k$)的概率是高估变量数(预测 $\hat{k} > k$)的近 4 倍。
模型天然地认为问题比实际情况更简单,这直接导致了行动上的早熟收敛:在多轮交互任务中,模型往往提问了一两轮后,就自作主张地停止询问并开始作答,此时搜集到的变量远远没有达到最小充分集的要求。
更耐人寻味的是,研究人员尝试“作弊”直接告诉模型真实的 $k$ 值。按常理推测,既然模型容易低估信息量,提示真实 $k$ 应该带来巨大飞跃。但实验结果却令人大跌眼镜:即使在提示中明确告知“你必须搜集满 $k$ 个变量才能得出结论”,模型的最终充分性与准确率也仅仅获得了极其边缘的微小改善。这说明问题不仅出在元认知层面的估计错误,更深层次的原因是模型在推理链条中根本缺乏反向追溯变量依赖关系、从候选池中精准抽离出最小充分集(MSS)的规划能力。
核心发现二:顺序只要颠倒,拿到全量信息照样抓瞎
在单轮问答中,只要信息在 Prompt 内部,自注意力机制原则上可以自由关联上下文;但在真实物理世界与多轮交互中,获取信息的步骤往往具有单向因果性或条件依赖性。
在 ClinGuide-MT 的临床路径评测中,研究团队深入分析了“提问顺序”对最终决策的影响。由于临床决策树是分层的,前一步检查(例如“是否绝经”)决定了下一步检查是关注激素水平还是子宫内膜厚度。实验清晰地表明:即便模型最终在多轮交互中侥幸把路径上的所有变量都问了一遍,如果提问顺序违背了临床逻辑树的从属关系,模型的最终准确率依然会遭遇显著下滑。
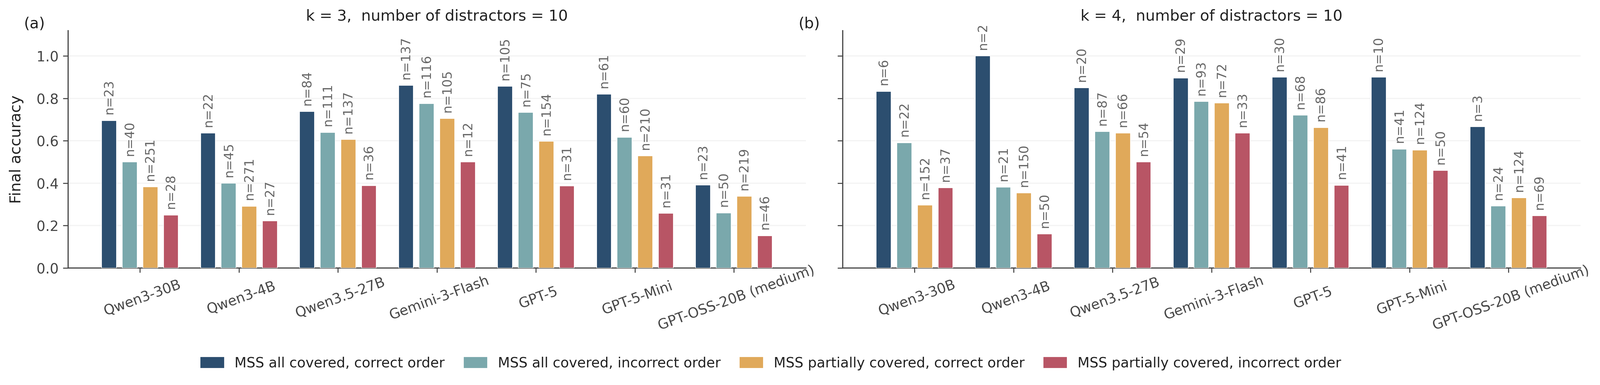
如上图的控制实验所示,当固定模型获取全量充分信息时,顺序完全合规组的准确率显著高于乱序组。多轮交互中的长上下文并非简单的变量累加池;大模型在面对以不合理顺序涌入的信息时,其内部的隐式状态机容易陷入注意力涣散或错误的推理分支,难以将后置变量正确回溯并绑定到前置条件上。这提示我们,未来针对 Agent 的指令微调与强化学习,绝不能仅仅奖励“有没有问”,必须对“何时去问”施加严厉的因果顺序惩罚。
核心发现三:解耦提问与回答,看清模型的假性恢复
为了厘清模型到底是在什么时候丧失了方向,研究人员通过相关性热力图与早期恢复斜率,系统追踪了模型在多轮对话中推理轨迹的变化过程。
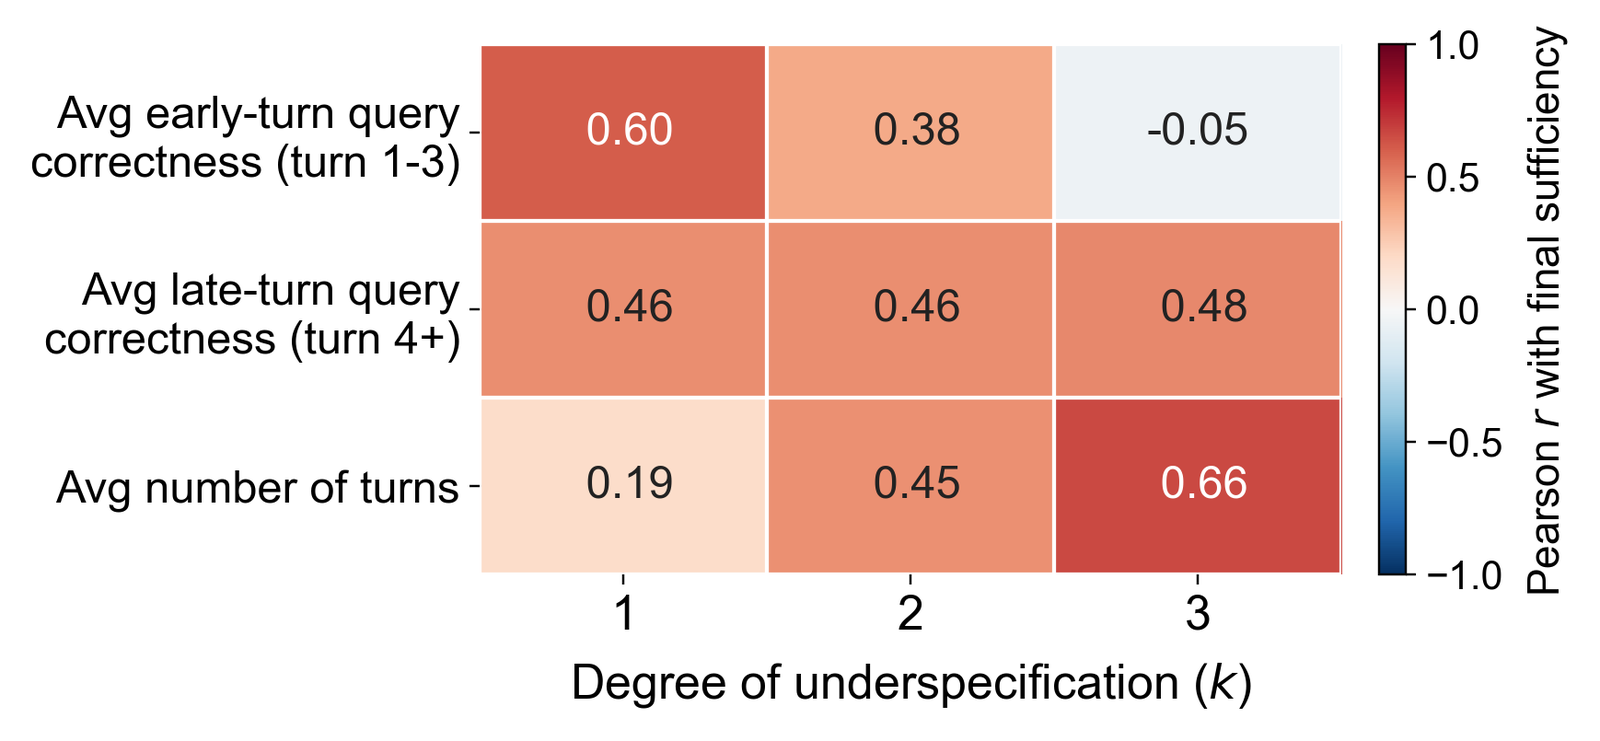
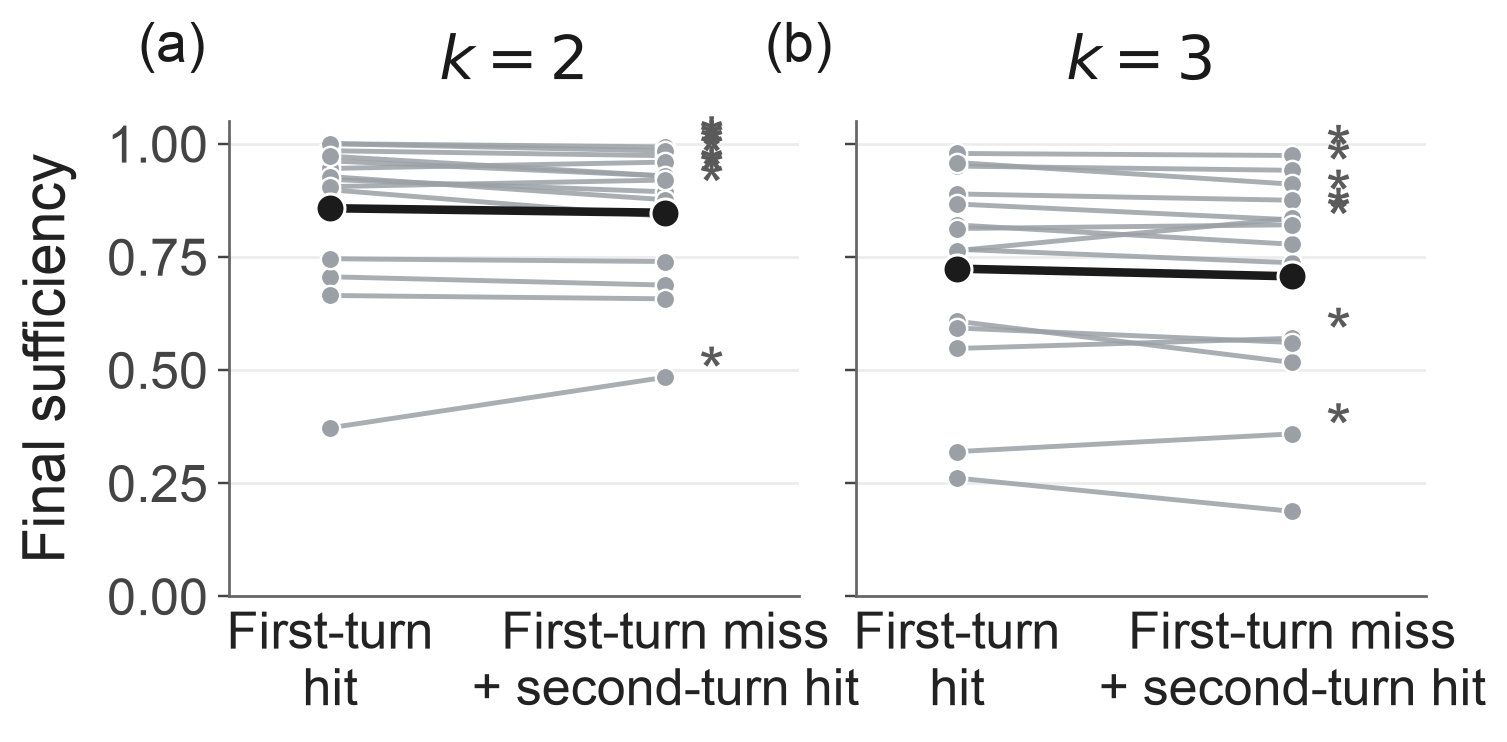
从相关性热力图可以看出,“最终充分性”(Final Sufficiency)与“最终准确率”(Final Accuracy)之间虽然存在正向关联,但在诸多复杂子集上两者的相关系数远非绝对同步。许多模型在最终充分性低于 40% 的恶劣局面下,依然能跑出 60% 以上的最终准确率。这正是论文反复警示的现象:传统评测给予了模型靠猜得分的空间,从而严重夸大了它们在非完整信息下的智能水平。
而在分析模型在首轮思考过程(CoT)及早期的表现时发现,模型在初始阶段考虑提问的变量中,属于最小充分集的比例(MSS relative mention rate)往往在第一步就决定了后续整场交互的走势。如果在前一到两轮,模型由于搜索空间过于宽泛而提出了边缘化、无信息增益的问题,其在后续轮次中自主“纠偏”的能力极其孱弱。早期恢复斜率分析证实,大部分开源与闭源模型在偏离正确依赖路径后,随着交互轮次增加,其累积不确定性不仅没有减少,反而因为无序信息注入导致状态塌陷,提问越来越盲目。
在 20Q 开放域任务的轨迹追踪中(如上图所示),研究团队还监测了一个重要指标——Pass Support Mass(即当问题抛出时,候选集中有多少目标会导致无法得到非黑即白的清晰回应)。越到交互后期,随着剩余候选对象之间越来越难以区分,模型提出的问题中边缘、模糊、引发 Pass 状态的质量缺陷明显增多。但顶级模型展现出的韧性在于:即便面对高 Pass 率的模糊反馈,它们依然能够尝试利用部分残余证据更新候选信念状态,而稍逊一筹的模型则直接把这一轮反馈当成无意义噪声抛弃,彻底丧失收敛到唯一解的能力。
从单向生成到主动探索的范式转变
这项由 DeepMind 与哈佛大学主导的研究,戳破了当前大模型在“多轮自主交互”能力上的某种虚假繁荣。
长久以来,业界沉浸于大模型在静态单轮 Benchmark 上不断刷新的高分,并将 Agent 的交互神话寄托于“Prompt 加上 ReAct 框架”。但 MT-InfoSeek 用严密的形式化数学语言证明:当前的 LLM 根本没有建立起稳固的“信息论直觉”。面对不完整世界时,它们缺乏对自身认知边界的准确刻画,不仅容易轻敌地低估缺漏程度,在需要多步筹谋、依序探索的信息链条前更是频频失控。
将“信息搜寻(Information Seeking)”从“答案生成(Answer Generation)”中彻底解耦出来,是这项工作为大模型评测领域带来的最重要启示。它明确告诉所有开发者与研究者:不要被高命中率的最终输出所迷惑,必须把探针扎入到多轮对话的每一步决策中,严格检验模型在约束空间下的提问充分性与因果拓扑逻辑。
无论是走向临床辅助决策的医疗 AI,还是需要自主排查系统故障的运维 Agent,未来真正可靠的交互系统,核心竞争力往往不在于懂得多少预存的知识,而在于是否清楚知晓自己何时该闭嘴、何时该发问、以及如何用最克制而精准的提问,一步步驱散眼前的迷雾。