DriveVLA-M0:结构化失败记忆解耦修正,26ms低延迟拿下94.1分
DriveVLA-M0: Failure-Aware Memory Augmentation for Autonomous Driving
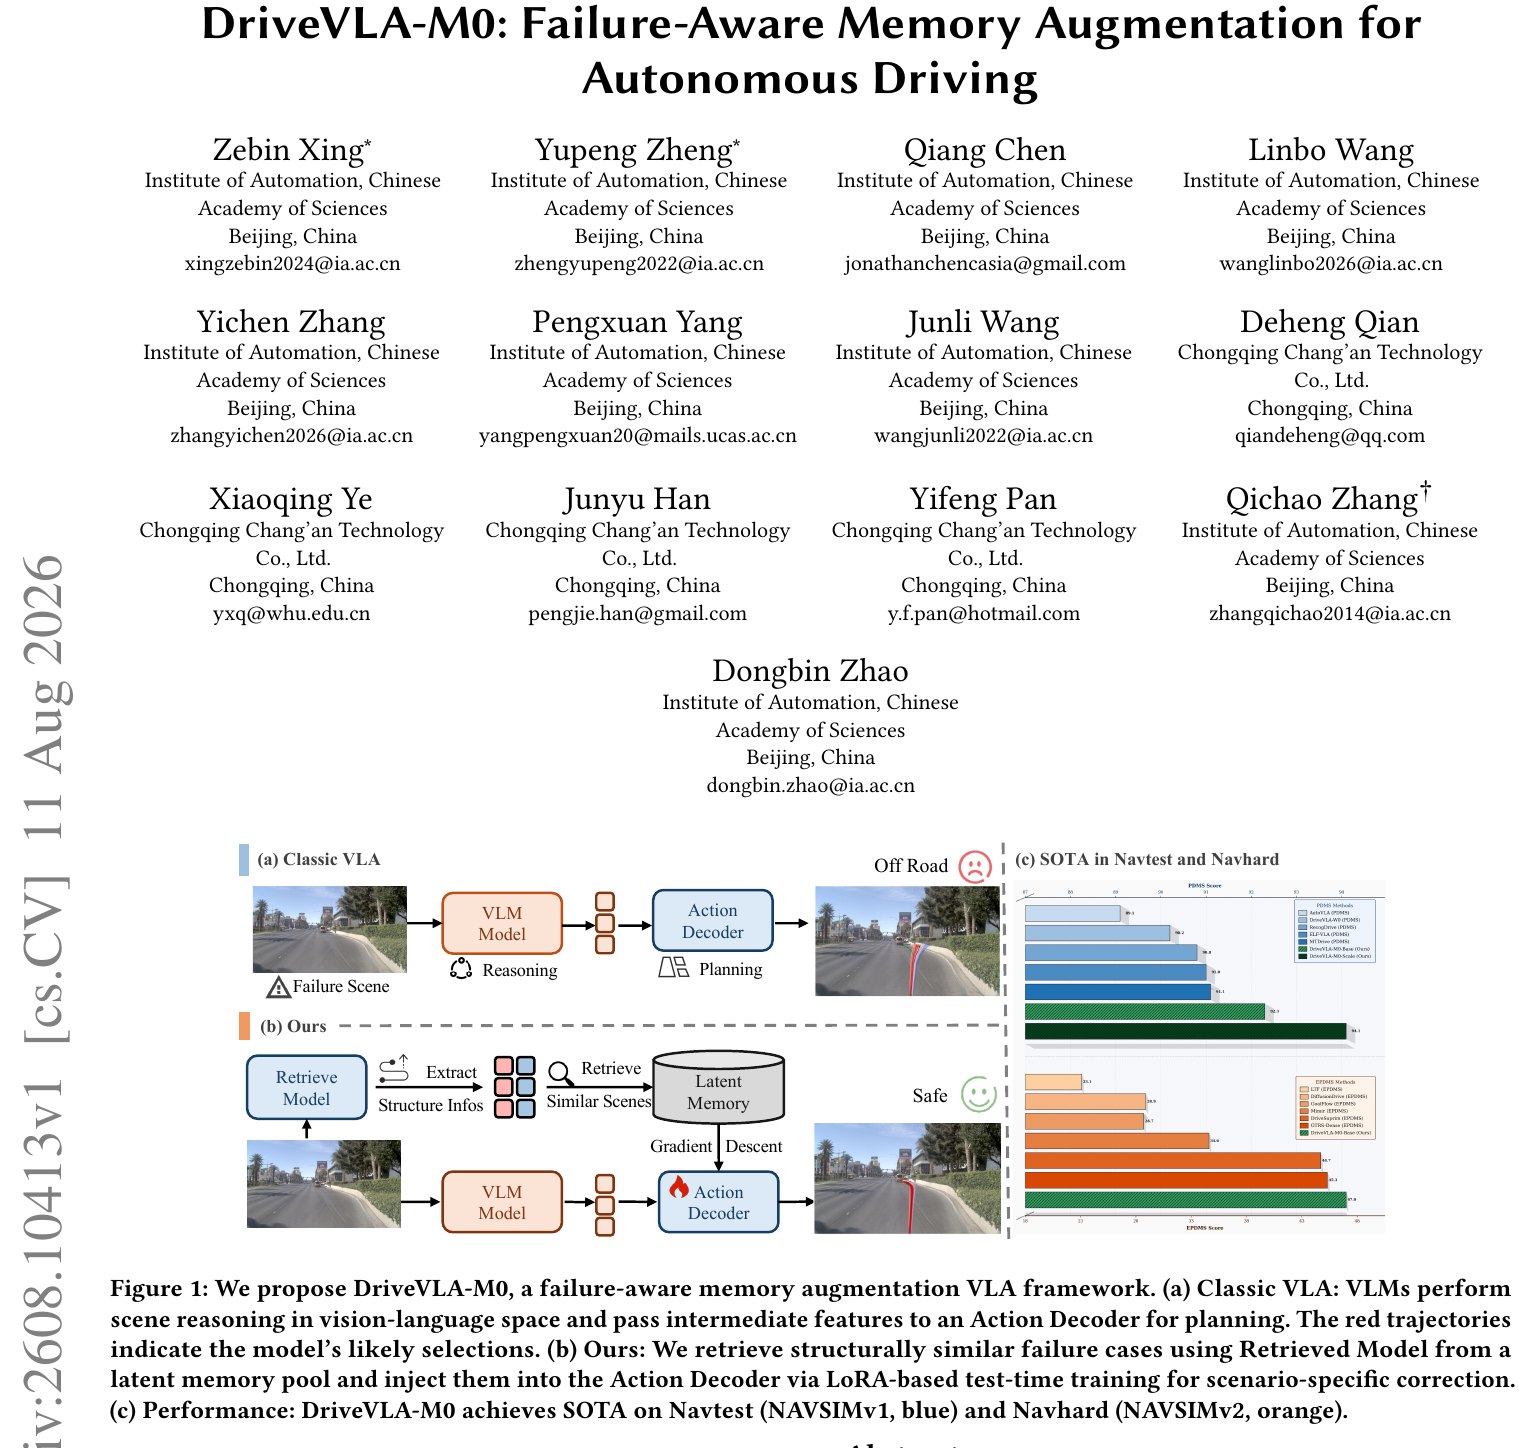
端到端自动驾驶(End-to-End Autonomous Driving)与视觉-语言-动作(VLA)大模型的结合,正在重塑车辆对复杂现实世界的认知与决策范式。借助多模态大语言模型(VLM)强大的常识推理与语义解析能力,现代智驾系统能够理解道路施工引导、复杂交互手势甚至突发的偶发事件。然而,这类模型在工程落地上却面临着一个致命缺陷:它们常常在相似的Corner Case中“反复掉进同一个坑里”。由于标准的大模型推理过程权重固定,面对长尾场景或分布偏移,系统缺乏像人类驾驶员那样从过去的失误中提取教训、进行即时心智修正的能力。
ArXiv URL:https://arxiv.org/abs/2608.10413v1
来自中国科学院与重庆长安科技的研究团队提出了 DriveVLA-M0。这项工作不再试图通过无休止的离线全量重训来抹平所有长尾错误,而是开创性地为自动驾驶VLA系统构建了一套带有“失败感知”的结构化隐式记忆库与测试时自适应机制。在面对高危或容易出错的场景时,系统能够基于场景的物理结构精准检索历史失败切片,并利用轻量解耦的 LoRA 在测试时(Test-Time Training, TTT)进行针对性在线修正。
该方案在业内公认的高难度基准 NAVSIMv1 上取得了 94.1 PDMS 的优异成绩,在更具挑战性的伪闭环测试 NAVSIMv2 Navhard 上达到 47.0 EPDMS,而引入的 TTT 反向微调耗时仅为 26.44 ms。更重要的是,DriveVLA-M0 展现出一种免训练扩展能力:无需修改基础模型权重,仅通过向记忆库注入新的仿真合成失败案例,就能实现系统鲁棒性的持续提升。
为什么通用的“语言特征记忆”难以拯救自动驾驶?
在具身智能(Embodied AI)和机器人领域,记忆增强机制并不鲜见。近期的 MemoryVLA 等工作尝试保存历史视觉-语言特征,以便在长流程任务中维持状态一致性。然而,自动驾驶对空间几何关系与动态博弈的要求,远比机械臂抓取更为严苛。自动驾驶决策极其依赖两类本质物理信息:以车道线拓扑和道路边界为代表的静态几何结构,以及周围交通参与者时空轨迹所构成的动态博弈状态。
如果直接沿用通用的中间视觉-语言特征作为检索键(Retrieval Keys),系统极易落入“语义相似但物理相悖”的陷阱。例如,一段在林荫大道下的顺畅直行与另一段发生追尾风险的复杂路口,在宏观文本描述与高层视觉嵌入中可能具有高度相似的上下文表征;但在自车与障碍物的动态距离、相对速度或前方车道分流节点等物理维度上,二者完全不可同日而语。这种语义与物理结构的错位,会导致检索出的历史经验不仅无法纠偏,反而可能引入错误的几何先验。
此外,自动驾驶系统并非在所有路况下都需要外部记忆介入。普通巡航或标准车道保持任务完全在基础策略的高置信区间内,强行在每个时间步进行全局记忆检索与参数调整,不仅会徒增端到端延迟,更可能破坏原有模型的稳定性。人类驾驶员只有在察觉当前工况逼近自身经验盲区、或者与某次险情高度相似时,才会神经紧绷并调整操作策略。自动驾驶 VLA 模型亟需建立针对“潜在失败工况”的定向自省与结构化关联机制。
静态与动态解耦:构建具有物理意识的失败记忆库
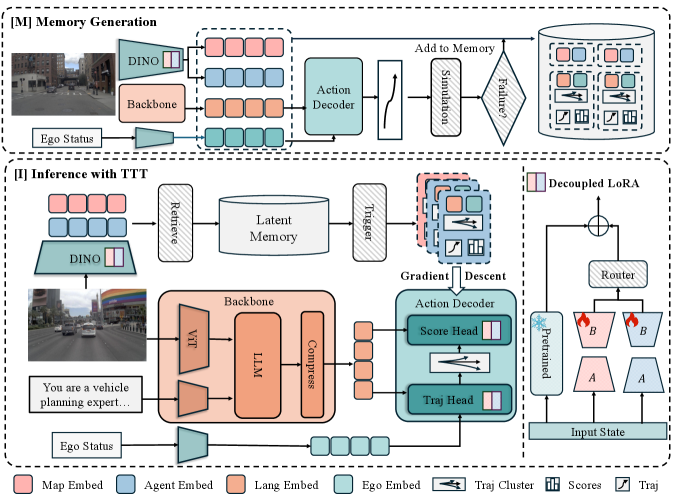
DriveVLA-M0 的破局点在于其两阶段闭环设计:离线阶段的失败记忆库生成(Memory Generation),与在线阶段的测试时修正(Inference with TTT)。
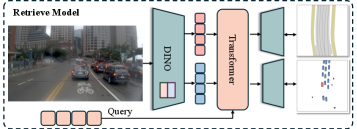
在离线阶段,基础模型在历史训练集或高保真仿真环境(如 SimScale)中运行,通过真值仿真评分(Oracle Simulation Metrics)自动挖掘出基础模型规划失败的样本。这些被挖掘出的案例构成了隐式记忆库 $\mathbb{M}$。为了克服前述语义特征对物理结构表达的不足,研究团队没有直接存储海量的原始视频 Token,而是设计了由 DINO 骨干与专用分支构成的检索模型(Retrieve Model),将场景解耦为静态道路拓扑与动态目标交互两个独立的物理维度:
\[F_{\text{map}}, F_{\text{agent}} = \mathrm{DINO}_{\text{LoRA}}(I)\]在训练检索模型时,静态分支受车道线、道路边界等二值交叉熵损失(BCE)监督,动态分支则专门受交通参与者栅格占用监督。
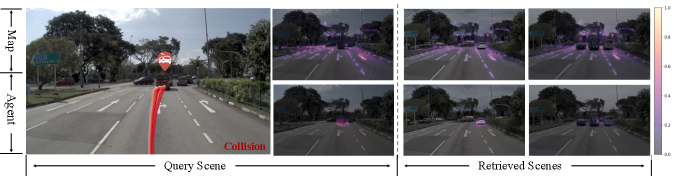
从上图的可视化注意力热力分布可以清楚看到这种解耦设计的成效:上层的地图嵌入专注于车道拓扑、边界标线及路口分流区域;下层的目标嵌入则精确聚焦于本车前方具有碰撞潜在威胁的动态车辆与行人。记忆库中的每个失败案例,最终被封装为三元组:用于检索的静态与动态特征键 $k = (F_{\text{map}}, F_{\text{agent}})$、动作解码器的中间压缩特征 $x = (F_{\text{lang}}, F_{\text{ego}}, \hat{\mathbb{T}})$,以及对应的高质量专家轨迹与安全评估标签 $y = (\tau, \mathbb{S})$。这种存储方式不仅规避了保存原始高清视频序列的显存负担,更确保了检索过程完全锚定在场景的物理骨架之上。
毫秒级在线修正:Decoupled LoRA 测试时训练机制
在线部署过程中,车辆传感器输入前视画面后,系统并行推进常规规划与记忆自检。基础模型以微调后的 InternVL3 作为 VLM 骨干提取场景特征,经过 Q-Former 风格的特征压缩模块,将原先庞大的 $2800 \times 1536$ 视觉 Token 压缩为仅 16 个紧凑的表征向量 $F_{\text{lang}}$,极大削减了后续动作解码模块的计算负载。
与此同时,解耦检索模型提取当前帧的静态与动态特征,并与离线失败记忆库计算余弦相似度。为了保证推理安全与效率,系统设置了一个门控触发机制(Trigger Gate):
\[g = \begin{cases} 1, & \text{if } \frac{F^{\top}F^{*}}{\|F\|_{2}\|F^{*}\|_{2}} > \lambda \\ 0, & \text{otherwise} \end{cases}\]只有当当前场景与库中某个历史失败案例在几何拓扑或动态博弈上的结构相似度越过阈值 $\lambda$ 时,TTT 修正机制才会被激活。如果相似度较低,说明当前场景处于模型熟悉的安全操作包线内,系统直接沿用基础模型输出,不产生任何微调开销。
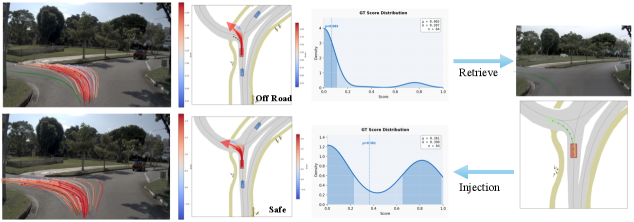
一旦门控被触发,意味着模型已行进至历史验证过的“易错区”。系统随即拉取匹配的历史失败上下文及其专家校正标签,通过 Decoupled LoRA 对动作解码器(Action Decoder)的规划头进行极速反向微调。这一设计的精巧之处在于参数更新的定向分流:静态地图检索拉取的高曲率或奇异道路案例,专门更新动作解码器中的 Map LoRA 分支;动态障碍物检索拉取的切车或急刹案例,则专门更新 Agent LoRA 分支。
上图直观展示了这一过程对规划决策的重塑作用。在未经记忆修正的失败场景下,动作解码器生成的轨迹候选群(Proposals)高度收敛于不安全的局部解(如打分分布聚集在低分区域),模型在候选轨迹中“矮子里面挑高个”,最终不可避免地导致违规或碰撞。而在通过解耦 LoRA 注入专家修正信号后,轨迹提议的整体质量显著改善,真实有效得分的分布明显向右推移,促使系统能够轻松选中避开风险的专家级轨迹。
严苛评测下的关键突破与消融验证
为了验证 DriveVLA-M0 的泛化能力与真实落地价值,研究团队在自动驾驶业界公认严苛的 NAVSIMv1 和全新的 NAVSIMv2 基准上进行了全面评测。NAVSIMv2 相比前代大幅提升了测试标准,引入了车道保持(LK)、行车方向合规(DDC)、红绿灯遵循(TLC)以及扩展舒适度(EC)等更为贴近闭环真实驾驶体验的指标,并采用分阶段分支仿真的伪闭环评估协议。
在 NAVSIMv1 的 Navtest 上,搭载记忆库与测试时自适应的 DriveVLA-M0 展现了统治级水准:
-
基础版本的 DriveVLA-M0-Base 在仅包含 4,000 个记忆案例时,综合预测驱动度量分(PDMS)即达到 92.3,全面超越此前的经典端到端与 VLA 架构。
-
在引入由仿真管线生成的额外长尾数据、将隐式记忆库免重训扩容至 10,000 个案例后,DriveVLA-M0 的 PDMS 进一步攀升至 94.1。这一表现不仅刷新了该榜单的最高水平,更证明了外挂记忆库具备近乎线性的经验扩展红利。
-
在 NAVSIMv2 极具挑战性的 Navhard 评测集中,该模型取得了 47.0 EPDMS,在无保护左转、非规范路口博弈等安全极度敏感的场景下,碰撞率与可行驶区域合规性均录得大幅改善。
在车载算力极其宝贵的工程现实面前,任何脱离时延谈自适应的方案都难以真正上车。研究团队在单张英伟达 H20 GPU 上针对系统效率展开了精细测算。实验数据显示,在检索规模达到 4,000 个样本的情况下:
-
依赖高维向量索引优化,完成一次静态与动态双分支特征的相似度检索仅需 15.19 ms;
-
基础模型的单次前向推理耗时控制在 30.79 ms;
-
最为关键的测试时训练环节,得益于参数更新被严格限制在 Decoupled LoRA 的低秩适配层内,其反向传播更新计算耗时仅为 26.44 ms(相比之下,全量更新动作解码器需要 55.42 ms)。
这意味着,即便是完整的“检索-微调-二次推理”流程,也能被精准压缩至车载系统的控制周期窗口之内,同时系统依赖门控机制,仅在关键帧按需触发,从而在绝大多数时间内保持毫秒级轻量运行。
范式演进:从暴力重训走向动态经验外挂
回顾端到端自动驾驶近年来的演化路径,工程界长期面临两难取舍:采用小模型难以具备长尾语义理解能力,而采用基于大语言模型的 VLA 范式,则面临高昂的训练成本与固定的策略权重。每次在实车路测中发现新的 Corner Case,往往需要重新组织数以万计的数据对模型执行全量或重度后训练(Post-Training),不仅周期漫长,更极易引发灾难性遗忘。
DriveVLA-M0 提供了一种极具实用主义色彩的解题新思路:将常识理解、物理感知与错误应对经验在系统架构层剥离。底层大模型负责扎扎实实地提供通用场景理解,而千奇百怪的长尾险情与应对策略则沉淀在动态、可即时插入的“物理结构失败记忆池”中。当车辆面对未曾涉足的险境时,它所调用的不再仅是静态参数空间里的泛化猜测,而是直接调取过往事故教训并进行瞬时肌肉记忆修正。
这种“解耦检索 + 测试时低秩微调”的工程哲学,不仅让自动驾驶系统在评测指标上实现了跨越,更打破了模型必须依赖全量离线重训才能进化的固有思维,为高可靠、自演进的下一代具身智驾系统提供了一条可落地的演进范式。